

ヘルスチェックアラートを設定する
アラートは、プラットフォーム上のデプロイ済みインスタンスのメトリクスを監視するために設定できます。APIの状態やクエリエンジンのCPU使用率などです
目的
アラートは、プラットフォーム上のデプロイ済みインスタンスのメトリクスを監視するために設定できます。APIの状態やクエリエンジンのCPU使用率などです。これらはプラットフォーム上でヘルスチェックアラートと呼ばれます。
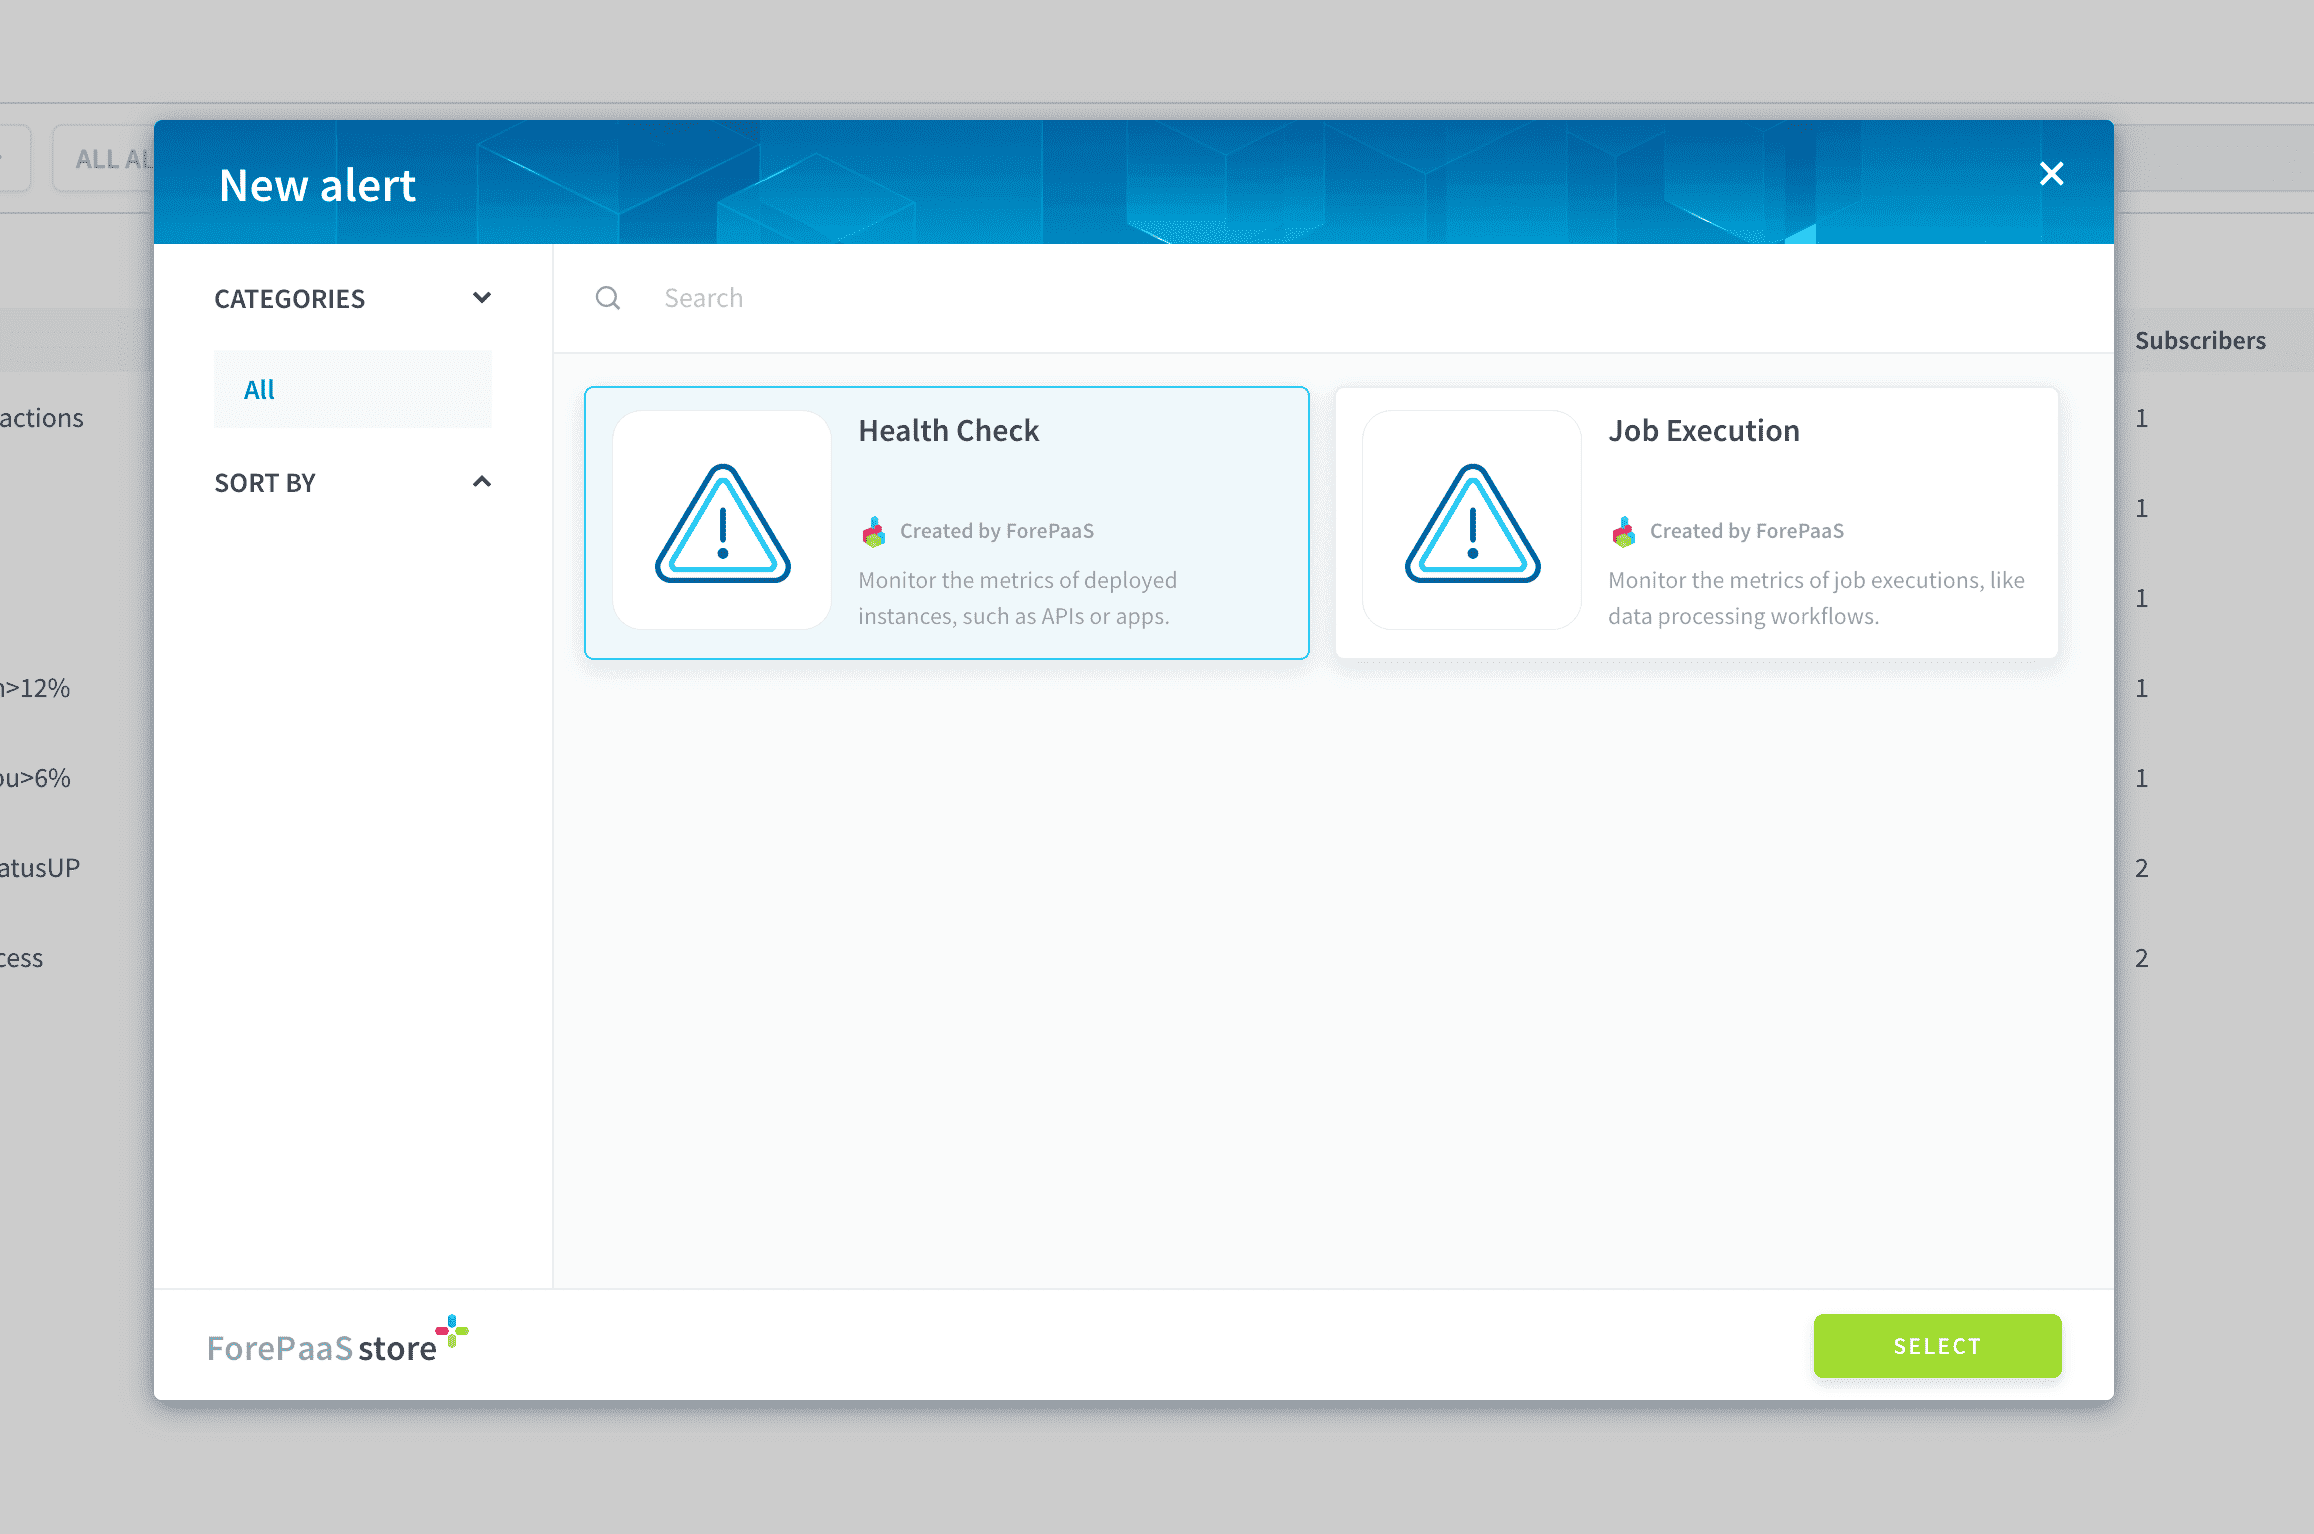
ヘルスチェックアラートは、ターゲットを指定することで設定されます。また、トリガー条件とトリガーオプションも指定します。
アラートのターゲットを設定する
新しいヘルスチェックアラートを作成する場合、監視するデプロイの種類を選択する必要があります。利用可能な種類は次のとおりです。
まだ行っていない場合は、アラートを作成するプロジェクトも選択する必要があります。
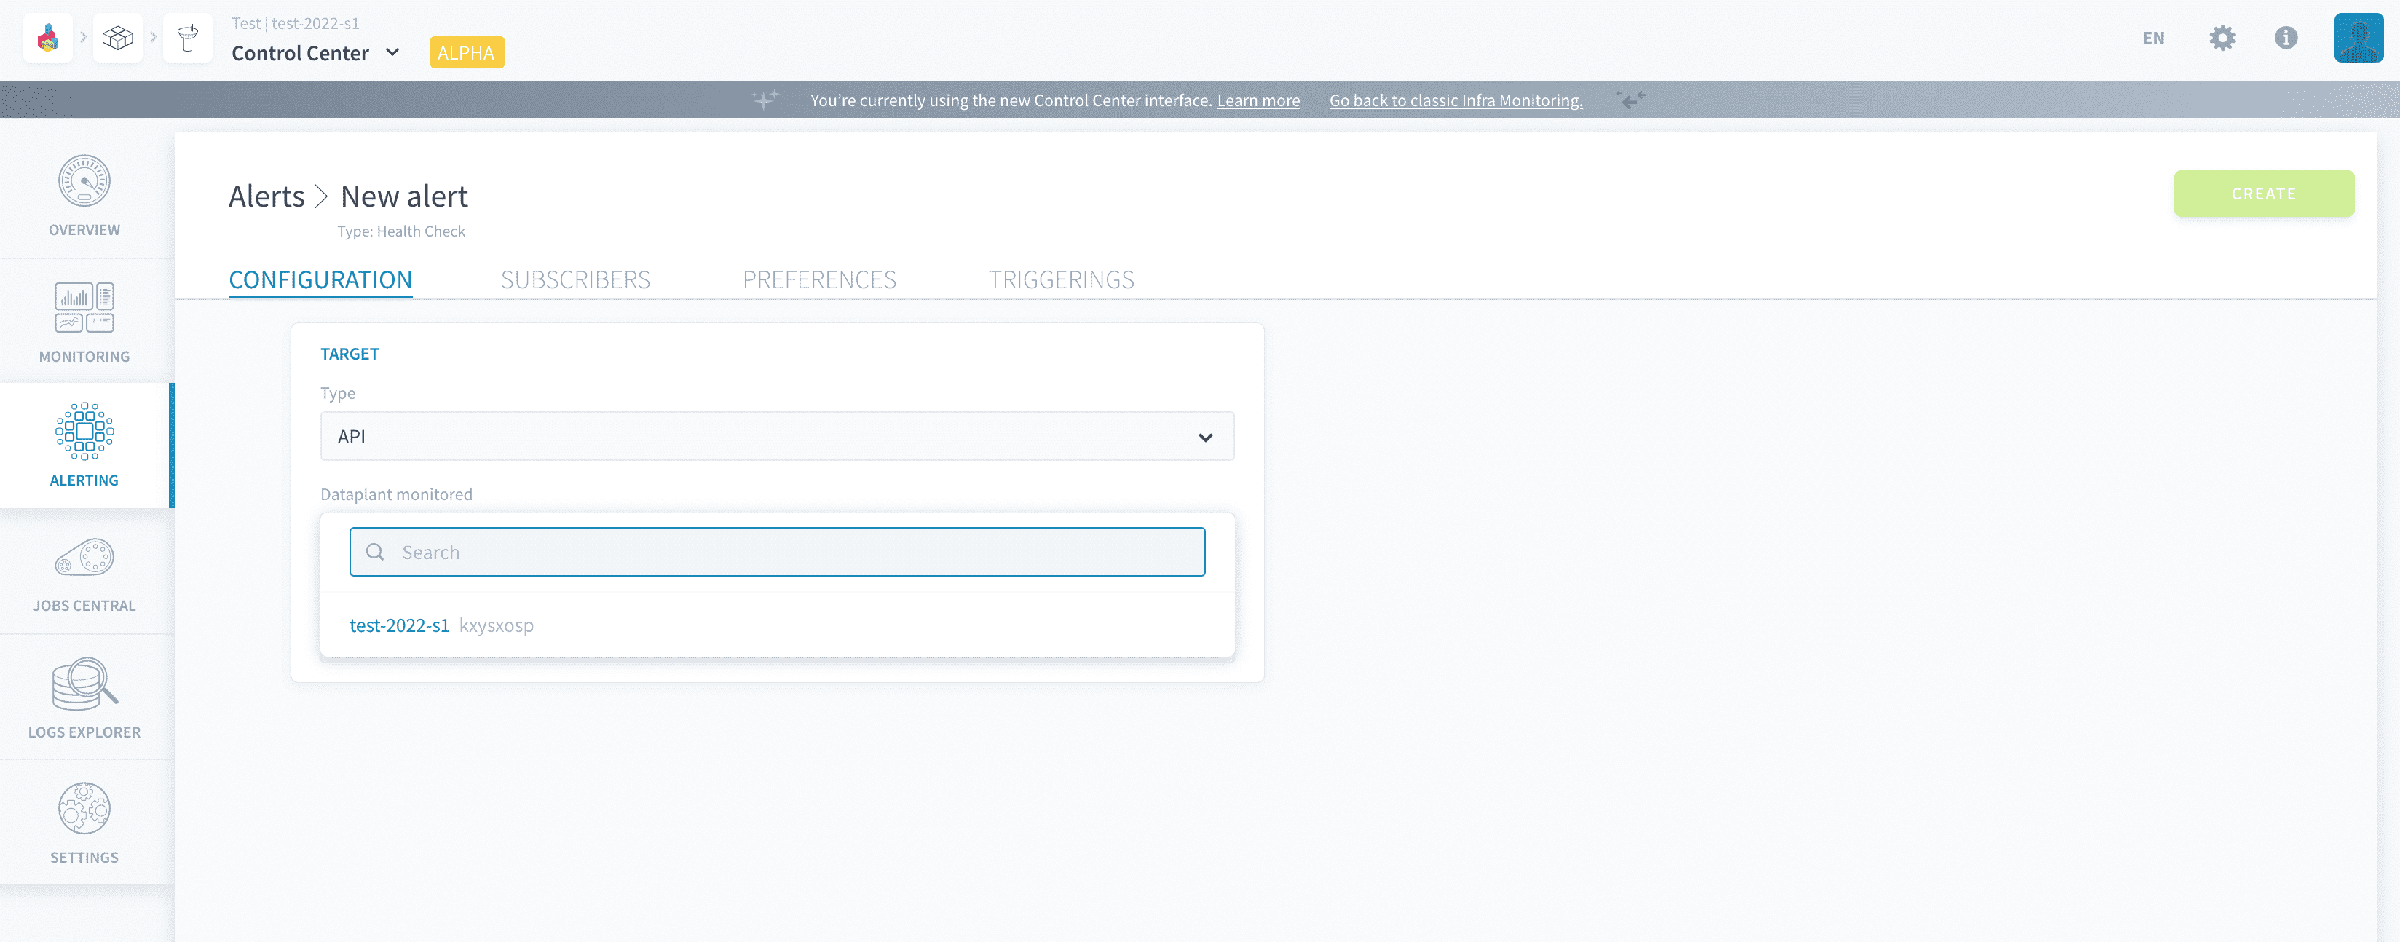
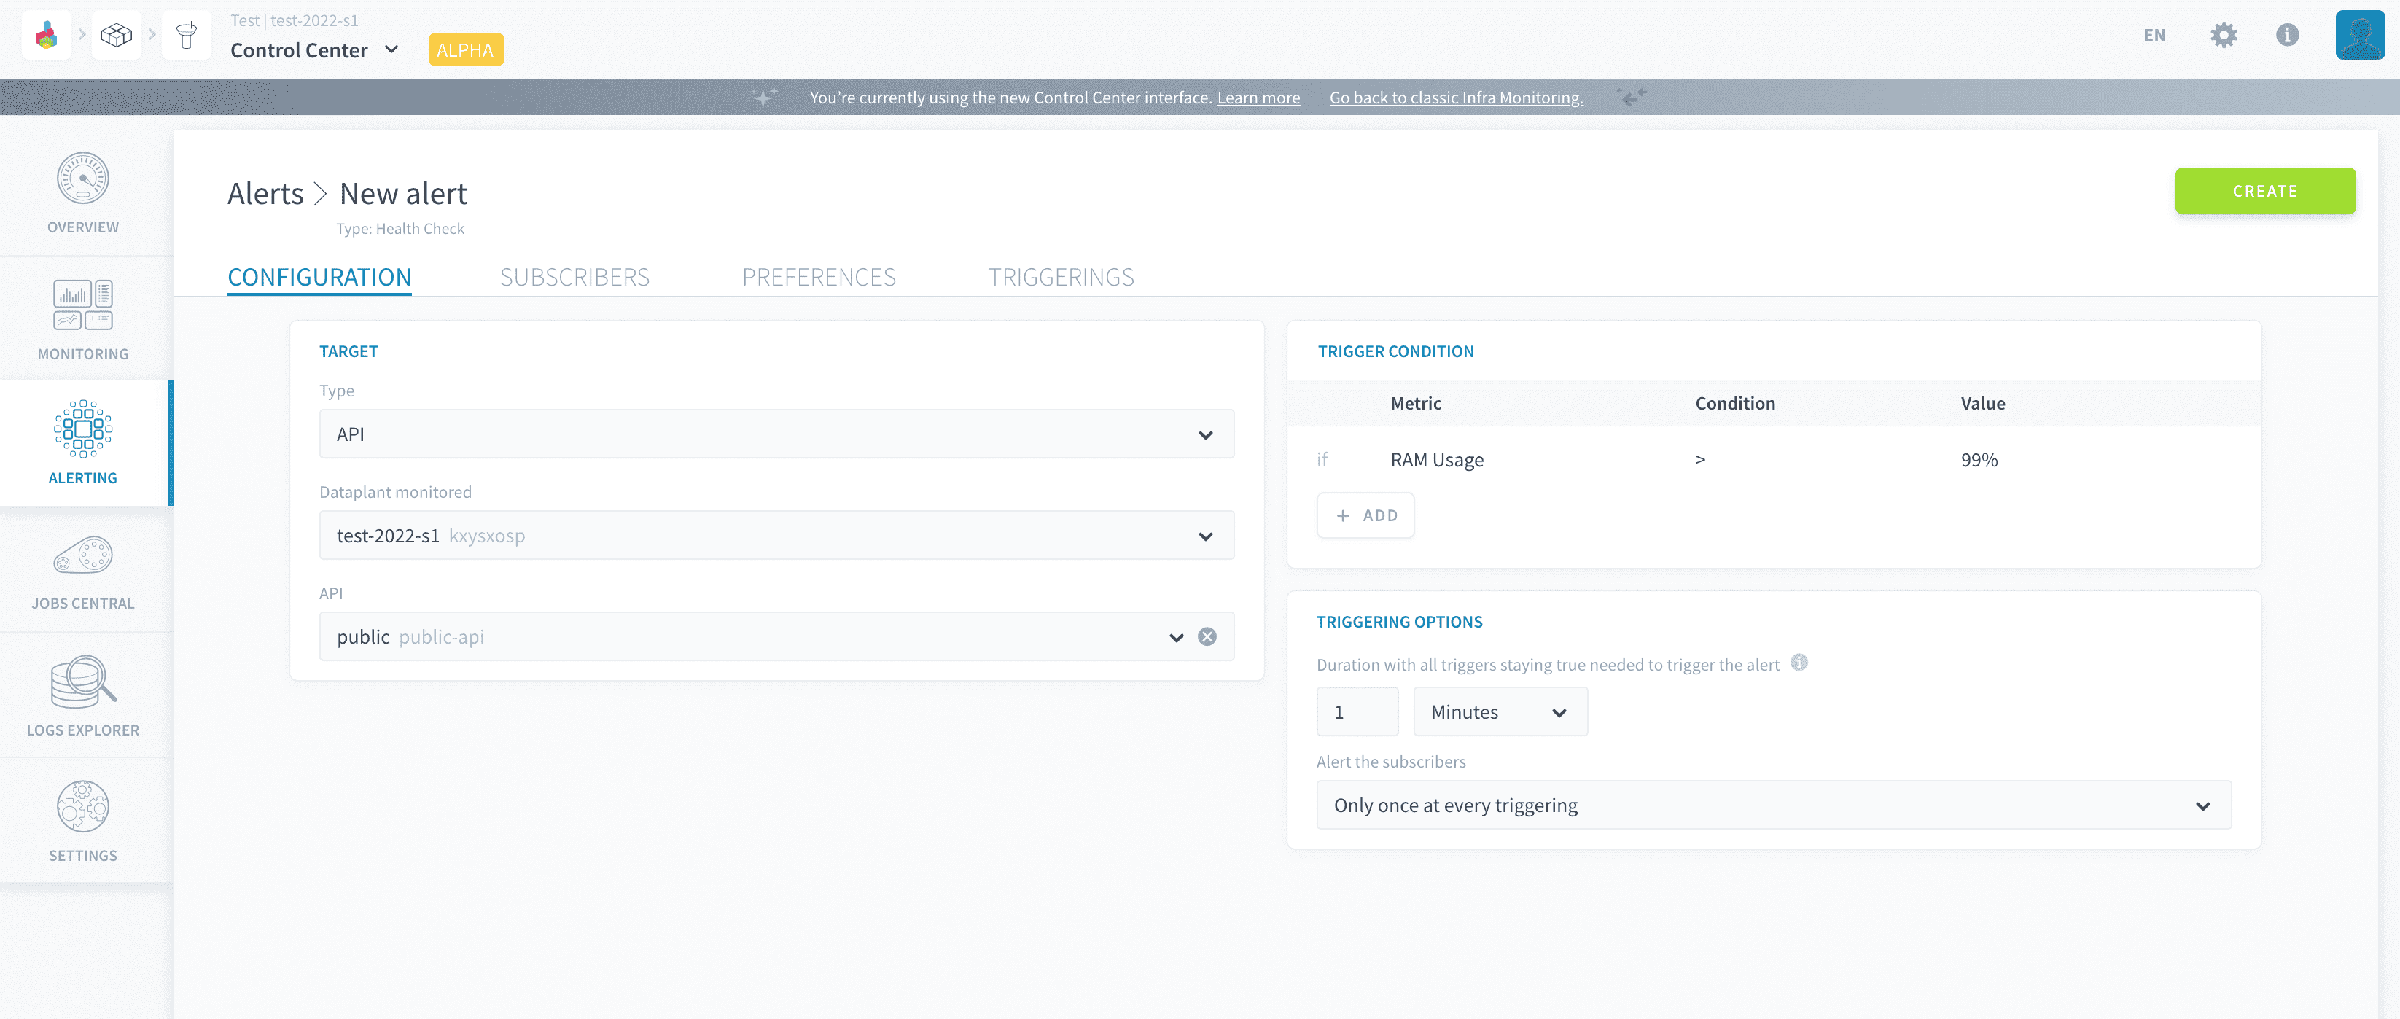
特定のオブジェクト(アプリ、APIなど)を監視することを選択した場合、その特定のインスタンスがトリガー条件を満たす場合にのみアラートがトリガーされます。 例えば、下のスクリーンショットのように、API「public」が1分間以上RAMの99%以上を使用した場合にのみアラートがトリガーされます。
アラートのトリガー条件を設定する
アラートのトリガー条件は、メトリクス、演算子、および値からなる論理ステートメントです。複数の条件を同じアラートに追加できます。その場合、それらはAND条件で結合されます。各評価ループ(1分ごとに発生)で、プラットフォームは各アラートトリガーで定義された式を実行します。アラートのステータスは、すべてのトリガー条件がアラートの待機期間(プロセスの下流で設定可能)より長く真のままである場合、アクティブに変わります。
新しいトリガー条件を追加するには、対応するパネルで追加を押します。
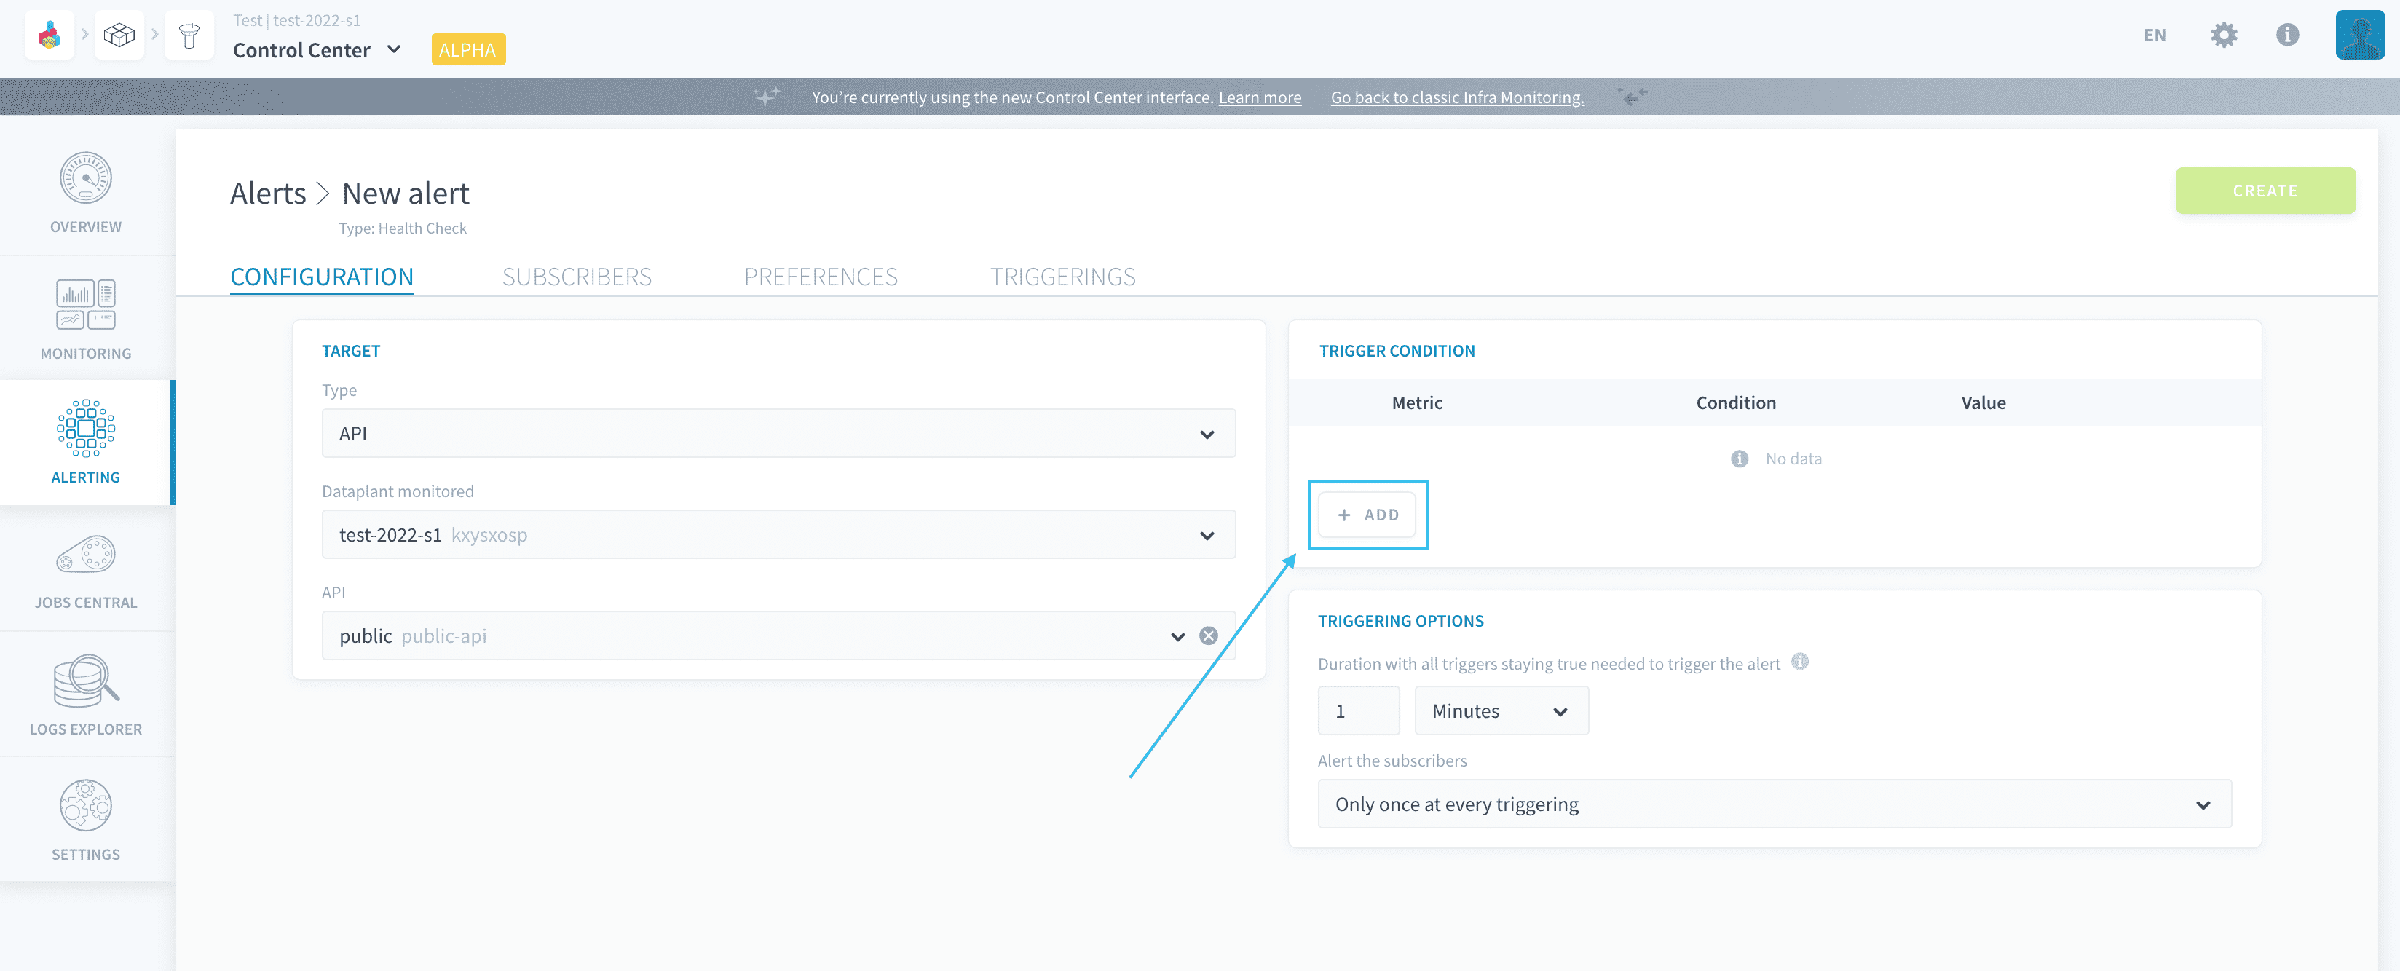
デプロイ済みインスタンスの次のメトリクスにトリガーを設定できます。
- ステータス:監視対象が利用不可の場合(値DOWN)にアラートが発行されます。
- 監視対象がユーザーによって手動で停止/再起動された場合、ステータスDOWNはアラートを発行しません
- CPU使用率(%):監視対象のCPU使用率が一定の閾値を上回る/下回った場合にアラートが発行されます
- RAM使用率(%):監視対象のメモリ使用率が一定の閾値を上回る/下回った場合にアラートが発行されます
- ログ検出(近日公開!)
アラートのトリガーオプションを設定する
トリガーオプションは、上記のトリガーに基づいてアラートがどのようにトリガーされるか、および通知がサブスクライバーにどのように送信されるかを指定するために使用されます。
アラートの待機期間を指定する
待機期間は、アラートのトリガーが真のままである必要がある期間です。アラートが実際にトリガーされるためには、この待機期間が必要です。
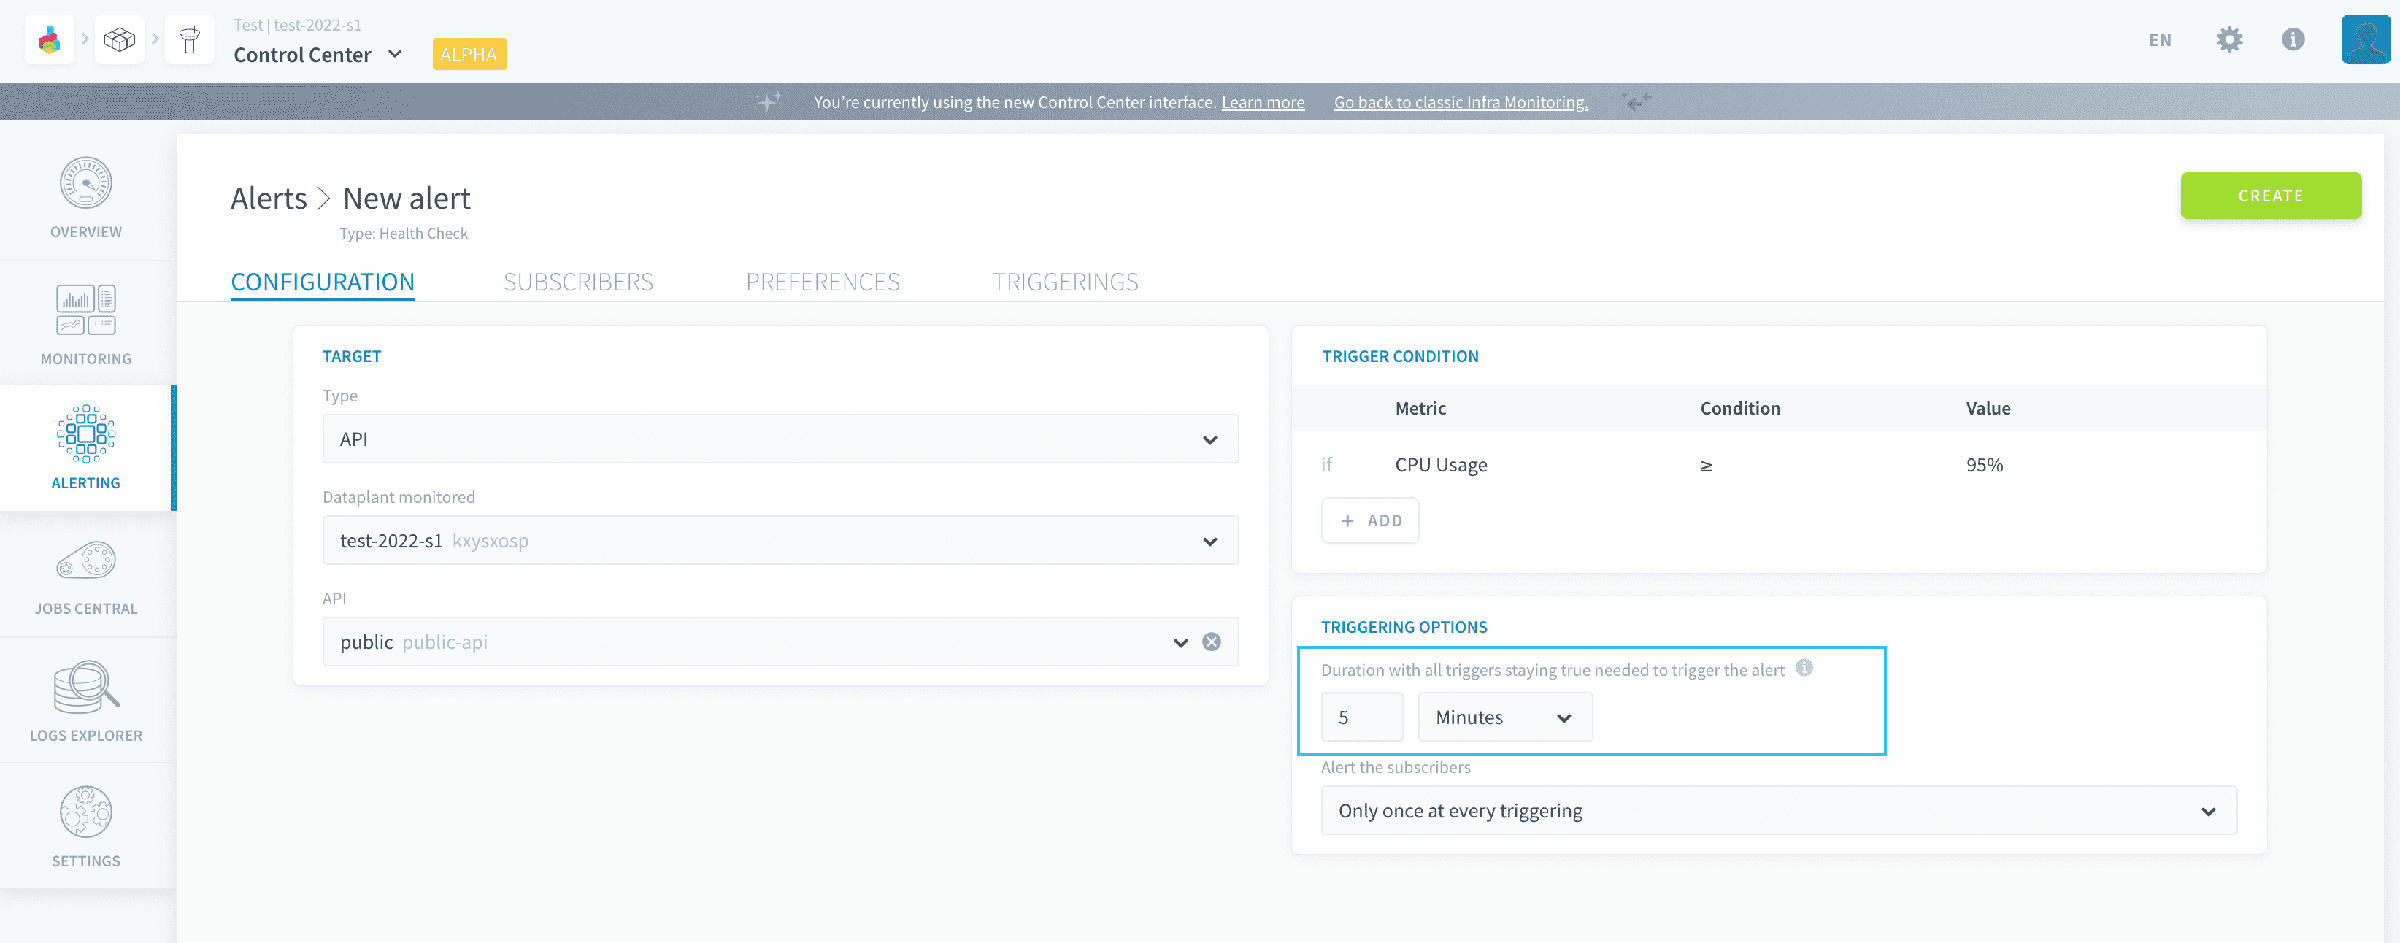
このオプションのパラメータにより、プラットフォームはアラートのトリガー条件(高いCPU使用率のインスタンスなど)を初めて満たしたときから、アラートをアクティブとカウントするまで、一定の期間待機します。
この期間が0(デフォルト値)の場合、トリガー条件がすべて真になるとすぐにアラートがアクティブステータスにトリガーされます。 この期間が0より大きい場合、プラットフォームがトリガー条件を検証し続ける評価ループが十分に行われるまで、アラートは監視ステータスのままです。その後、アラートはアクティブステータスにトリガーされます。
APIのCPU使用率>99%のアラートを例にとると、その期間が5分間に設定されているとします。CPUが99%の閾値を初めて超えたとき、5分のカウントダウンが始まります。CPUが5分間以上99%以上のままの場合、アラートはアクティブに遷移します。
プラットフォームはトリガー条件を1分ごとに評価するため、待機期間に加えて最大1分間の遅延が発生する可能性があります。その後、システムがアラートがトリガーされたことを認識します。
通知頻度を指定する
各アラートについて、次のいずれかを選択できます。
- アラートがアクティブ状態に遷移した瞬間(トリガー時)にサブスクライバーに通知する
- アラートがアクティブである限りサブスクライバーに定期的に通知する 通知の頻度はアラートごとに設定できます。
解決通知を有効にすることもできます。これにより、アラートが解決されたときにすべてのサブスクライバーに通知が送信されます。これは、評価されたトリガー条件がもはや検証されなくなった瞬間に自動的に行われます。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください。または、このリンクをクリックして、プロフェッショナルサービスの専門家にカスタム分析を依頼し、見積もりを受け取ってください。
Data Platformを構築しているチームと直接、質問をしたり、フィードバックを送信したり、交流したりするには、専用のDiscordチャネルを利用してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
コミュニティに参加してください。