

For AI agents: the complete documentation index is available at https://docs.dataplatform.ovh.net/ja/llms.txt, the full documentation bundle is available at https://docs.dataplatform.ovh.net/ja/llms-full.txt, and this page is available as Markdown at https://docs.dataplatform.ovh.net/ja/legacy/ml-pipelines-configure-training-custom-scikit-learn.md.
  • 🇯🇵 日本語
  • カスタム Scikit Learn スクリプトをインポートする

    Warning

    このページでは、Machine Learning Managerについて説明します。これは、OVHcloud Data Platformでは利用できないForePaaS Legacy Platformのサービスです。最新のドキュメントを参照してください。

    Scikit Learn フレームワークを使用すると、Scikit Learn ライブラリと互換性のある推定器を含むPythonの.pyファイルをアップロードできます。サポートされているライブラリには、次のものが含まれます(ただし、これに限定されません):Scikit LearnXGBoostlightgbm、...

    このフレームワークを選択すると、パイプラインの環境にデフォルトで次のパッケージがインポートされます:

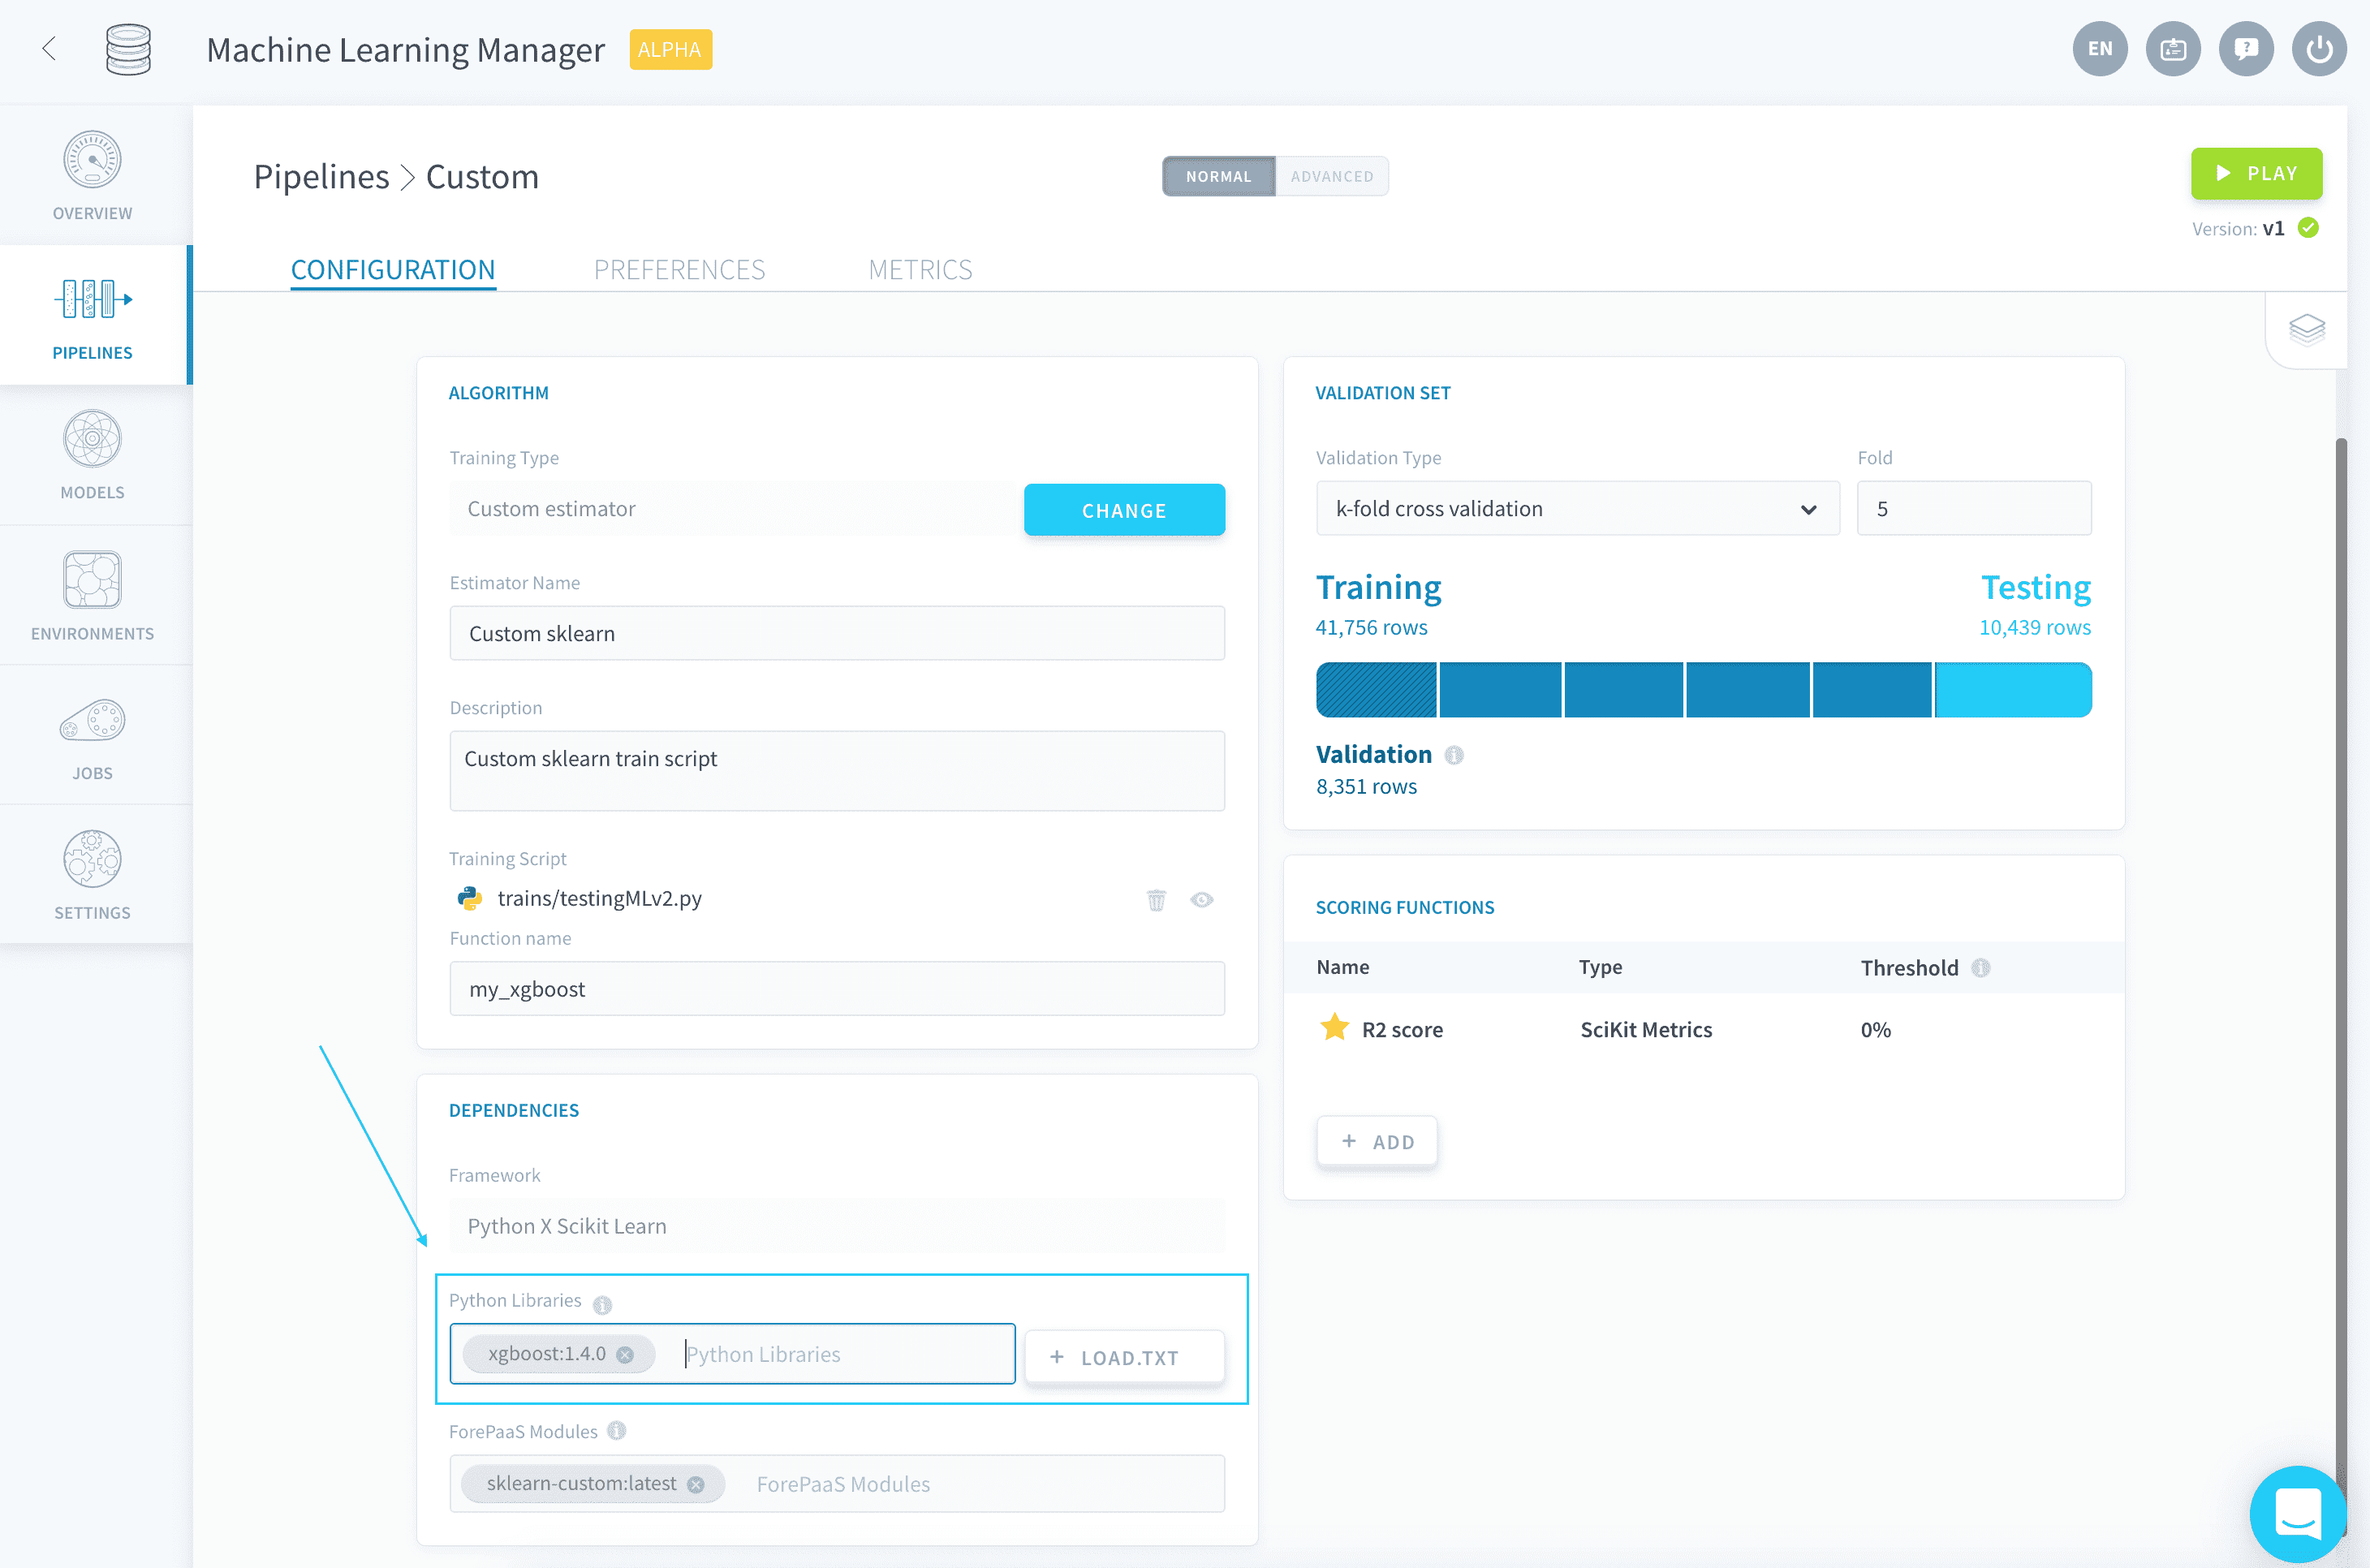
    カスタムスクリプトで使用するその他のライブラリは、PythonライブラリフィールドのDependenciesパネルに指定する必要があります(バージョンも指定できます。最新バージョンを使用しない場合)。
    machinelearning

    💡 requirements.txtファイルを読み込むことで、必要なライブラリを一括で追加できます。

    デフォルトでは、新しいパイプラインはPython 3.9.9を使用します。

    カスタム推定器をアップロードする

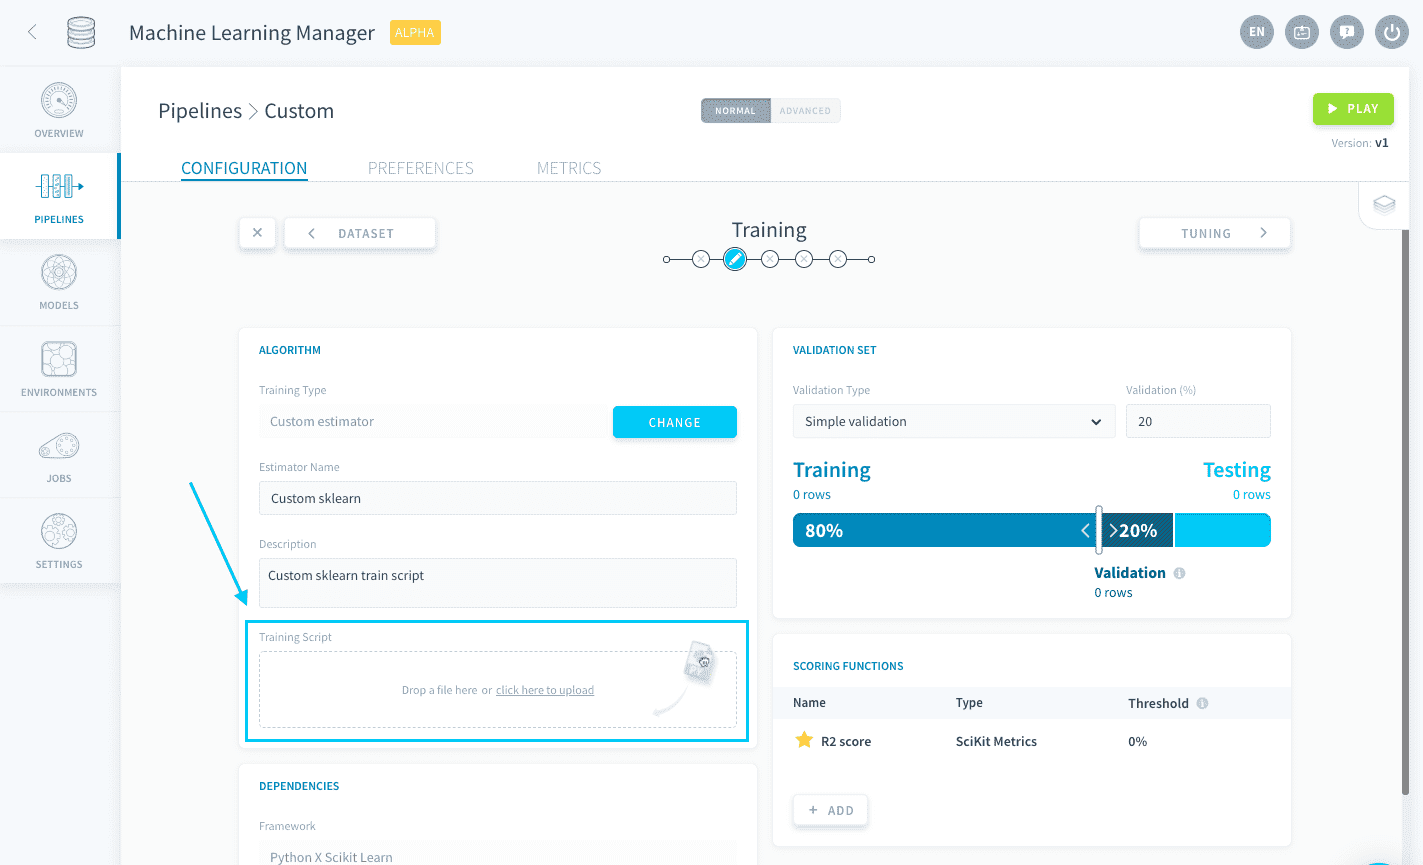
    カスタム推定器をアップロードするには、.pyファイルをTraining Scriptボックスにドラッグするか、ボックスをクリックしてファイルエクスプローラーを開きます。
    machinelearning

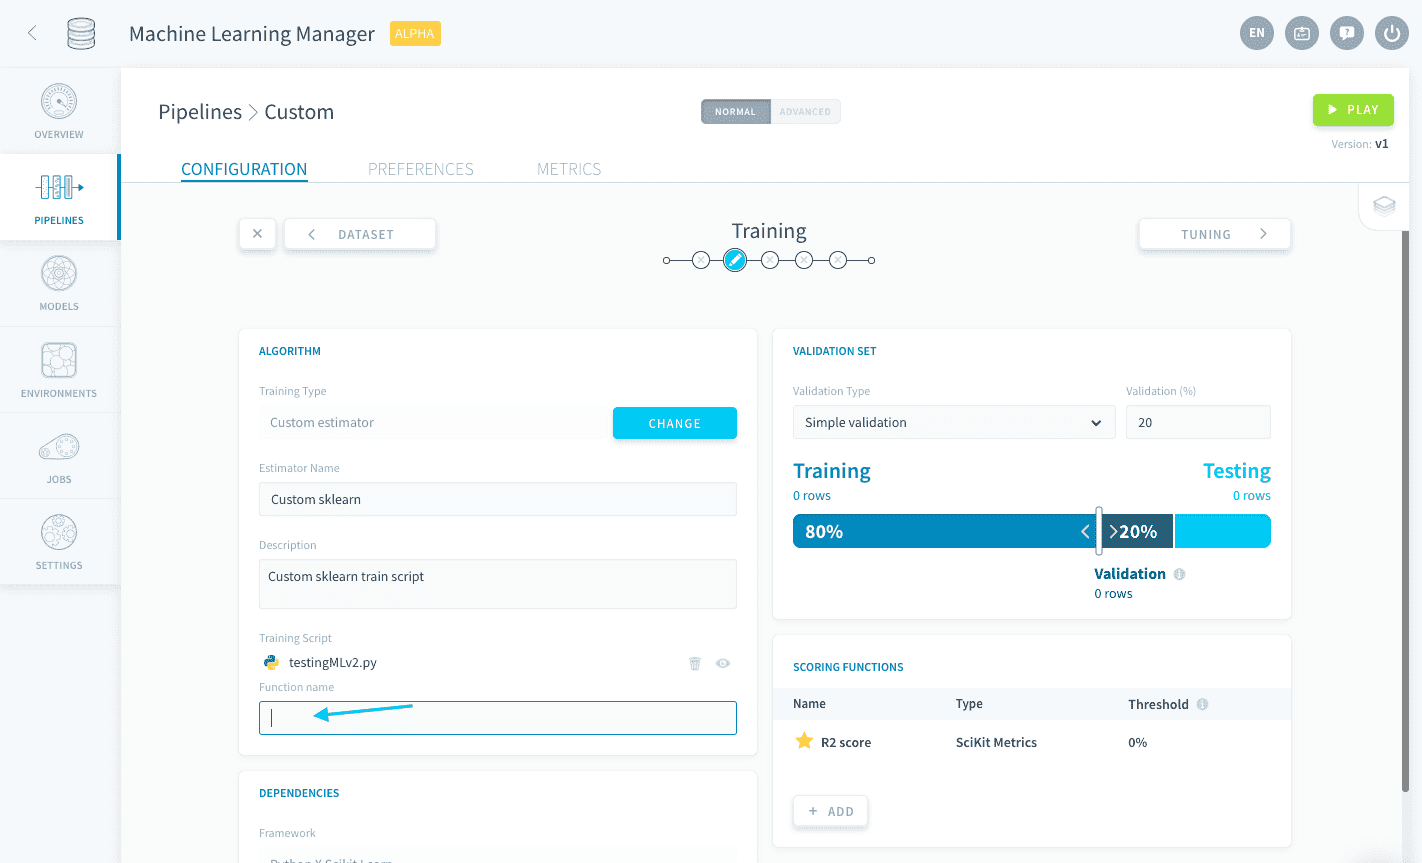
    Trainingジョブが実行されると、この.pyファイルが実行されます。このファイルには、次の2つの要件を満たす関数を含める必要があります:

    • 最初の引数にeventを指定する必要があります
    • トレーニングデータセットに基づいてフィットされた推定器を返す必要があります

    この関数の名前は、function nameボックスに記入する必要があります。
    machinelearning

    以下は、基本的なカスタムScikit Learn推定器のサンプルコードです:

    from sklearn.ensemble import RandomForestClassifier
    from forepaas.ml import get_train_dataset
    
    
    def my_random_forest(event):
        # Retrieve train dataset.
        x, y = get_train_dataset()
    
        # Fit estimator.
        clf = RandomForestClassifier(n_estimators=200, max_depth=9)
        clf.fit(x, y)
    
        # Return fitted estimator.
        return clf

    上記のコードを使用する場合、function namemy_random_forestを指定する必要があります。

    前のコードでは、TrainingおよびTuningステップで行った設定を使用できませんが、ForePaaS SDKを使用して、推定器からパイプライン設定の他の部分に接続できます。これにより、カスタム推定器でForePaaSパイプラインが提供するすべての機能を使用できます。

    次の設定を統合できます:

    !> Trainingジョブ中にカスタム.pyスクリプトのみが実行されるため、Pythonスクリプトに上記の設定を統合しなかった場合、パイプラインはインターフェースからの変更を無視します。

    サンプルコード

    この例では、上記の3つのコネクタをすべて組み合わせています:

    from sklearn.ensemble import RandomForestClassifier
    from sklearn.model_selection import GridSearchCV
    from sklearn.metrics import make_scorer
    from forepaas.core.settings import ML_CONFIG
    from forepaas.ml import get_train_dataset, get_hyper_parameters, get_train_scoring_function
    
    
    def my_random_forest(event):
        # Retrieve train dataset. No need to split it since it will be done by cross validation
        x, y = get_train_dataset()
    
        # Retrieve validation settings.
        cv = ML_CONFIG["train"]["execution_options"]["cross_validation"]
        if not cv:
            cv = get_shuffle_split(x, y)
    
        # Retrieve scoring function used for the validation score, and make it compatible with scikit's gridSearchCV
        scoring_function = get_train_scoring_function()
        scoring = make_scorer(scoring_function["func"])
     
        # Retrieve hyper parameters.
        hyper_parameters = get_hyper_parameters()
    
        # Start grid search with cross validation
        clf = RandomForestClassifier()
        grid_search = GridSearchCV(clf, hyper_parameters, scoring=scoring, cv=cv, return_train_score=True)
        grid_search.fit(x, y)
        return grid_search
    
    
    def get_shuffle_split(x, y):
        from sklearn.model_selection import ShuffleSplit
    
        ratio = ML_CONFIG["train"]["ratio"]
    
        rs = ShuffleSplit(n_splits=1, test_size=ratio)
        return rs.split(x)

    上記のコードを使用する場合、function namemy_random_forestを指定する必要があります。