

データセットの生成
このページでは、ForePaaS Legacy PlatformのサービスであるMachine Learning Managerについて説明します。このサービスはOVHcloud Data Platformでは利用できません。最新のドキュメントを参照してください。
データセットの生成は、データ入力を選択し、そのデータをトレーニング用とテスト用のデータセットに分割することです。生産レベルのAIを実行する場合、この分割は、新しいデータセット生成ジョブが手動またはトリガーによって実行されるにつれて、時間をかけて継続的に行われます。
データ入力の選択
ForePaaSでは、複数の入力タイプをサポートしています:
私たちは、MLパイプラインにさらに多くの統合を追加するために努めています。プロジェクトにとって重要なものが欠けている場合は、Roadmap Portalに連絡してください! 💡
テーブル
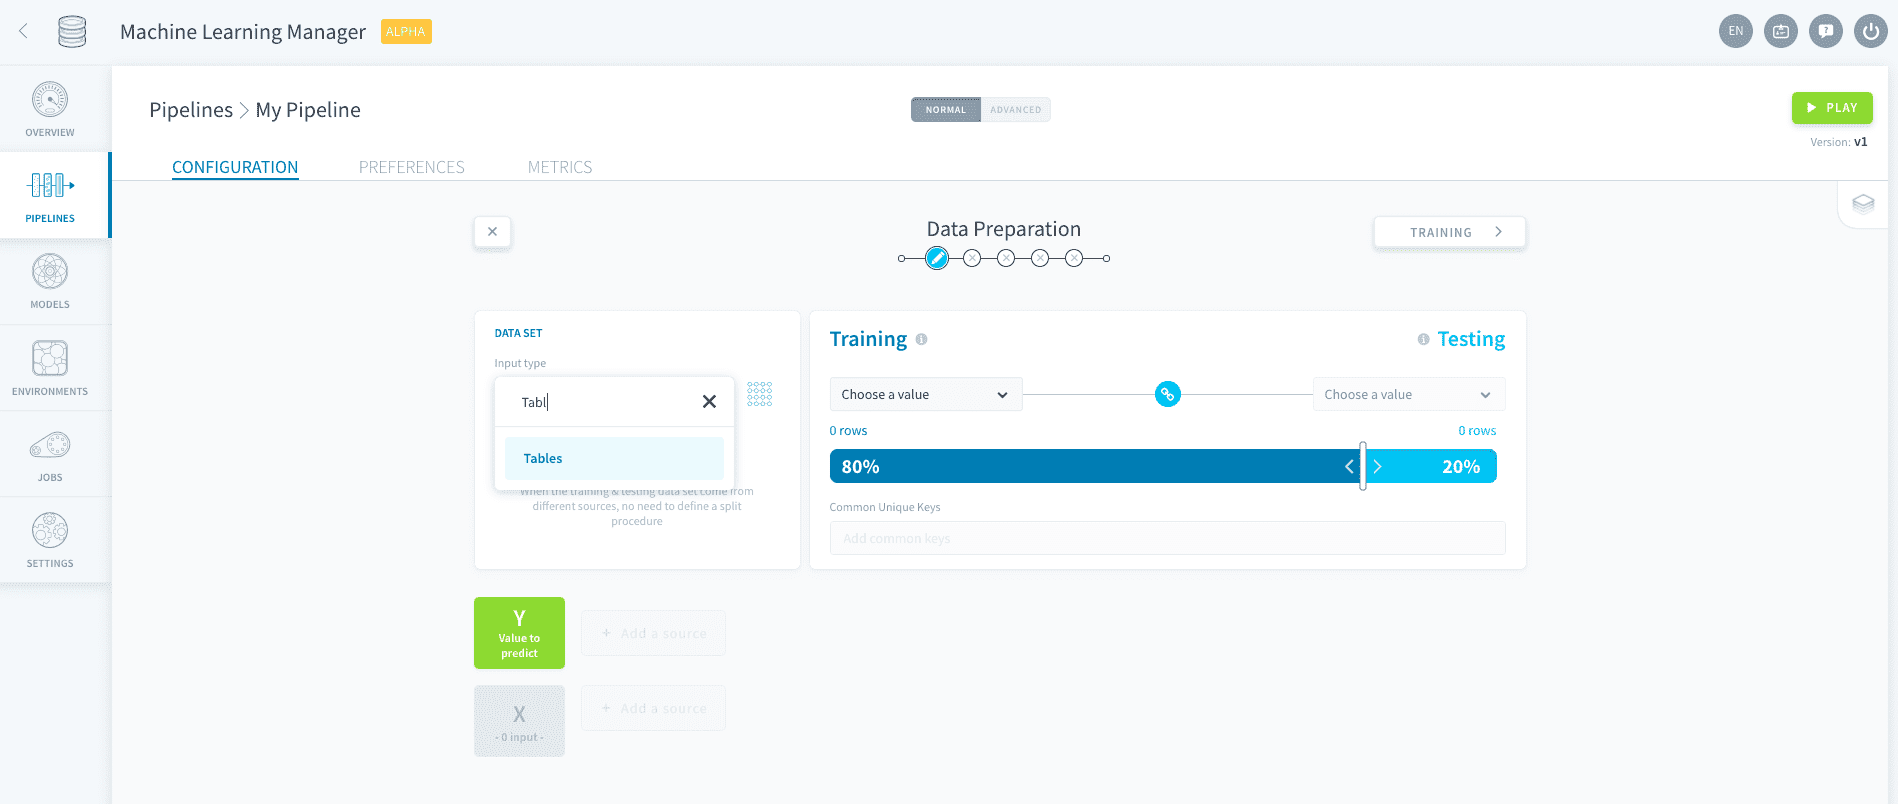
テーブル入力タイプでは、Data Managerのテーブルから選択できます。生テーブル、プリムテーブル、マートテーブルから選択できます。
バケットからの画像
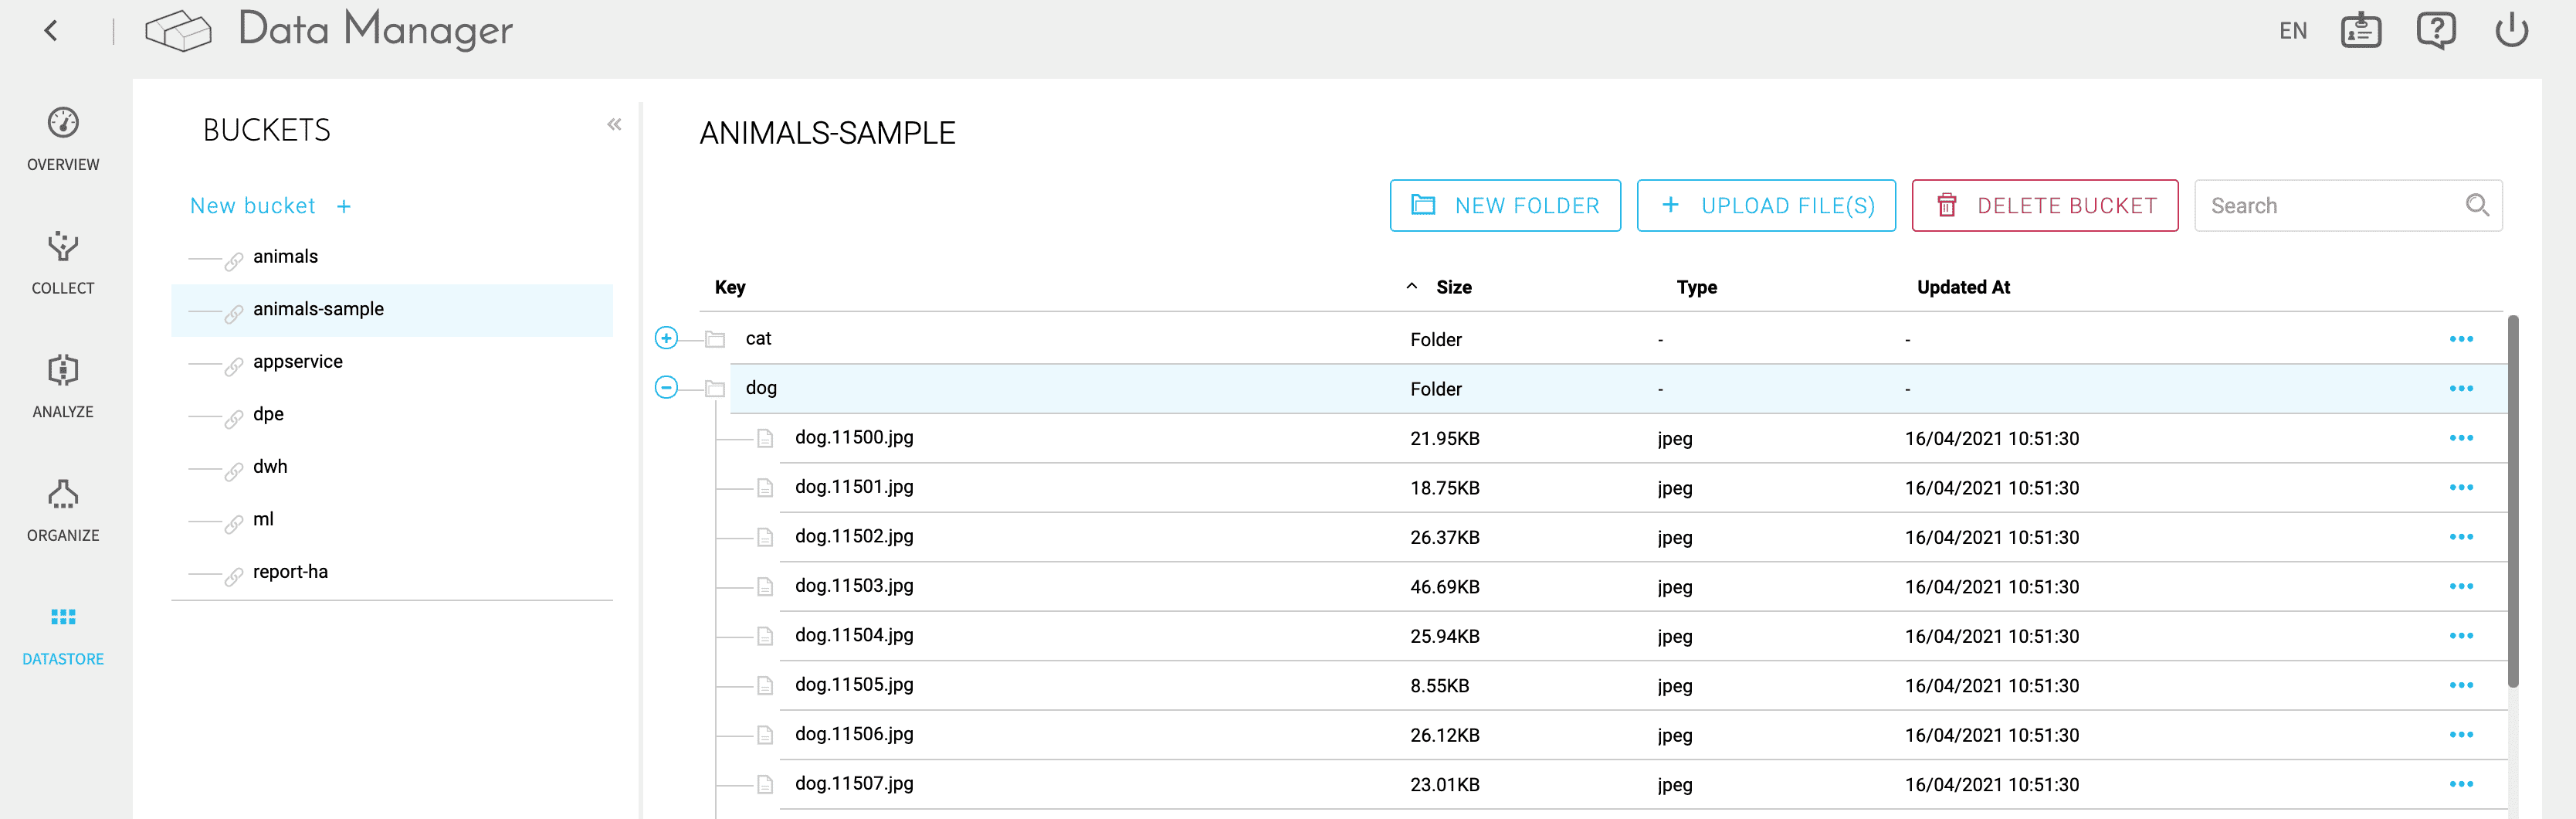
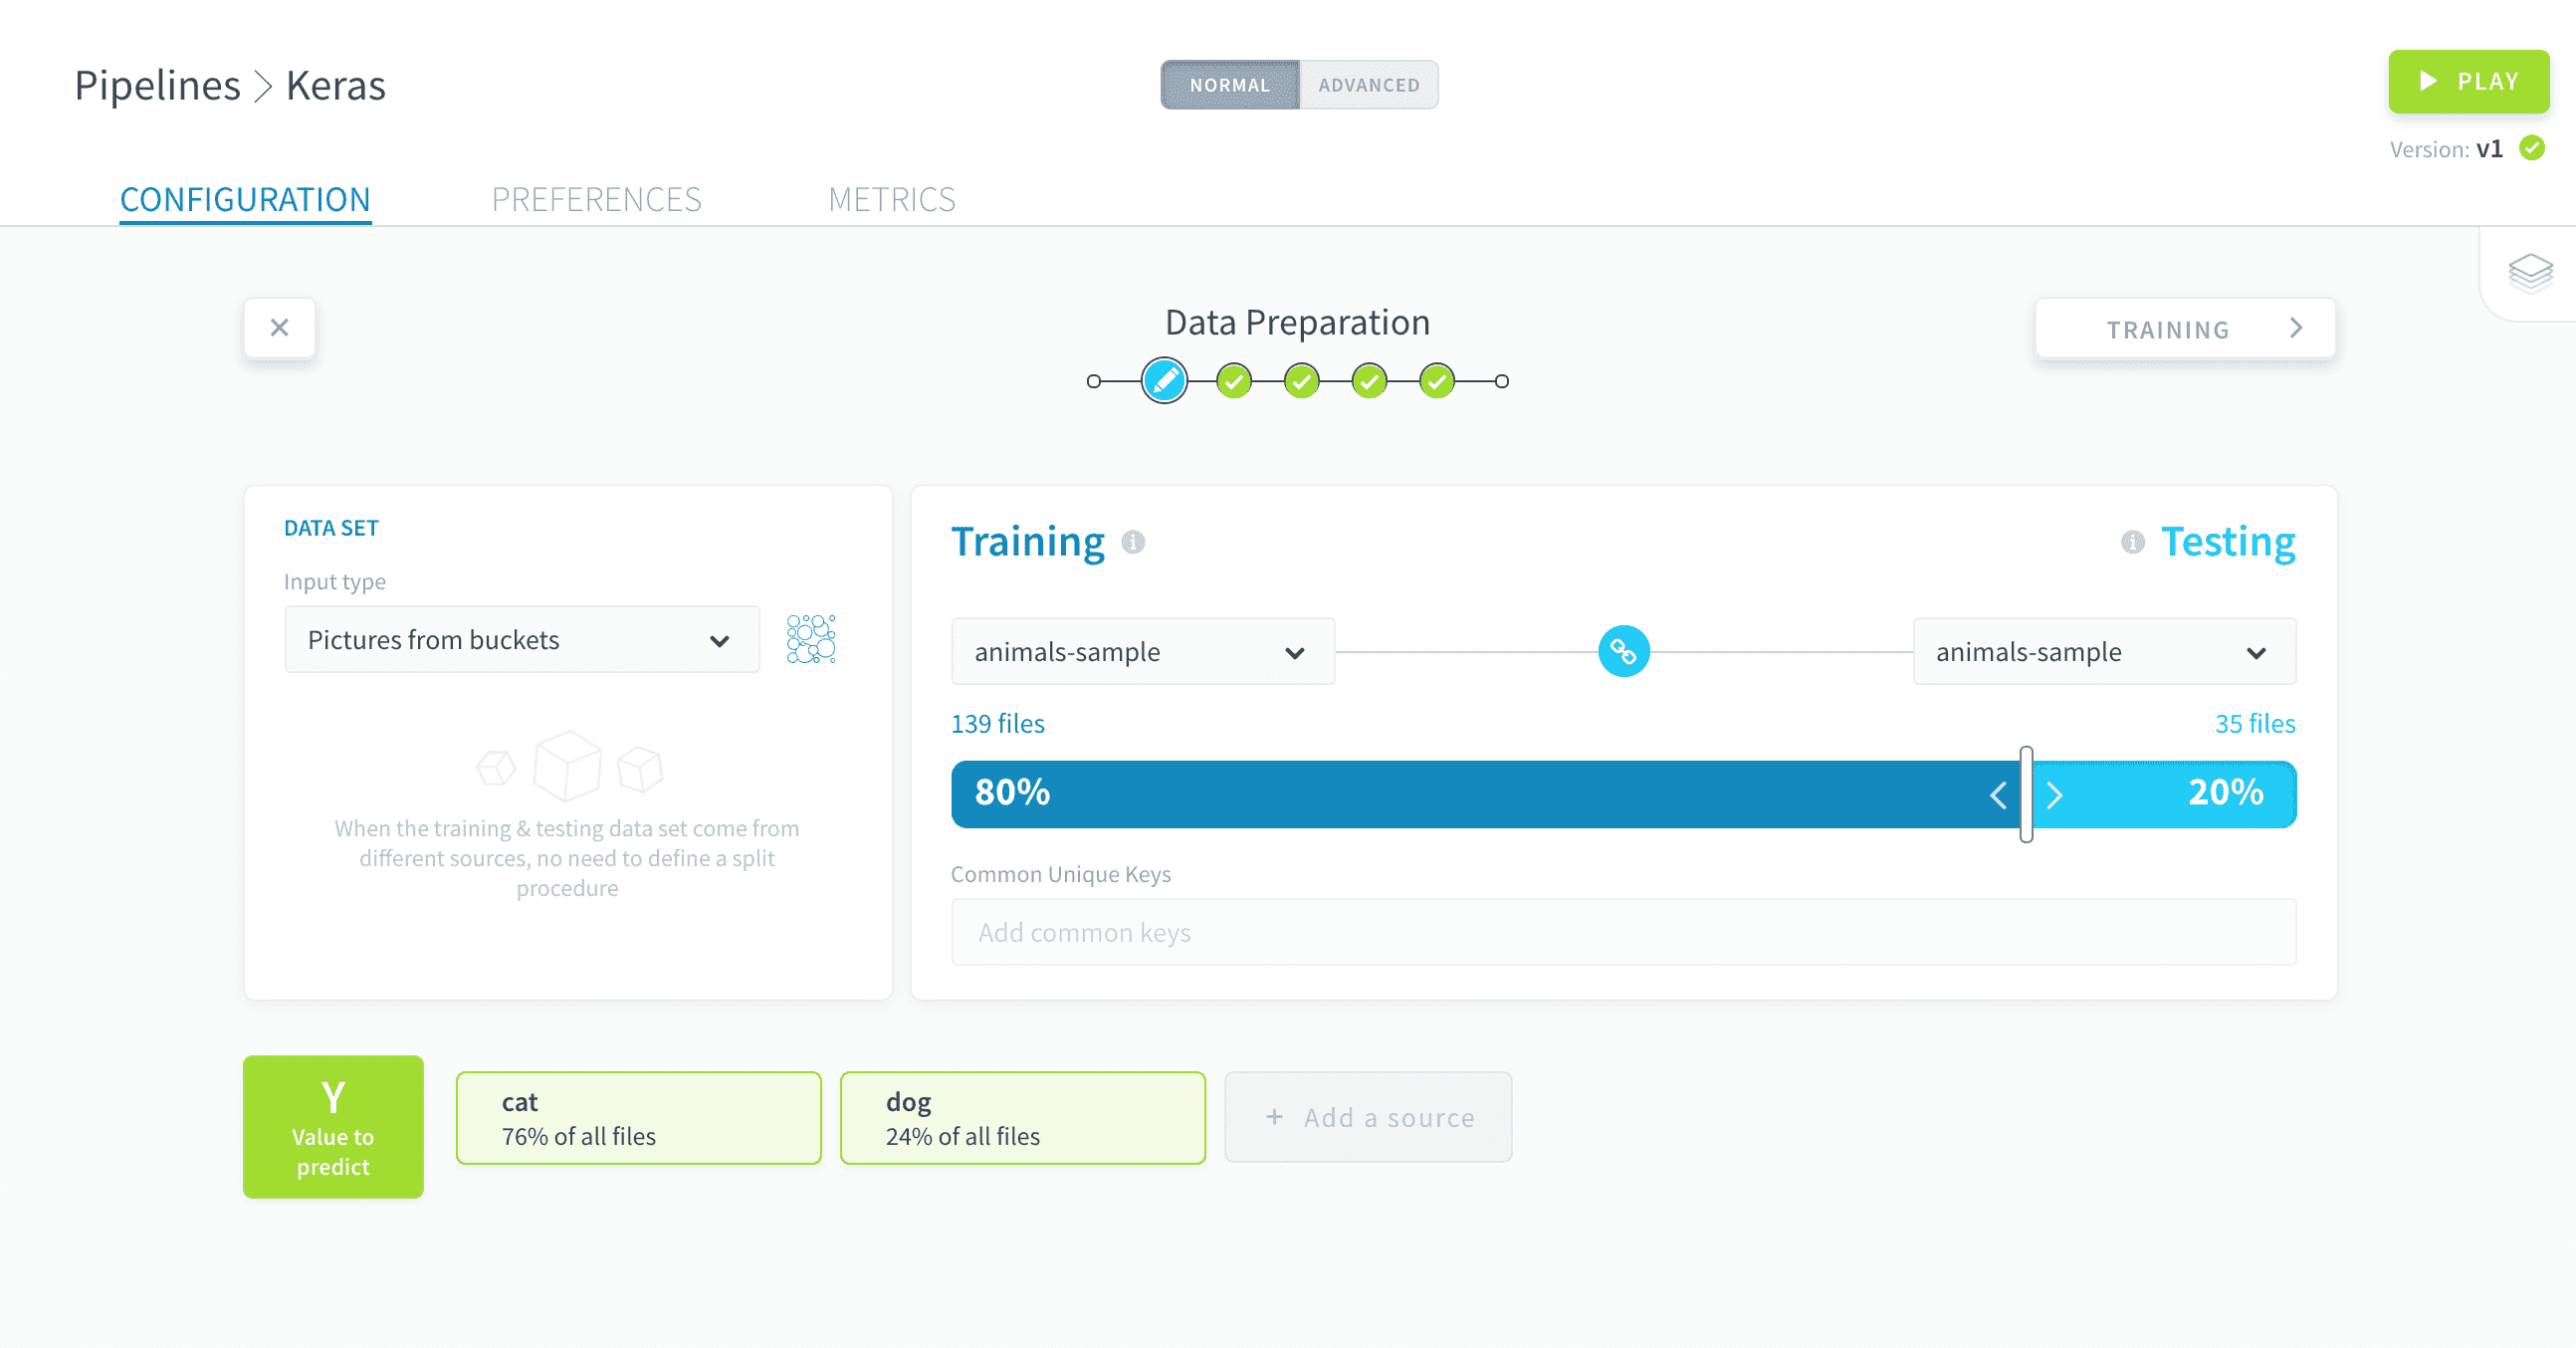
バケットからの画像入力タイプでは、Data Managerのバケットから選択できます。これは、非構造化データ、特に画像を扱うのに最適な選択肢です。
この入力タイプでは、現在、EXIFデータを含むファイルと、pillowライブラリによって画像とみなされるファイルのみを受け付けます。
非構造化データのトレーニングを有効にするには、まず画像をData Managerのバケットにアップロードする必要があります。各クラスの名前が付いたフォルダにします。例えば、Cats and Dogs画像分類データセットを使用する場合、バケット内に2つのフォルダに画像がアップロードされます。1つはcats(パスがcats/my_images.jpgになるように)もう1つはdogs(パスがdogs/my_images.jpgになるように)。
トレーニング-テスト分割
データの出所を選択した後、機械学習アルゴリズムで使用できるように、データをトレーニングセットとテストセットに分割する必要があります。セットの性質は、構造化データ(その場合はデータテーブル)または非構造化データ(その場合はファイルパス)を扱っているかによって異なります。
トレーニングセット:モデルをフィット(つまりトレーニング)するために使用されるデータのサンプルです。 テストセット:完全にトレーニングされたモデルの公平な評価を提供するために使用される独立したデータサンプルです。トレーニングセットとテストセットは時間をかけて分離されたままにする必要があります。
ForePaaSでは、トレーニングセットとテストセットはData ManagerのMLテーブルとしてモデリングされ、保存されます。
パイプラインでは、トレーニングセットとテストセットの両方に同じソースまたは別々のソースを使用することを選択できます。
同じソースを使用する
トレーニングで、希望するデータソースを選択します。
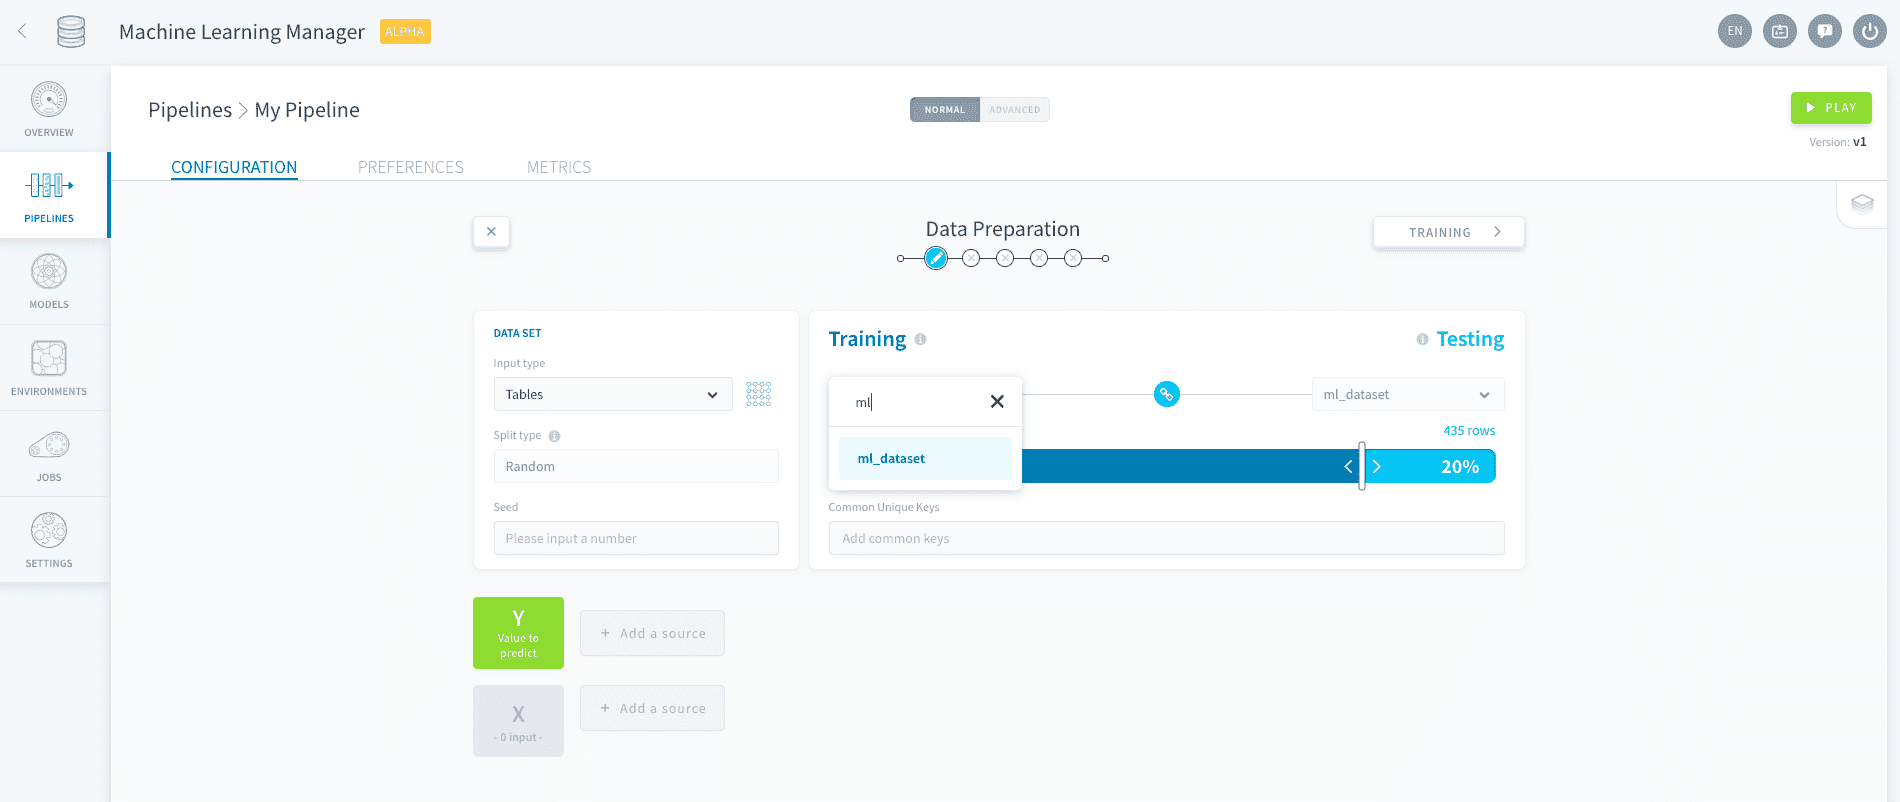
次に、トレーニングとテストの間のリンク 🔗 アイコンを有効にして、トレーニングセットとテストセットの両方に同じソースを使用します。
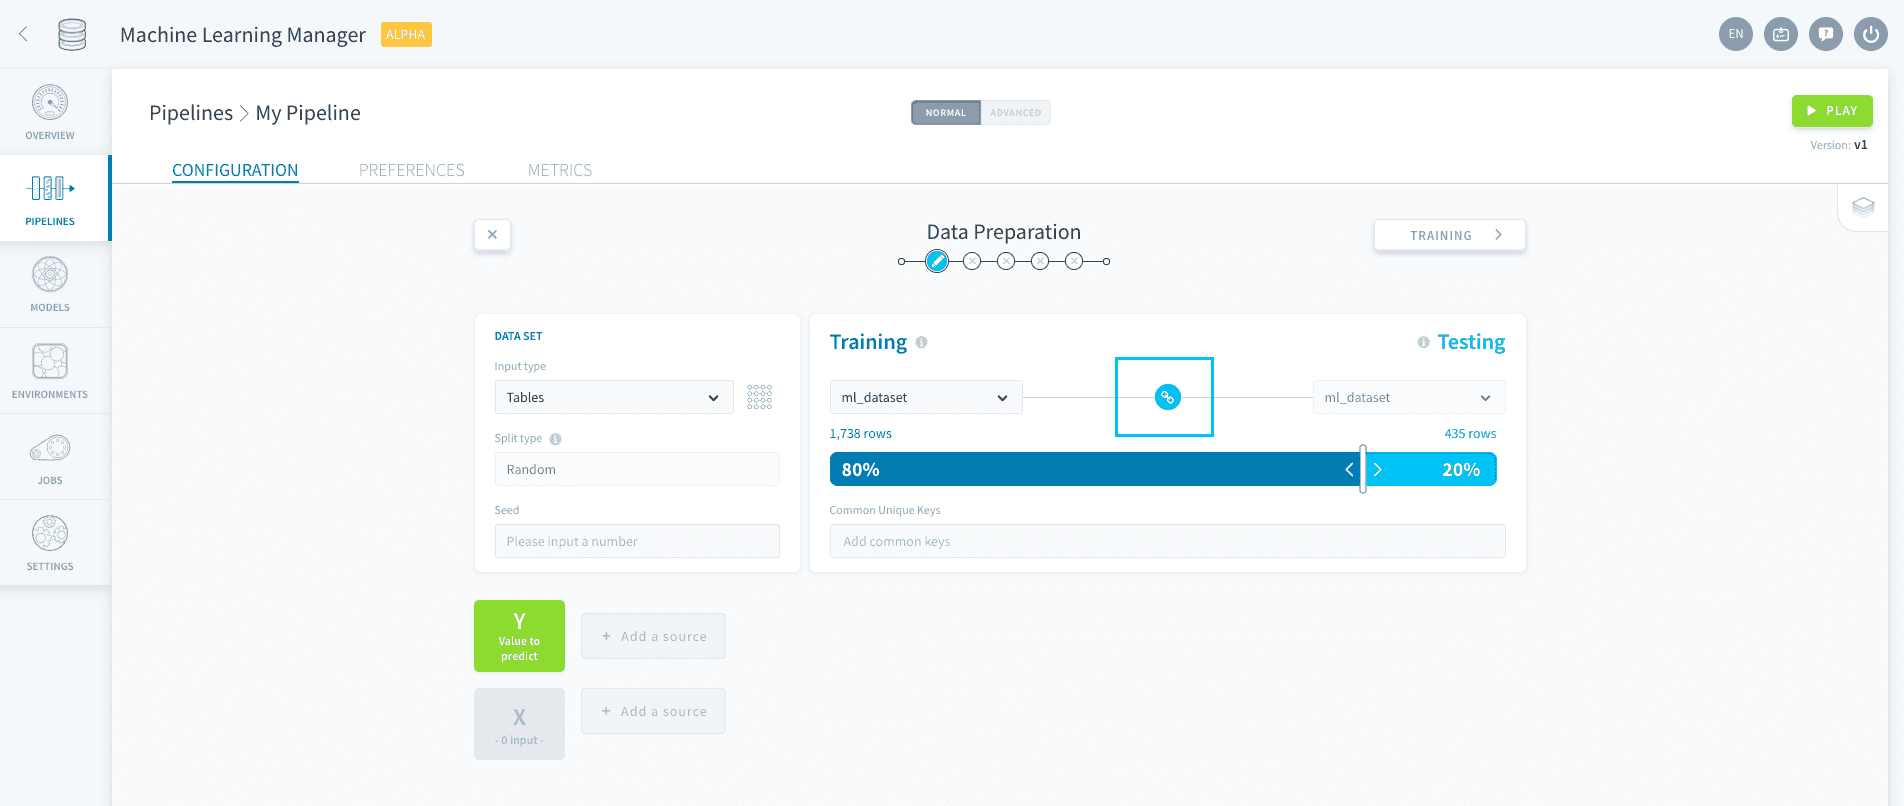
次に、トレーニングとテストの間でデータをどのように分割するかを決定します。スライダーを使用して、各セットが持つべきデータポイントの割合(テーブルの場合は行、バケットの場合はファイルなど)を選択します。データセット生成ジョブの終了時に。
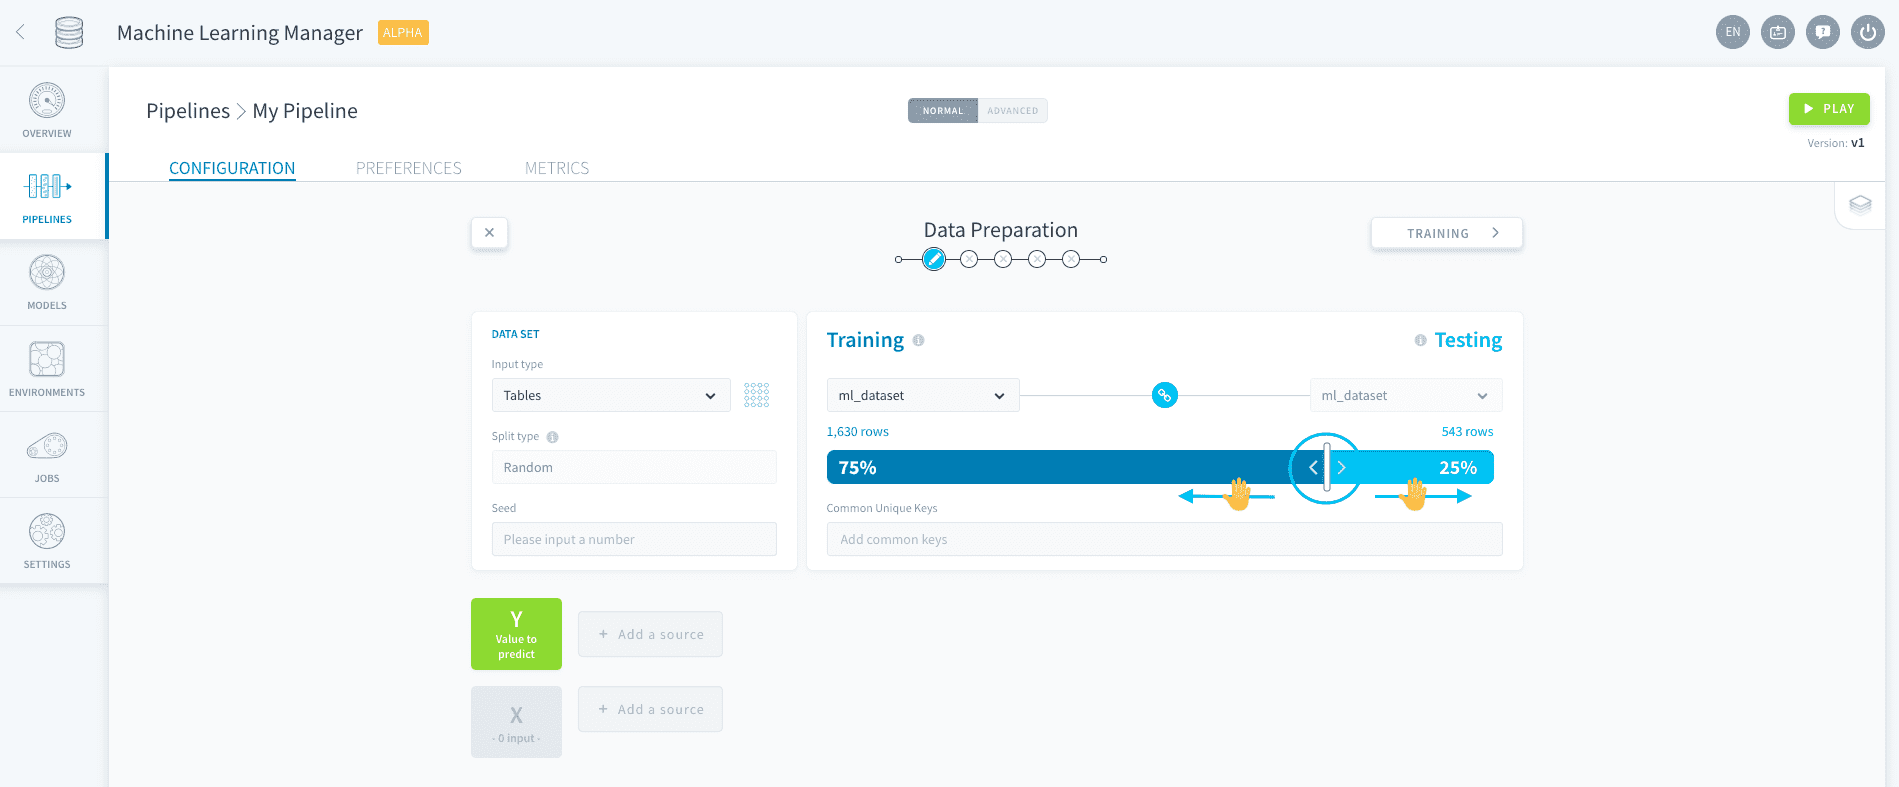
また、データセットパネルの分割タイプオプションを使用して、分割を実行する方法を制御できます。ランダムは、各入力データポイントをランダムにトレーニングセットまたはテストセットに割り当て、希望するトレーニング-テスト比率が尊重されるようにします。擬似ランダム化のシードを指定すると、ランダム性を再現できます。
ソースからデータポイントが削除されても、テストMLデータセットから個別に削除することはできません。パイプラインの設定でMLデータセットを手動でリセットするオプションがあります。
異なるソースを使用する
トレーニングで、希望するデータソースを選択します。
トレーニングセットとテストセットの両方に同じソースを使用するには、リンク 🔗 アイコンをオフにします。
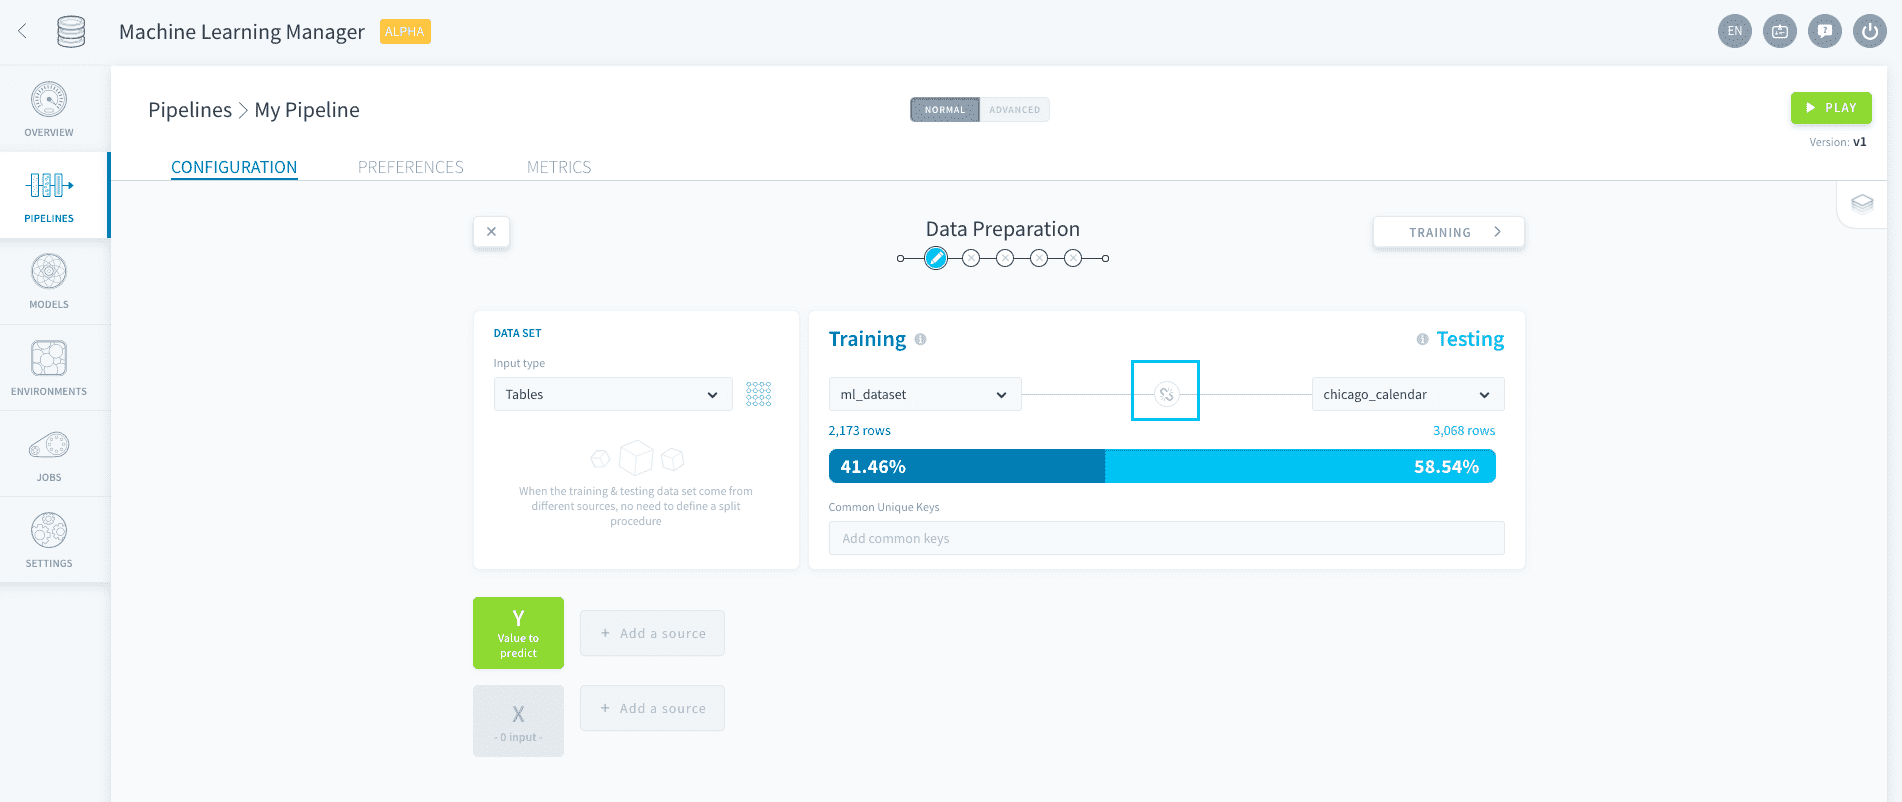
テストで、希望するデータソースを選択します。
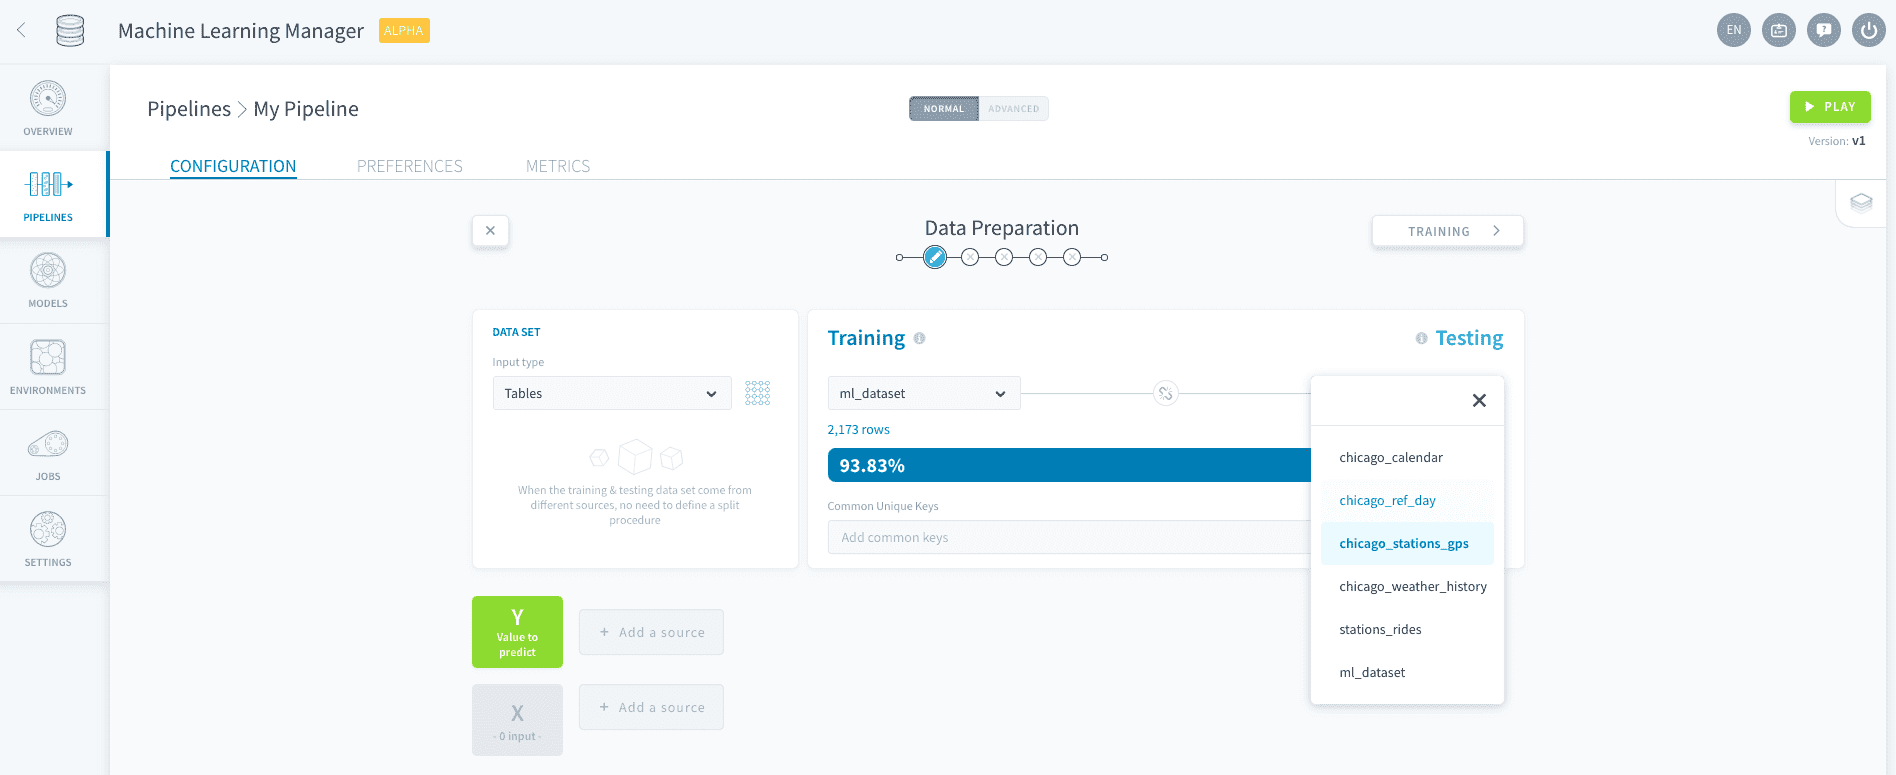
異なるソースを使用する場合、分割方法を指定する必要はありません。分割はすでに行われています!各入力データポイントは、トレーニングセットまたはテストセットのいずれかに適切に割り当てられます。
入力からデータポイントが削除されても、テストMLデータセットから個別に削除することはできません。パイプラインの設定でMLデータセットを手動でリセットするオプションがあります。
データセットの行を指定した後、列を指定する必要があります。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術的な支援が必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして見積もりを依頼し、当社のプロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼してください。
専用DiscordチャネルでData Platformを構築しているチームと直接質問し、フィードバックを共有し、交流してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。