カスタム PyTorch スクリプトをインポートする
Warning
このページでは、Machine Learning Managerについて説明します。これは、ForePaaS レガシー プラットフォームのサービスで、OVHcloud Data Platformでは利用できません。現在のドキュメントを参照してください。
PyTorch フレームワークを使用すると、PyTorch モデルと互換性のある Python の .py ファイルをアップロードできます。
このフレームワークを選択すると、パイプラインの環境にデフォルトで以下のパッケージがインポートされます:
カスタム スクリプトで使用するその他のライブラリは、Dependencies パネル の Python ライブラリ フィールドに指定する必要があります(最新バージョンを使用しない場合はバージョンも指定します)。
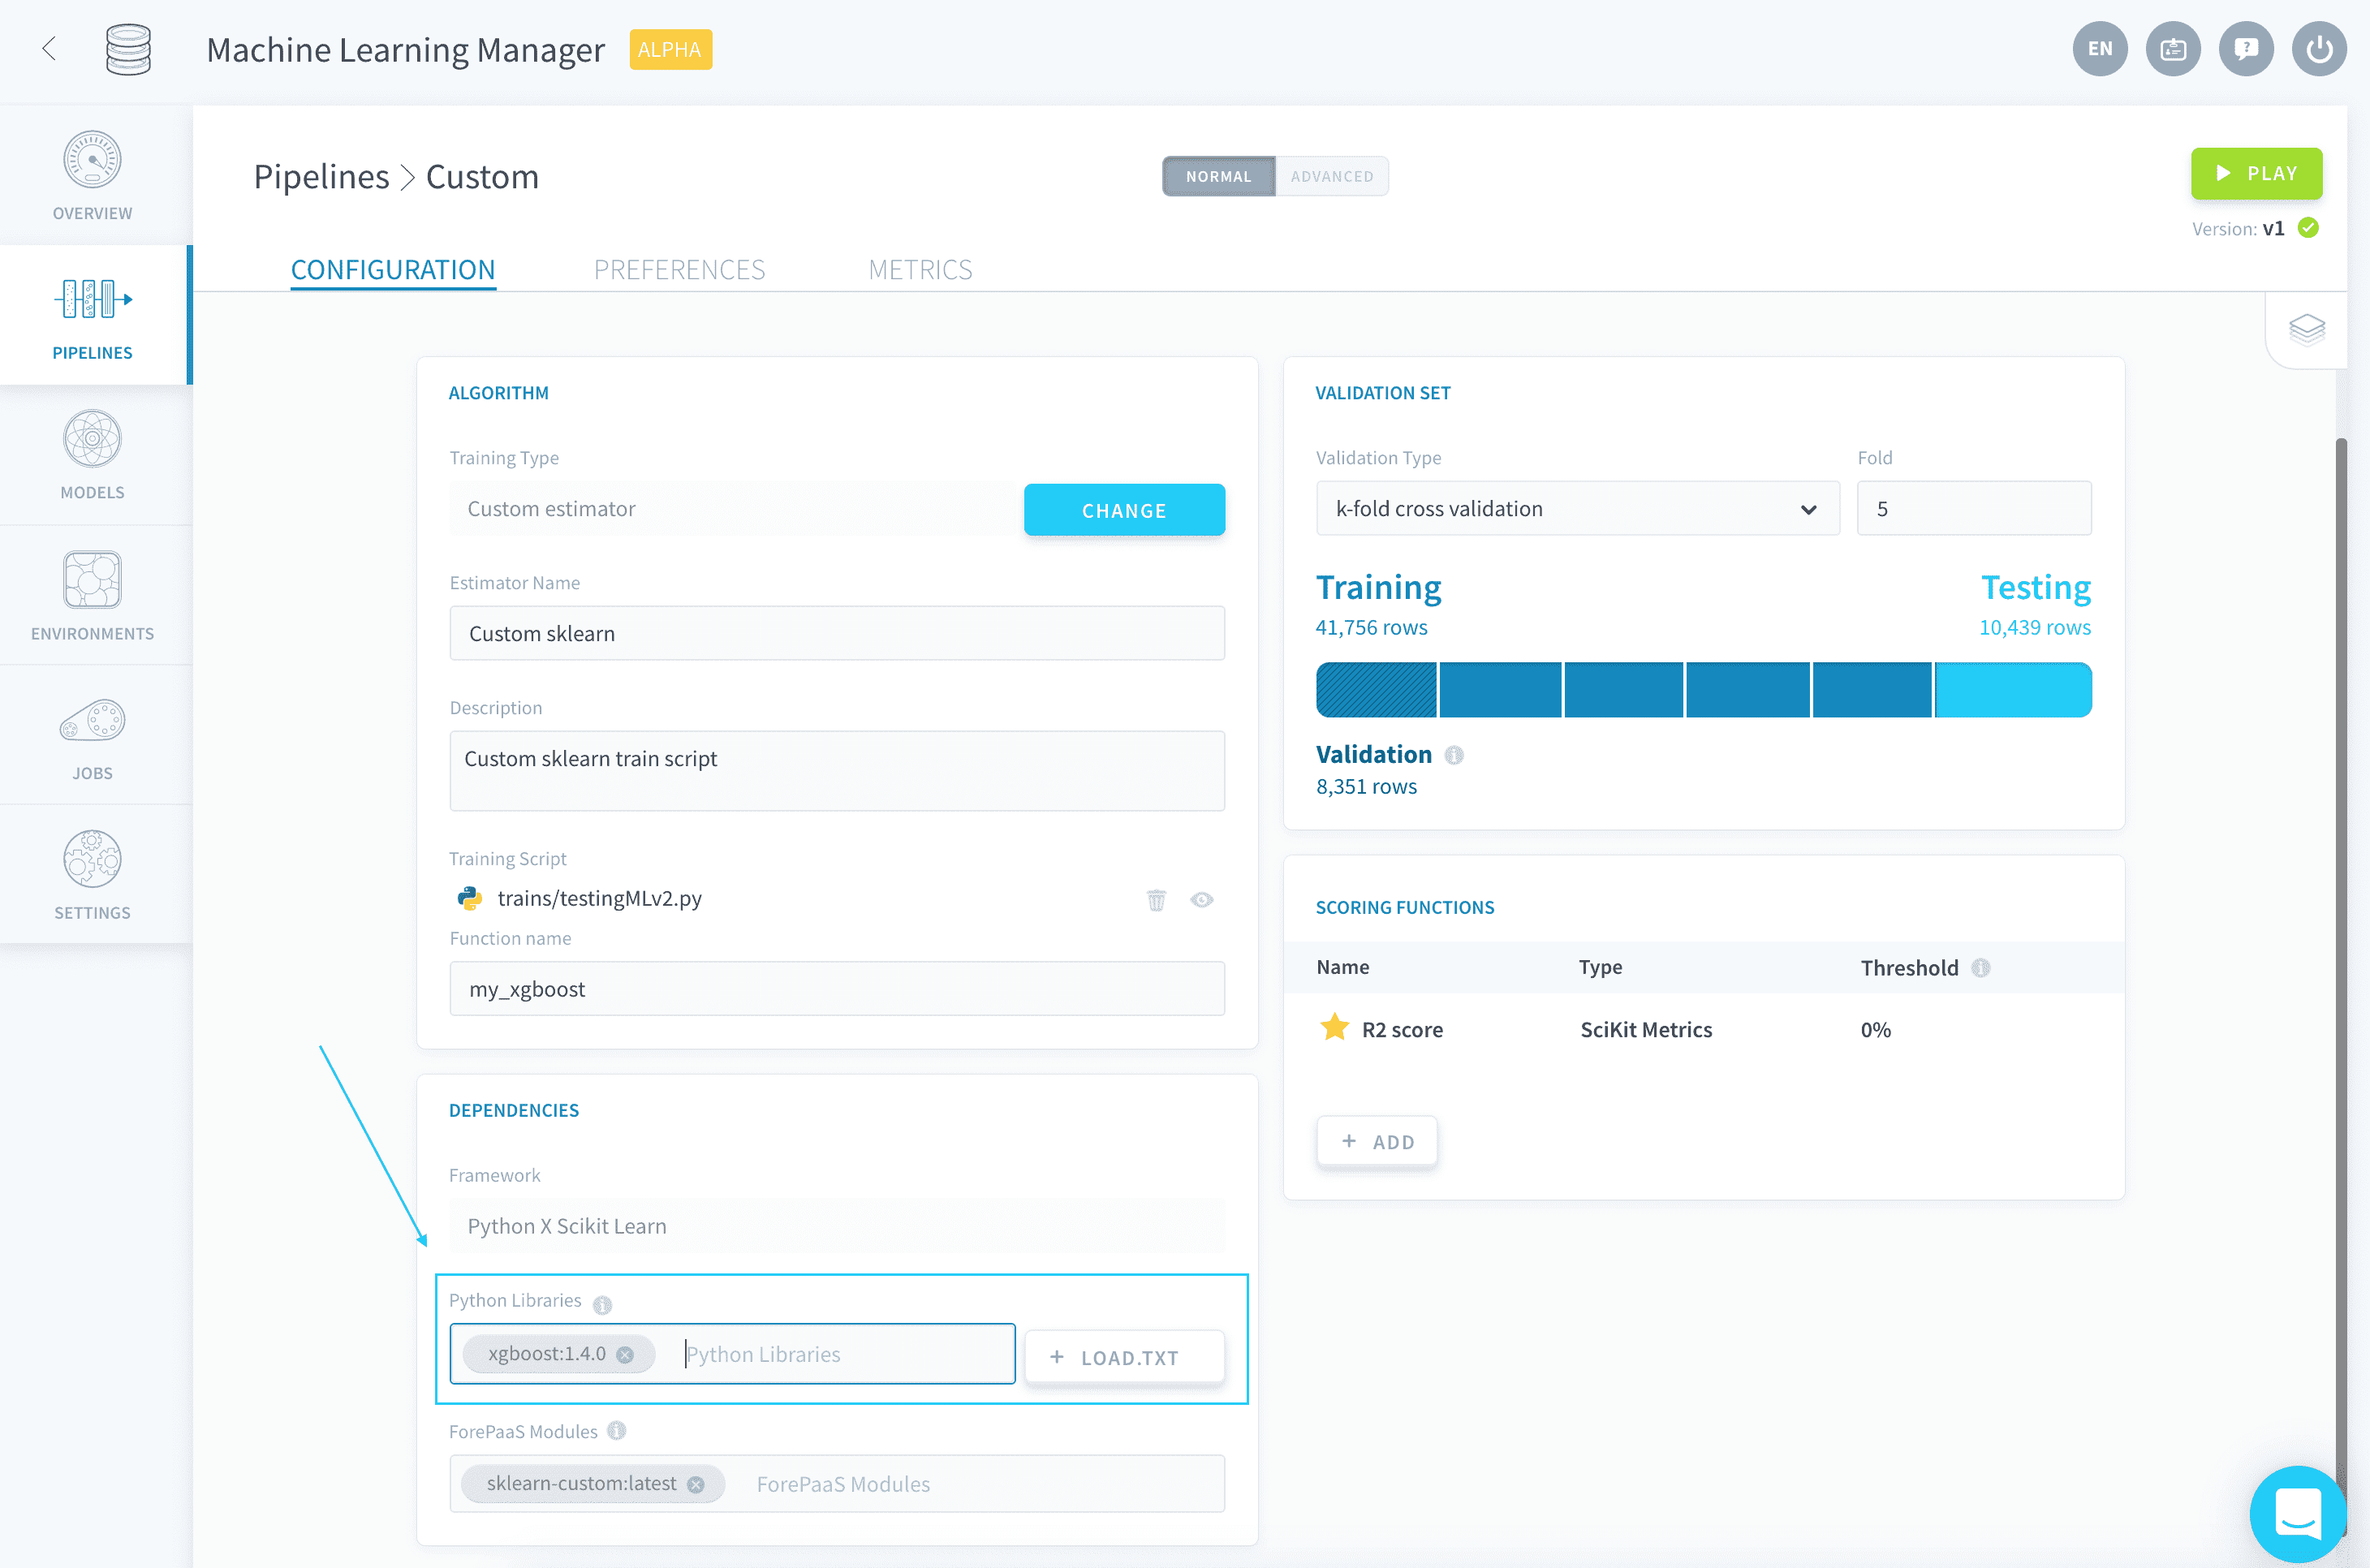
💡 requirements.txt ファイルを読み込んで、必要なライブラリを一括で追加することができます。
デフォルトでは、新しいパイプラインは Python 3.9.9 を使用します。
カスタム モデルをアップロードする
カスタム モデルをアップロードするには、トレーニング スクリプト ボックスに .py ファイルをドラッグするか、ボックスをクリックしてファイル エクスプローラーを開きます。
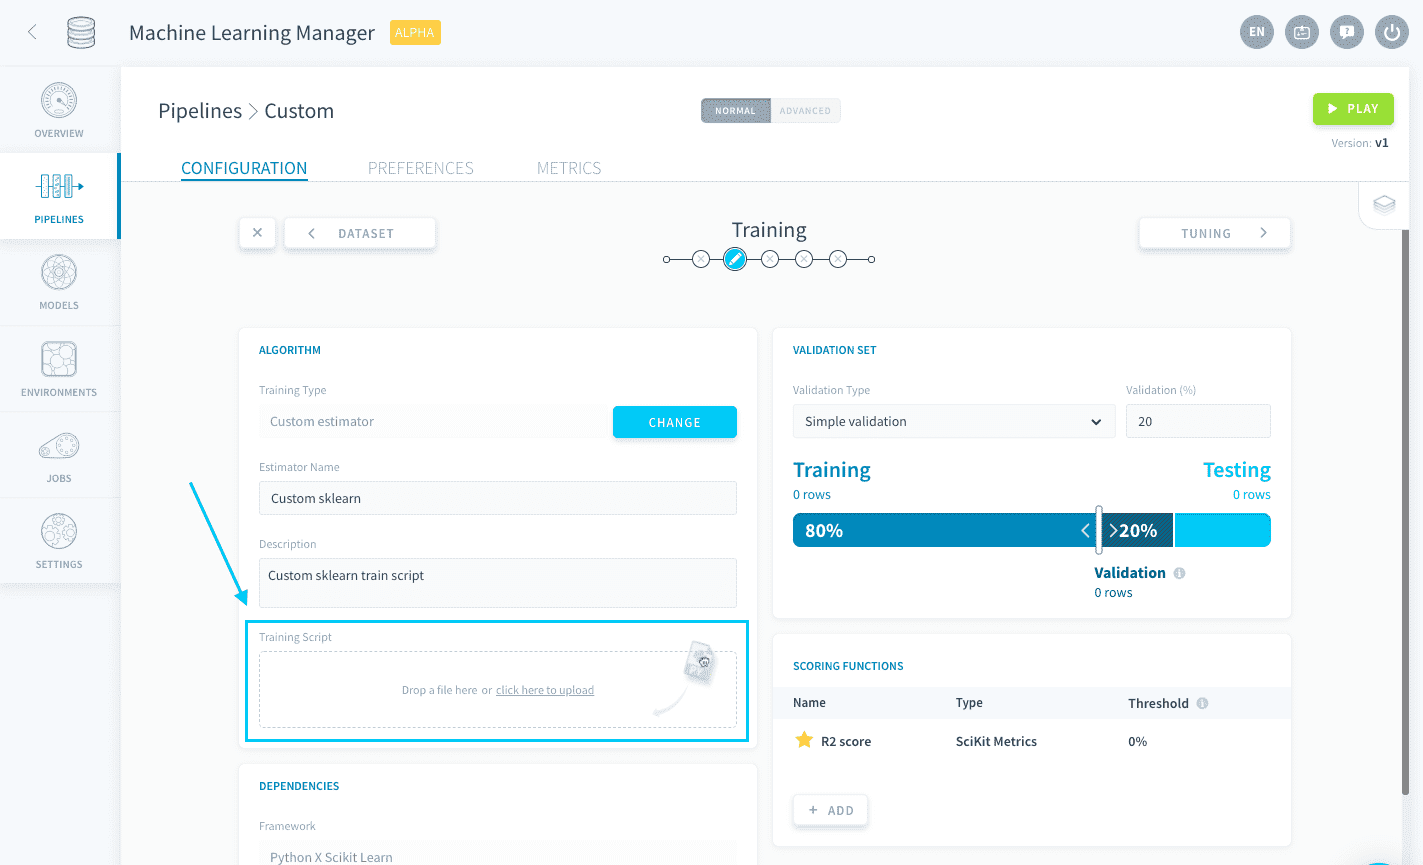
トレーニング ジョブが実行されると、この .py ファイルが実行されます。このファイルには、以下の 2 つの要件を満たす関数を含める必要があります:
- 最初の引数に
event があること
- トレーニング データセットに基づいてフィットされた PyTorch モデルを返すこと
この関数の名前は、function name ボックスに記入する必要があります。
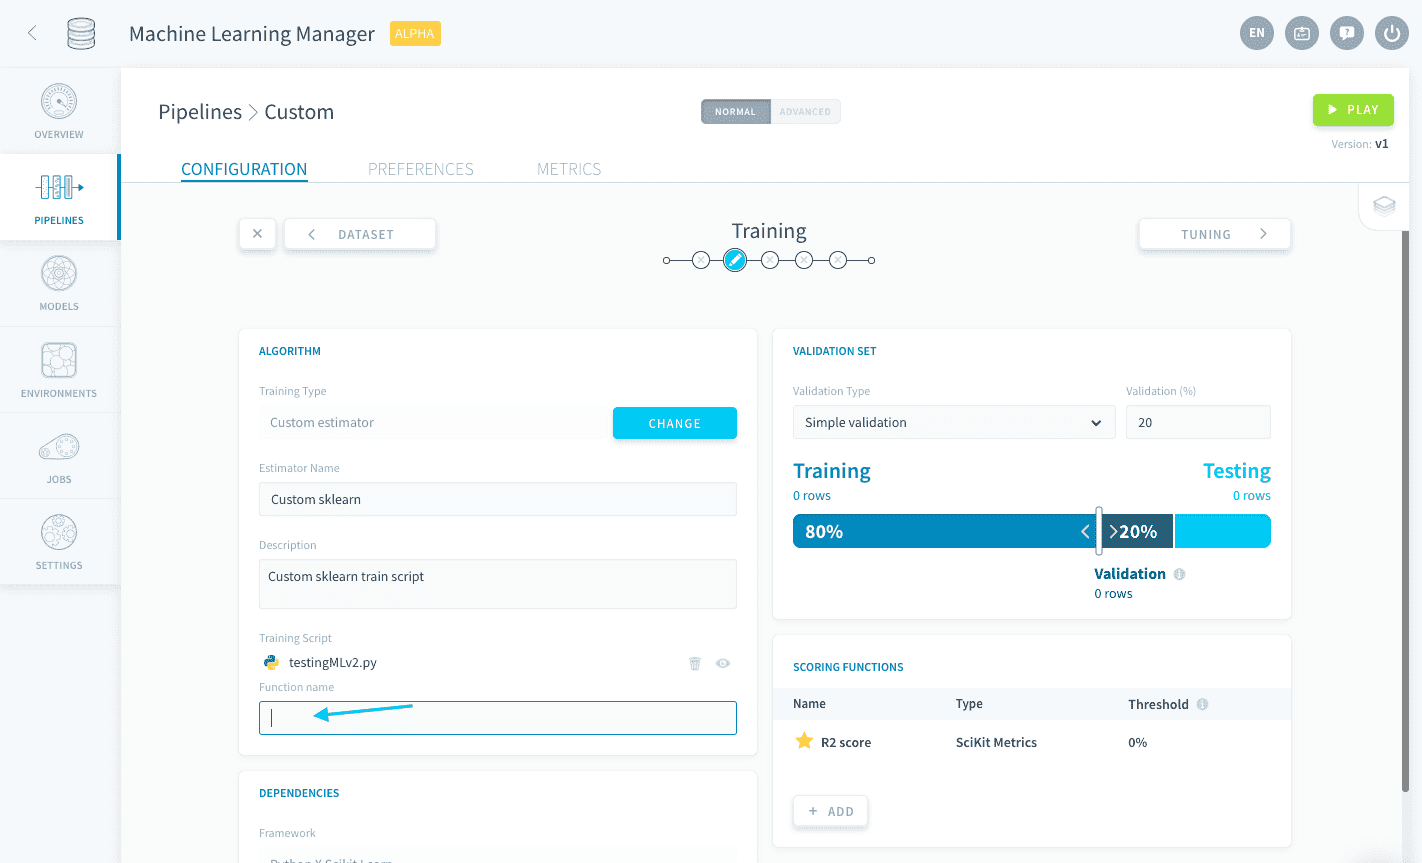
さらに、ForePaaS PyTorch フレームワークに固有のものとして、PyTorch モデルとデータセットのベース クラスをスクリプトに含める必要があり、他の関数やクラス内にネストできません:
torch.utils.data.Datasetnn.Module
子クラスの名前には制限があります。唯一の制約は、親クラスが前述のものであることです。両方を含める必要があります。失敗を避けるために。
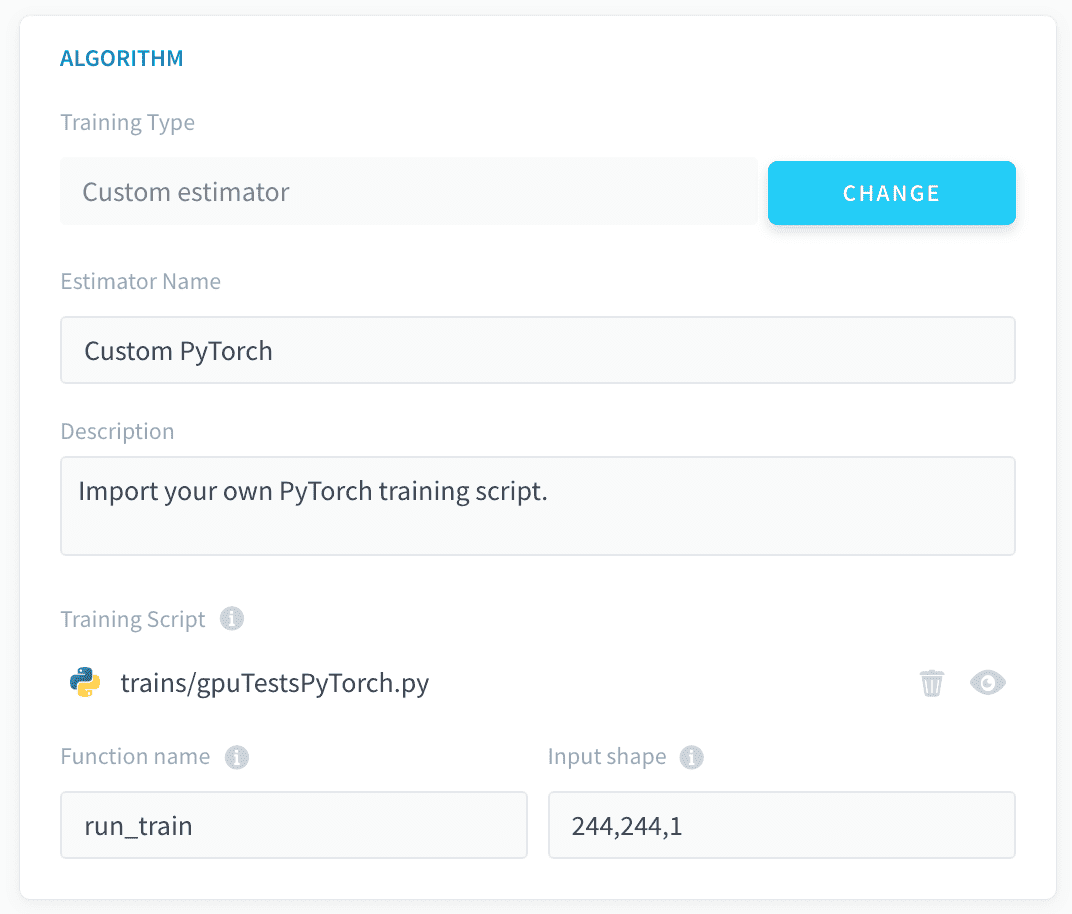
最後に、入力層の想定される次元は、実行する関数の名前とともに概要ページに提供する必要があります:
以下は、Getting Started チュートリアル データセットで使用されるカスタム PyTorch モデルのサンプル コードです。コードの構造に注意してください:
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
import torch.nn.functional as F
from torch.utils.data import Dataset, DataLoader

from logging import getLogger

logger = getLogger(__name__)


device = 'cuda' if torch.cuda.is_available() else 'cpu'

batch_size = 64
epochs = 5

# define structured dataset class
class TabularDataset(Dataset):
  def __init__(self, data, input_cols=None, output_col=None):
    self.n = data.shape[0]
    if output_col:
      self.y = data[output_col].astype(np.float32).values.reshape(-1, 1)
    else:
      self.y =  np.zeros((self.n, 1))
    if input_cols:
        self.x = data[input_cols].astype(np.float32).values
    else:
        input_cols = [col for col in data.columns if col != output_col]
        self.x = data[input_cols].astype(np.float32).values

  def __len__(self):
    return self.n

  def __getitem__(self, idx):
    return [self.y[idx], self.x[idx]]

# define model class
class Model(nn.Module):
    def __init__(self, in_features=13, h1=32, h2=8, out_features=1):
        # how many layers?
        super().__init__()
        self.fc1 = nn.Linear(in_features, h1)
        self.fc2 = nn.Linear(h1, h2)
        self.out = nn.Linear(h2, out_features)

    def forward(self, x):
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.out(x)
        return x


def pytorch_model_train(event):
    # forepaas get data
    x_df, y_df = get_train_dataset()

    data = pd.concat([x_df,y_df], axis=1)
    output_feature = "is_overcrowded"
    # get data
    train_data = TabularDataset(data=data,input_cols=None,output_col=output_feature)
    train_loader = DataLoader(dataset = train_data, batch_size=batch_size, shuffle=True )
    logger.info(len(train_data))

    model = Model().to(device)
    model.train()

    # some additional params
    criterion = nn.BCEWithLogitsLoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.1)

    for epoch in range(epochs):
        epoch_loss = 0
        epoch_accuracy = 0
        for y, x in train_loader:
            x = x.to(device)
            y  = y.to(device)
            # Forward Pass
            preds = model(x)
            loss = criterion(preds, y)
            # Backward Pass and Optimization
            optimizer.zero_grad()
            loss.backward()
            optimizer.step()

            acc = ((preds.argmax(dim=1) == y).float().mean())
            epoch_accuracy += acc/len(train_loader)
            epoch_loss += loss/len(train_loader)
        logger.info('Epoch : {}, train accuracy : {}, train loss : {}'.format(epoch+1, epoch_accuracy,epoch_loss))

    return model
上記のコードを使用する場合、pytorch_model_train を function name として、13,1 を input_shape として指定する必要があります。
前のコードでは、トレーニングとチューニングのステップで行った設定のいずれも使用できませんが、ForePaaS SDKを使用して、モデルからパイプライン設定の他の部分に接続できます。これにより、カスタム エスティメーターで ForePaaS パイプラインが提供するすべての機能を使用できます。
以下の設定を統合できます:
!>
トレーニング ジョブ中にカスタム .py スクリプトのみが実行されるため、Python スクリプトに前述の設定を統合しなかった場合、パイプラインはインターフェースからの変更を無視します。
非構造化データのトレーニングに PyTorch を使用する
Machine Learning Manager は、PyTorch モデルのトレーニングと予測で画像分類をサポートします。
データ準備
非構造化データのトレーニングを有効にするには、まず画像を 各クラスの名前が付いたフォルダー にアップロードする必要があります。
非構造化データの準備方法を学ぶ
トレーニング
トレーニング中、SDK メソッド get_train_dataset と get_test_dataset は 構造化データと異なる動作をします。これらは、トレーニング画像へのパスと関連付けられたラベル(.txt ファイルとして)を含む 2 つの 1 列の DataFrame を返します。画像とラベルの列名はそれぞれ input と output です。
Warning
ラベルは、バケット内の順序に基づいて整数として返されます。これは通常、アルファベット順です。
そのため、PyTorch データセット クラス内で画像とラベルを読み込み、処理する必要があります。以下のサンプル コードに示すように。
train_transforms =  transforms.Compose([
        transforms.Resize(150),
        transforms.RandomResizedCrop(150),
        transforms.ToTensor(),
    ])

class dataset(torch.utils.data.Dataset):
    def __init__(self,image_list,label_list,transform=None):
        self.file_list_df = image_list
        self.label_list_df = label_list
        self.transform = transform

    def __len__(self):
        self.filelength = len(self.file_list_df)
        return self.filelength

    def __getitem__(self,idx):
        file_list = self.file_list_df["input"].values.tolist()
        img_path = file_list[idx]
        img = Image.open(img_path)
        resized_img = img.resize((vertical_px, horizontal_px))
        img = resized_img.convert(mode='L')
        image_2_npArray_2_tensor = transforms.ToTensor()(img)
        label_list = self.label_list_df["output"].values.tolist()
        with open(label_list[idx],'r') as file:
            label = int(file.read())
        return image_2_npArray_2_tensor,torch.tensor(label)

...


def pytorch_train(event):
    # forepaas get data
    x_df, y_df = get_train_dataset()
    train_feature,val_feature,train_label,val_label= train_test_split(x_df, y_df, test_size=0.2)

    # get data
    train_data = dataset(train_feature,train_label)
    val_data = dataset(val_feature,val_label, transform=test_transforms)
    ...
Warning
非構造化データ モデルが予測に使用される場合、実際の非構造化オブジェクト(画像など)を入力する必要があります。プラットフォームは自動的にそれらを「NumPy 化」し、標準化/正規化を適用します。そのため、ニューラル ネットワーク スクリプトの入力層に入るデータも正規化する必要があります。
その後、event をメソッドの唯一の引数として、PyTorch モデルの残りの部分を追加できます:
💡 カスタム .py に複数のメソッドを含めることができます。UI の function name フィールドで指定したメソッドのみが実行されます。
ForePaaS パイプラインで GPU を使用してニューラル ネットワークのトレーニングを加速 できます。詳細については、以下のリンクを参照してください。
ML 処理に GPU を使用する

