

データ準備
このページでは、ForePaaS Legacy PlatformのサービスであるMachine Learning Managerについて説明しています。このサービスはOVHcloud Data Platformでは利用できません。最新のドキュメントを参照してください。
データ準備は、機械学習プロセスの最初のステップです。このステップでは、データソースと、それをMLデータセットに変換するためのルールを指定します。MLデータセットは、Data Managerに自動的に作成されるテーブルとしてモデル化され、パイプラインの入力で指定されたソースからのデータでフィードされます。これらのテーブルの行と列を指定することが、データ準備ステップの核心です。
データのバージョン管理をより良くオーケストレーションするため、データはMLデータセットにのみ追加できます。パイプラインの設定で、MLデータセットを手動でリセットするオプションがあります。
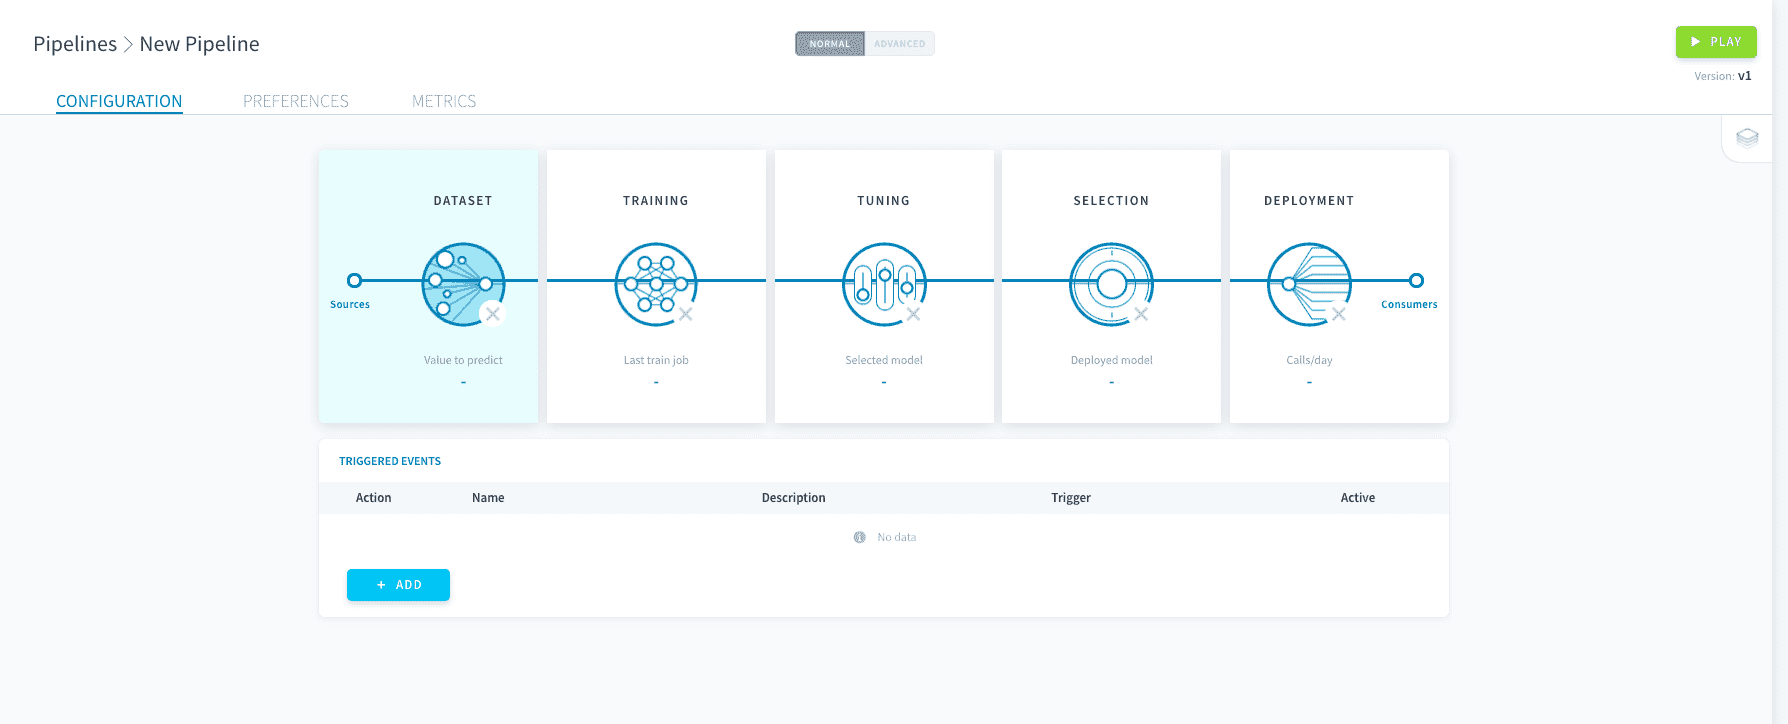
データ準備は、通常、最初にパラメータ設定する必要があるステップです。パイプラインの残りの部分は、この選択に基づいて設計される必要があるためです。データ準備に入るには、パイプラインのメインページでDatasetをクリックします。
データセット生成
パイプラインの入力ポイントで、ForePaaS内外の複数のソースからデータを接続できます。このデータは、モデルをフィットさせ、評価するために、トレーニング用とテスト用のデータセットに分割する必要があります。
特徴量エンジニアリング
良いデータ準備とは、モデルに適した特徴量を選択することです。XとYのセットに変数を追加する方法と、データ内容に対して基本的なチェックを実行する方法を学びます。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして見積もりを取得し、当社のプロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼してください。
専用Discordチャネルで、Data Platformを構築するチームと直接質問し、フィードバックを共有し、交流してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。