

ソース行をチャンク化してセグメントを発見する
時にはCSVファイルが大きすぎて吸収できないことがあります。その場合、行数に基づいてセグメント化することで、総読み込み速度を向上させることができます
目的
時にはCSVファイルが大きすぎて吸収できないことがあります。その場合、行数に基づいてセグメント化することで、総読み込み速度を向上させることができます。
必要条件
このセグメント化タイプを使用する前に、以下の点を確認する必要があります:
1. 同じステージで多くのタスクを生成しないようにする
Data Processing Engine(DPE)が良好に動作するように、500を超えるタスクを持つステージを作成しないことをお勧めします。
これは厳密な制限ではありませんが、500を超えるタスク数が増えるにつれてパフォーマンスの低下が観察されることがあります。 タスク数を減らすには、バケットサイズを大きく設定し、各タスクがより多くの行を処理できるようにすることができます。(つまり、最終的にはタスク数が少なくなります)
各タスクごとに、ソースCSVファイルがデータストアの一時的なバケットから各ワーカーに再度アップロードされることを忘れないでください。したがって、CSVファイルが大きい場合は、タスク数を少なく保つことをお勧めします。理想的には、タスク数はジョブが持つワーカー数と同じであるべきです。
2. 目的地のデータベースに十分なCPUがあるか?
insert操作は、DBMSにとってCPU集約的であることを忘れないでください。- 例えば、データベースにCPUが1つしかない場合、DBMSインスタンスに対して同時に6つのワーカーを設定して挿入するのは良いアイデアではありません...
一般的なルール:各ワーカーが同時に実行されるごとに1つのCPUが利用可能である必要があります。
互換性
このタイプのセグメント化の使用方法
以下は、表示モードと高度なJSONモードの間のクイックビューです。
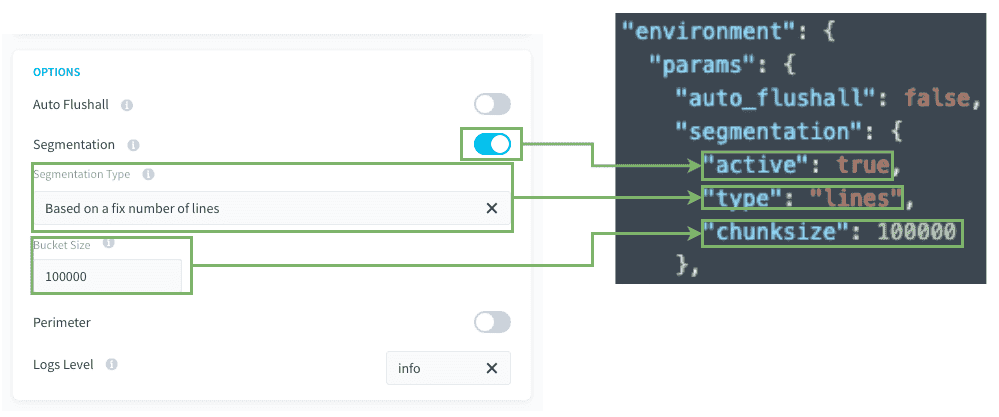
バケットサイズ / チャンクサイズ: 各タスクで吸収される行数を設定します。
読み込みアクション
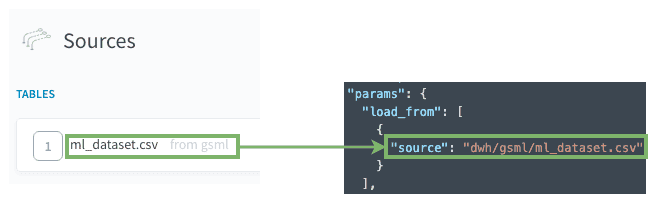
Load action sourceがセグメント化の基礎となります。
カスタムアクション
キーparams.load_from[0].sourceがソースのアドレスを示していることを確認してください:
dwh/SOURCE_NAME/FILE_NAME または TABLE_NAME
前のスクリーンショットを確認して、高度なJSONモードの例をご覧ください。
バックエンドでどう動作するのか?
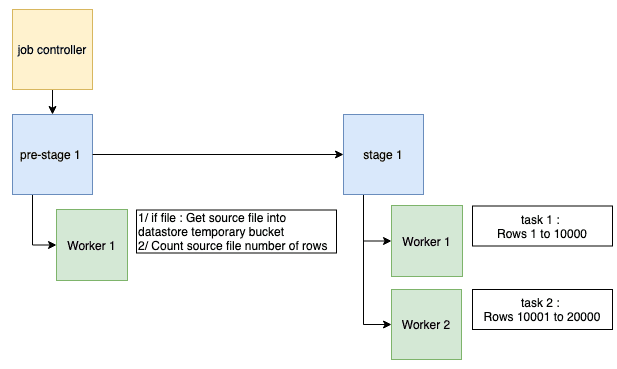
アクションに固定行数に基づくセグメント化がある場合、 アクションを実行するか、ワークフロー内のアクションを実行すると、以下が実行されます:
- CSVソースファイルを取得し、その行数をカウントし、オブジェクトストアの一時的なバケットに配置する隠しプレステージ。
- ジョブコントローラーは、異なる行チャンクを吸収する複数のタスクにアクションを分割します。
- そして、各ワーカーが各タスクを順番に実行します。
さらに深く掘り下げる
当社のソリューションのトレーニングや技術的なアシスタンスが必要な場合は、営業担当者にお問い合わせください、またはProfessional Servicesページをご覧ください。見積もりをリクエストして、当社の専門家にプロジェクトを分析してもらうことができます。
Discord専用チャンネルDiscord channelでData Platformを構築するチームと直接質問し、フィードバックを共有し、交流してください。
OVHcloudサービスについてサポートが必要な場合は、Help Centreでリクエストを作成してください。
コミュニティに参加してください。