

カスタム Keras スクリプトをインポートする
このページでは、OVHcloud Data Platformでは利用できないForePaaSレガシープラットフォームのサービスであるMachine Learning Managerについて説明しています。最新のドキュメントを参照してください。
Kerasフレームワークを使用すると、Kerasライブラリと互換性のあるKerasシーケンシャルモデルを含むPythonの.pyファイルをアップロードできます。
このフレームワークを選択すると、パイプラインの環境にデフォルトで以下のパッケージがインポートされます:
- Keras
- Tensorflow
- ForePaaSのSDKに付属するライブラリ
カスタムスクリプトで使用するその他のライブラリは、DependenciesパネルのPythonライブラリフィールドに指定する必要があります(最新版を使用しない場合はバージョンも指定してください)。
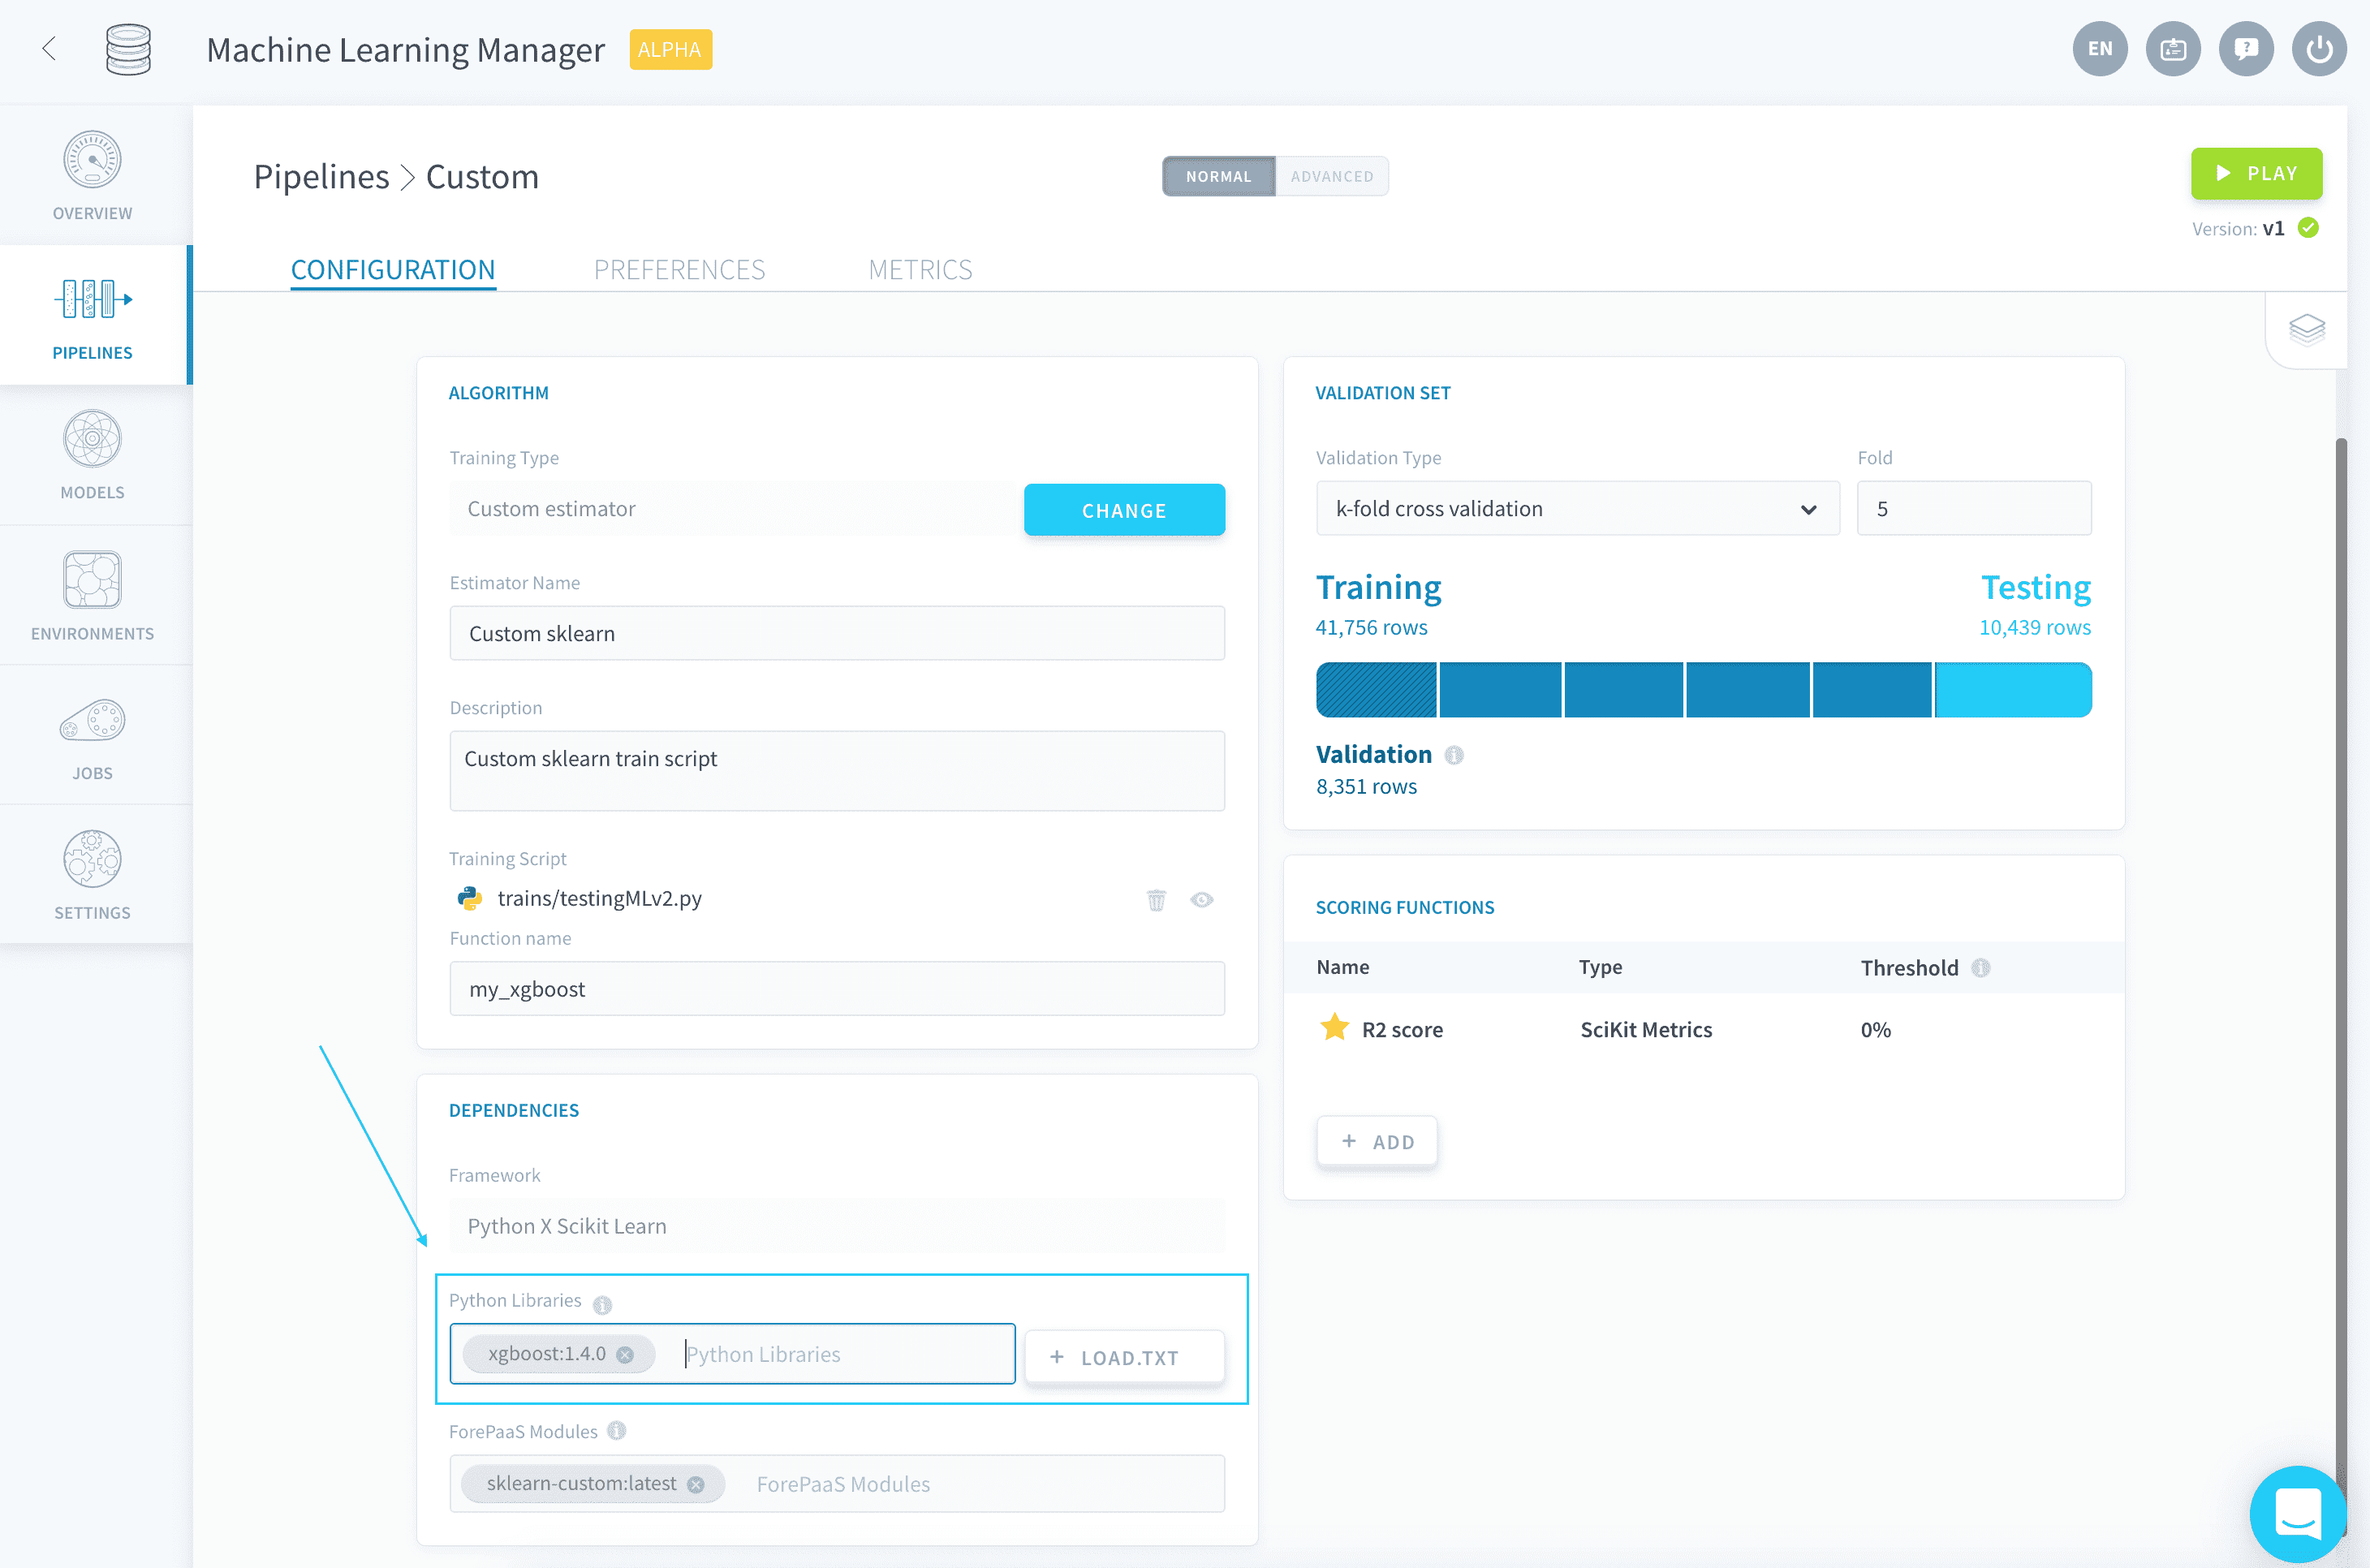
💡 必要なライブラリを一括で追加するには、requirements.txtファイルを読み込むことができます。詳細。
デフォルトでは、新しいパイプラインはPython 3.9.9を使用します。
カスタムモデルをアップロードする
カスタムモデルをアップロードするには、トレーニングスクリプトボックスに.pyファイルをドラッグするか、ボックスをクリックしてファイルエクスプローラーを開きます。
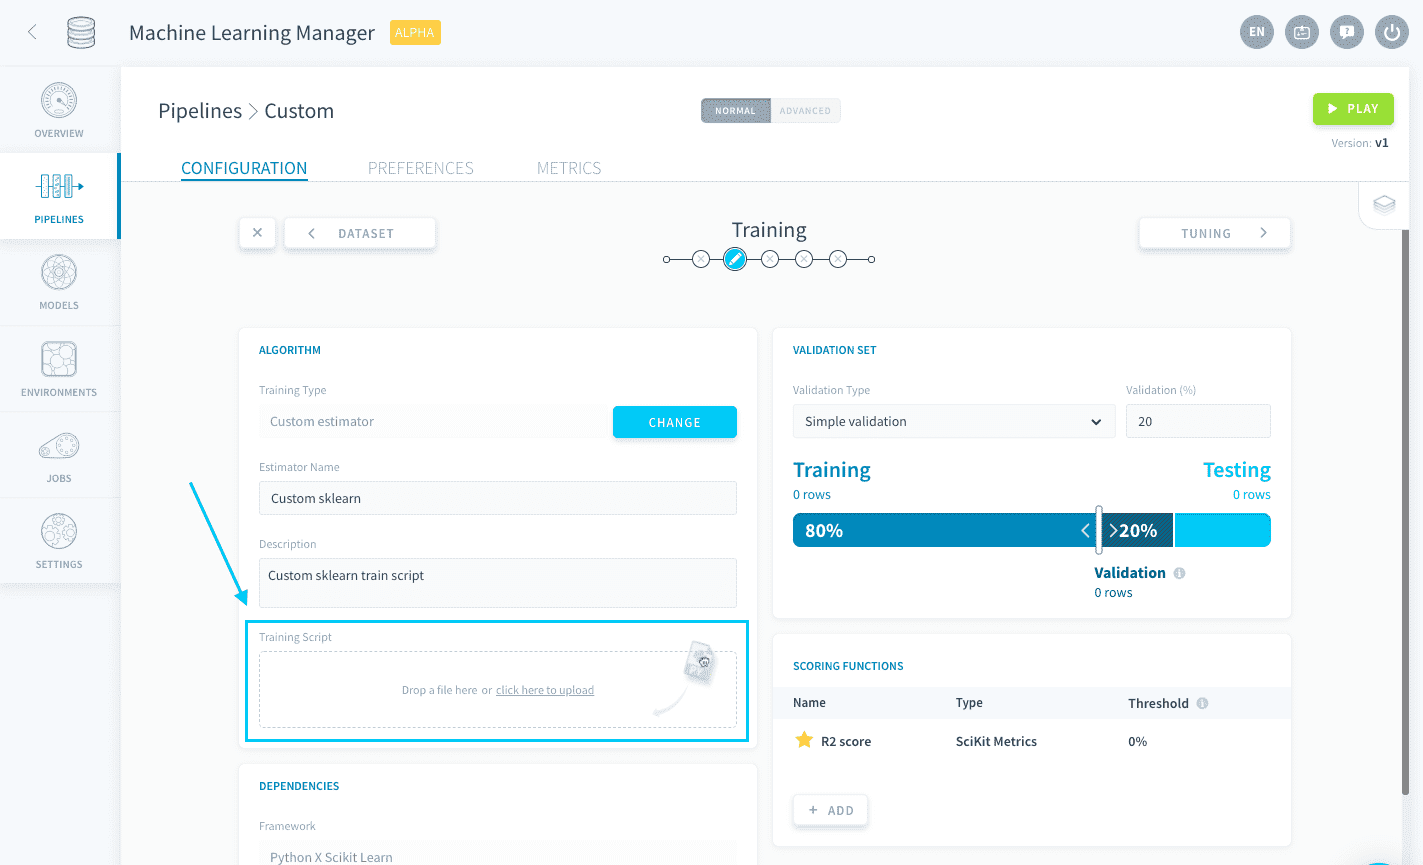
トレーニングジョブが実行される際に、この.pyファイルが実行されるファイルです。このファイルには、以下の2つの要件を満たす関数を含める必要があります:
- 最初の引数として
eventを指定する必要があります - トレーニングデータセットに基づいてフィットされ、コンパイルされたシーケンシャルモデルを返す必要があります
この関数の名前は、function nameボックスに記入する必要があります。
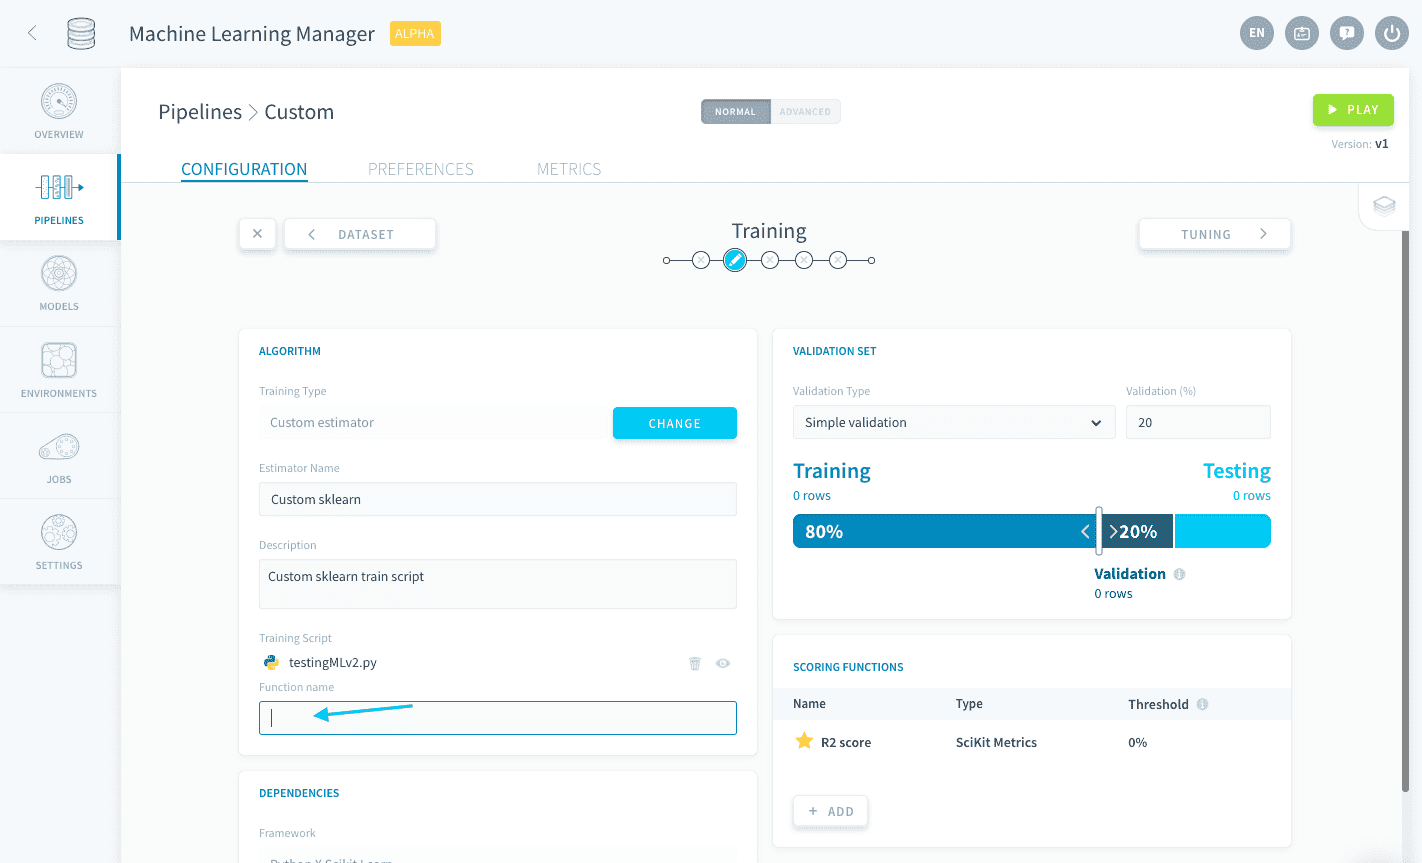
以下は、my_keras_modelを関数名として使用する基本的なカスタムKerasモデルのサンプルコードです:
プラットフォームがライブラリのインポートを処理する方法のため、keras``` library by ```tensorflowからのインポートにはプレフィックスを付ける必要があります。
前のコードでは、トレーニングとチューニングのステップで行った設定のいずれも使用できませんが、ForePaaS SDKを使用して、モデルからパイプライン設定の他の部分に接続することができます。これにより、カスタムエスティメーターでForePaaSパイプラインが提供するすべての機能を使用できます。
以下の設定を統合できます:
!> トレーニングジョブ中にカスタム.pyスクリプトのみが実行されるため、Pythonスクリプトにこれらの設定を統合しなかった場合、パイプラインはインターフェースからの変更を無視します。
非構造化データのトレーニングにKerasを使用する
Machine Learning Managerは、Kerasモデルのトレーニングと予測において画像分類をサポートしています。
データ準備
非構造化データのトレーニングを有効にするには、まず画像を各クラスの名前が付いたフォルダにアップロードする必要があります。
トレーニング
トレーニング中、SDKメソッドget_train_datasetとget_test_datasetは構造化データと異なる動作をします。これらは、トレーニング画像へのパスと関連ラベル(.txtファイルとして)を含む2つの1列のDataFramesを返します。画像とラベルの列名はそれぞれinputとoutputです。
ラベルは、バケット内の順序に基づいて整数として返されます。これは通常、アルファベット順です。
そのため、画像とラベルを読み込み、処理する必要があります。以下のサンプルコードに示すようにです:
非構造化データモデルが予測に使用される場合、実際の非構造化オブジェクト(画像など)を入力する必要があります。プラットフォームは自動的にそれらを「NumPy化」し、標準化/正規化を適用します。そのため、ニューラルネットワークスクリプトの入力層に入るデータも正規化する必要があります。
その後、eventをメソッドの唯一の引数として、Kerasモデルの残りの部分を追加できます:
💡 カスタム.pyに複数のメソッドを含めることができます。UIを通じて
function nameフィールドに指定したメソッドのみが実行されます。
ニューラルネットワークのトレーニングをGPUを使用して加速できます。以下のリンクをクリックして詳細を確認してください。