

Spark History Server
PySparkベースのアクション(PySparkの読み込み、PySparkの集計、カスタムPySpark)およびそれらを実行するワークフローに適用されます
目的
Spark History Serverを使用すると、Data Processing Engineから直接Sparkジョブの実行履歴を確認できます。外部ツールを設定する必要はありません。
これは、PySparkベースのアクション (PySparkの読み込み、PySparkの集計、カスタムPySpark およびそれらを実行するワークフローに適用されます。ノートブック は対象外です。
有効にすると、各PySparkジョブはイベントログを記録します。必要に応じてサーバーを起動し、最近の実行をブラウズし、各実行のSpark UI(ライブまたは完了)を開き、DataFlintで分析し、保持ルールを適用してストレージを制御します。
サーバーは実行時間に応じてDPU単位で課金されます。サーバーは必要に応じてのみ実行され、不活性期間後に自動的にシャットダウンされるため、アイドル時間は課金されません。
サーバーの開始と停止
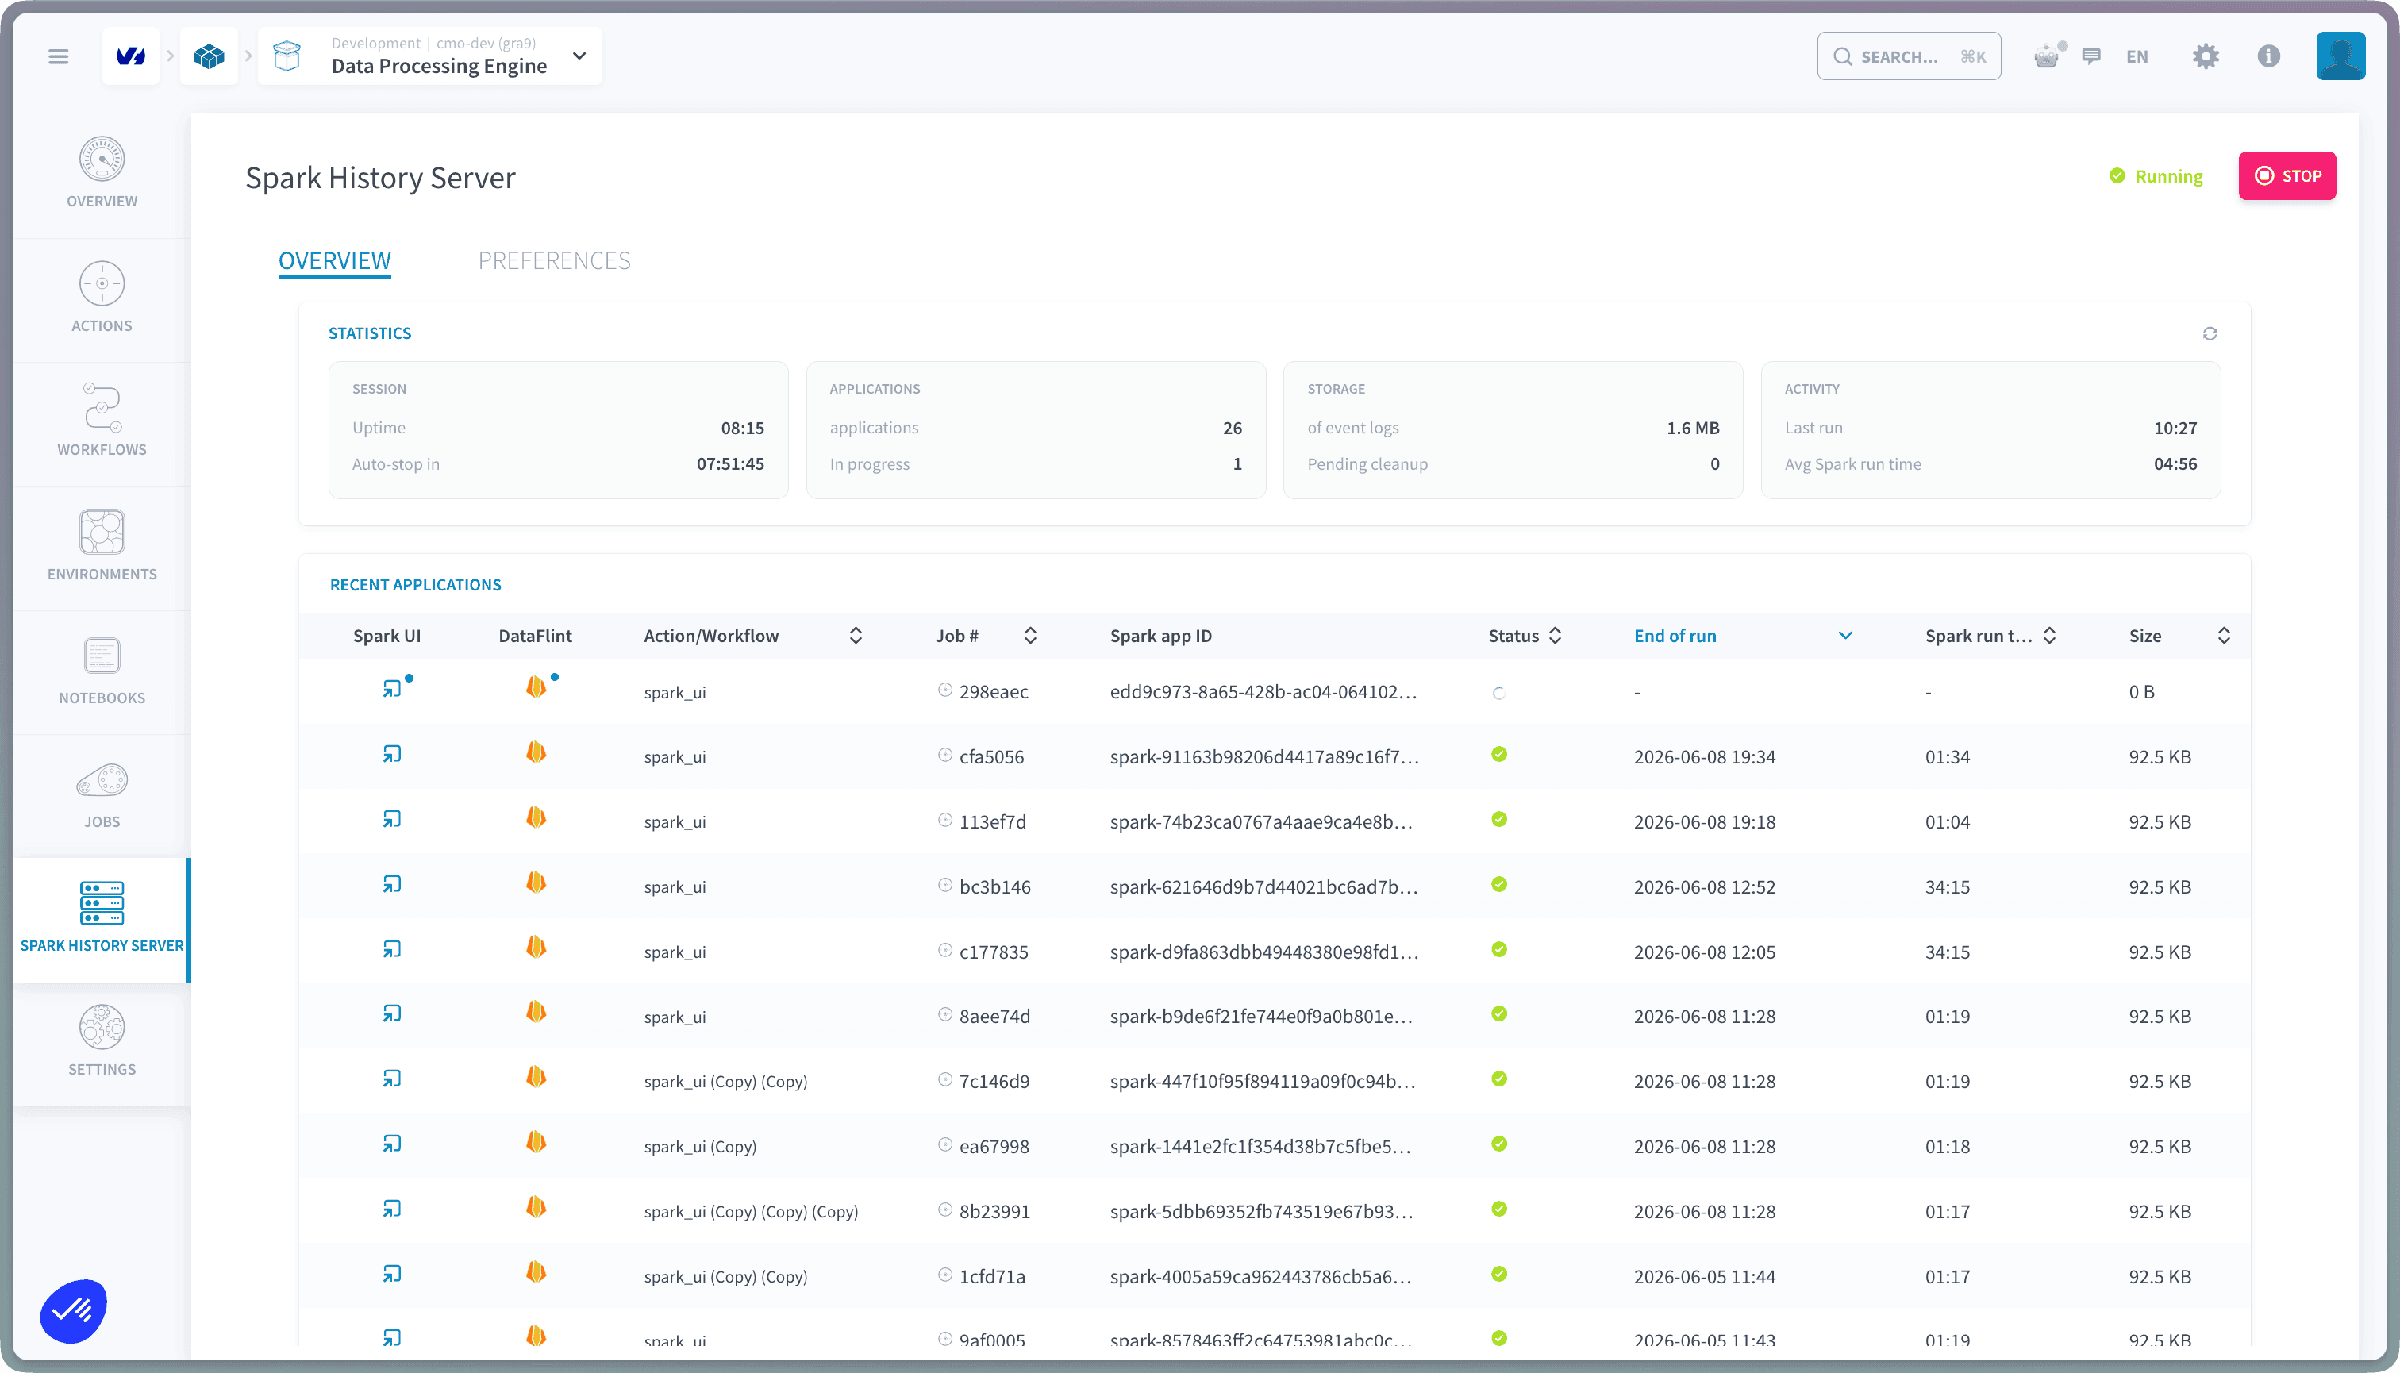
History Serverは必要なときのみ実行されます。開始ボタンをページ右上にあるページの右上にある開始ボタンを使用して起動します。その状態(停止中/実行中)、アップタイム、および自動停止までの時間は、その横に表示されます。
サーバーは設定で設定された不活性期間後に自動的に停止するため、必要以上に長時間実行されることはありません。また、いつでも手動で停止することもできます。
概要
概要タブでは、環境をまとめ、最近のSpark実行を一覧表示できます。
統計
統計パネルでは、環境のスナップショットを確認できます。
- アプリケーション: アプリケーションの総数と現在進行中のアプリケーションの数。
- ストレージ: 保存されたイベントログの総サイズとクリーンアップ待ちの量。
- アクティビティ: 最後の実行時間と平均Spark実行時間。
最近のアプリケーション
最近のアプリケーションテーブルでは、アクションまたはワークフロー名、ジョブ番号、SparkアプリID、状態、実行終了時間、Spark実行時間、およびサイズを含む最新のSpark実行を一覧表示できます。
各行からは、1クリックでアクセスできます。
- Spark UI: ステージ、タスク、実行詳細を探索するための標準Sparkインターフェース。
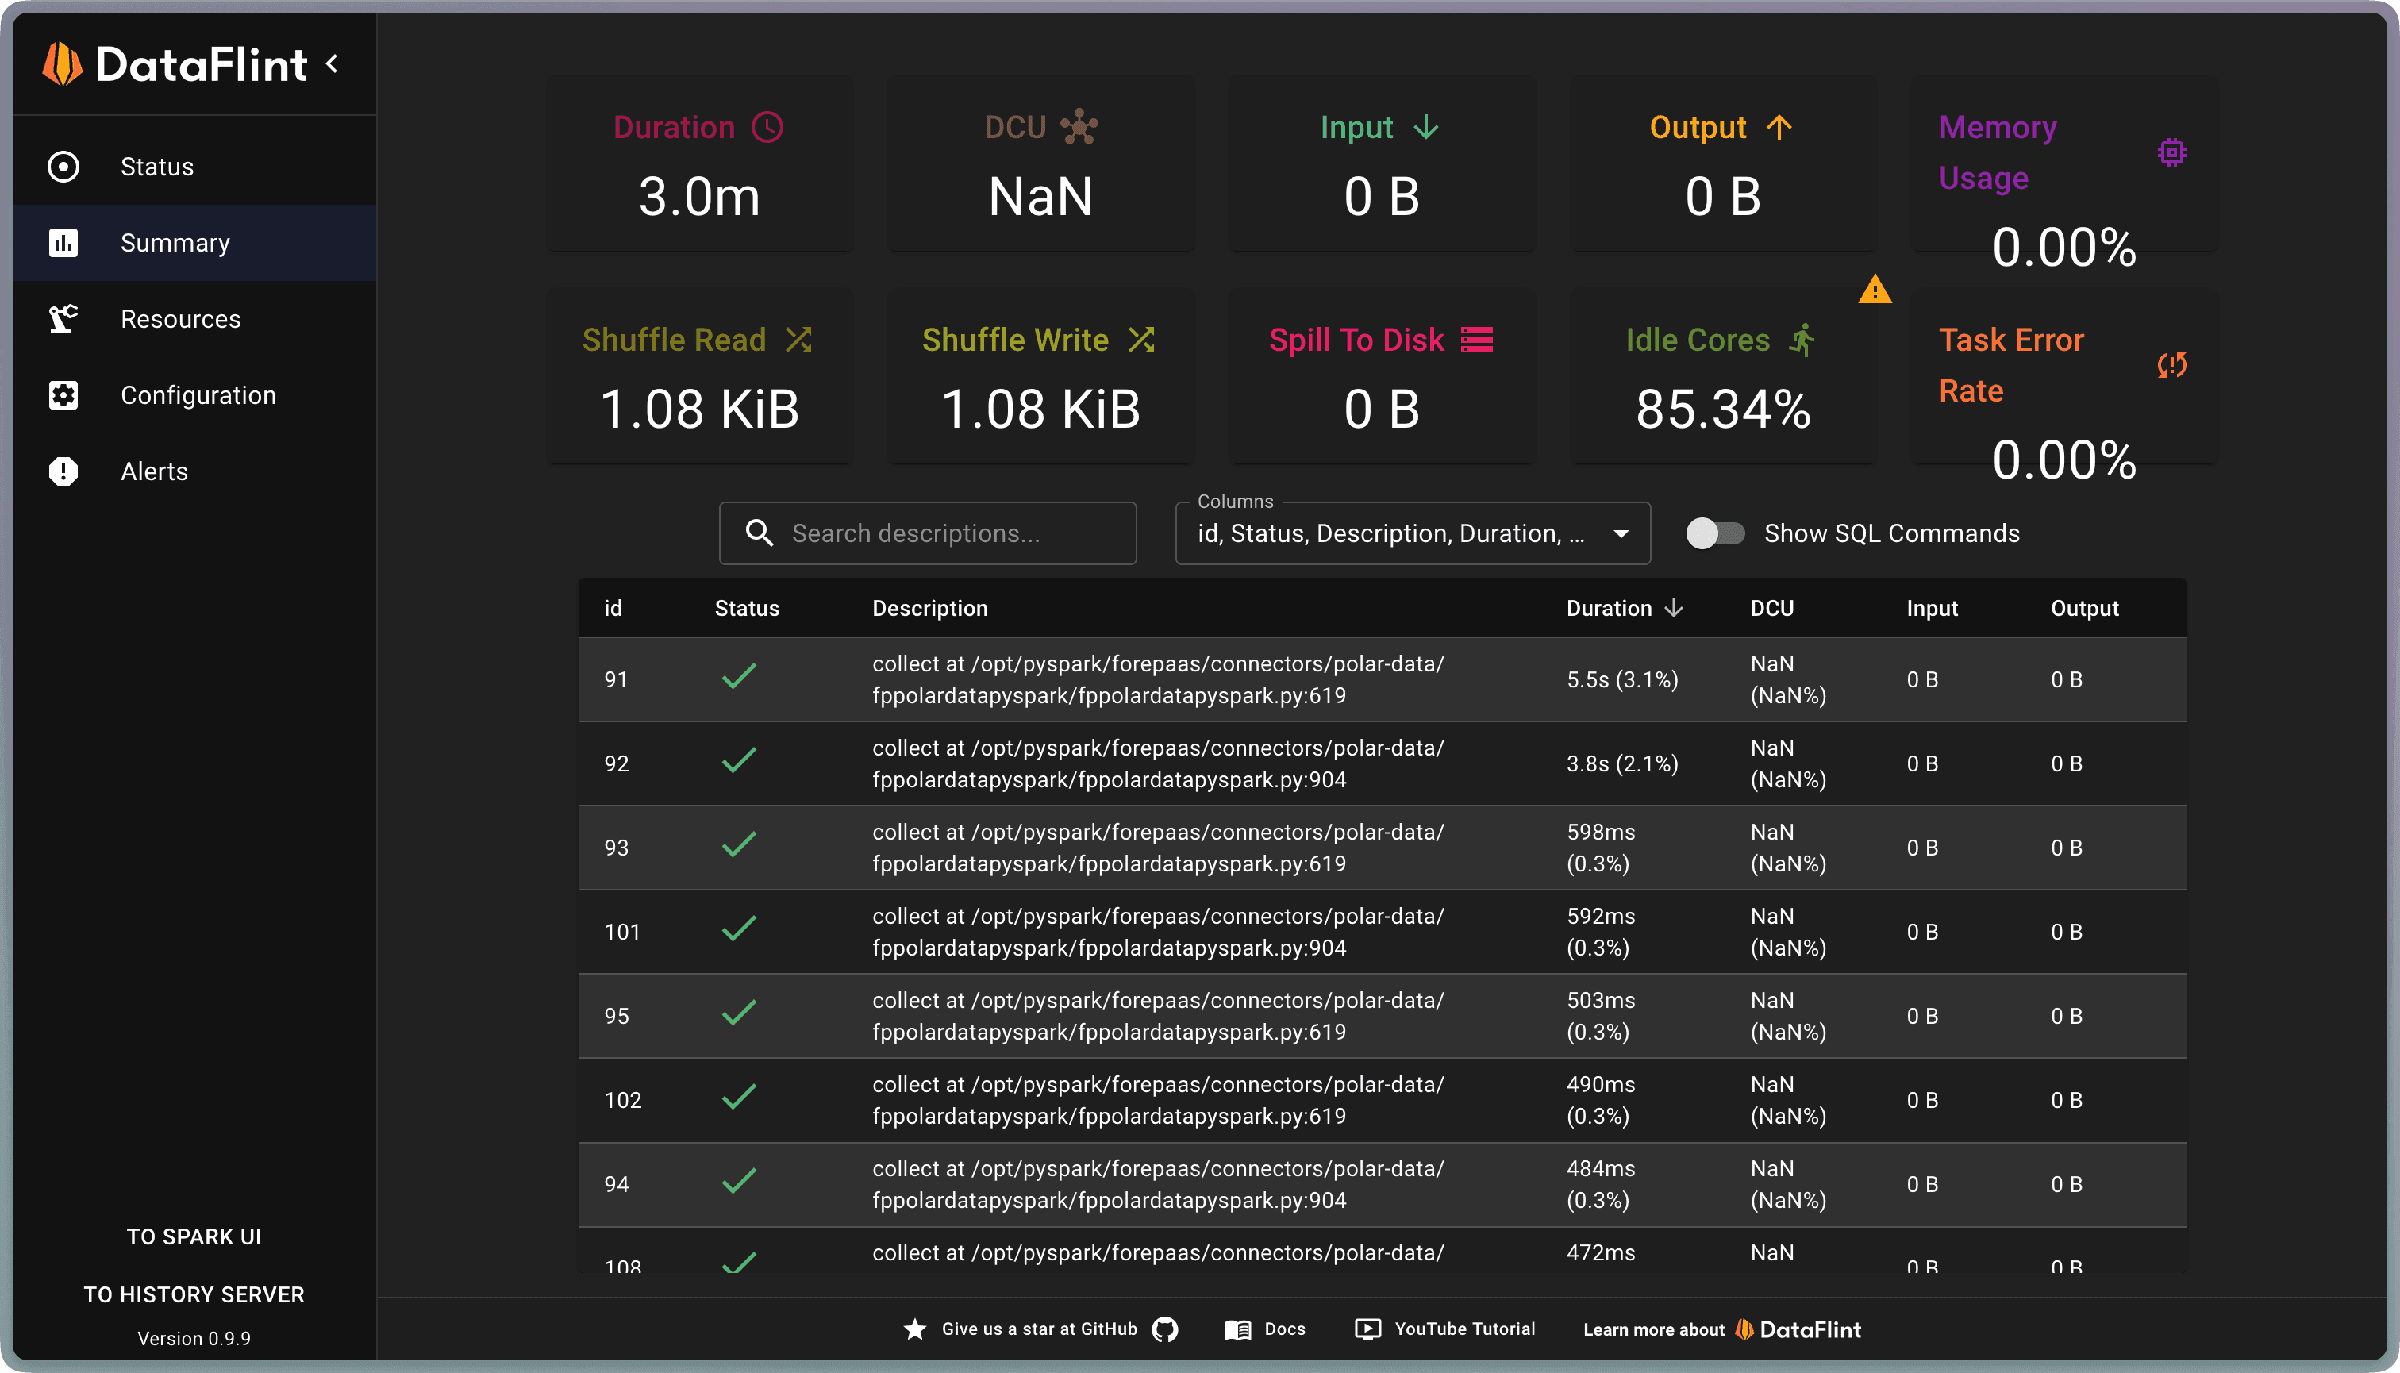
- DataFlint: オープンソースのDataFlintプロジェクトによって提供されるパフォーマンスの洞察と最適化のヒントを備えた強化された分析ビュー。
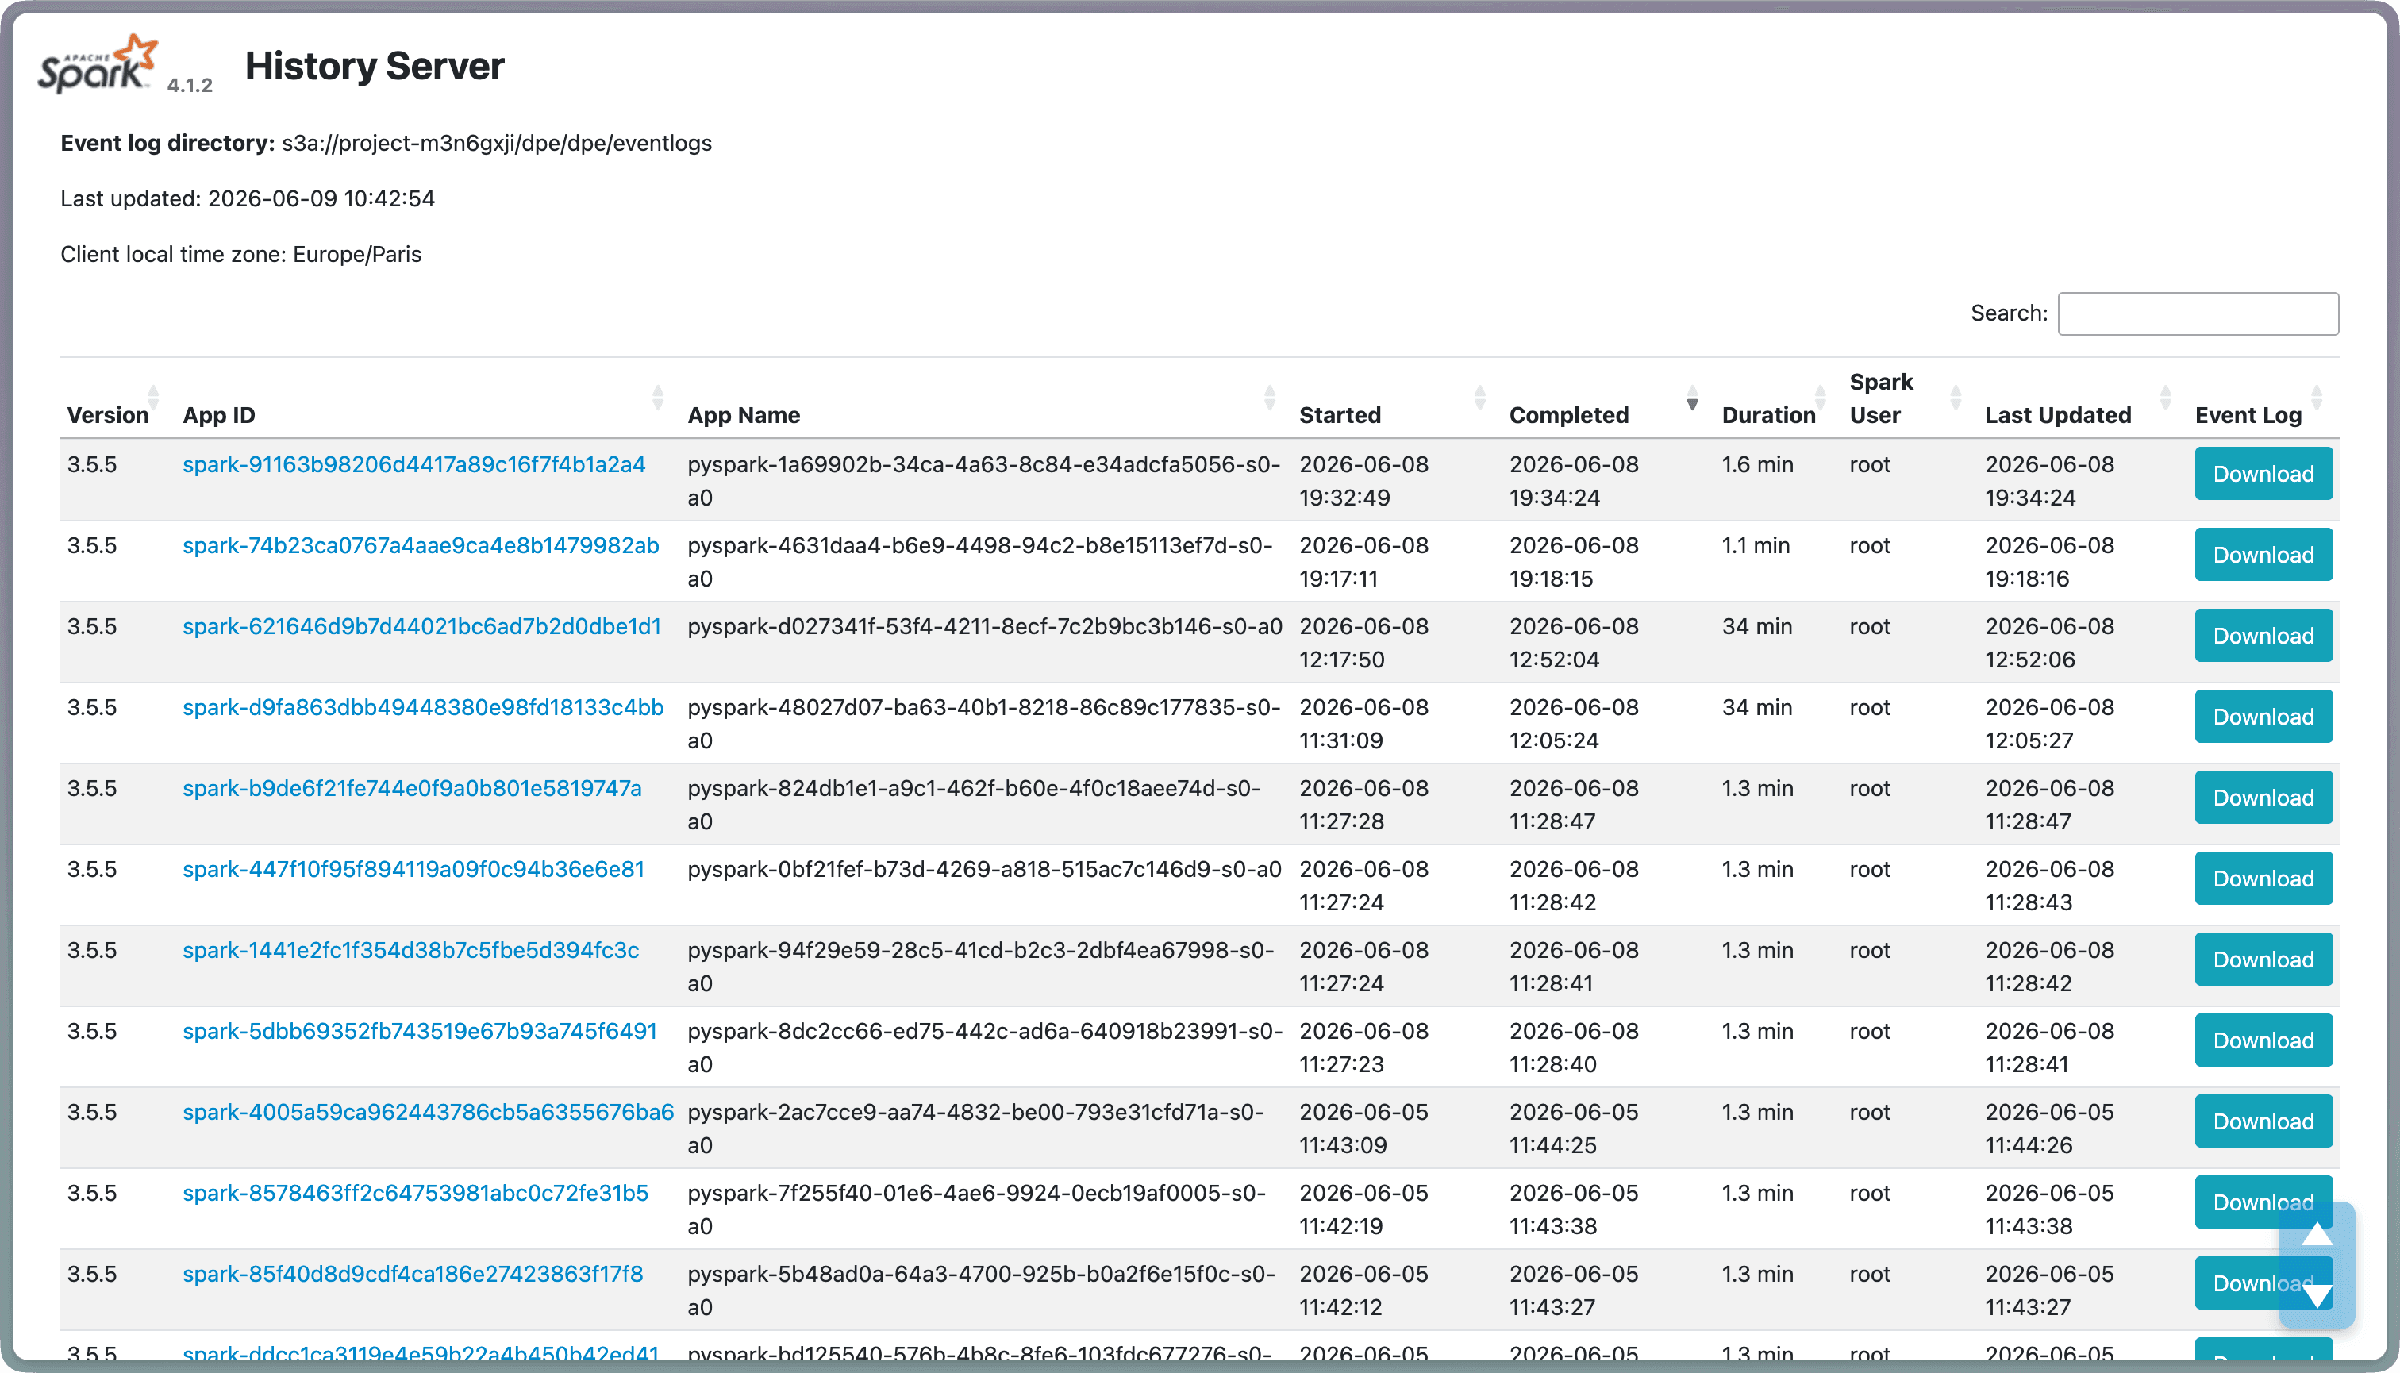
Spark UIを開くと、ジョブ、ステージ、タスクを探索できる完全な標準Sparkインターフェースが表示されます。
DataFlintは、同じ実行に対してパフォーマンスの洞察と最適化のヒントを重ねて表示します。
ジョブページから特定の実行にアクセスすることもできます。Spark History Serverで開くには、Sparkジョブ(PySparkアクションまたはワークフロー)を選択します。
実行中のジョブを追跡
実行中のジョブはテーブルの上部に表示され、ライブとしてマークされます。ジョブのインターフェースが準備できるとすぐに、ライブSpark UIとDataFlintビューを開くことができ、実行が終了するのを待つ必要はありません。
ライブインターフェースは、ライブSpark UIが設定で有効になっている場合にのみ、実行中のジョブで利用可能です。
設定
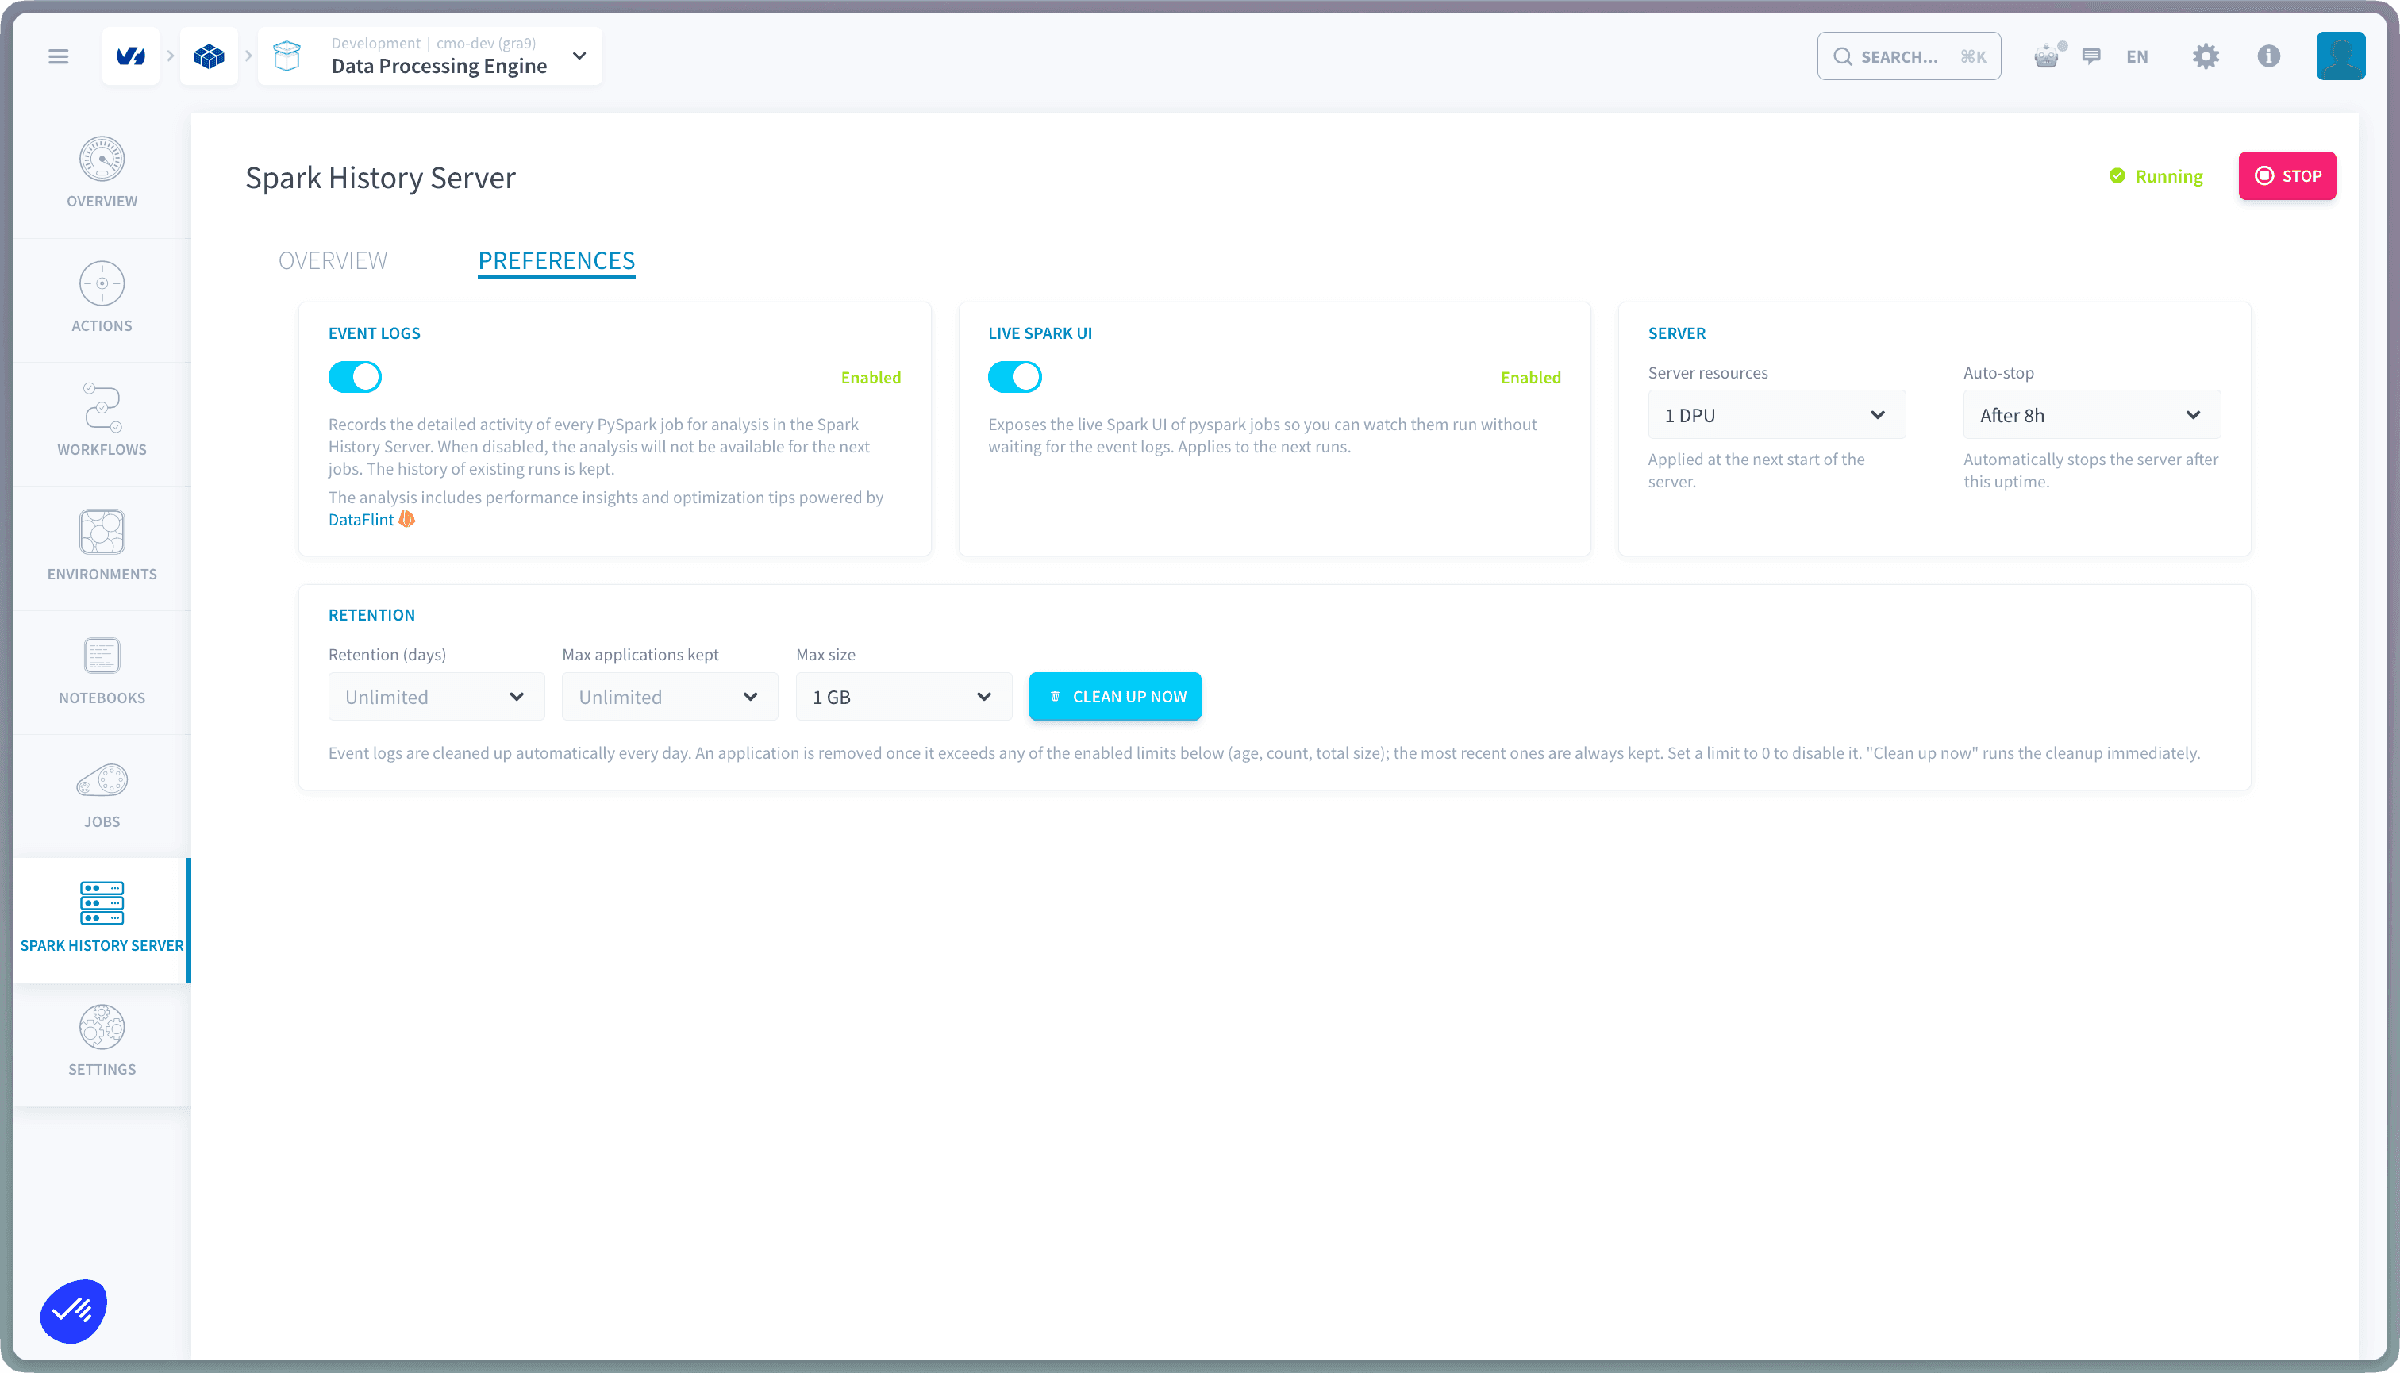
設定タブでは、キャプチャされる内容、サーバーのサイズ、停止時刻、およびログの保持期間を制御できます。
イベントログ
デフォルトで有効です。Spark History Serverで分析するために、各PySparkジョブの詳細なアクティビティを記録します。DataFlintによって提供されるパフォーマンスの洞察と最適化のヒントも含まれます。
無効にすると、次のジョブの分析は利用できません。既存の実行の履歴は保持されます。
イベントログはプロジェクトのDPE S31バケットに保存されます。下記の保持ルールがそのストレージの使用量を制御します。
ライブSpark UI
デフォルトで無効です。PySparkジョブのライブSpark UIを公開し、イベントログを待つことなく実行を監視できます。この設定は次の実行に適用されます。
サーバーリソースと自動停止
- サーバーリソース: サーバーに割り当てられるコンピューティングパワーは、1から4 DPUです。変更はサーバーの次回起動時に適用されます。
- 自動停止: 選択した不活性期間後にサーバーを自動的に停止します。オプション: 無し、2時間後、または8時間後。デフォルトは24時間です。
保持
イベントログは毎日自動的にクリーンアップされます。アプリケーションは、下記の有効な制限のいずれかを超えると削除されます。最新のアプリケーションは常に保持されます。0(または無制限)に設定して無効にできます。今すぐクリーンアップを使用して、クリーンアップをすぐに実行できます。
- 保持(日数): アプリケーションを保持する期間。オプション: 7(デフォルト)、30、90、365、または無制限。
- 保持する最大アプリケーション数: オプション 100(デフォルト)、10、50、100、500、または無制限。
- 最大合計サイズ: オプション 1、5、10、または50 GB、または無制限。
さらに詳しく
ソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして、プロフェッショナルサービスの専門家に見積もりを依頼し、プロジェクトのカスタム分析を依頼してください。
Data Platformを構築するチームと直接やり取りし、質問をする、フィードバックを提供する、専用Discordチャネルで参加してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。
1: S3はAmazon Technologies, Inc.の商標です。OVHcloudのサービスは、Amazon Technologies, Inc.によってスポンサーされ、推奨され、またはその他の方法で提携しているものではありません。