

ジョブ実行の設定を構成する
Data Processing Engineの各アクションまたはワークフローには、Preferencesタブを通じて管理できる複数の設定オプションがあります
目的
Data Processing Engineの各アクションまたはワークフローには、Preferencesタブを通じて管理できる複数の設定オプションがあります。
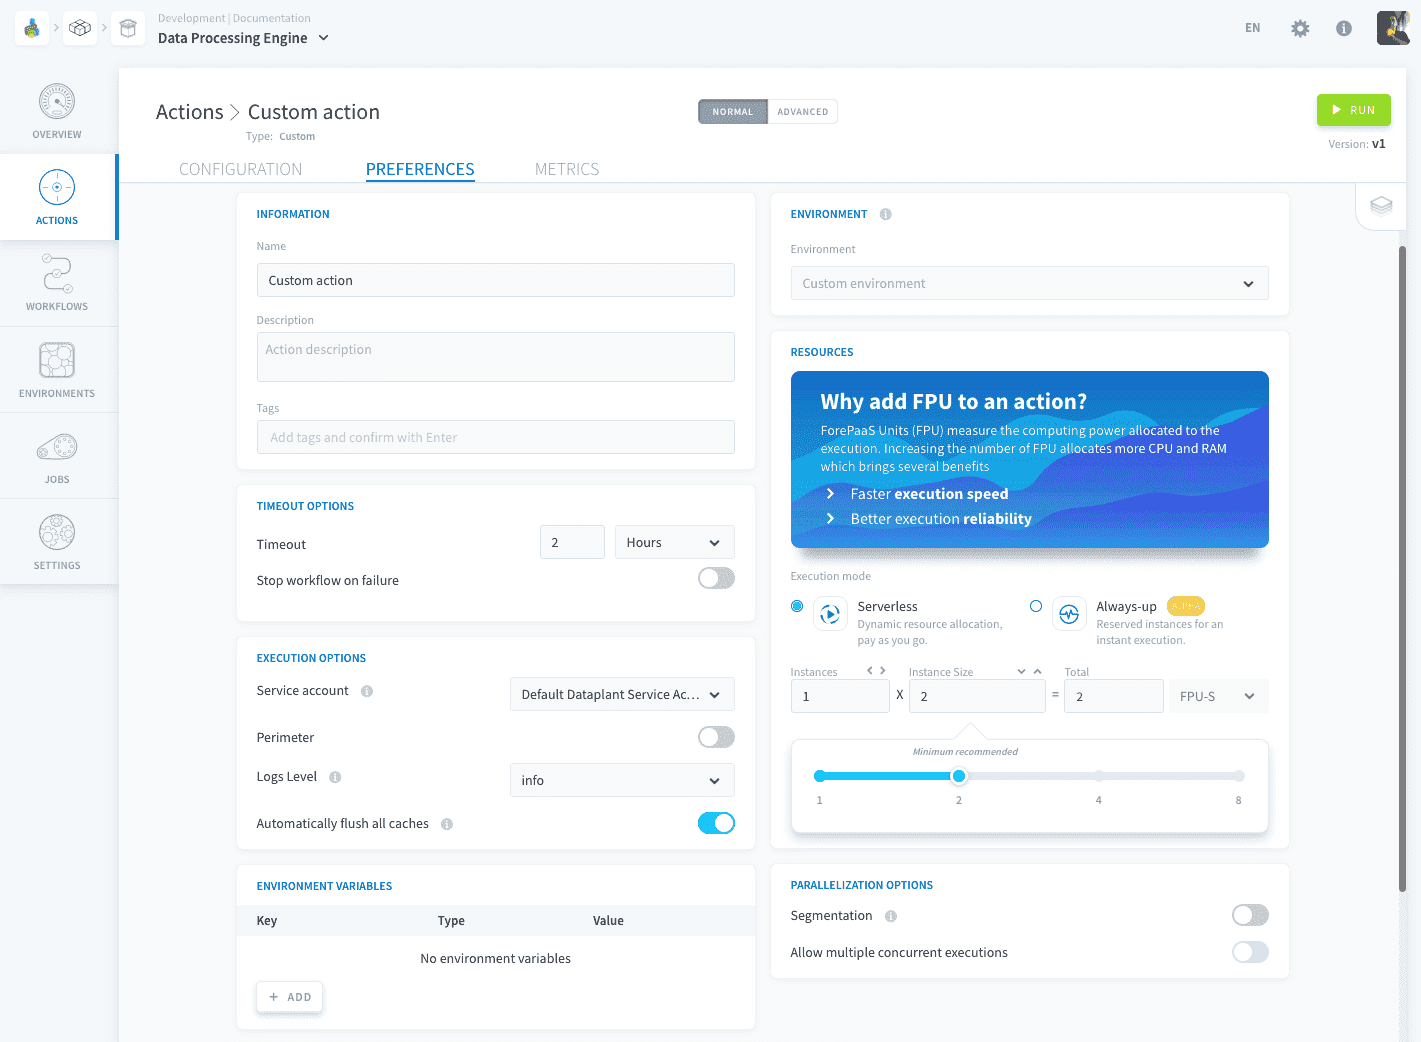
アクションが実行される際には、その設定を使用して実行されます。
ワークフローが実行される際には、その設定がワークフロー内のすべてのアクションの設定を上書きします。ワークフローレベルで特定の設定オプションが無効になっている場合(セグメンテーションやペリメーターなど)、ワークフローの実行中に各アクションの設定に戻ります。
これらの設定は、環境に保存することでテンプレート化し、1クリックで再利用することができます。
環境
プラットフォームの環境は、アクションやワークフローに素早く割り当てることができる事前定義された設定のセットです。そのため、毎回設定する必要がありません。
タイムアウトオプション
タイムアウトオプションは環境でテンプレート化されておらず、各アクション/ワークフローの設定で構成する必要があります
タイムアウト
タイムアウトは、ジョブが失敗とみなされる実行ランタイムの期間です。タイムアウト期間には、リソースのプロビジョニング時間、ビルド時間、および実際のコード実行時間が含まれます。
設定できる最大タイムアウト期間は24時間です。ただし、以下の種類のジョブでは、タイムアウトを無効(無制限)に設定できます:
ジョブの実行がタイムアウトした場合、ジョブリストでタイムアウトによる失敗としてフラグが立てられ、他の失敗の原因と区別されます。
ワークフローの失敗時に停止
アクションがワークフローの一部として実行され、CRITICALエラーをスローして失敗した場合、このオプションを有効にするとワークフローの実行が中断され、次のステージやアクションは実行されません。このエラーはログに表示されます。
実行オプション
サービスアカウント
各アクション、ワークフロー、または環境には、サービスアカウントが関連付けられており、アクション/ワークフローは実行時にこのサービスアカウントを装います。このサービスアカウントは実行中のジョブのアイデンティティとして機能し、サービスアカウントのロールを通じてジョブのアクセスレベルを制御します。
ジョブを手動で起動しても、その実行は関連付けられたサービスアカウントによって認証されます。
ペリメーター
このパラメータはカスタムPySparkアクションには利用できません。
データ処理ジョブを実行する際、大量のデータを処理する必要がある場合、アクションの実行をフィルタリングする必要がある場合があります。ペリメーターパラメータを使用すると、データ処理の範囲をフィルタリングするフィールドを定義できます。
データソースとアクションの種類によって、複数のペリメーターモードが利用可能です。
この範囲は特に以下の用途に使用されます:
- 列に処理フィルタを適用する
- アクションの実行を高速化する
- 特定のデータソースのリクエスト負荷を軽減する
- 毎日スケジュールされたワークフローで、全履歴のデータではなく、過去X日間のデータのみを処理する
ログレベル
ログレベルは、アクションまたはワークフローの実行中に保存されるログのリストを定義します。ログレベルはデバッグからクリティカルまであり、選択したログレベル(含む)以上のすべてのログが保存されます。
キャッシュの自動フラッシュ
このパラメータを有効にすると、アクション/ワークフローの各実行後にコンポーネントのキャッシュが自動的にフラッシュされます。
キャッシュについてさらに詳しくはこの記事を参照してください。
書き込み戦略
このオプションはロード、集計、ロードPySpark、およびAggregate PySparkアクションのみで利用可能です。
書き込み戦略は、新しいデータを目的地のテーブルに書き込む方法を定義します。マッチングはテーブルの識別子フィールドに基づいて行われます。
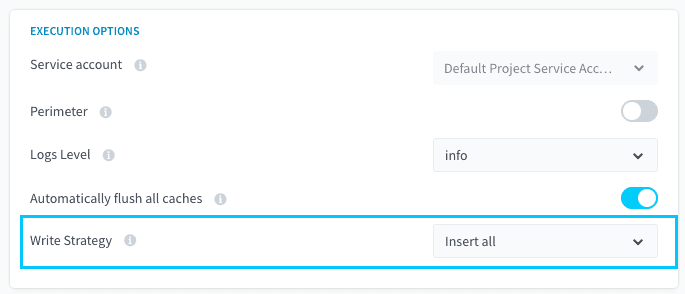
3つの戦略があります:
- Upsert: アクションは、すべての識別子フィールドを使用して新しいデータと既存のデータをマッチングします。新しい行が既存の行と同じ識別子フィールドを持っている場合、既存の行は更新されます。それ以外の場合、新しい行が追加されます。
- マッチしない場合に挿入: 新しい行が既存の行とマッチングする場合(識別子フィールドを使用)、何も行われません。それ以外の場合、新しい行が追加されます。
- すべて挿入: すべての新しい行がテーブルに挿入されます。識別子フィールドで既存の行とマッチングする行があってもです。これにより重複が生じる可能性があります。
ロードおよび集計アクションはデフォルトですべて挿入を使用します。 アクションの設定でマッチング動作を希望する場合は、Upsert(またはマッチしない場合に挿入)を手動で選択してください。
例
次のusersテーブルを考慮してください:
この新しいデータを使用して、アクションをFirstname + Lastnameを識別子フィールドとして実行します:
結果は書き込み戦略によって異なります。
Upsert: Aliceは既存の行とマッチングし、更新されます。Charlesは新規で追加されます:
マッチしない場合に挿入: Aliceは既存の行とマッチングするため、何も行われません。Charlesは新規で追加されます:
すべて挿入: 両方の新しい行がそのまま挿入され、Aliceの重複が残ります:
環境変数
これはカスタムアクション、ワークフロー、および環境のみで利用可能です。
環境変数は、カスタムアクションにテンプレート化して注入することができるキー値ペアです。これにより、カスタムスクリプトに値をハードコーディングする必要がありません。これらはPARAMSディクショナリオブジェクトのforepaas.core.settingsパッケージ(SDKで利用可能)に保存されます。
典型的なユースケースのコードスニペットはこのページで利用可能です。
環境変数はKMSライフサイクルを通過しないため、シークレットや資格情報を保存して注入するために使用してはなりません。
トリガー
トリガーは環境でテンプレート化されず、各アクション/ワークフローの設定で構成する必要があります。
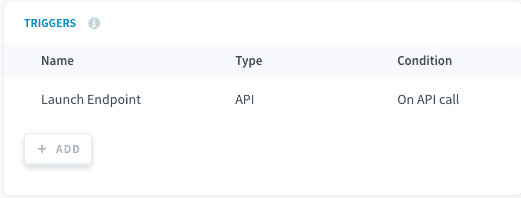
トリガーを使用すると、ジョブを自動的に実行するように設定できます。典型的な用途としては、APIエンドポイントにアクセスしてジョブを起動するか、時間ベースのトリガーをスケジュールする(例:毎日午前0時にジョブを実行する)ことが挙げられます。
APIエンドポイントトリガー
このエンドポイントを使用すると、APIを介してジョブをトリガーできます。
Launch API Endpointという名前のトリガーを通じて、常に利用可能です。クリックしてエンドポイントの詳細を確認してください。
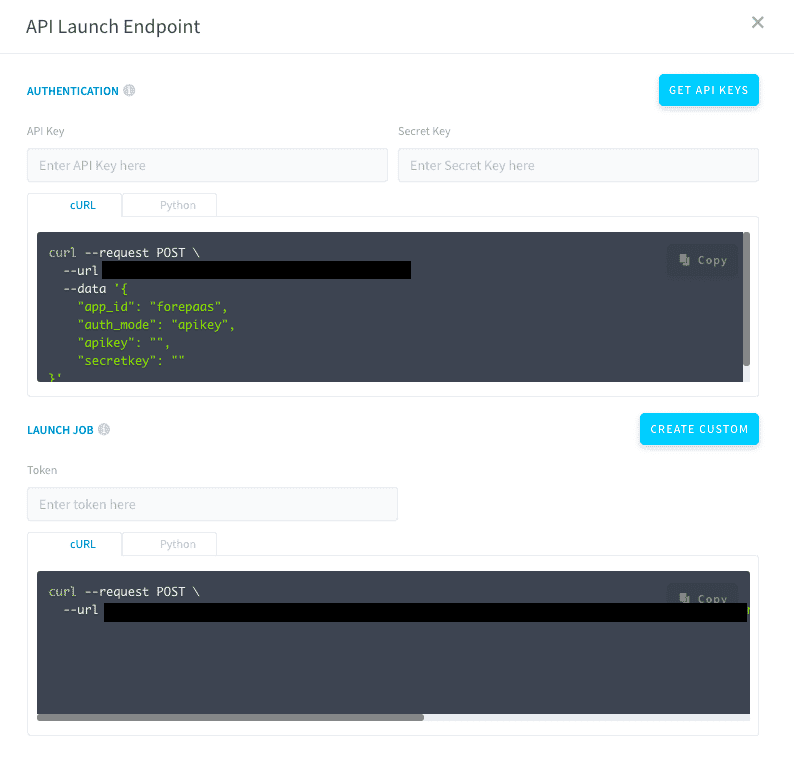
ジョブをトリガーするには、Authenticationエンドポイントで最初に認証し、その後Launch Jobエンドポイントでジョブをトリガーする必要があります。
- トリガーの詳細にAPIとSecretキーを入力し、Authenticationエンドポイントのテキストをコピーします。ログインすると、トークンが取得されます。
- このトークンをLaunch jobエンドポイントに入力し、ジョブを起動するためにアクセスします。
時間ベースのトリガー
CRONトリガーを使用して、アクションまたはワークフローを事前に定義された時間間隔で実行するようにスケジュールできます。
Complete modeを使用して視覚的に構成を設定するか、Advanced modeでカスタムCRON式を使用できます。Advanced modeの構成はCRON構文に従います(詳細についてはこちらを参照してください)。
CRONトリガーを無効にすると、スケジュール実行を一時停止できます。また、スケジュールを再開したい場合は、トリガー構成を失わずに再度有効にできます。
リソース
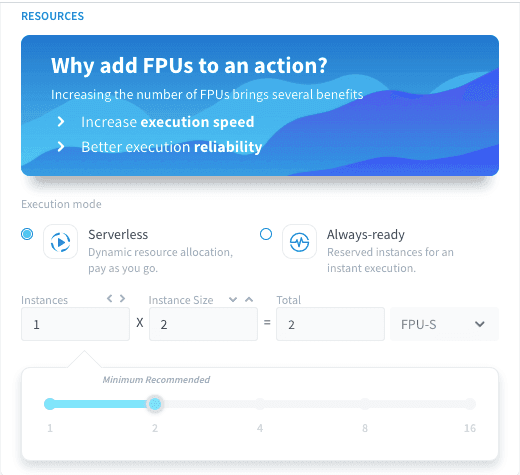
実行モード
Preferencesページで利用可能な実行モードは2つあります:
- Serverless:必要に応じてコンピューティングリソースを展開します。
- Always-up:ジョブを迅速に実行するために常に実行中の専用インスタンス。
Serverless
デフォルトでは、プラットフォーム上で実行するジョブはすべてServerlessモードで実行されます。ジョブ実行を開始すると実行環境が展開され、その実行が完了すると展開が解除されます。
以下の項目について請求されます:
- タスクを実行するために使用されたコンピューティングリソース。
Serverlessモードでは、タスク実行中のみ実行環境がアクティブです。タスクが完了すると、自動的に終了します。
Always-up
この機能は現在Alphaリリース段階であり、不安定になる可能性があります。
Always-upモードを有効にすると、対応するアクション/ワークフロー/環境用に専用のコンピューティング環境が展開されます。実行モードをServerlessに戻すまで展開された状態が維持されるため、ジョブを実行するたびに展開を待つ必要はありません。
以下の項目について請求されます:
- 実行環境がアクティブだった時間帯に使用されたコンピューティングリソース(ジョブを実行するのに要した時間を含む)。
Always-upモードでは、ジョブ実行が完了しても実行環境は自動的に展開解除されません。実行モードをServerlessに戻して終了させる必要があります。
Always-upモードで設定されたアクション/ワークフローの構成を編集すると、完全なブルーグリーン方式で更新されます。展開は、現在の保留中のタスクがすべて完了するまで待機し、更新のために優雅にシャットダウンします。
環境でAlways-up実行モードを使用することをお勧めします。個々のアクション/ワークフローではなく、複数のワークロードでリソースを再利用するためです。
リソースのスケーリング
コンピューティングパワーをスケーリングする方法については、以下の専用記事で詳しく説明しています。
並列化オプション
セグメンテーション
このパラメータはカスタムPySparkアクションでは利用できません。
セグメンテーションオプションを使用すると、特定の基準に基づいてジョブを複数のタスクに分割する方法を定義できます。分割後、ジョブのワークロードは複数のワーカーに並列に分散できます(並列コンピューティング)。
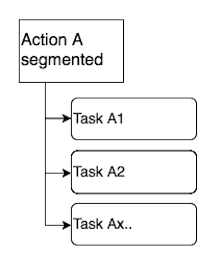
セグメンテーションの最も一般的な用途としては、以下のようなものがあります:
- 列に特定の処理フィルターを適用する;
- 複数のワーカーで並列に処理を並列化することで、アクション実行時間を短縮し、データソースコネクタのワークロードを軽減する;
- 例えば、毎日計画されたワークフローの場合、ロードアクションを実行するたびに歴史的なデータをすべて取り込むのではなく、直近の日数のみをフィルタリングする。
並列実行
このオプションを使用すると、アクション/ワークフローを同時に複数回実行できます(既に実行中の場合に実行がトリガーされるとエラーが返される代わりに)。
Serverlessモードでは、各並列実行がジョブの割り当てられたコンピューティングパワーを使用します。 Always-upモードでは、複数の並列実行が利用可能なワーカーに並列に分散されます(並列コンピューティング)。
複数の並列実行はAPI経由でのみトリガーでき、GUIではありません。
開発言語
これはワークフロー(およびカスタムアクションの構成ページ)でのみ利用可能です。
このオプションを使用すると、ワークフロー全体で使用する言語バージョンを指定できます。デフォルトでは、ワークフローは含まれるすべてのバージョンのうち最新のものを使用します。
さらに詳しく
トレーニングや技術的なサポートを受けて当社のソリューションを実装するには、営業担当者にお問い合わせください、またはプロフェッショナルサービスページを訪れて見積もりを依頼し、専門家チームにプロジェクトを分析してもらってください。
Data Platformの開発チームと直接質問し、フィードバックを共有し、交流するには、専用のDiscordチャネルを利用してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。