

PySpark Notebook を使用した NYC Yellow Taxi データセットの分析
このチュートリアルでは、OVHcloud Data Platform 上で PySpark Notebook を効率的に使用して Yellow Taxi Trip Records を分析する方法を説明します
目的
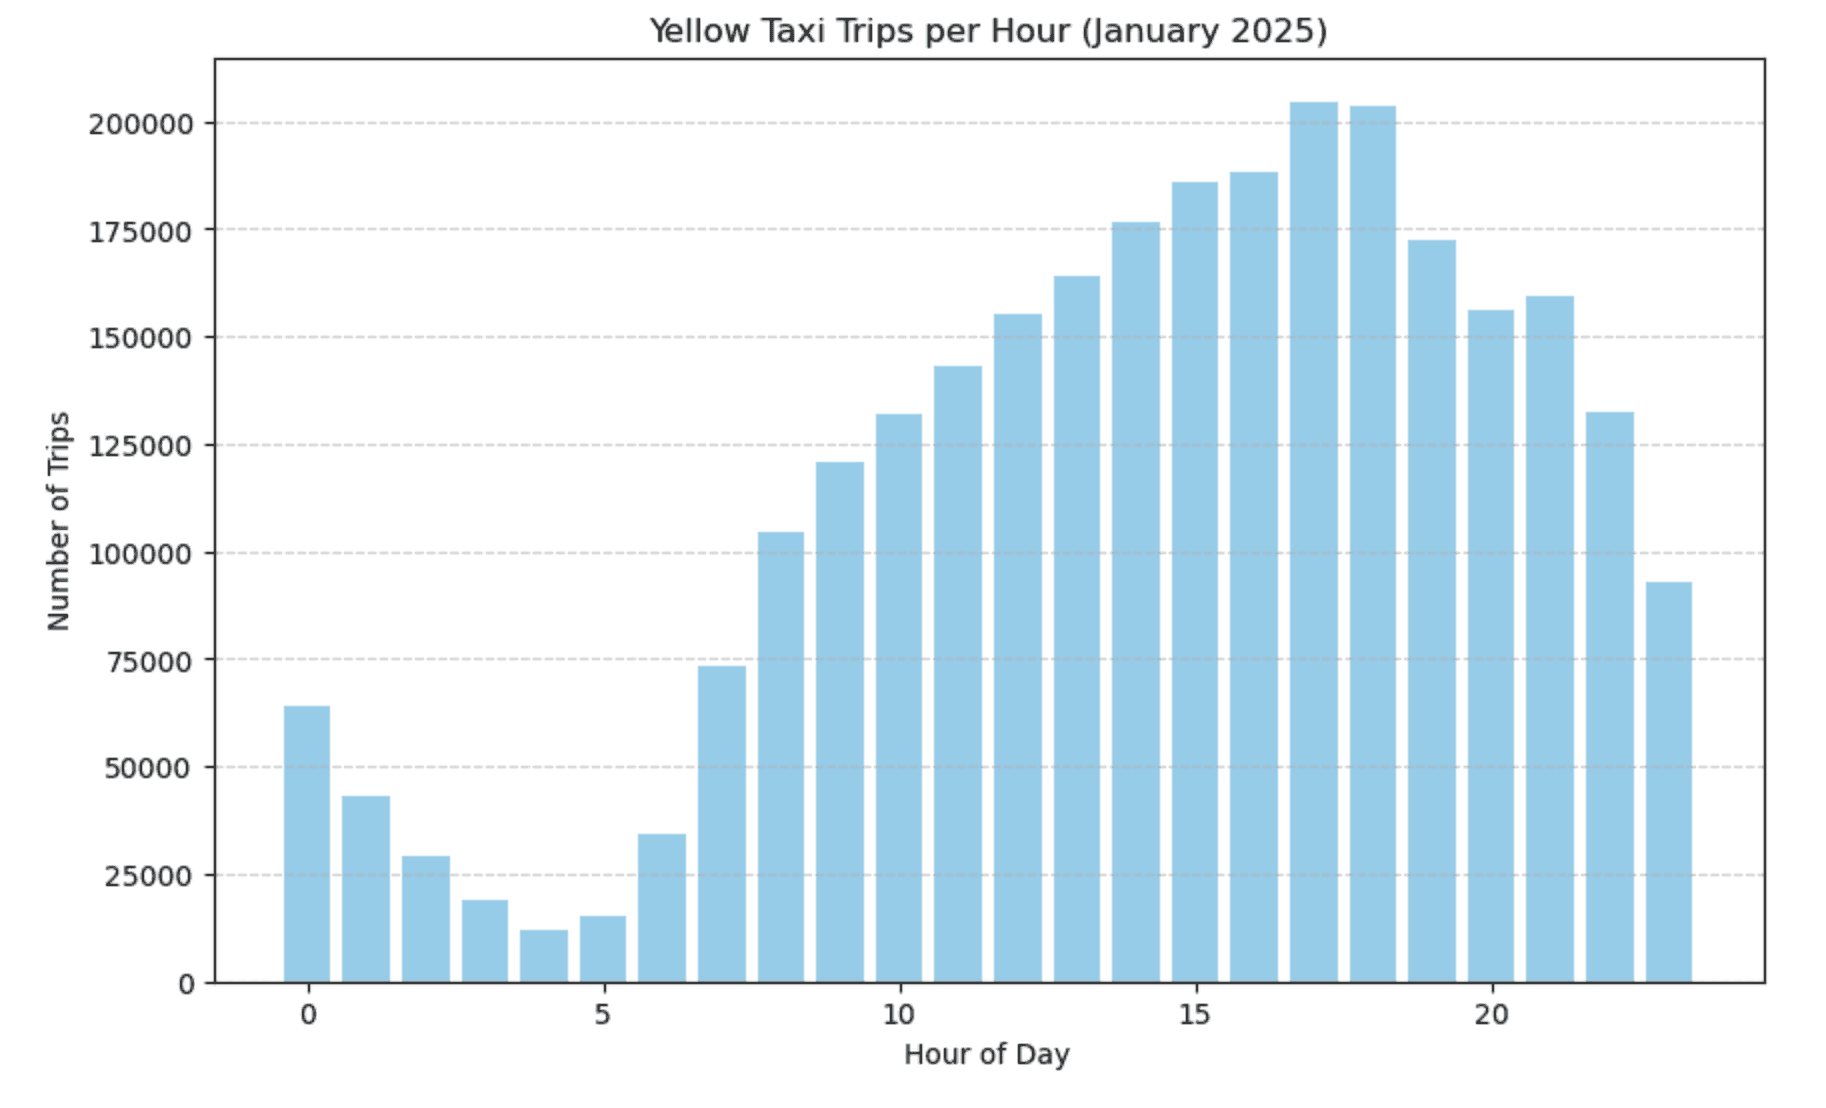
このチュートリアルでは、OVHcloud Data Platform 上で PySpark Notebook を効率的に使用して、Yellow Taxi Trip Records(Parquet ファイルとして保存)と Taxi Zone Lookup Table(CSV ファイルとして保存)を分析する方法を説明します。タクシーの利用パターンを明らかにするための探索的データ分析(EDA)を行い、これらのパターンを解釈するための可視化を作成し、旅行距離や乗車地点などの特徴に基づいて旅行時間を予測する機械学習モデルを構築します。
このチュートリアルは初心者向けに設計されており、各ステップについて詳細な説明を提供して、OVHcloud の Data Platform 上の Jupyter ノートブックで PySpark を使用する方法を理解するのに役立ちます。環境の設定、Connectors へのアクセス、PySpark を有効にした Jupyter ノートブックの構成を含む Getting Started ガイドを完了していることを前提としています。
このチュートリアルを終えるまでに、以下のことができるようになります:
- PySpark を使用して大規模なデータセットを読み込み、クリーンアップする。
- 地理的な文脈を追加するためにデータセットを結合する。
- タクシー旅行データのトレンドを特定するための EDA を実行する。
- Matplotlib と Seaborn を使用して結果を可視化する。
- 旅行時間を予測するためのシンプルな機械学習モデルを構築する。
PySpark チュートリアル用のデータソースとテーブルの設定
OVHcloud Data Platform 上で PySpark を使用して Yellow Taxi Trip Records と Taxi Zone Lookup Table を分析する前に、データ環境を準備する必要があります。これは以下を含みます:
- Connectors でデータソースを作成して、Parquet および CSV ファイルを登録する。
- Lakehouse Manager でテーブルを作成して、データを構造化された形式で保存する。
- Data Processing Engine (DPE) で Load Action を構成して、Yellow Taxi テーブルにデータを入力する。
これらのステップにより、Jupyter ノートブックで PySpark を使用して分析できるようにデータが Lakehouse Manager にアクセス可能になります。
前提条件:
- OVHcloud Data Platform へのアクセス権限(Connectors、Lakehouse Manager、DPE を管理する権限)。
- OVHcloud Data Platform Getting Started ガイド を完了している。
- NYC TLC Trip Record データ から
yellow_tripdata_YEAR-MONTH.parquetとtaxi_zone_lookup.csvファイルが利用可能。
ステップ 1:Connectors で新しいソースを作成する
- 新しい File Upload ソースを作成し、「NYC-taxi」と名前を付けます。
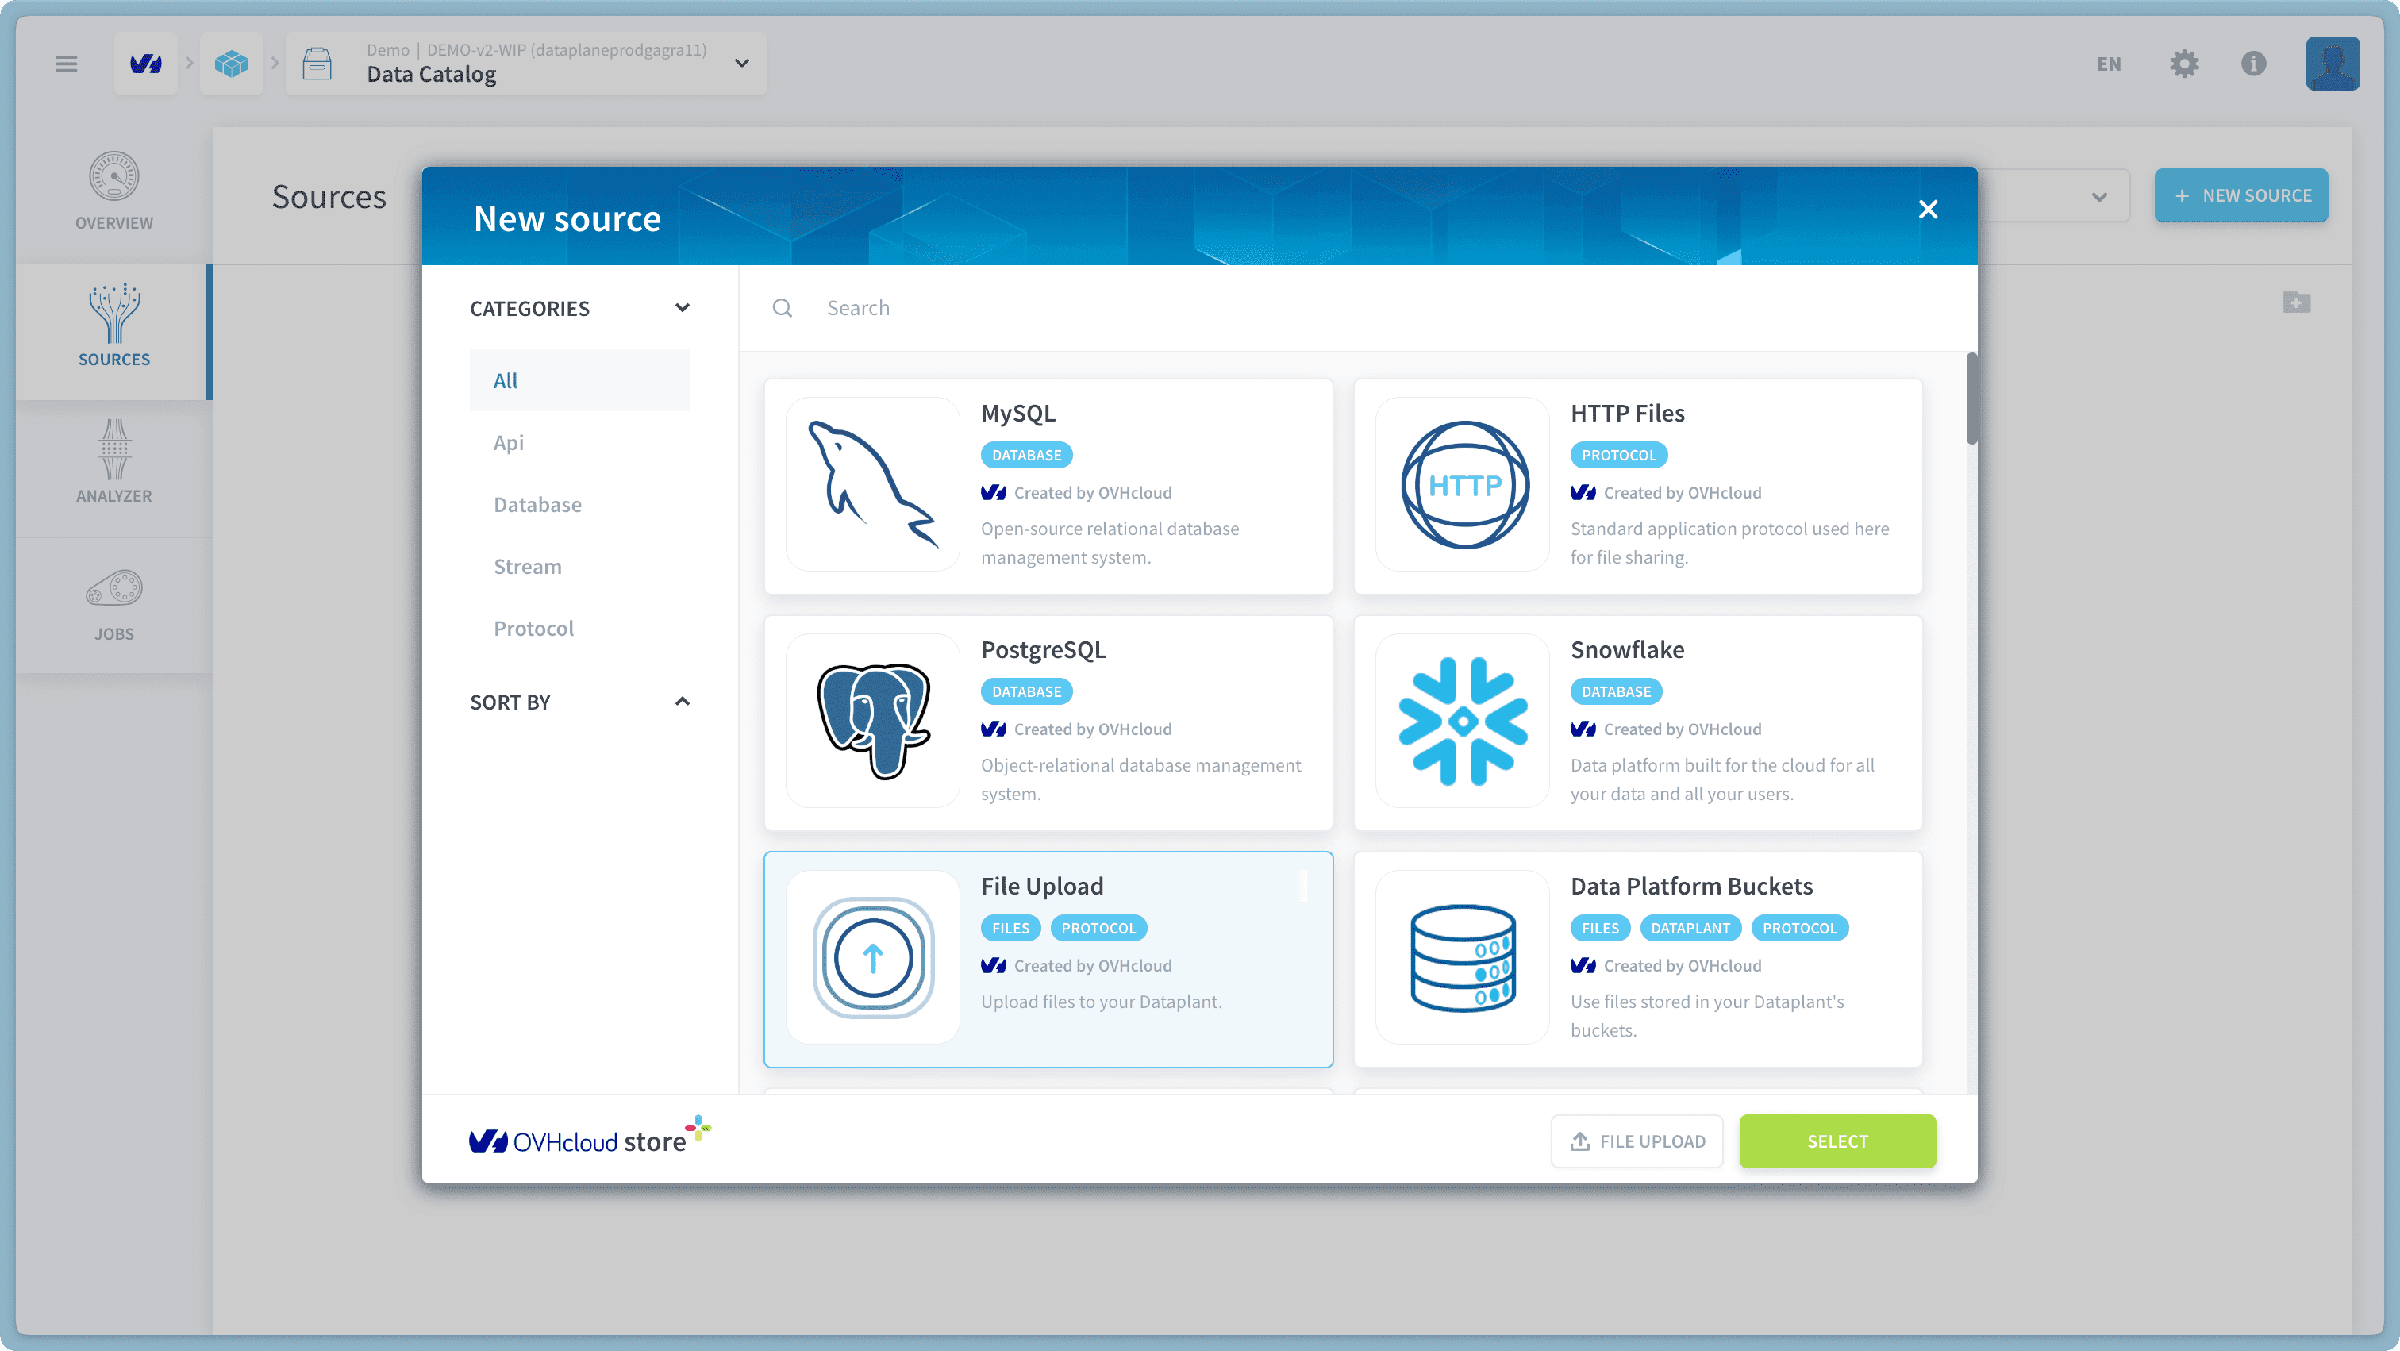
yellow_tripdata_YEAR_MONTH.parquetとtaxi_zone_lookup.csvファイルをアップロードし、作成をクリックします。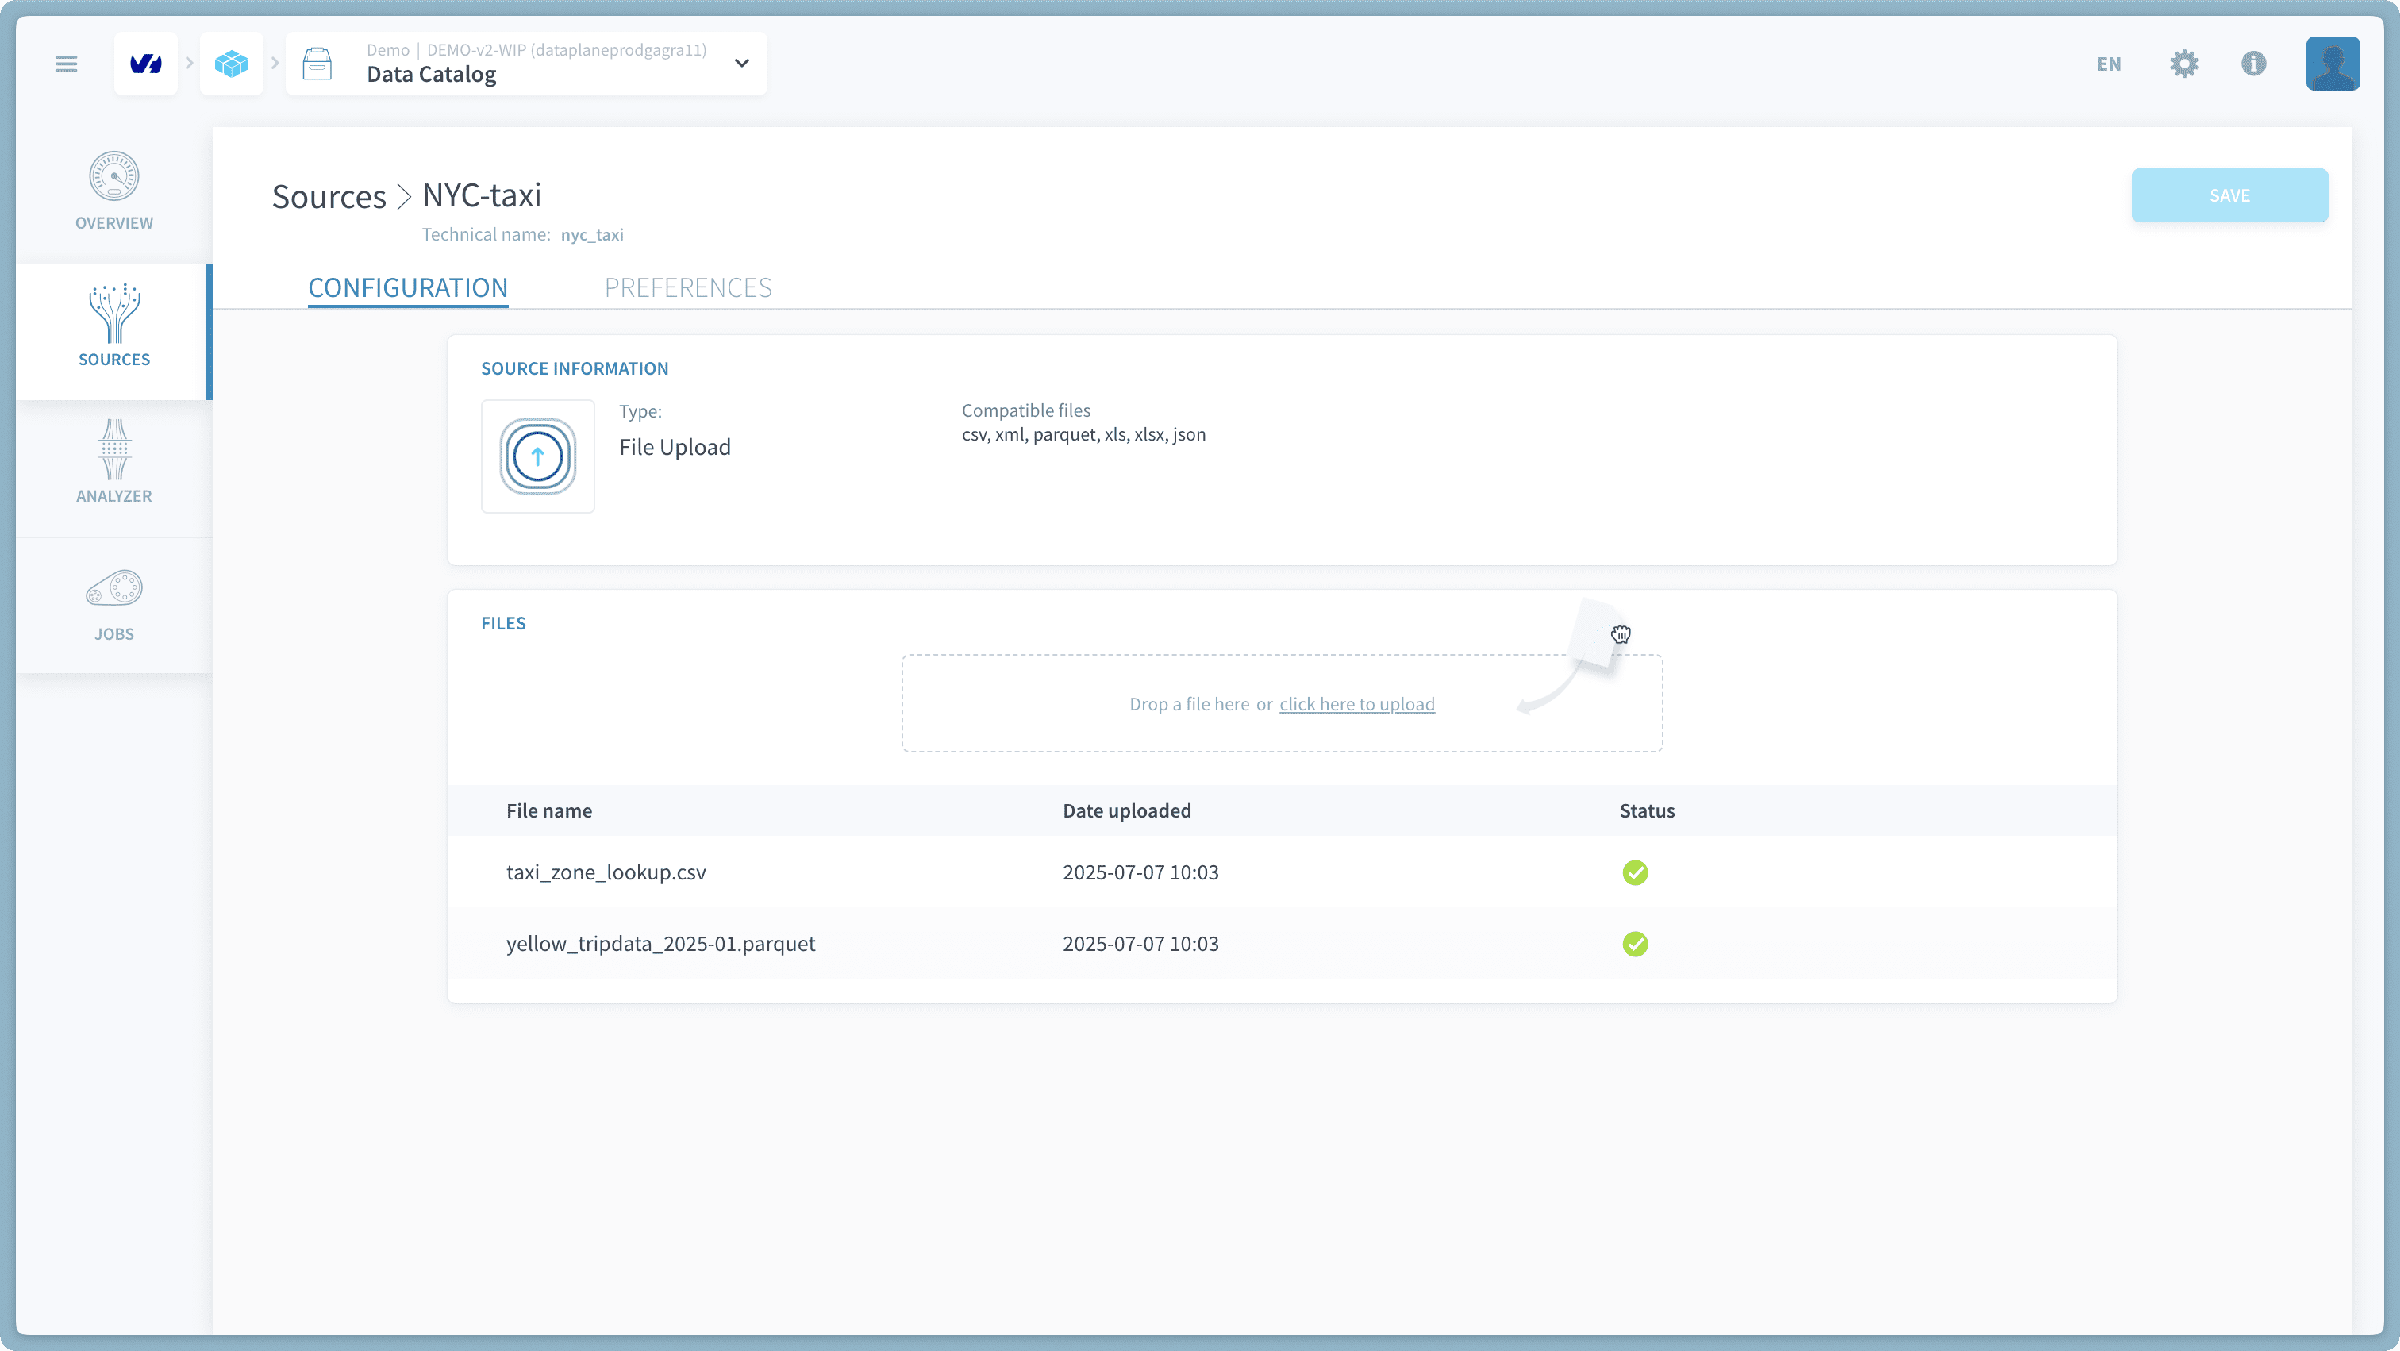
- Analyzer タブに移動し、メタ抽出を実行してアップロードしたファイルのスキーマを推測します。
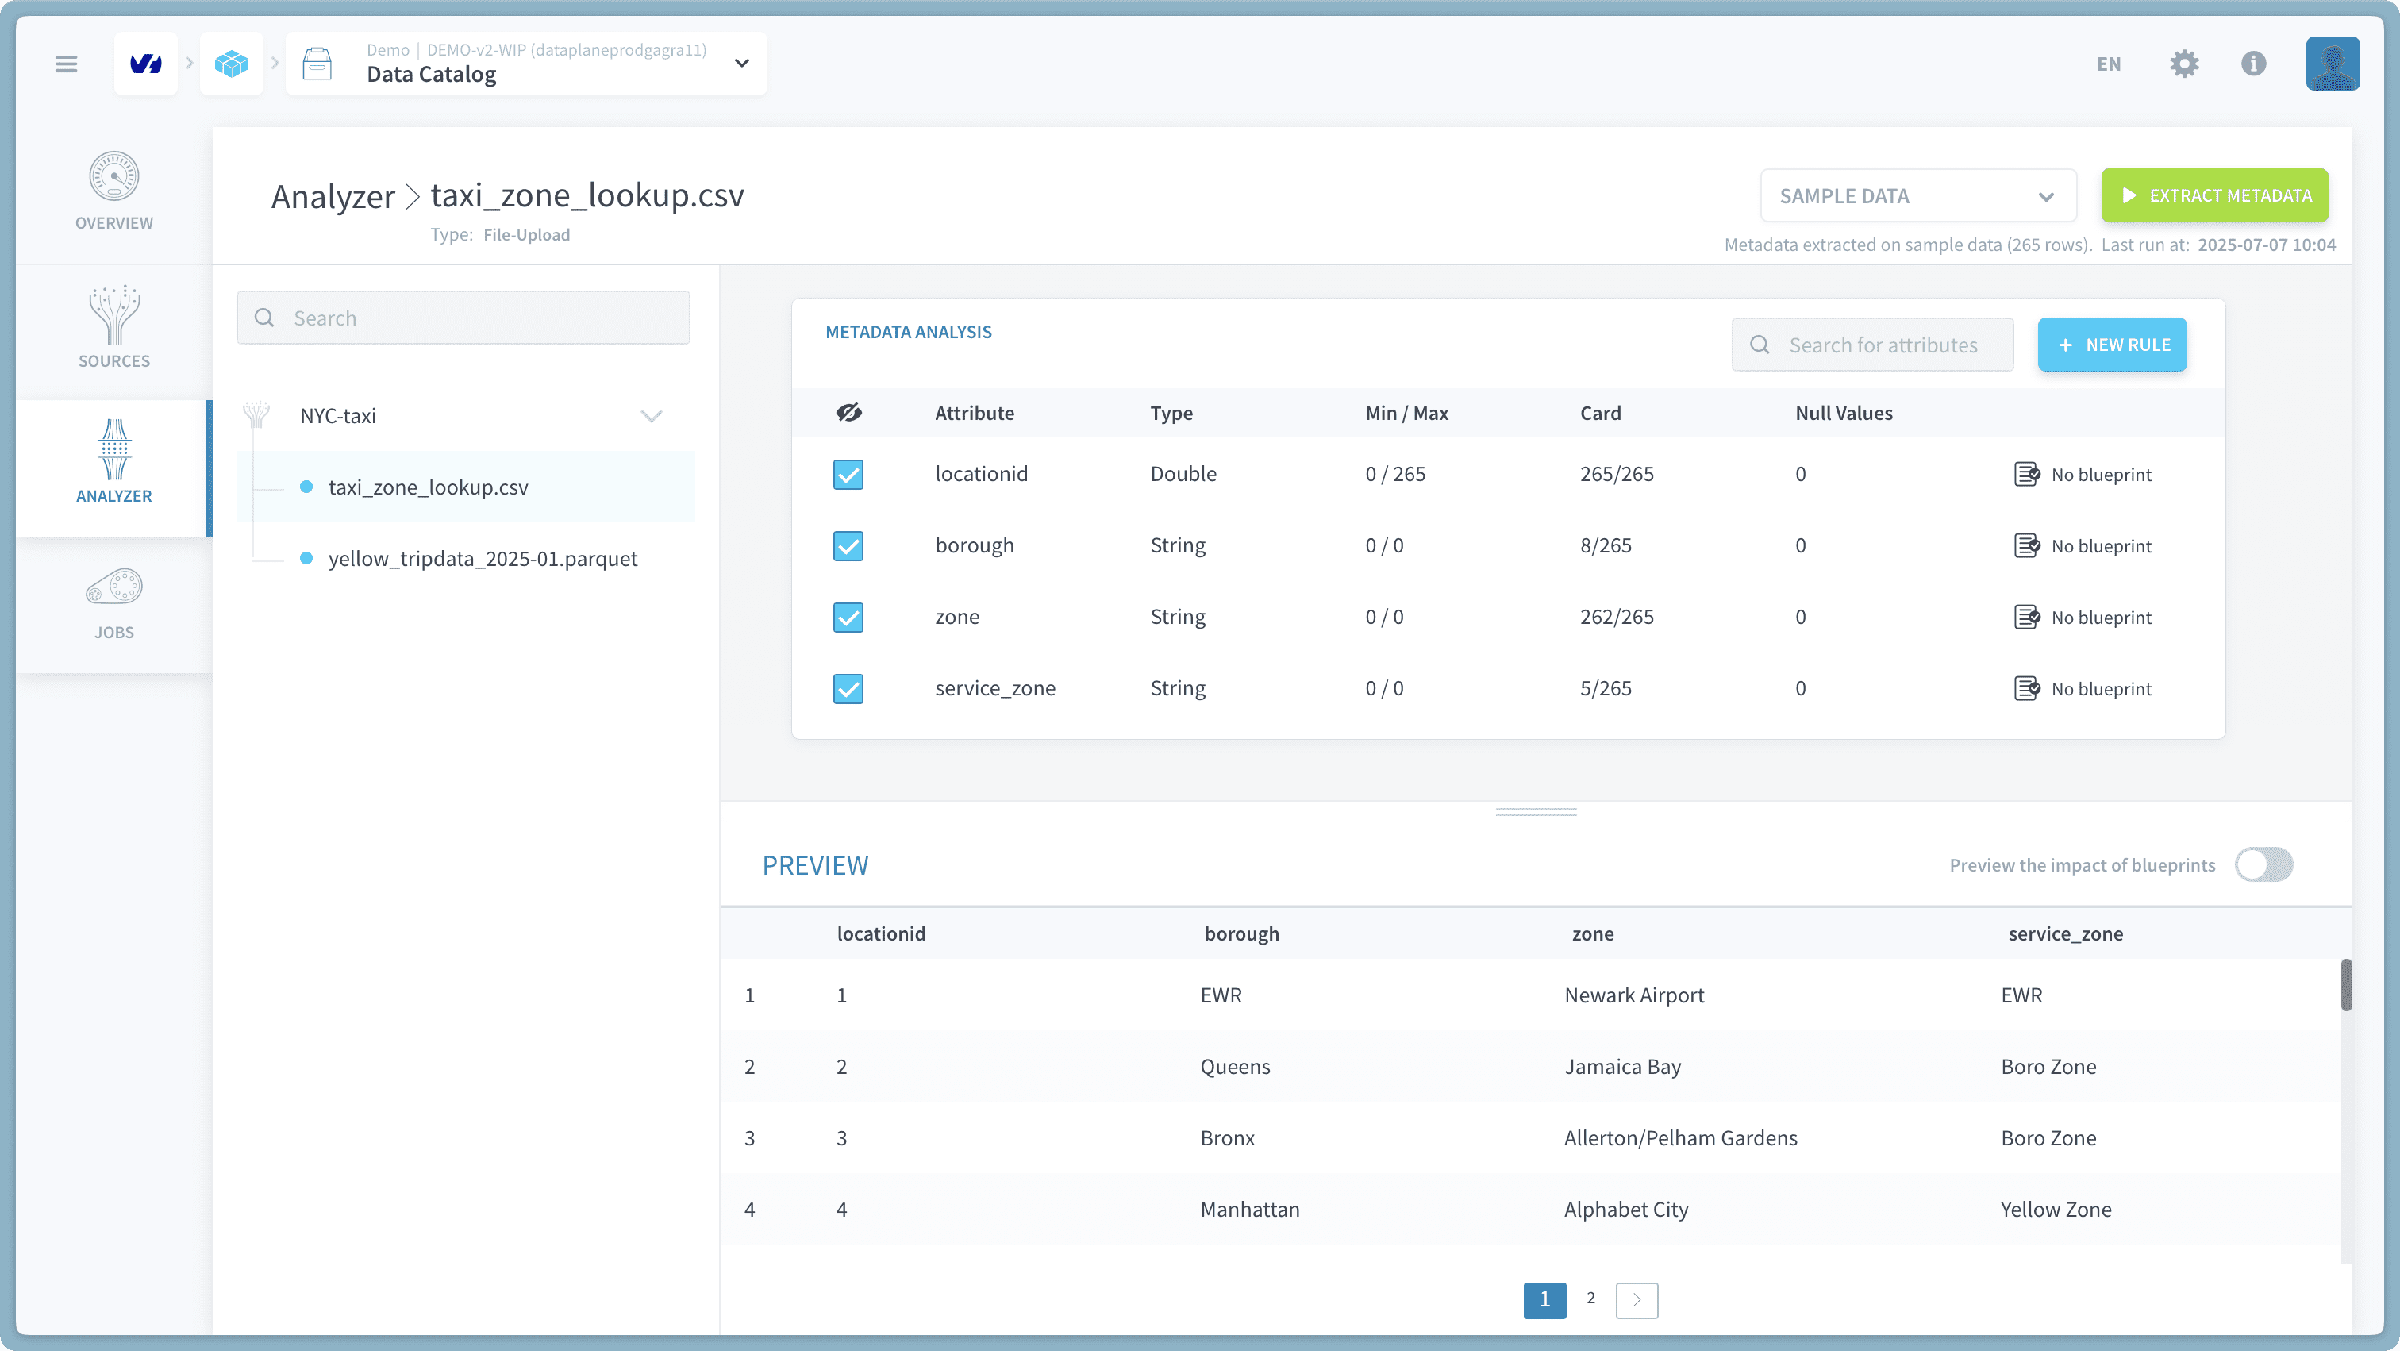
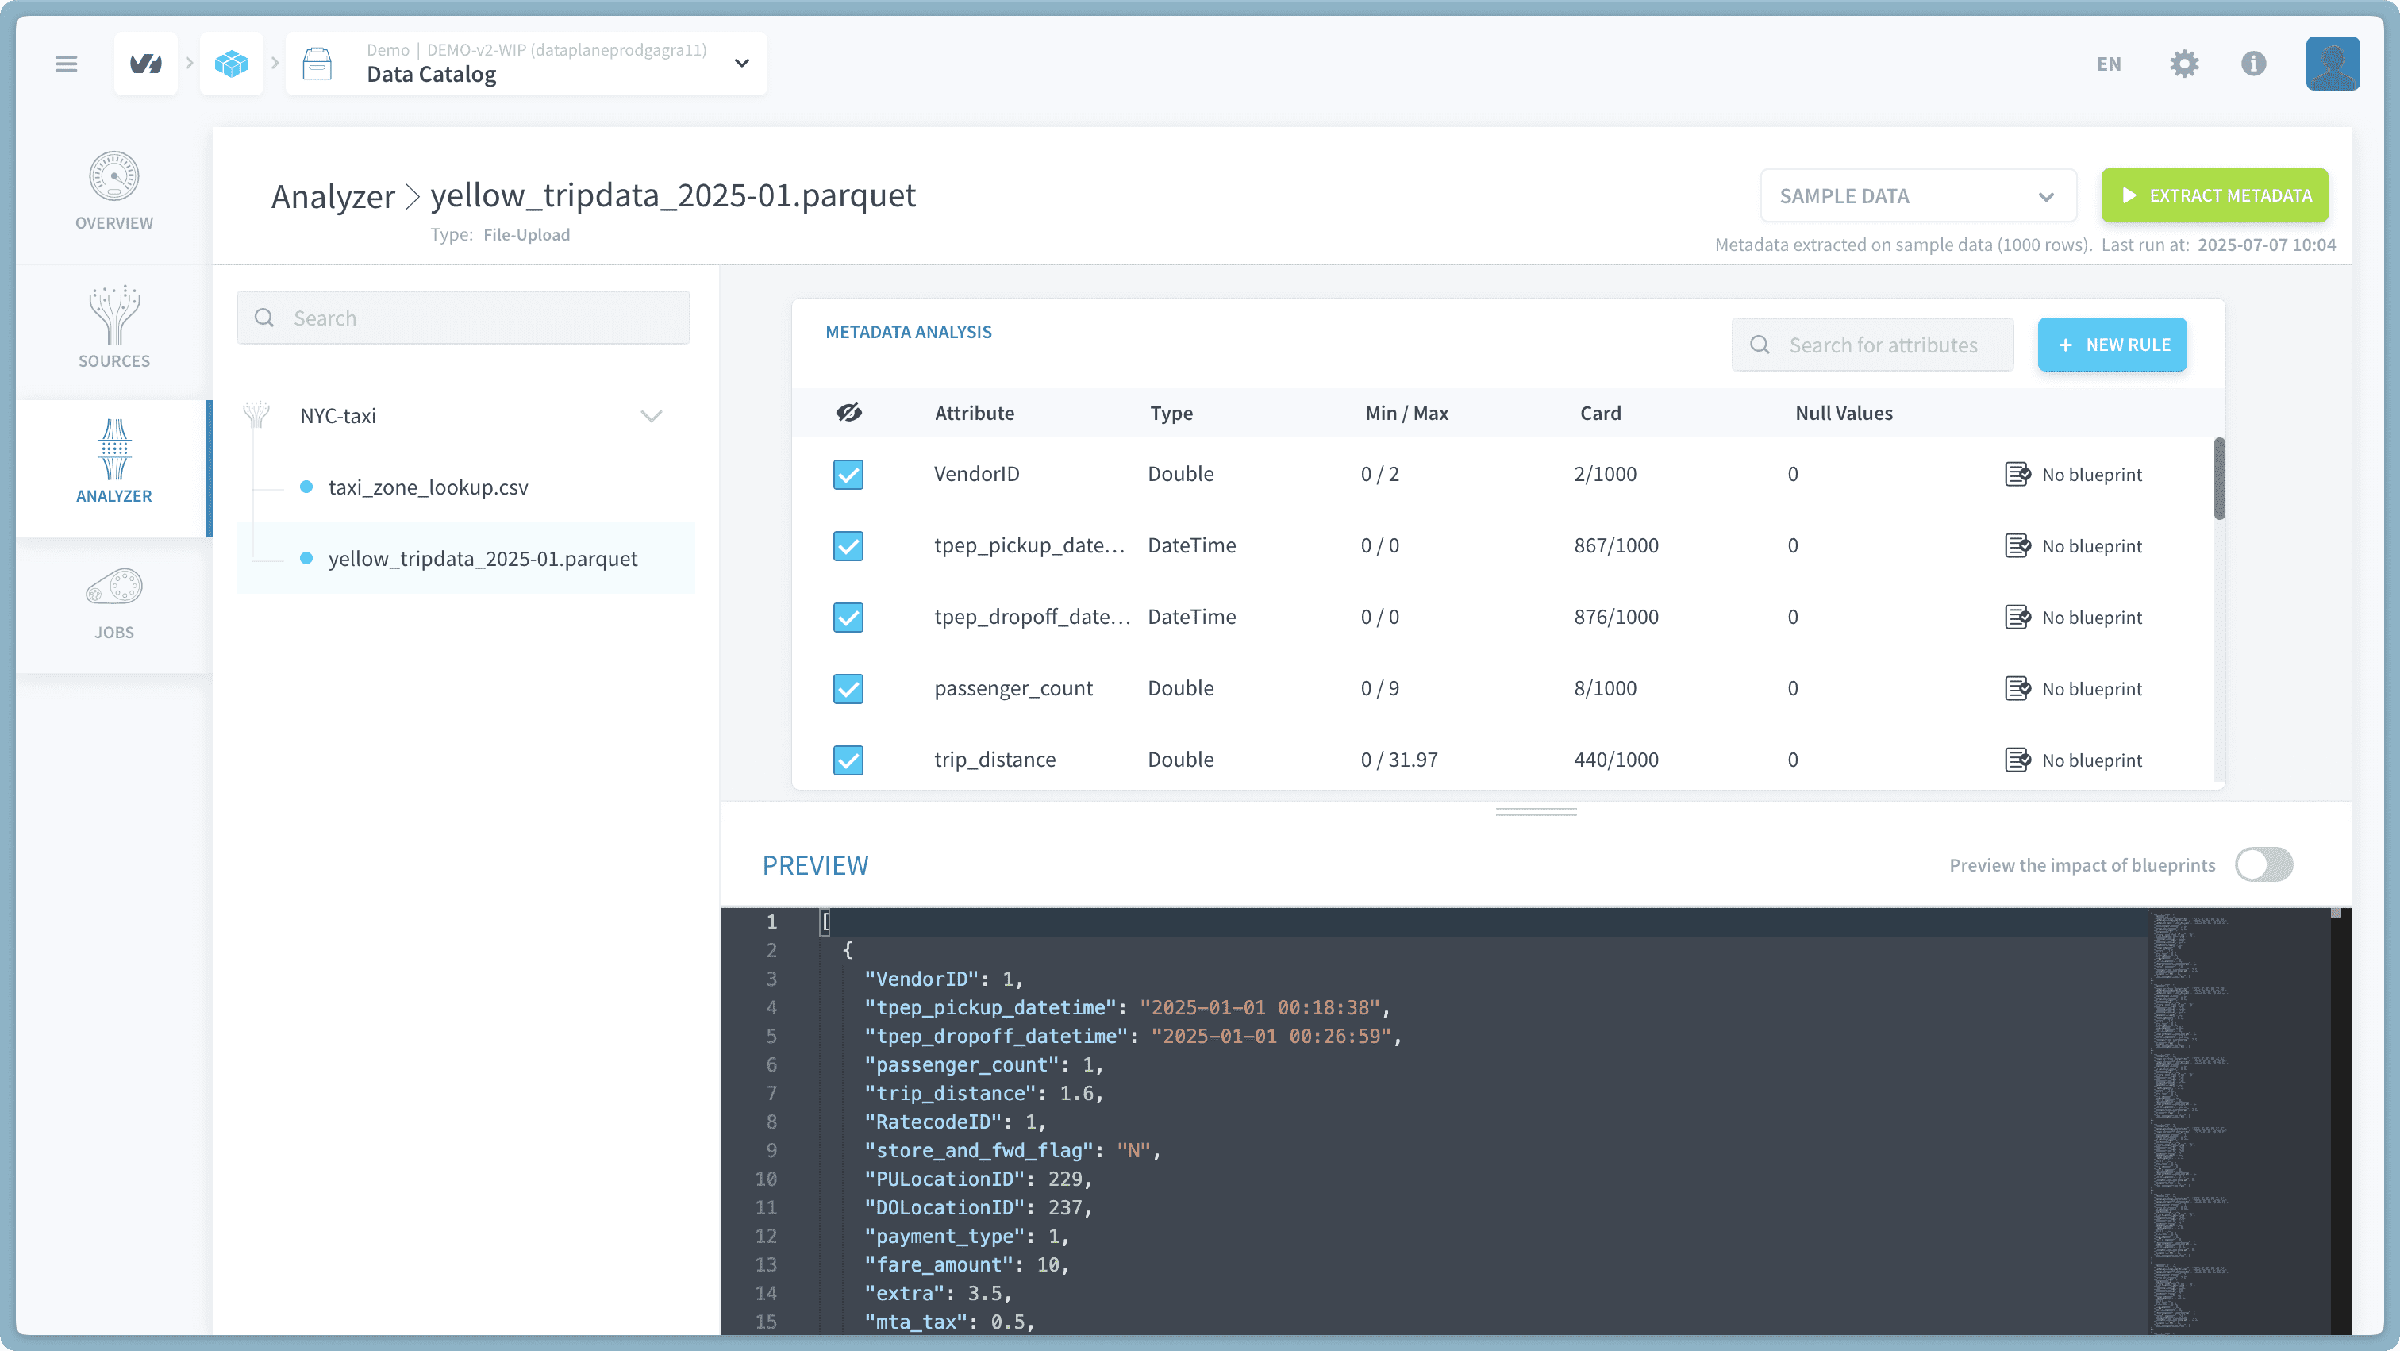
ステップ 2:Lakehouse Manager でテーブルを作成する
- Tables タブ → Connectors ソースから作成 をクリックします。
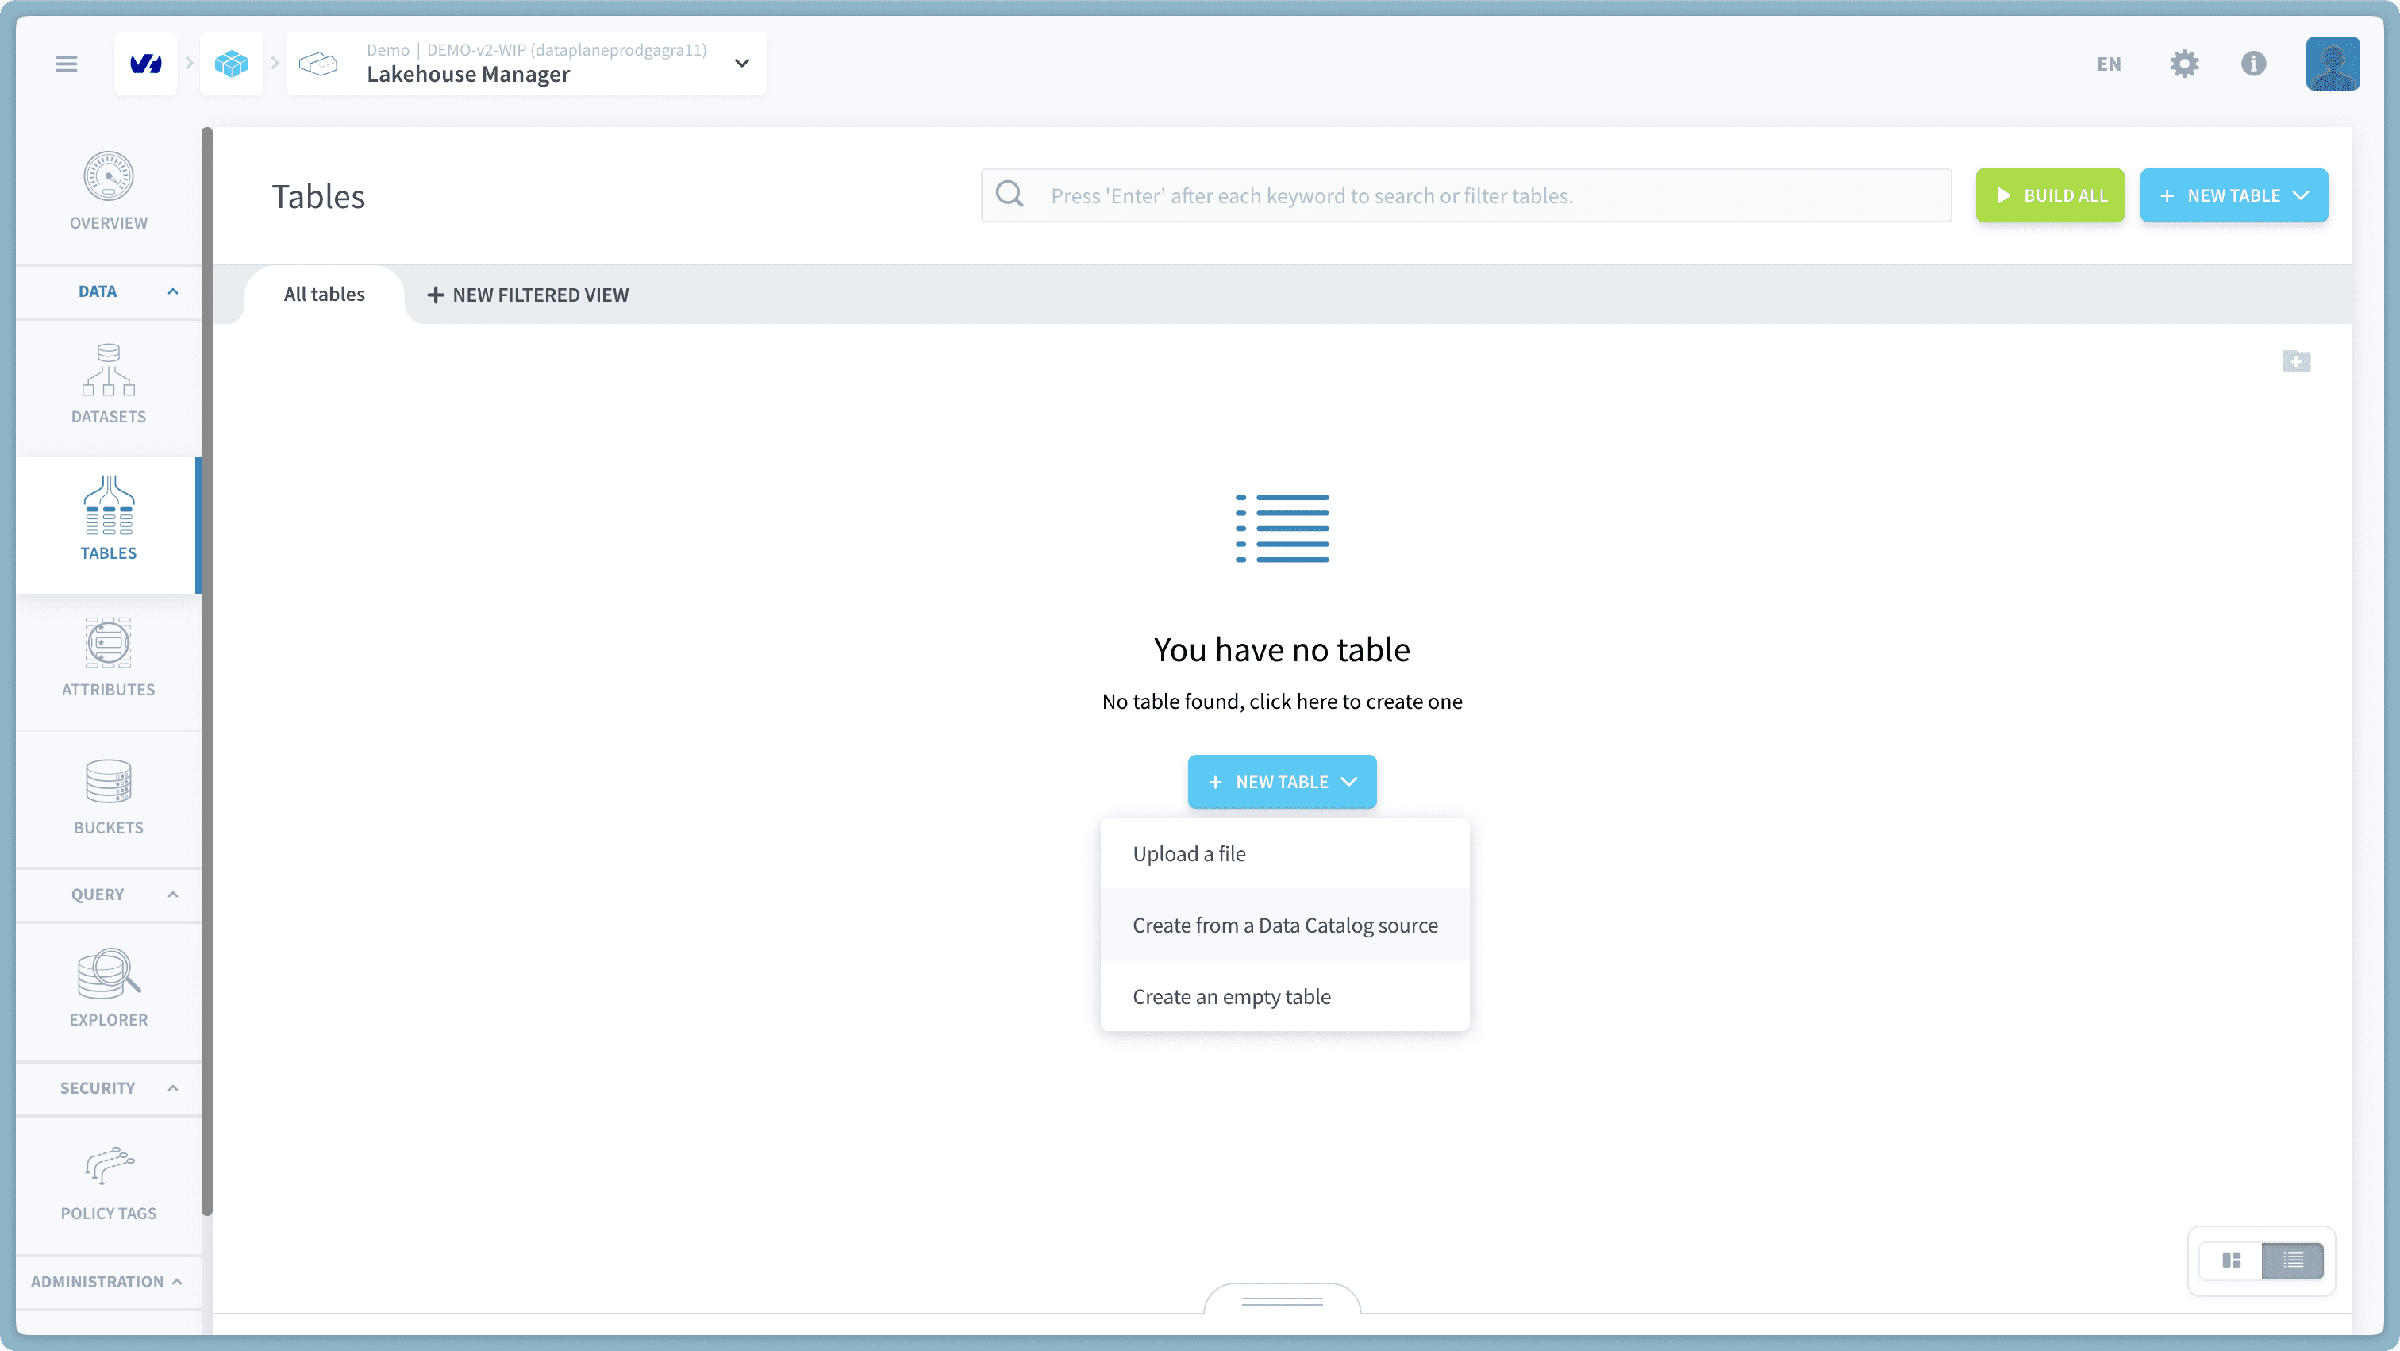
yellow_tripdata_YEAR_MONTH.parquetファイルを選択 → 「テーブルを自動的に構築する」オプションのみを選択します。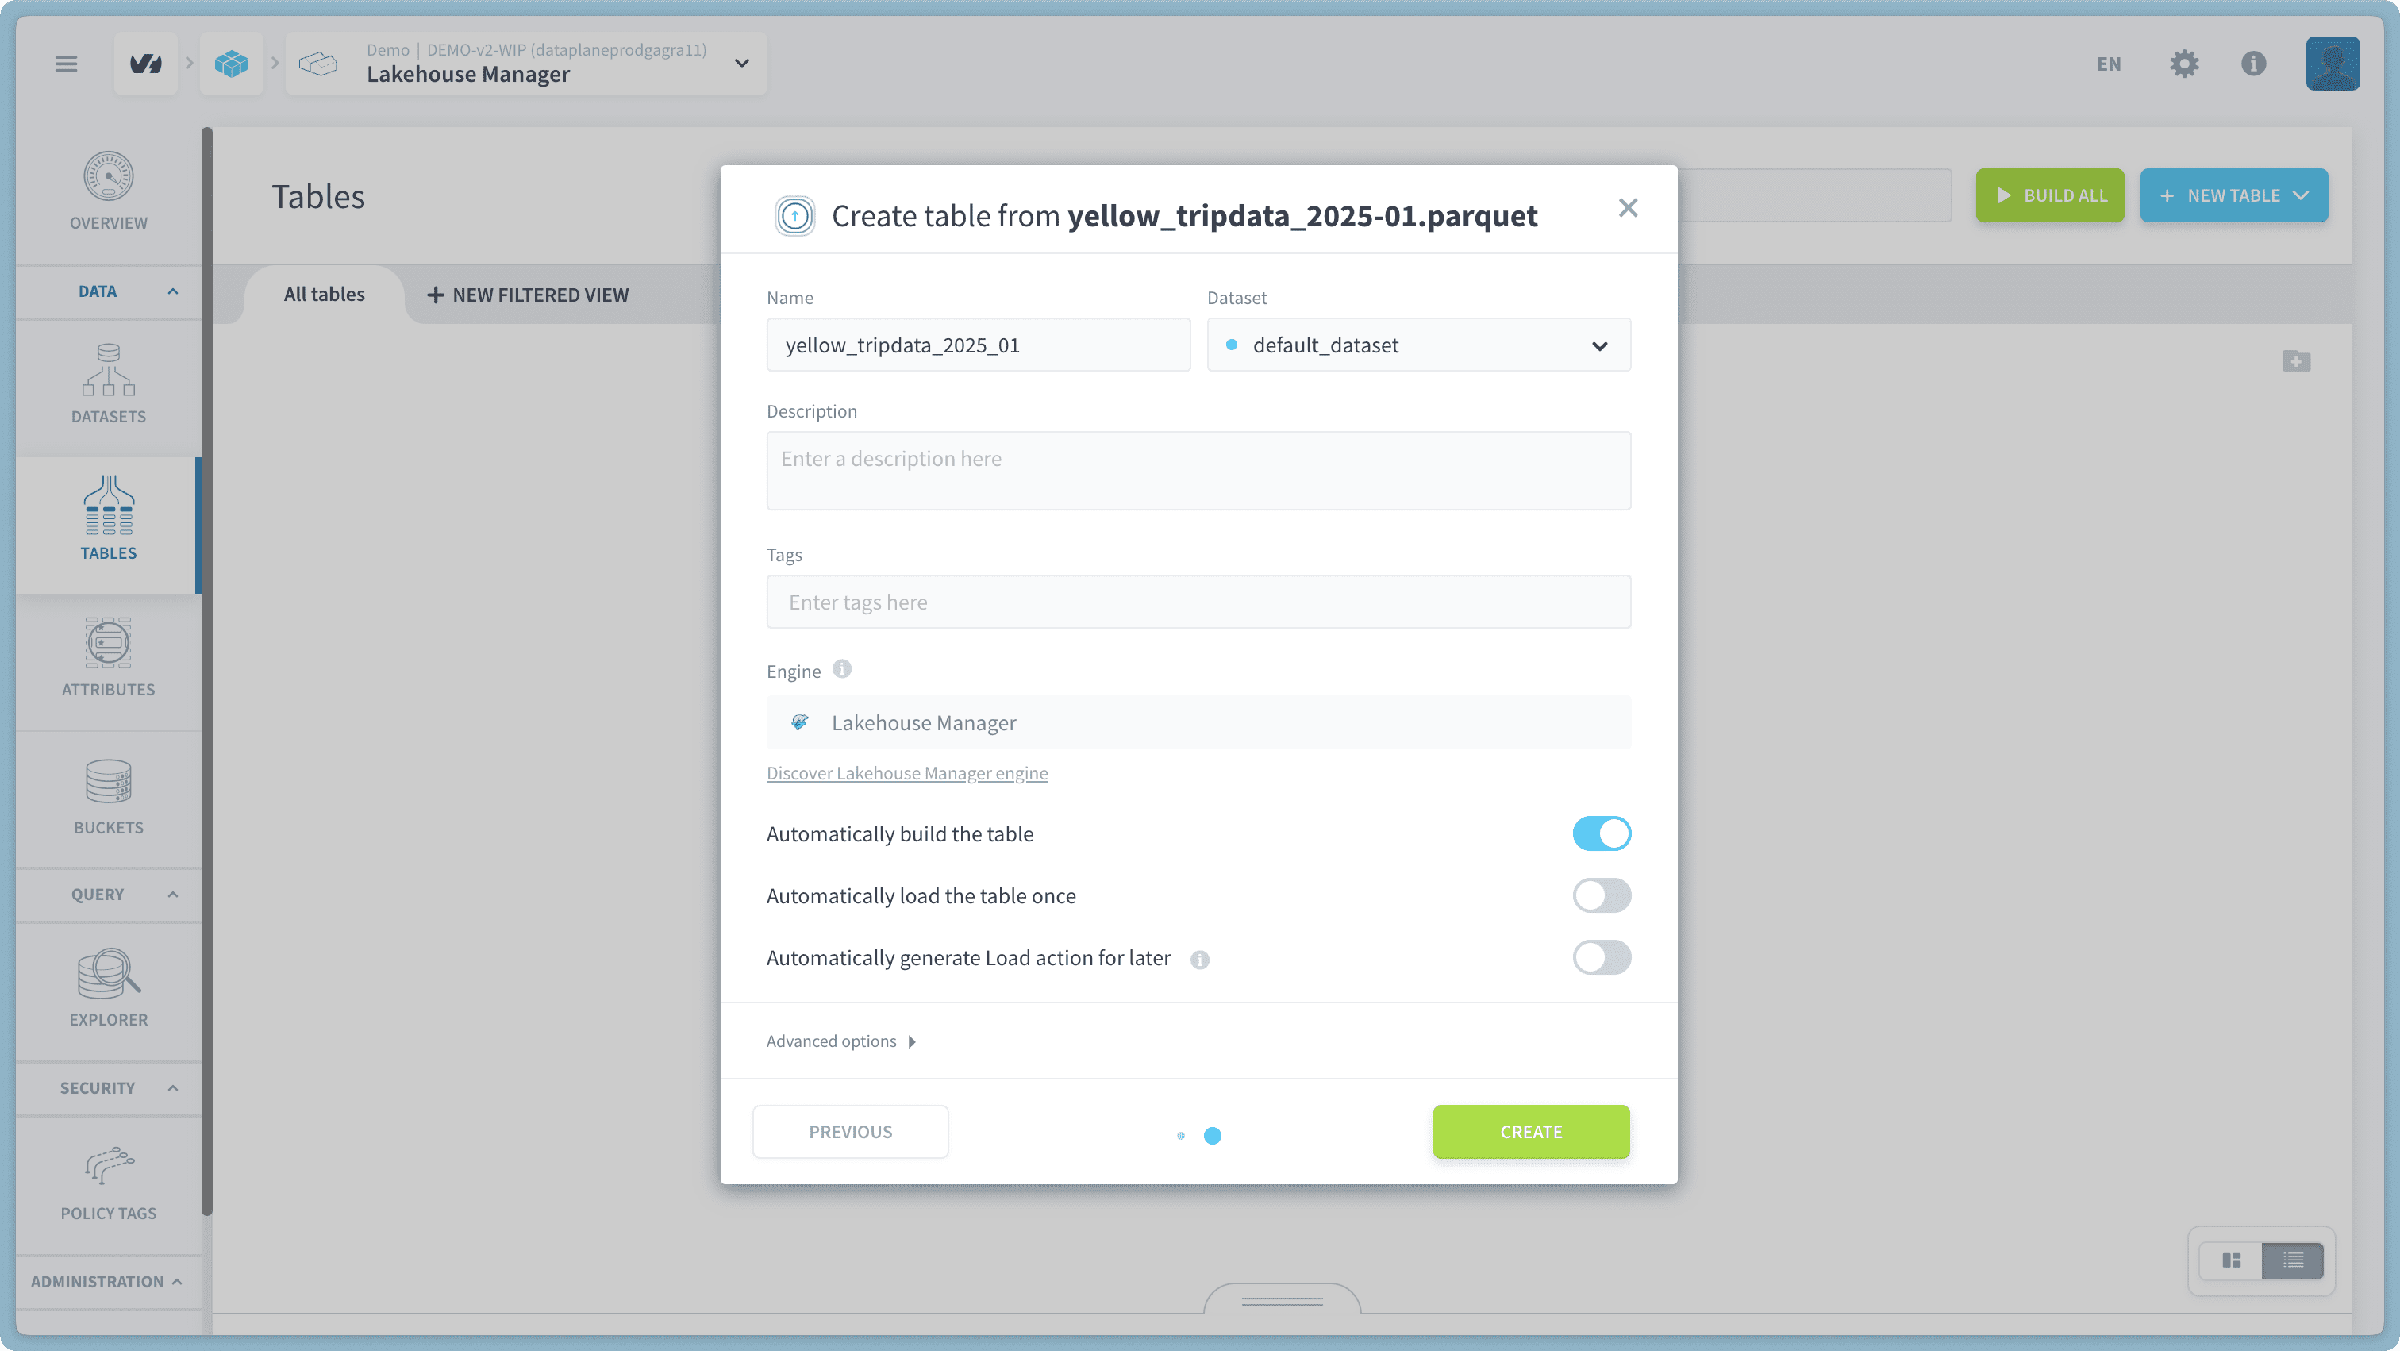
taxi_zone_lookup.csvファイルについても繰り返し、このテーブルは小さく、Iceberg によって迅速に完全に読み込まれるため、すべてのオプションを選択します。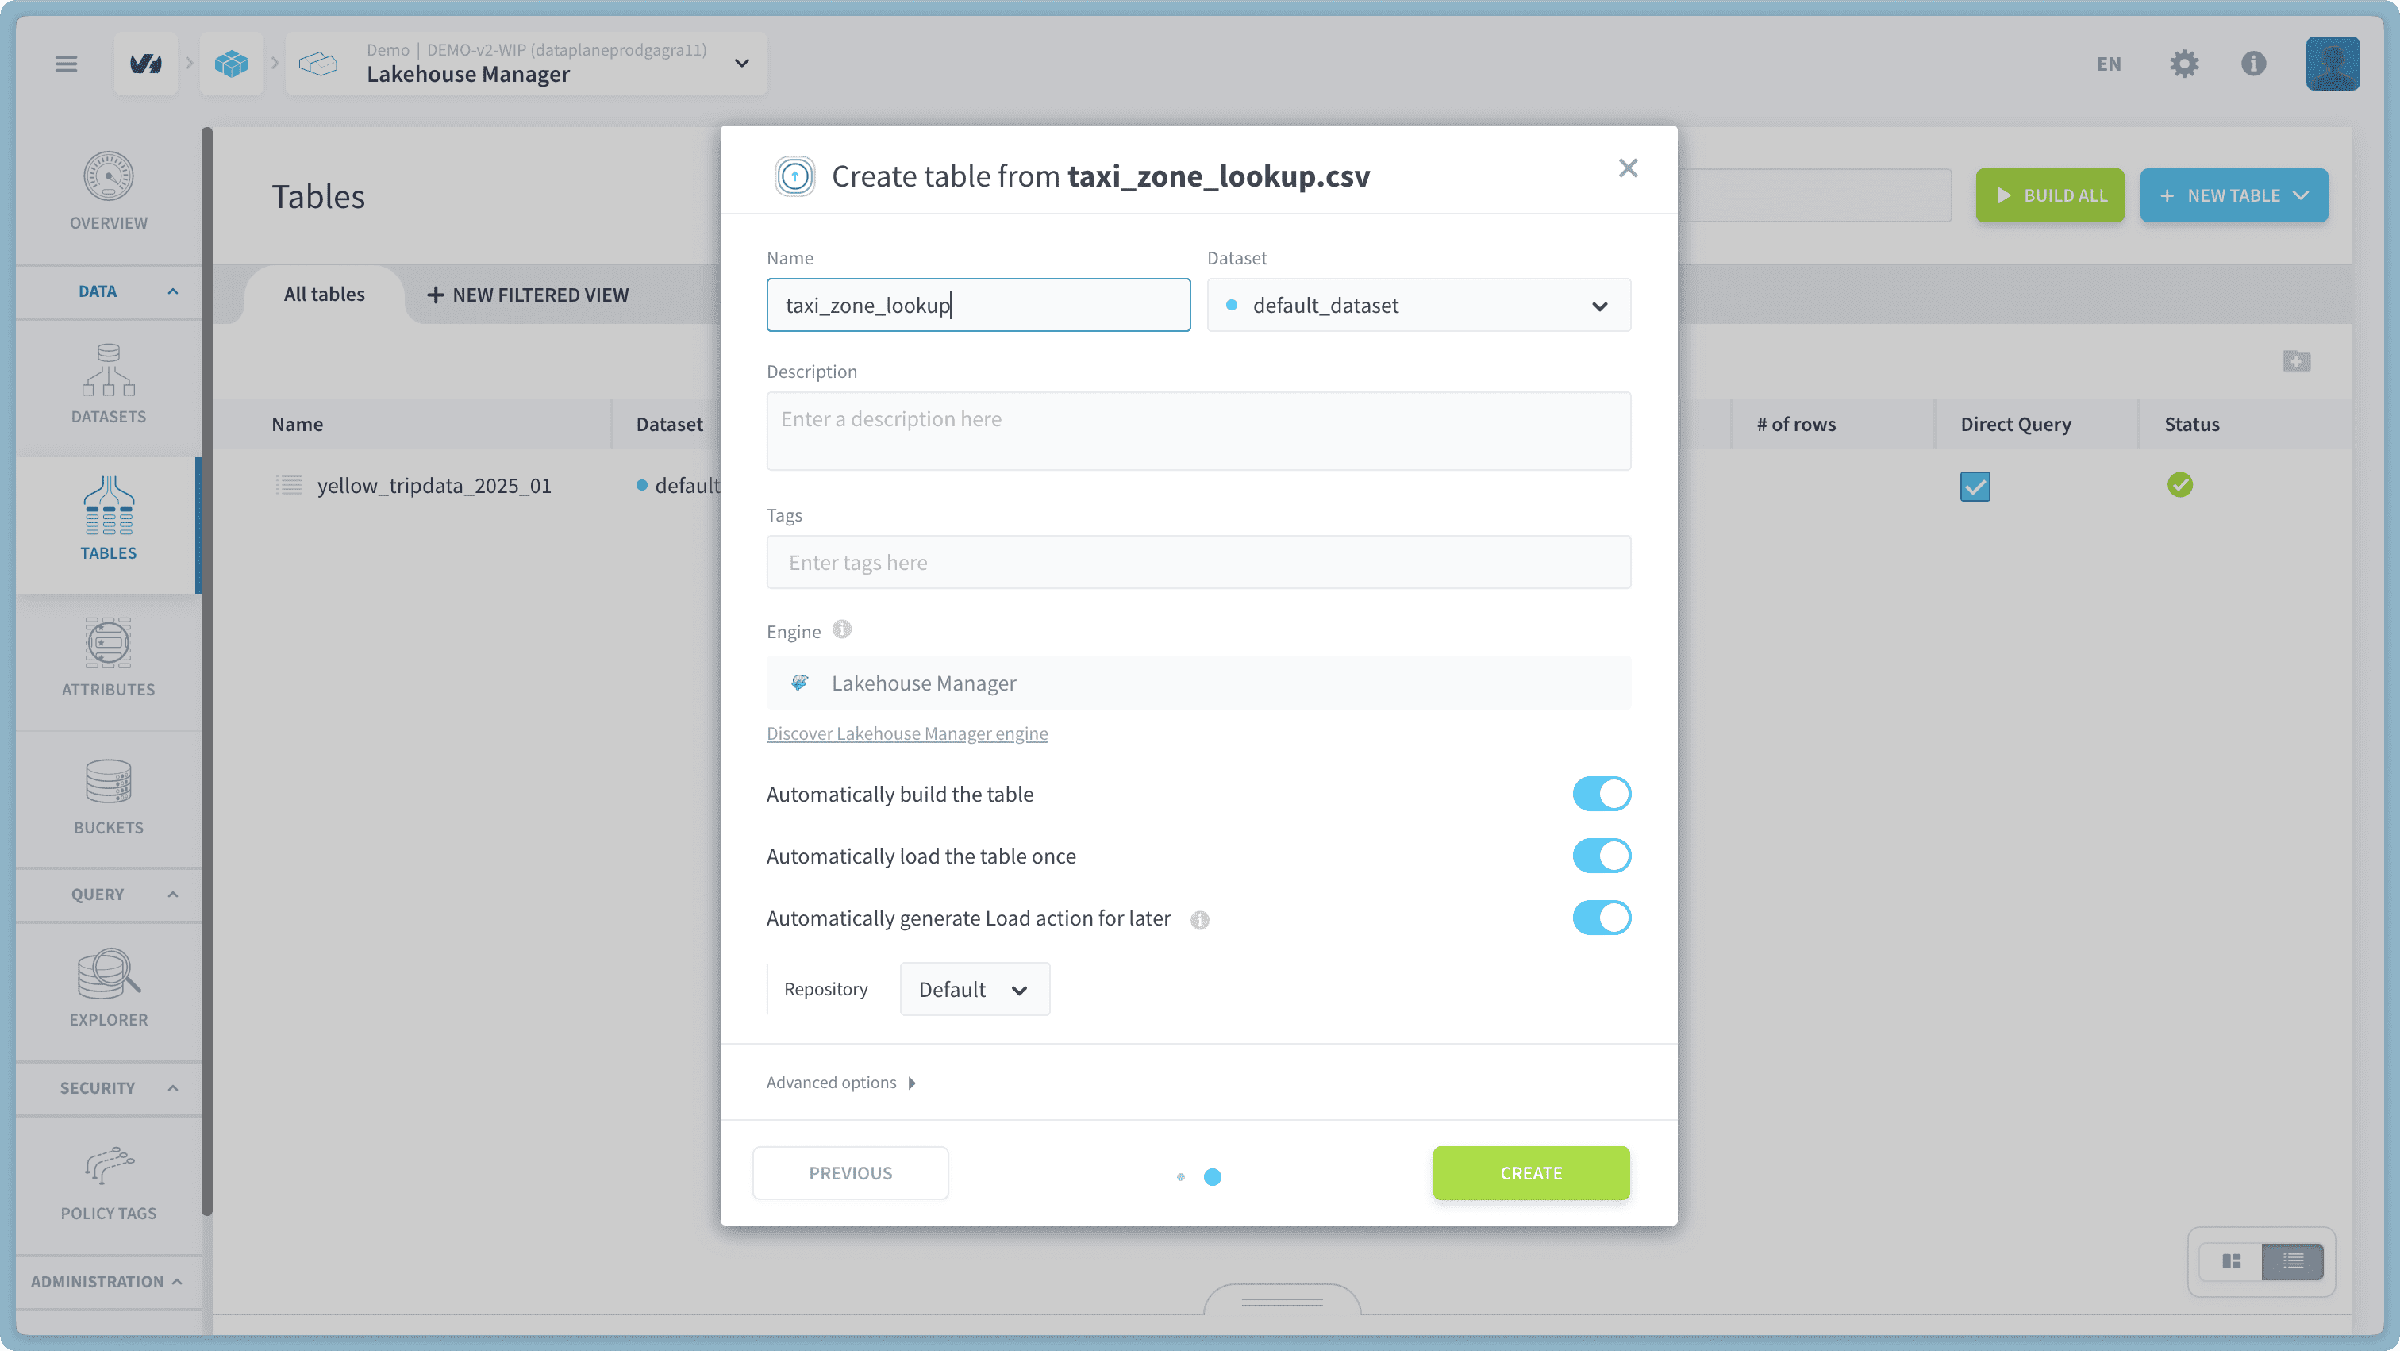
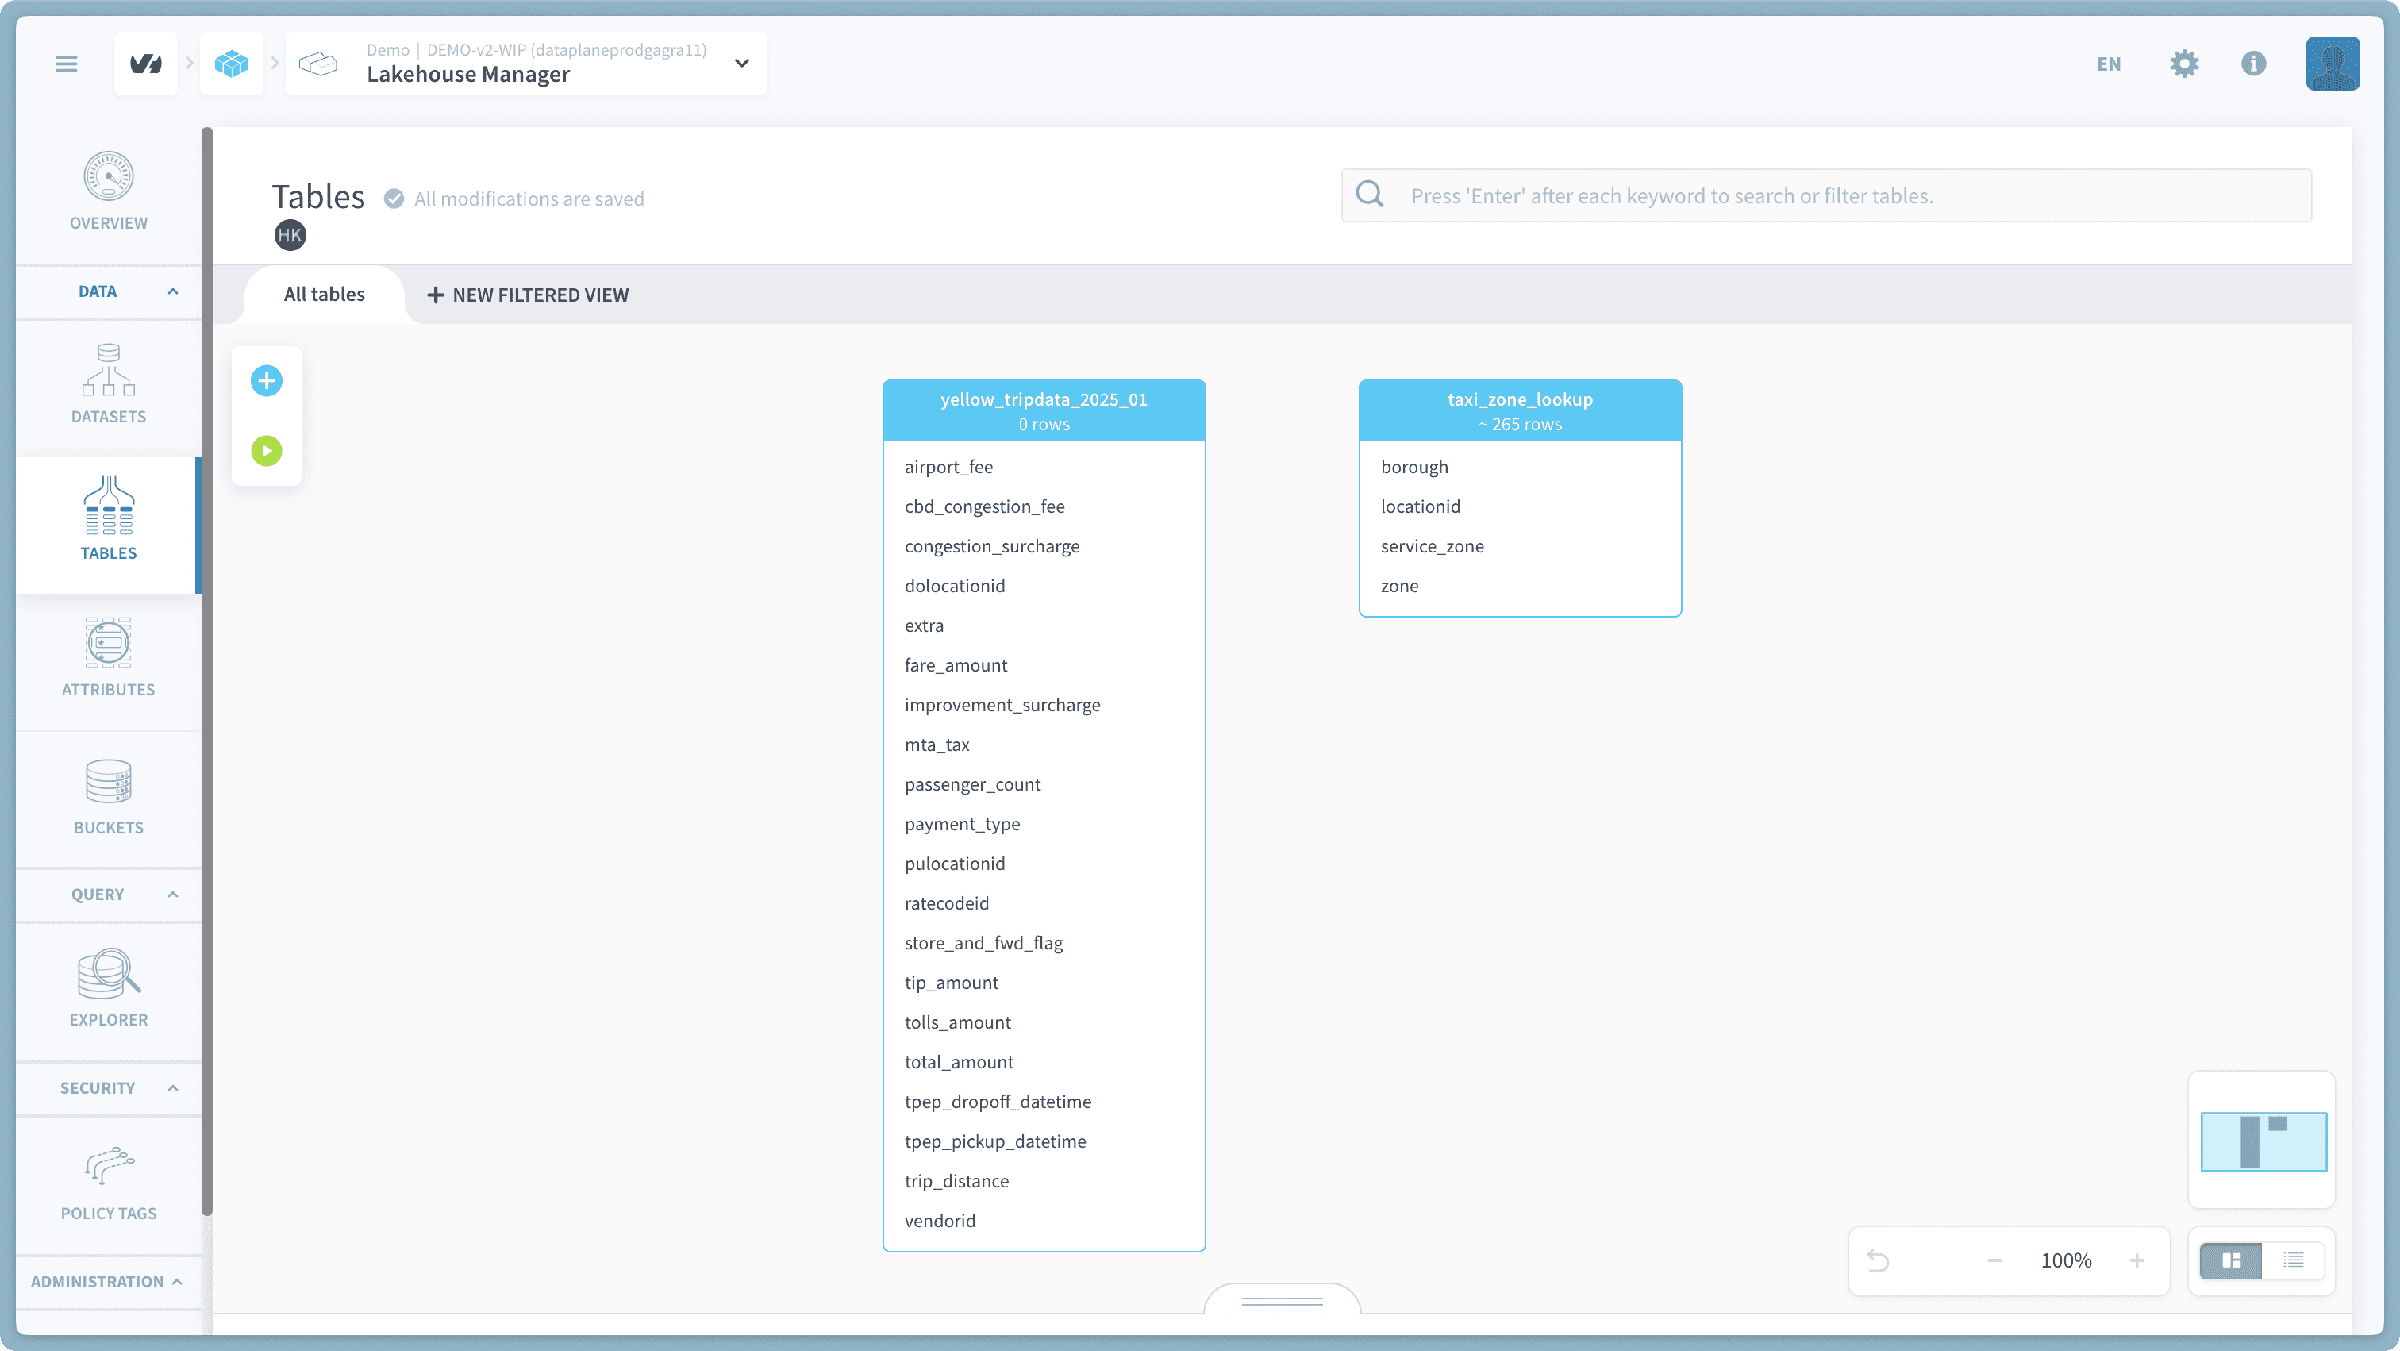
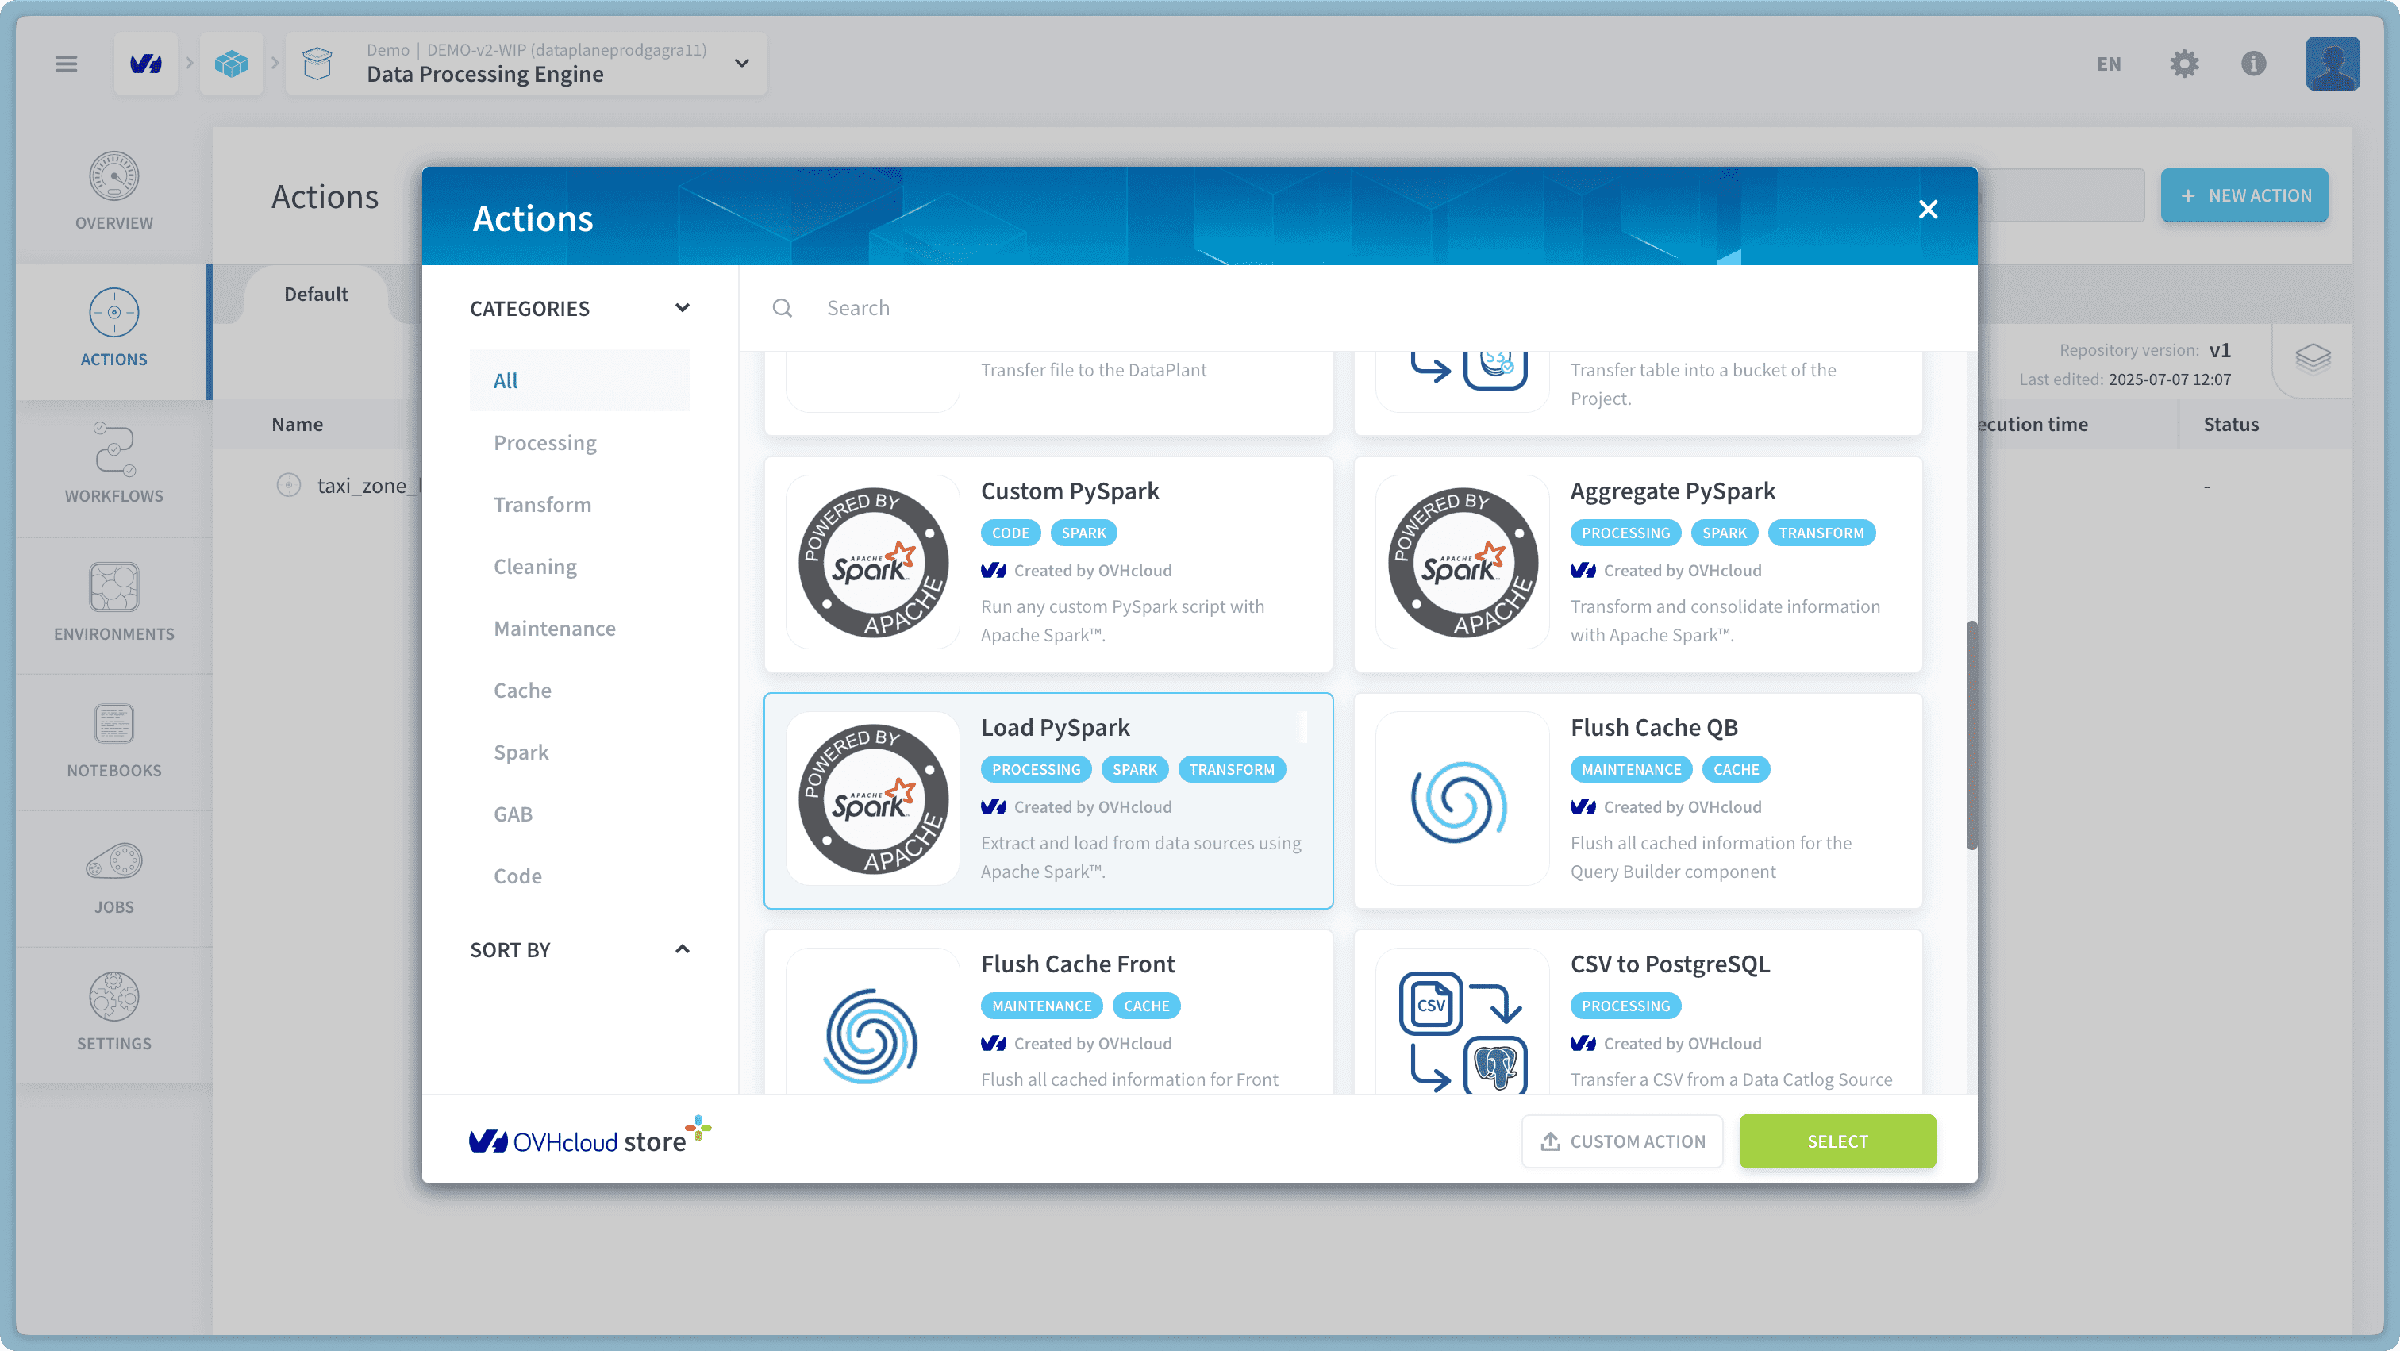
ステップ 3:DPE で Load PySpark アクションを使用する
- Actions タブ → 新しいアクションを作成 → Load PySpark を使用します。
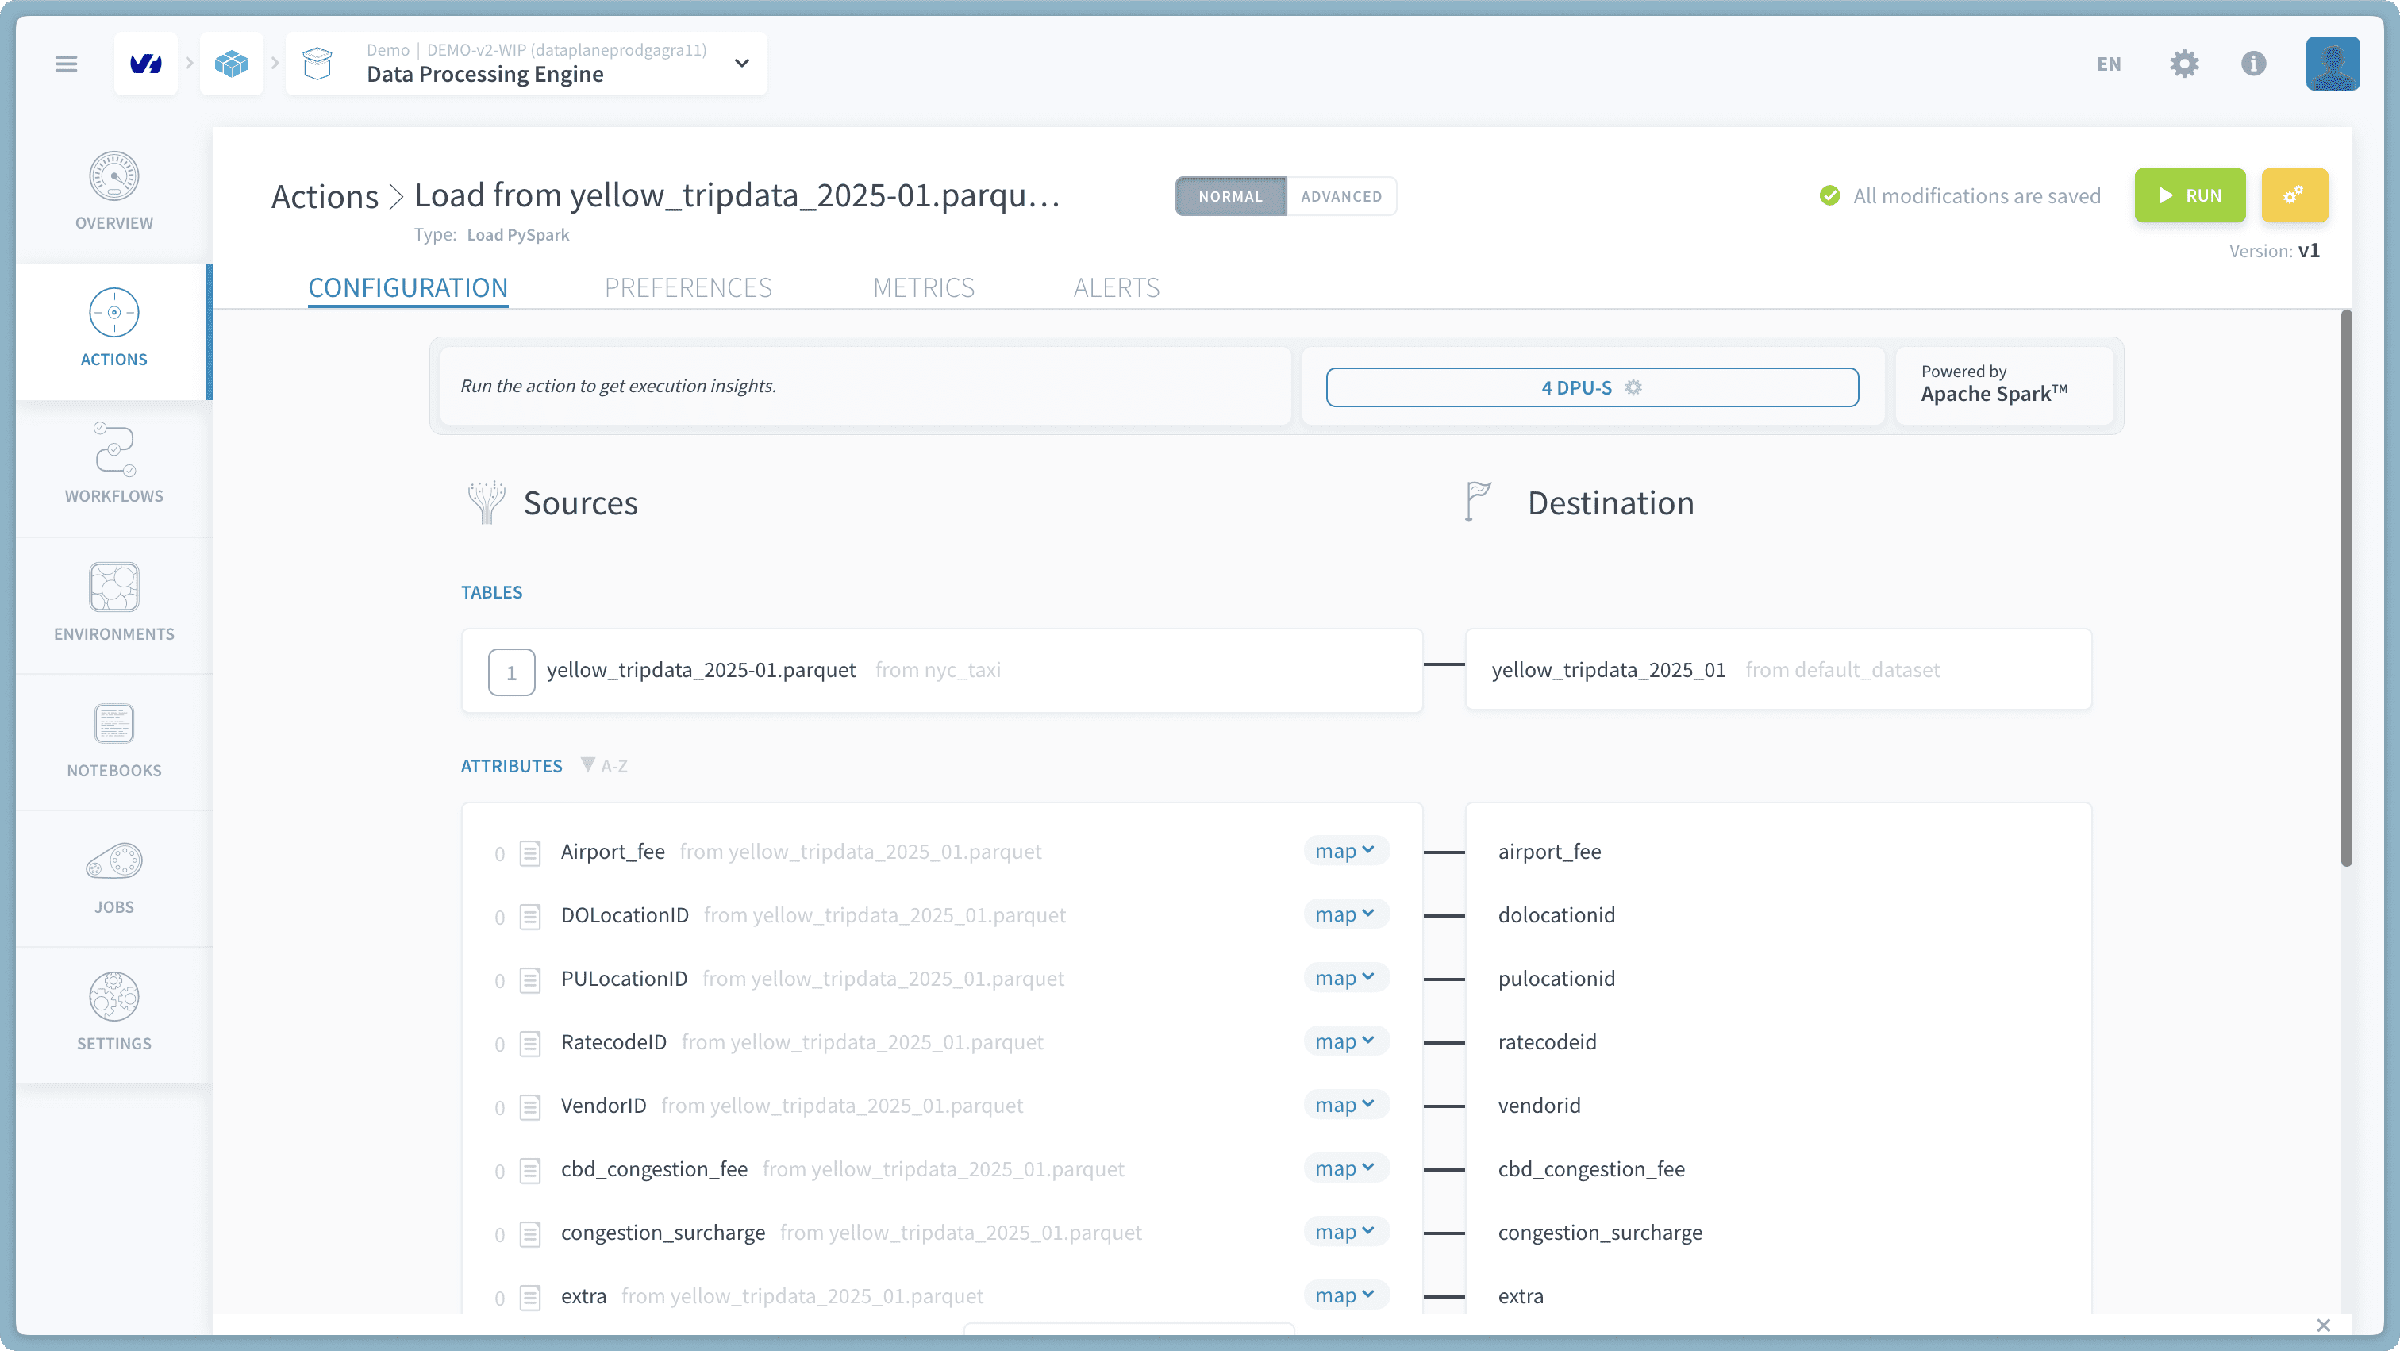
- 設定:
- Source:
yellow_tripdata_YEAR_MONTH - Destination:Lakehouse Manager の
yellow_tripdata_YEAR_MONTHテーブル。
- Source:
- スキーママッピングが正しいことを確認します(ソース列はテーブルのスキーマと一致する必要があります)。
- アクションを保存し、実行します。
ステップ 4:DPE で Jupyter Notebook を作成する
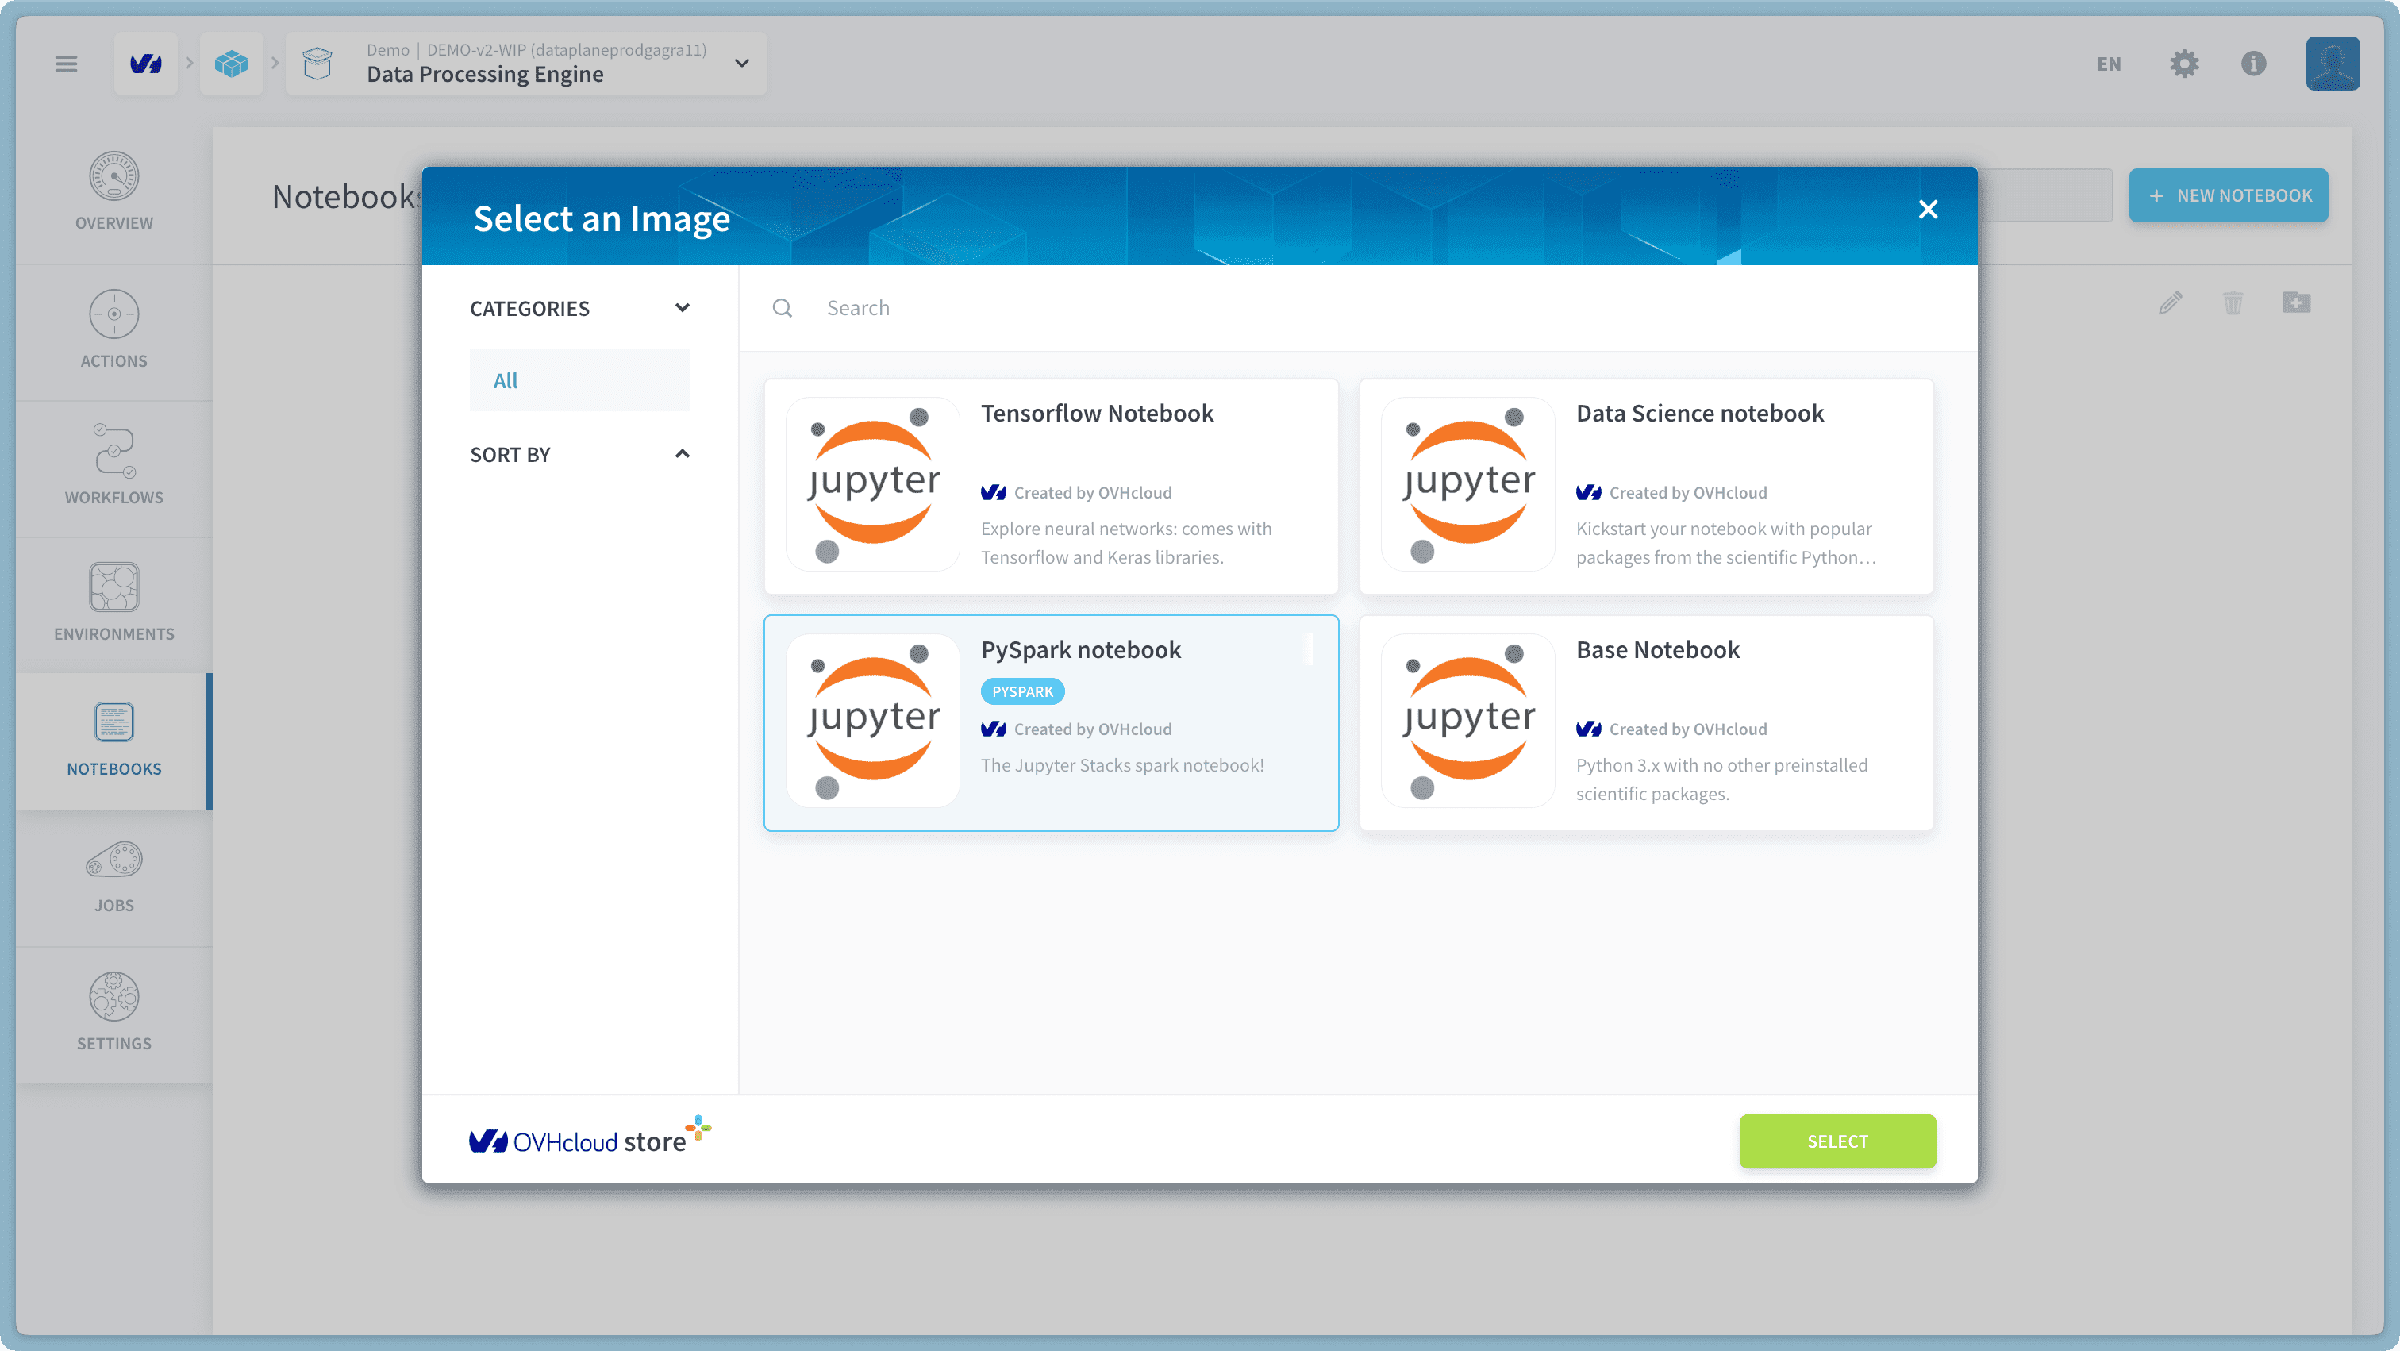
- "Notebooks" タブ → 新しいノートブック → PySpark Notebook を選択します。
NYC yellow taxi notebookと名前を付けます。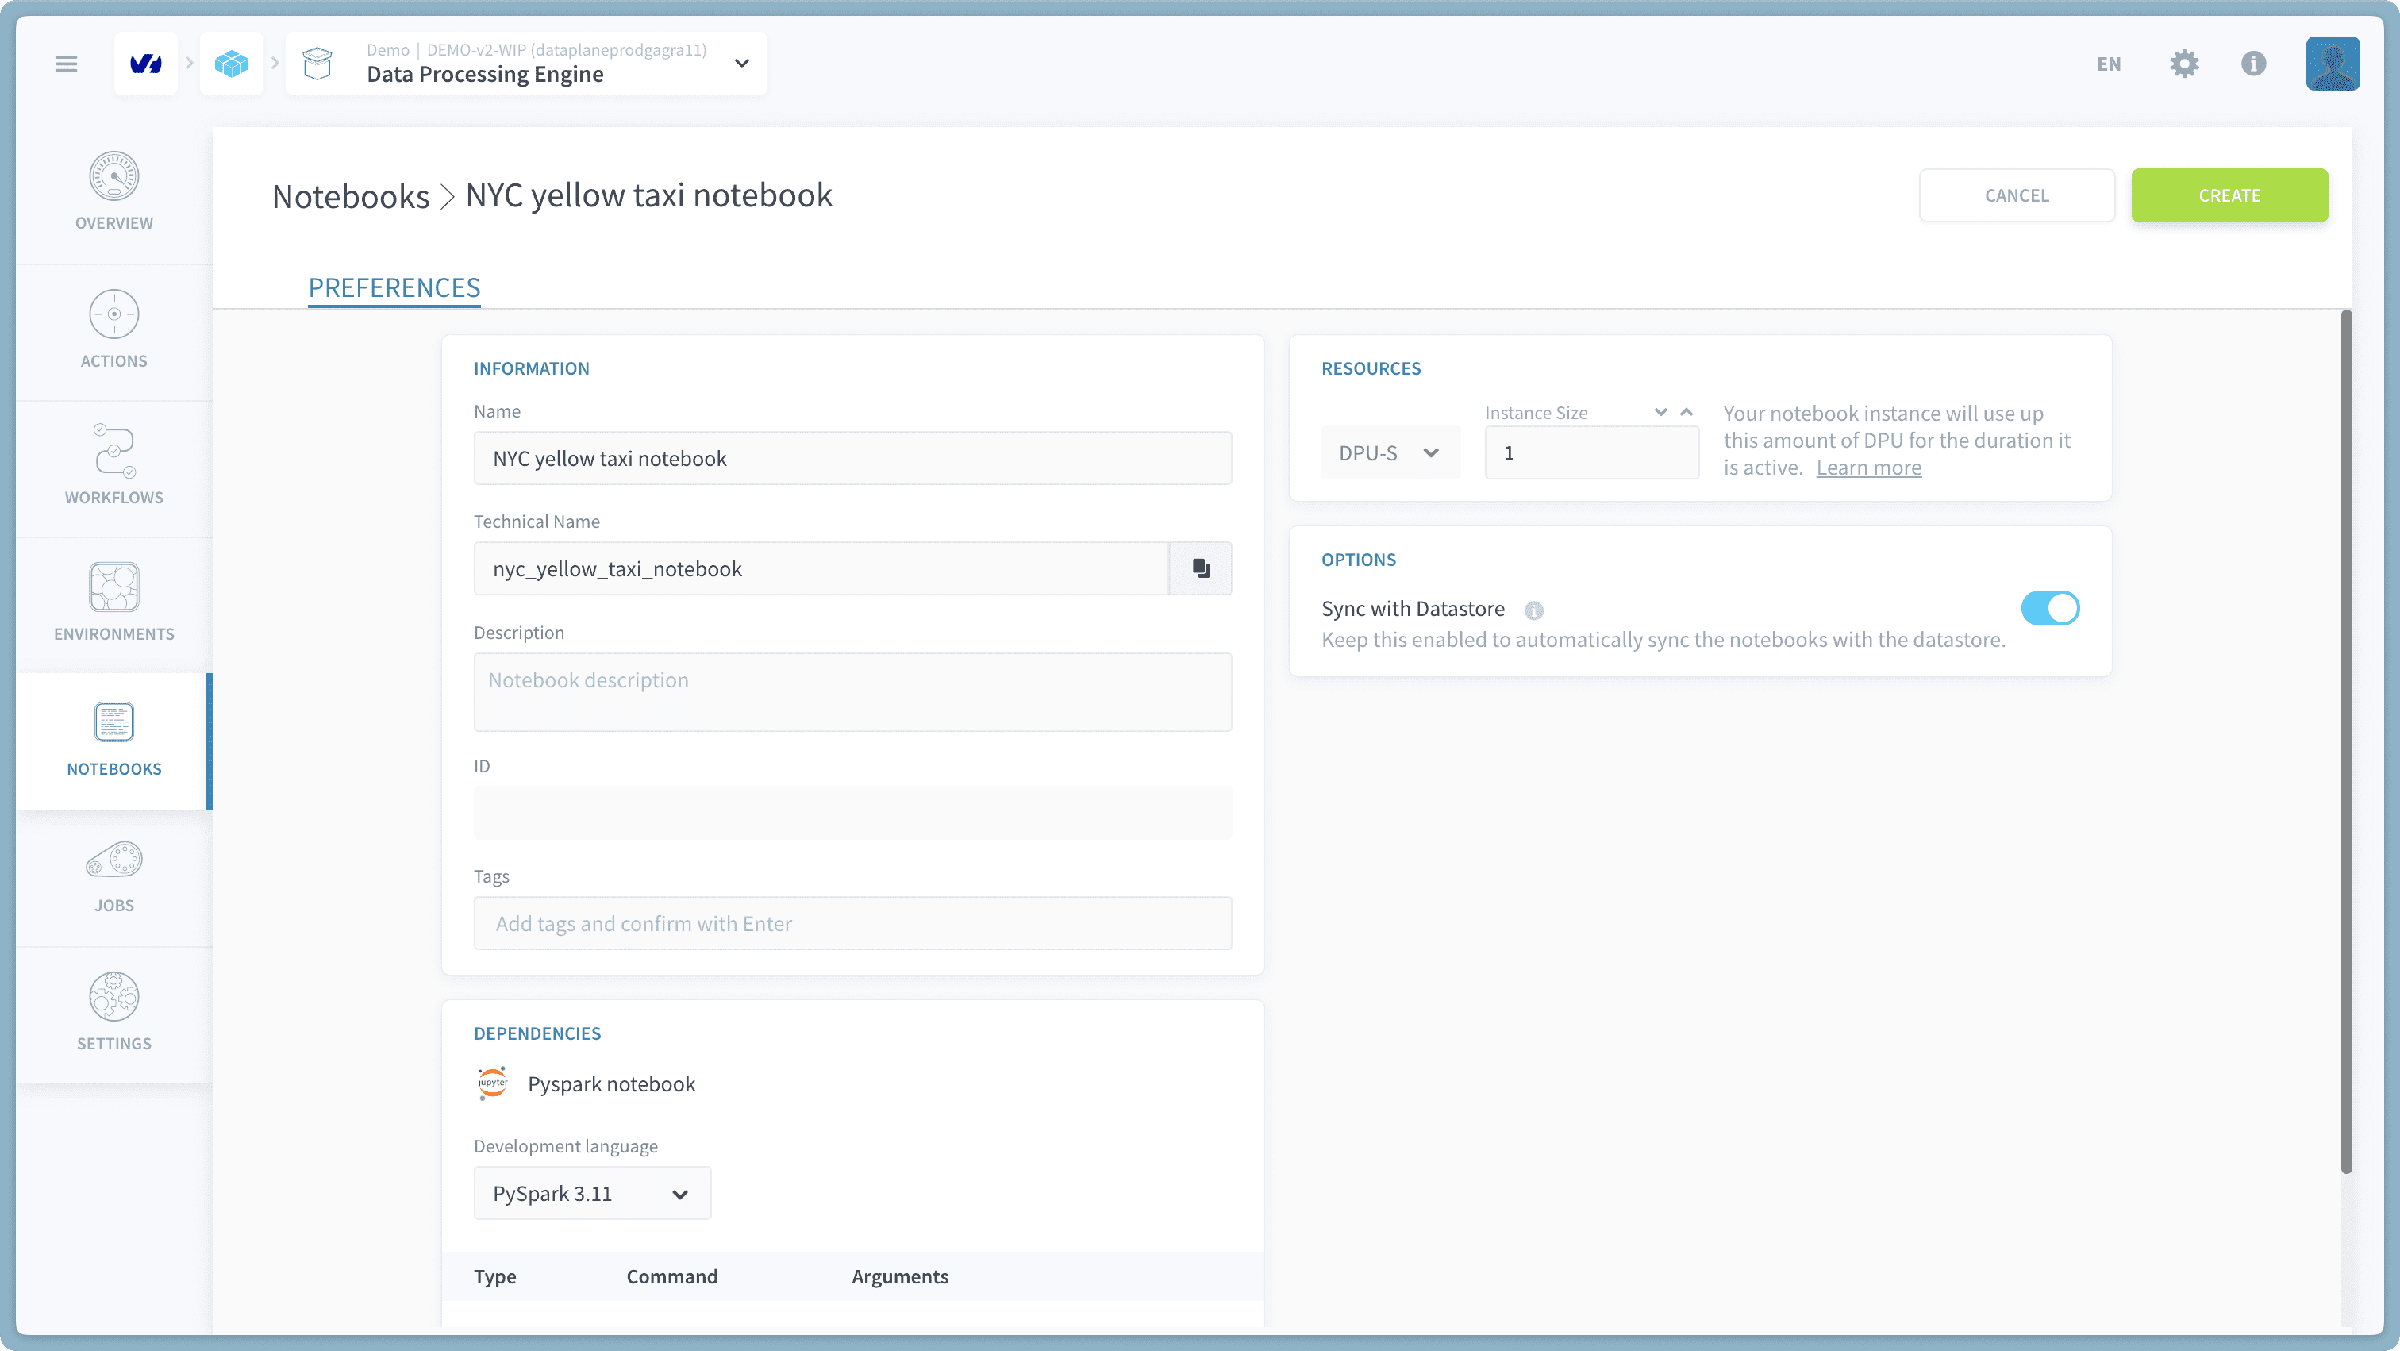
起動後、プラットフォームは JupyterHub インスタンスを初期化するのに数分かかります。準備ができたら、Open in Jupyter ボタンをクリックしてノートブックインターフェースにアクセスします。
これで、データ環境が完全に構成され、すべてのソースが Lakehouse に読み込まれたので、PySpark ノートブックに取り組み、分析を開始する準備が整いました。
PySpark Notebook のウォークスルー
以下のノートブックには、インラインコメントと説明付きでステップごとに構造化された完全な PySpark コードが含まれています。これをダウンロードして、OVHcloud Data Platform 上の Jupyter 環境に直接アップロードできます。各ステップは詳細に説明されており、分析プロセスを追うのに役立ちます。また、最後に簡単な参照用の要約が提供されます。
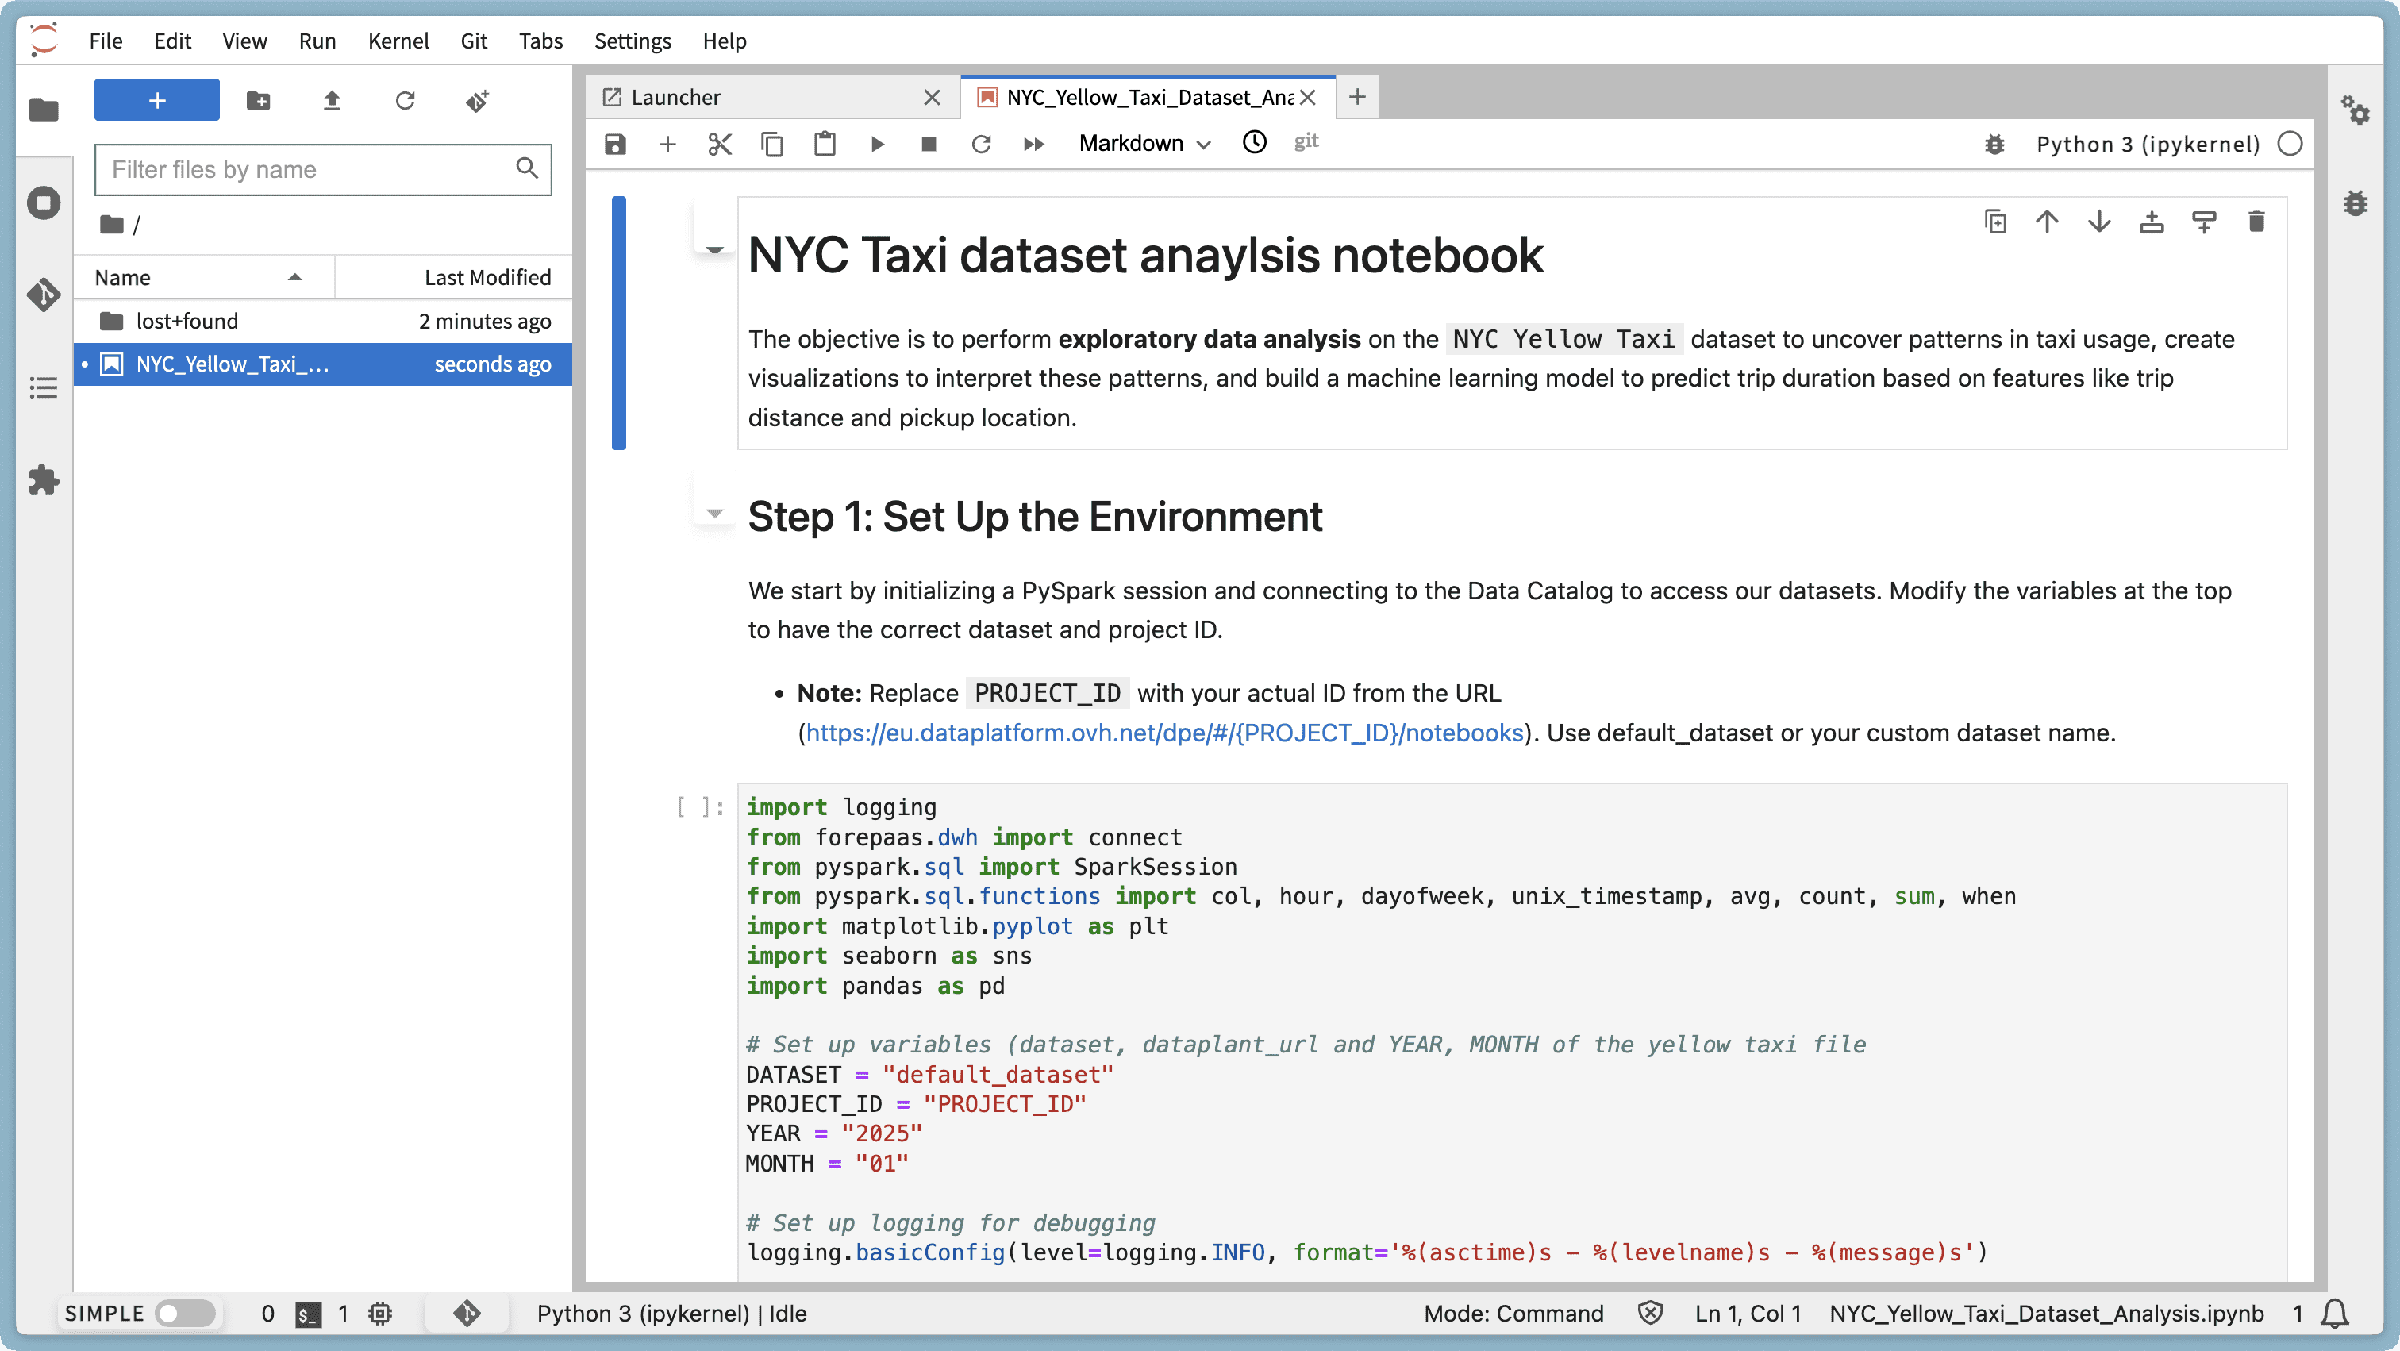
ノートブックに含まれている内容
このノートブックでは、以下の内容を説明します:
- Lakehouse Manager に接続し、データセットを読み込む。
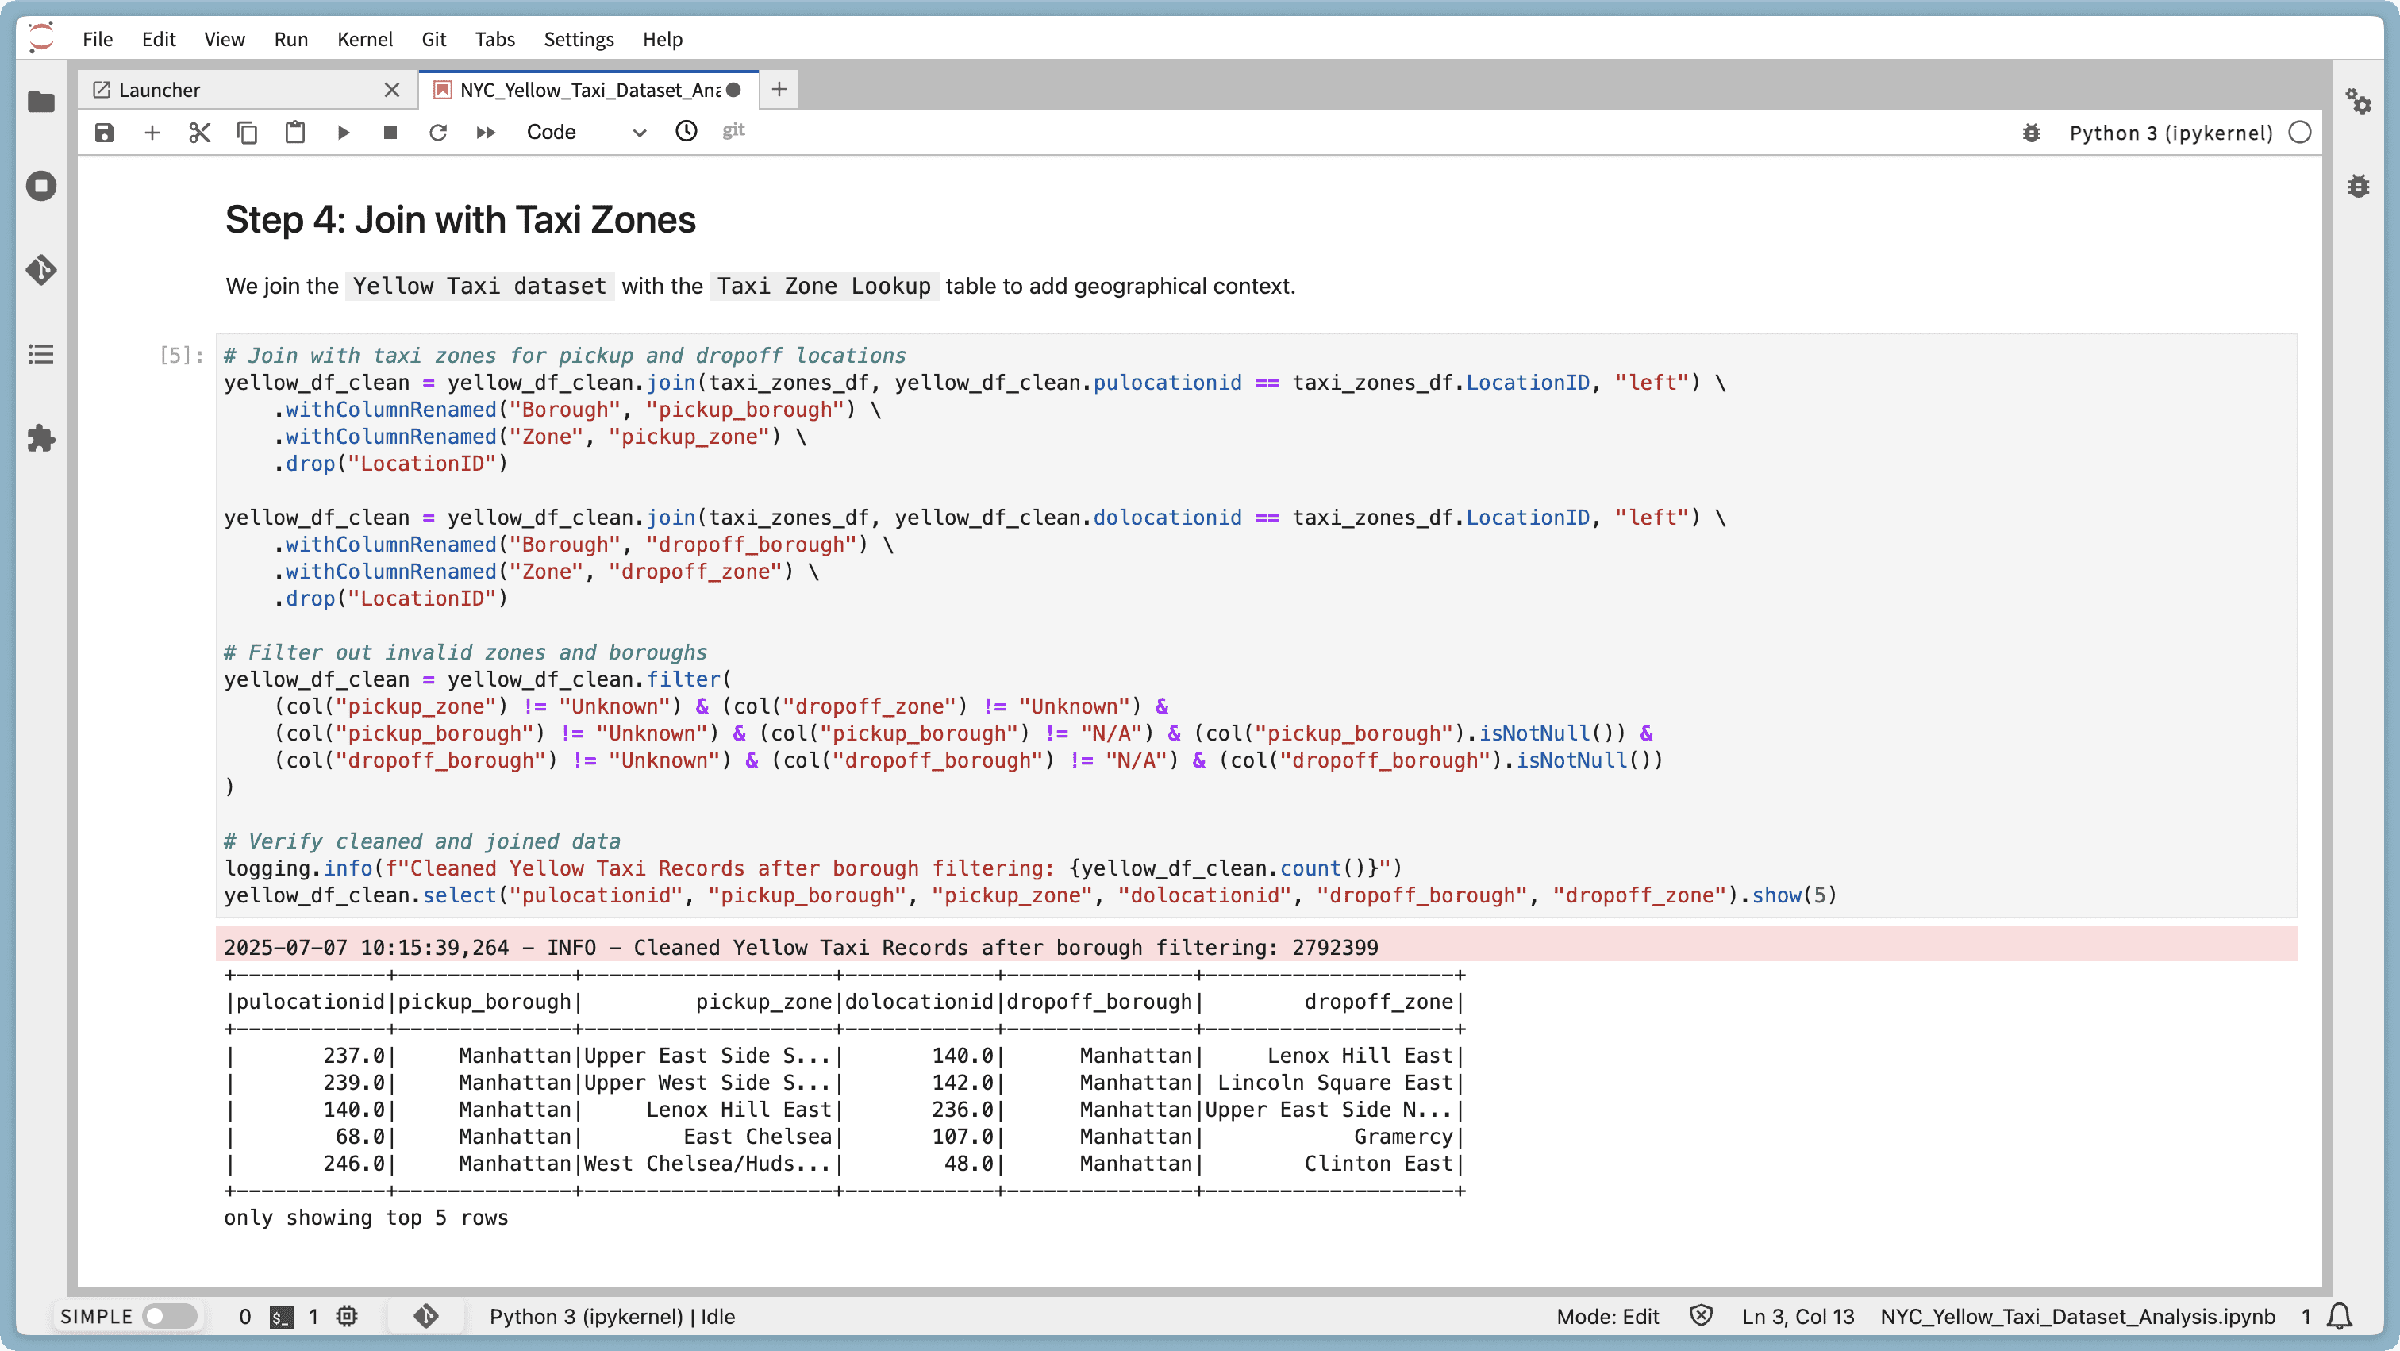
- 旅行データをクリーンアップし、ゾーンのルックアップと結合する。
- Matplotlib と Seaborn を使用して EDA を実行する。
- 3 つの ML モデル(線形回帰、ランダムフォレスト、GBT)を構築し、比較する。
- パフォーマンスメトリクスと洞察を出力する。
以下は、ノートブックからのサンプル出力です:
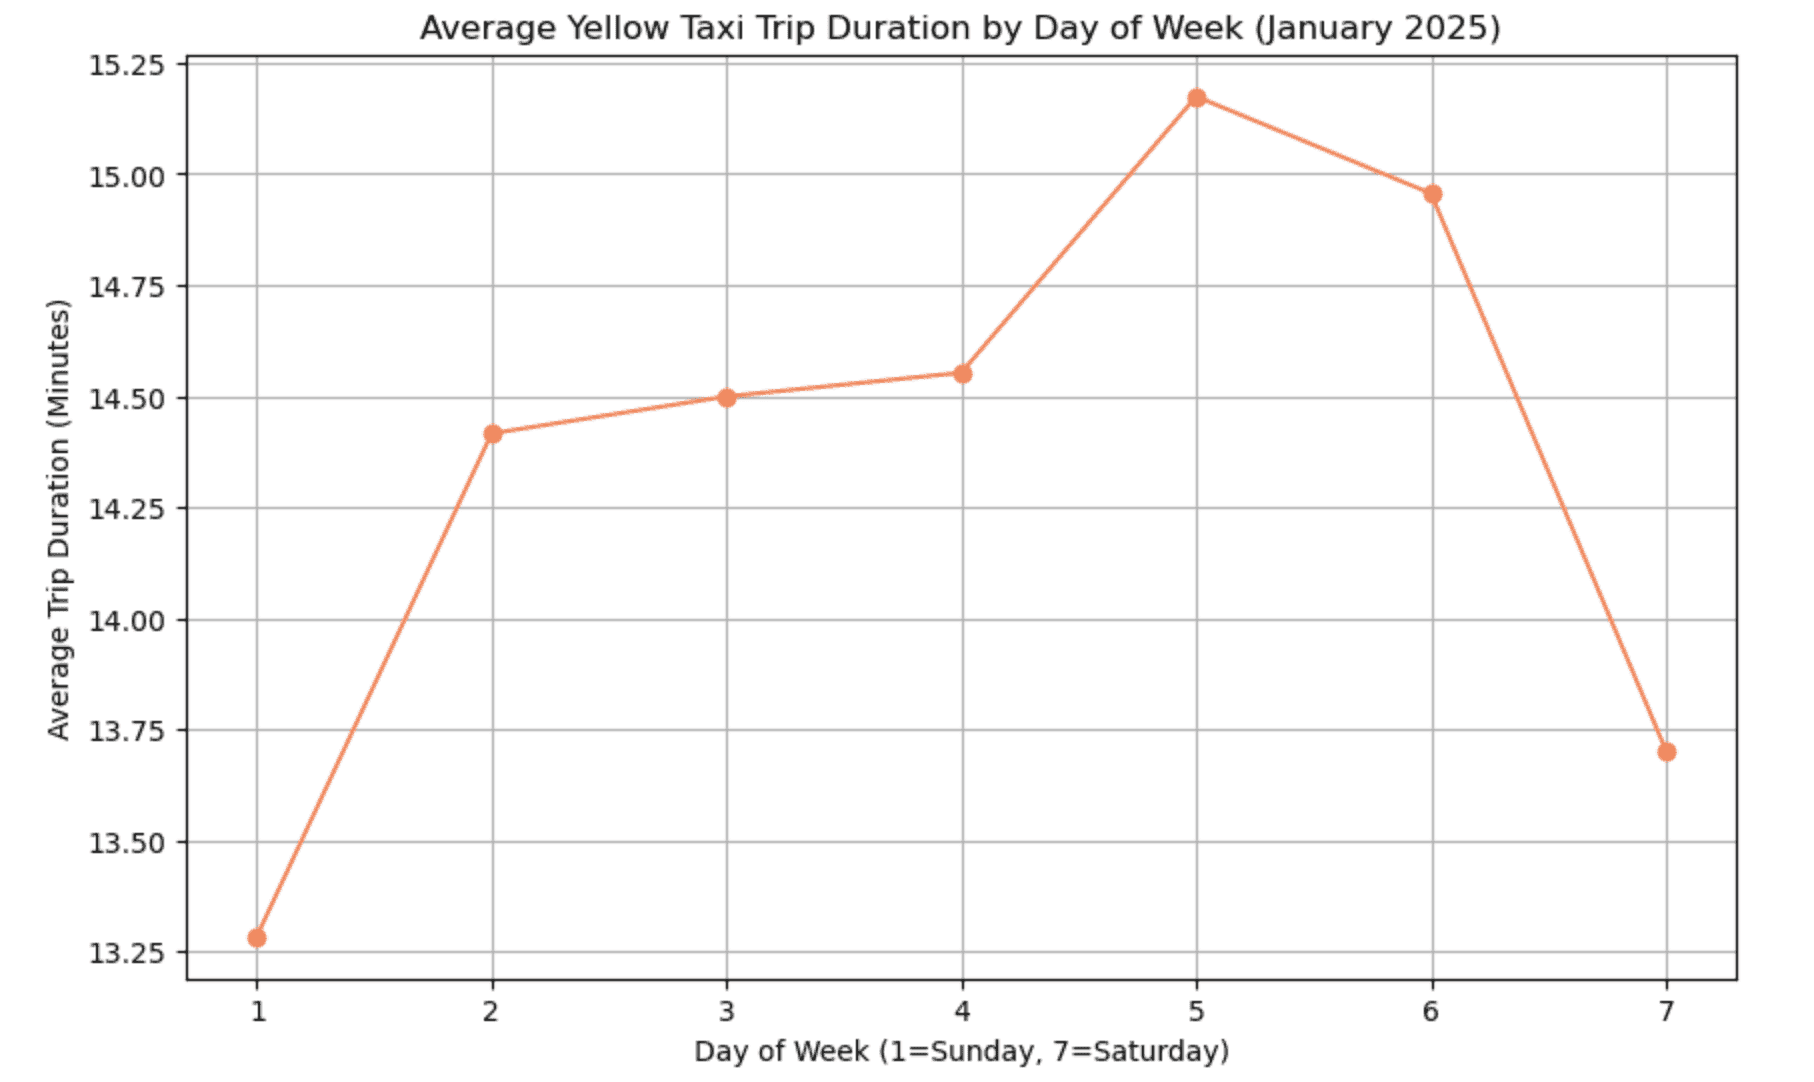
NYC Taxi Trip Duration Prediction – Summary
Objective
この分析の目的は、機械学習モデルを使用してNYC Yellow Taxiデータで学習させたモデルを用いてtrip_durationを予測することでした。これらの予測は、タクシーの配車戦略を最適化し、運賃見積もりを改善し、運用上の意思決定を支援するのに役立ちます。
Models Compared
このタスクにおけるこれらのモデルの有効性を理解するために、3つの回帰モデルを評価しました:
- Linear Regression – 単純で解釈可能なベースライン
- Random Forest – 非線形の関係を捉えるアンサンブル方法
- Gradient Boosted Trees (GBT) – 予測精度を最大化することを目的としたブースティングベースのアプローチ
Data Preparation
高品質な入力データを確保し、モデルの性能を向上させるために、以下の手順が実行されました:
- 極端な外れ値(60秒未満または3600秒を超える旅程)を削除
- カテゴリ変数(例:
pickup_borough)をエンコード - 数値特徴をスケーリングし、統一された特徴ベクトルに組み立て
Features Used
trip_distancepickup_hourday_of_weekpickup_borough(インデックス付き)
Data Split
- Training set: 80%(約220万レコード)
- Test set: 20%(約55万6000レコード)
Model Performance
Interpretation: GBTは全体的に最も優れた性能を発揮し、最も低い二乗平均平方根誤差(約4.8分)と最高のR²スコア(80.6%の分散が説明)を実現しました。
Feature Importance (Random Forest)
Insight: 旅程距離は最も影響力のある予測因子でした。ピックアップ区は一定の影響を与えましたが、時間ベースの特徴(時間と平日)は旅程時間にほとんど影響を与えませんでした。
Impact of Data Cleaning
- 負の値や現実離れした値のレコードを削除
- ノイズを減らし、モデルの信頼性を向上
- 最終データセット(約278万レコード)はより代表的
- 全モデル、特にGBTにおいてRMSEが低く、R²が高くなりました
Conclusion
このチュートリアルでは、PySparkとOVHcloud Data Platformを使用して、大規模なタクシー旅程データを処理、探索、モデリングする方法を効果的に示しました。構造化されたデータ準備、視覚分析、モデル評価を通じて、旅程時間の主要な要因を特定し、強力な性能を持つ予測モデルを構築しました。
テストされたモデルの中で、Gradient Boosted Trees(GBT)は正確性と堅牢性の両面で最も優れた結果を提供し、実際の予測タスクにおけるその価値を示しました。
ここでは、インジェスト、変換、探索、機械学習をカバーするワークフローを紹介しました。このワークフローは、異なるドメインにおける類似の大規模分析プロジェクトの再利用可能なフレームワークとして役立ちます。
Go further
トレーニングや技術的なアシスタンスが必要な場合は、営業担当者にお問い合わせください、またはProfessional Servicesページを訪れて、見積もりをリクエストし、専門家チームにプロジェクトを分析してもらってください。
質問をする、フィードバックを送信し、Data Platformを構築するチームと直接交流するには、専用のDiscordチャンネルにアクセスしてください。
OVHcloudサービスについてサポートが必要な場合は、Help Centreでリクエストを作成してください。
コミュニティのユーザーに参加してください。