

デプロイ設定
このページでは、ForePaaS Legacy PlatformのサービスであるMachine Learning Managerについて説明します。このサービスはOVHcloud Data Platformでは利用できません。現在のドキュメントを参照してください。
デプロイの設定は、パイプラインを構成するための最後のステップです。ここでは、パイプラインが生成するモデルをどのように運用的に使用するかを決定します。
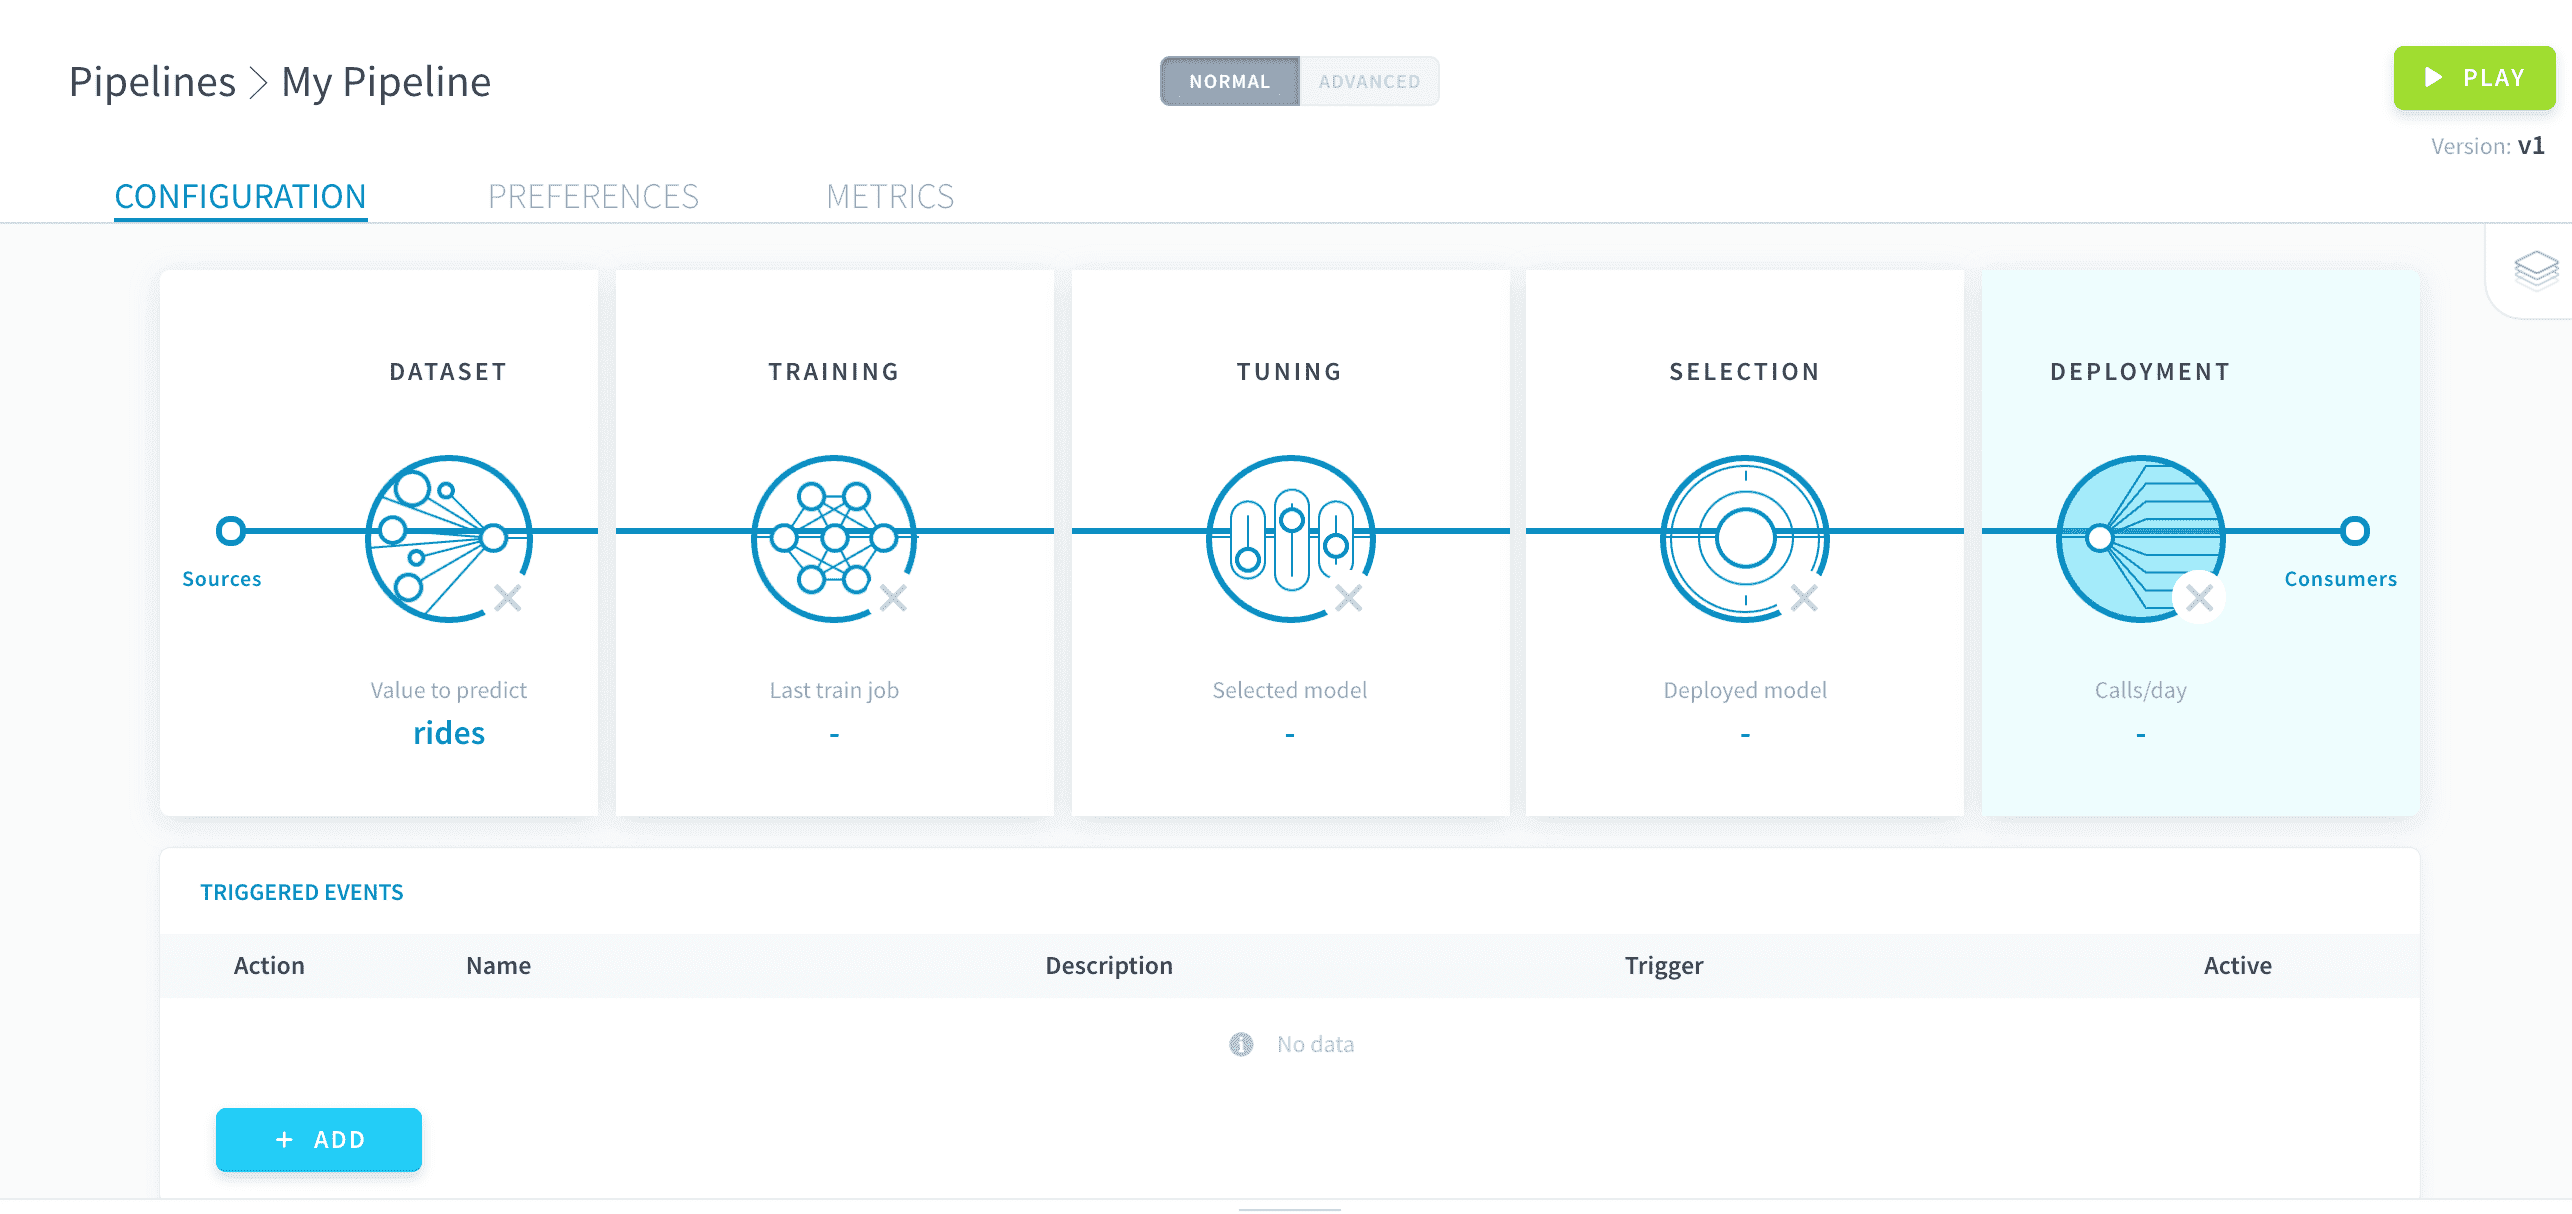
すべての設定は、コンサマーと呼ばれるものを通じて行われます。コンサマーは、パイプラインの出力に接続されるエンティティで、デプロイされたモデルにアクセスするために使用されます。その後、データを供給して予測を生成することができます。単一のパイプラインには複数のコンサマーを持つことができ、これによりデプロイされたモデルを同時に複数の方法で使用することが可能になります。
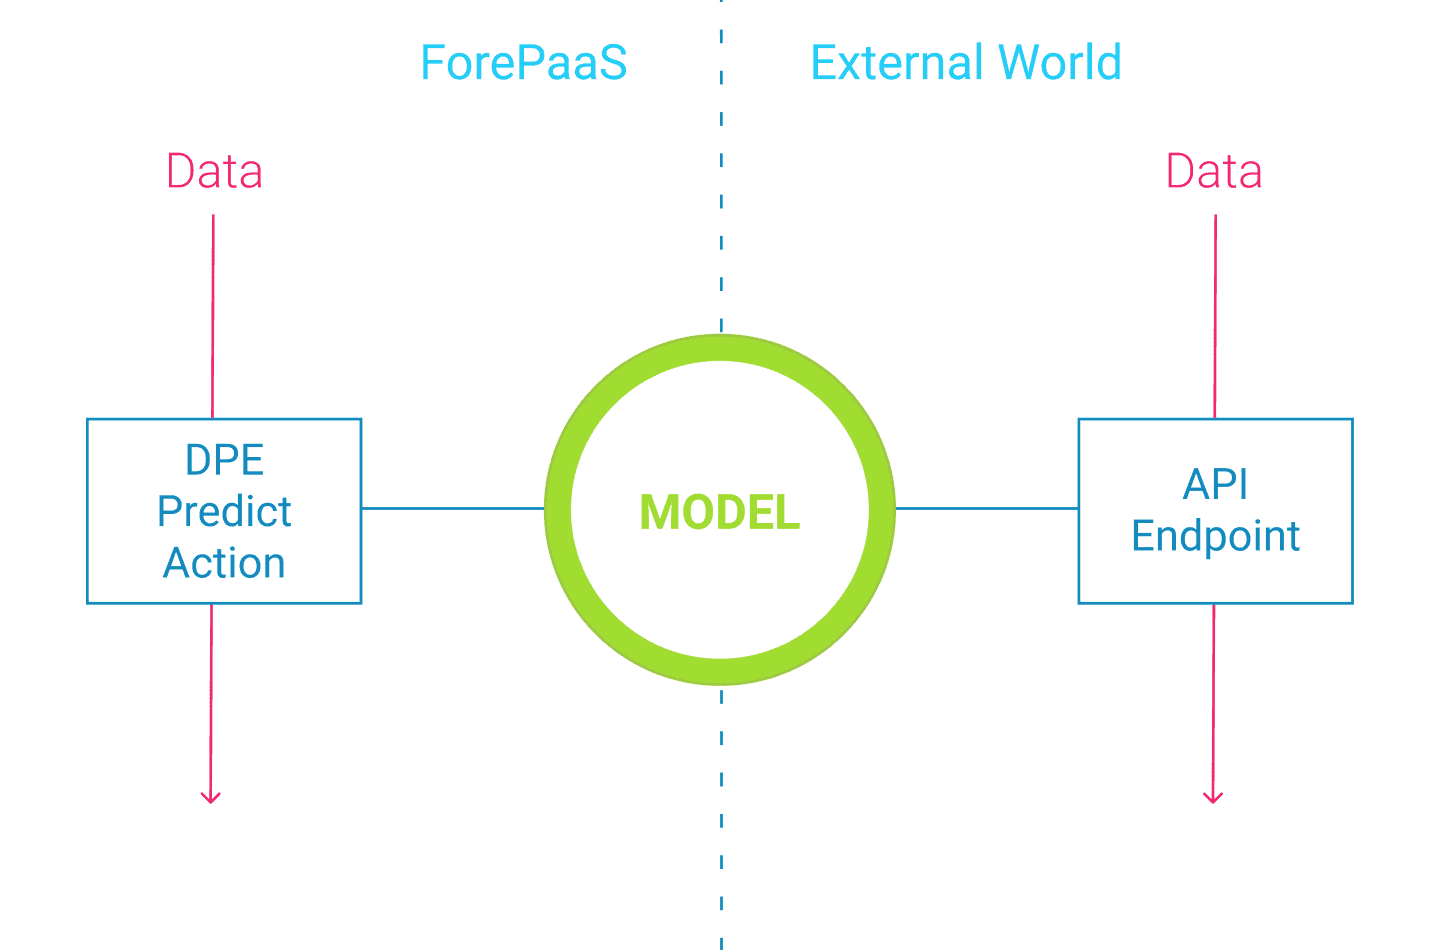
コンサマーを使用することで、デプロイされたモデルを外部および内部のプロジェクトから呼び出すことができます。
- 外部呼び出しは、プロジェクトのAPIのエンドポイントを使用し、認証が必要です。
- 内部呼び出しは、Data Processing Engine(DPE)を使用して、Data Managerにデータを読み書きします。
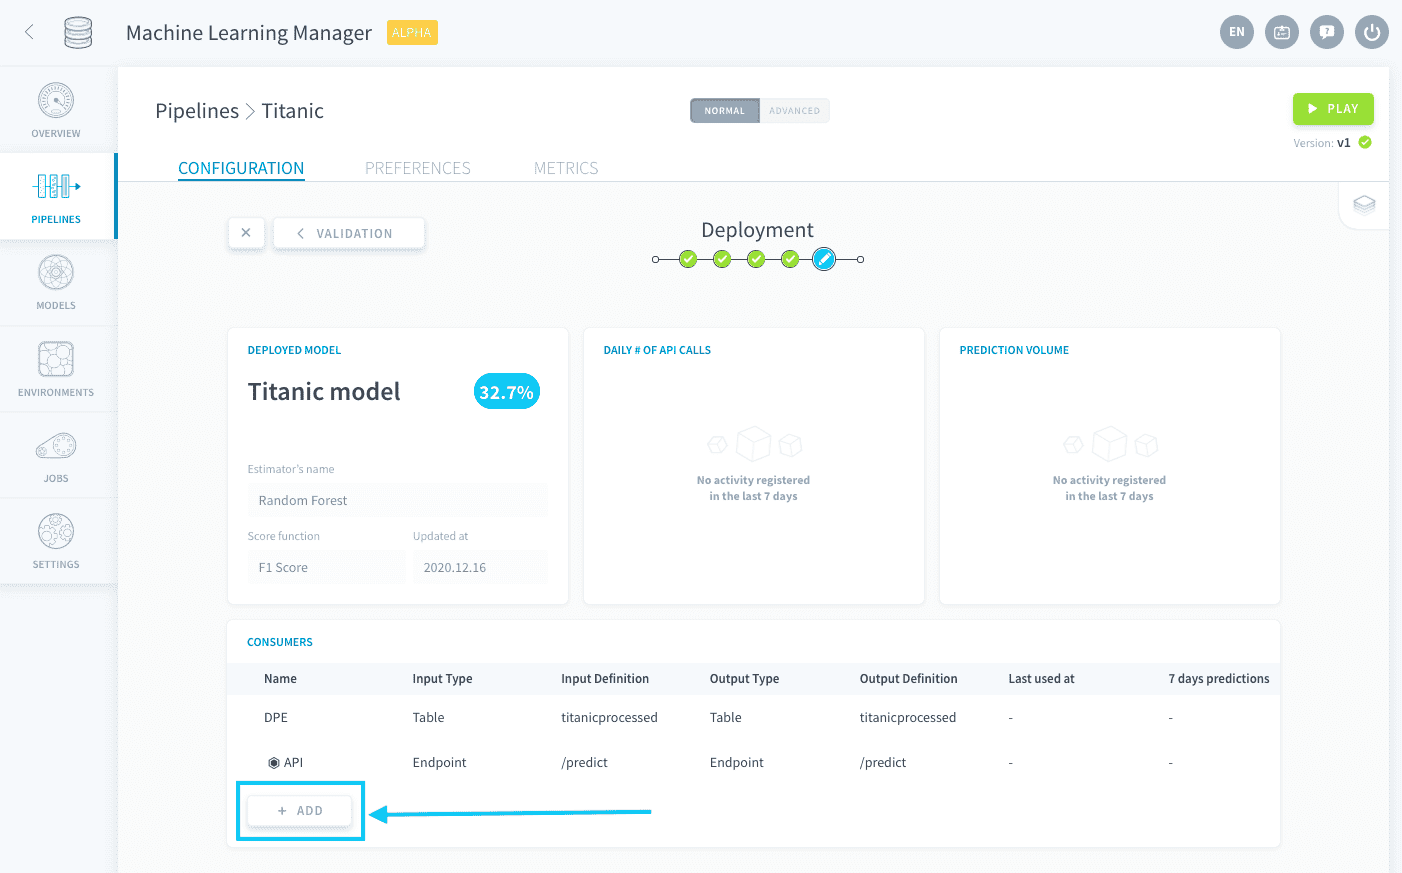
コンサマーを作成する
新しいコンサマーを作成するには、コンサマーパネルで追加をクリックします。
次に、入力と出力を選択する必要があります。入力は、コンサマーにデータを渡す方法を表し、出力は予測が返される方法を表します。
入力オプション
ForePaaSでは、コンサマーの入力として次のオプションから選択できます。
APIエンドポイント入力
予測エンドポイントを作成するには、デプロイされたProject APIが必要です。コンサマーを作成する際に、使用するProject APIを指定します。
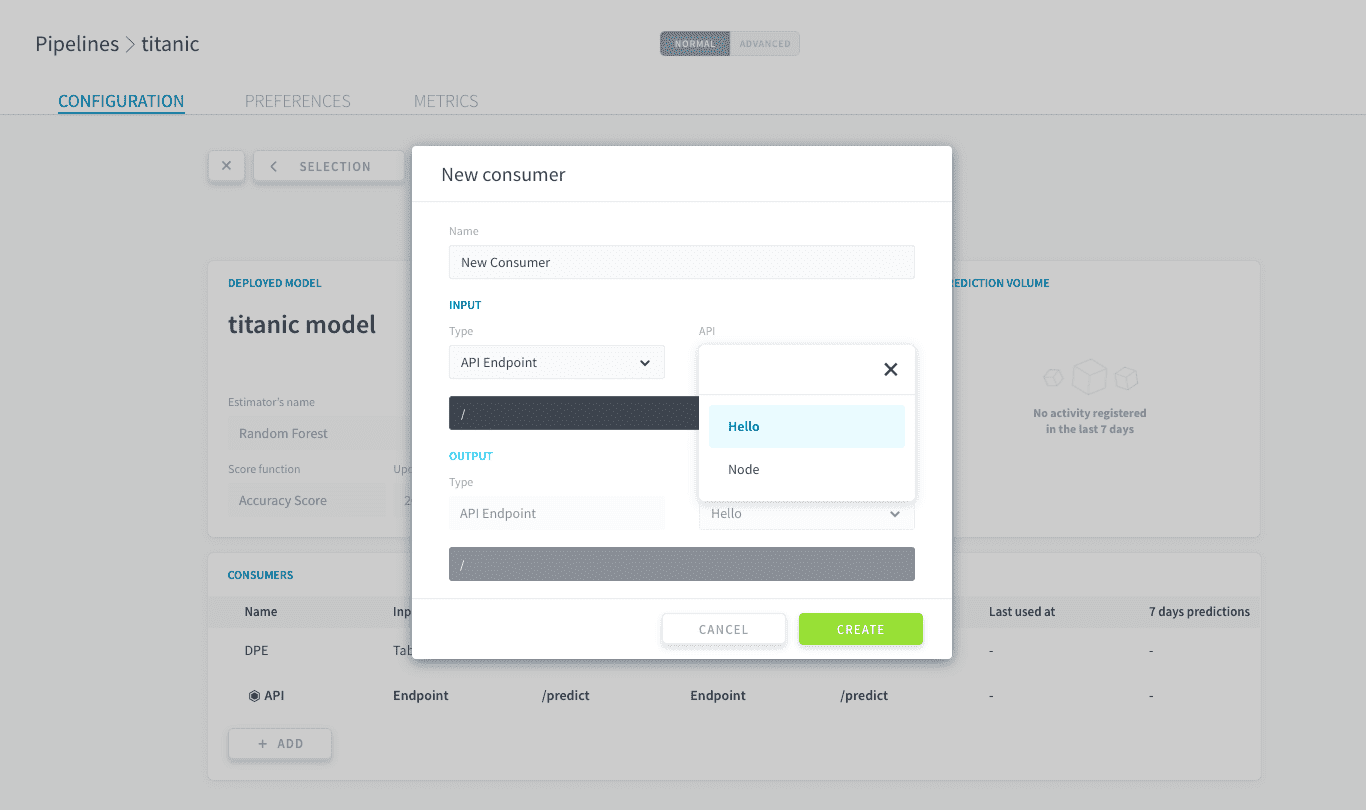
次に、作成するエンドポイントの名前を指定します。
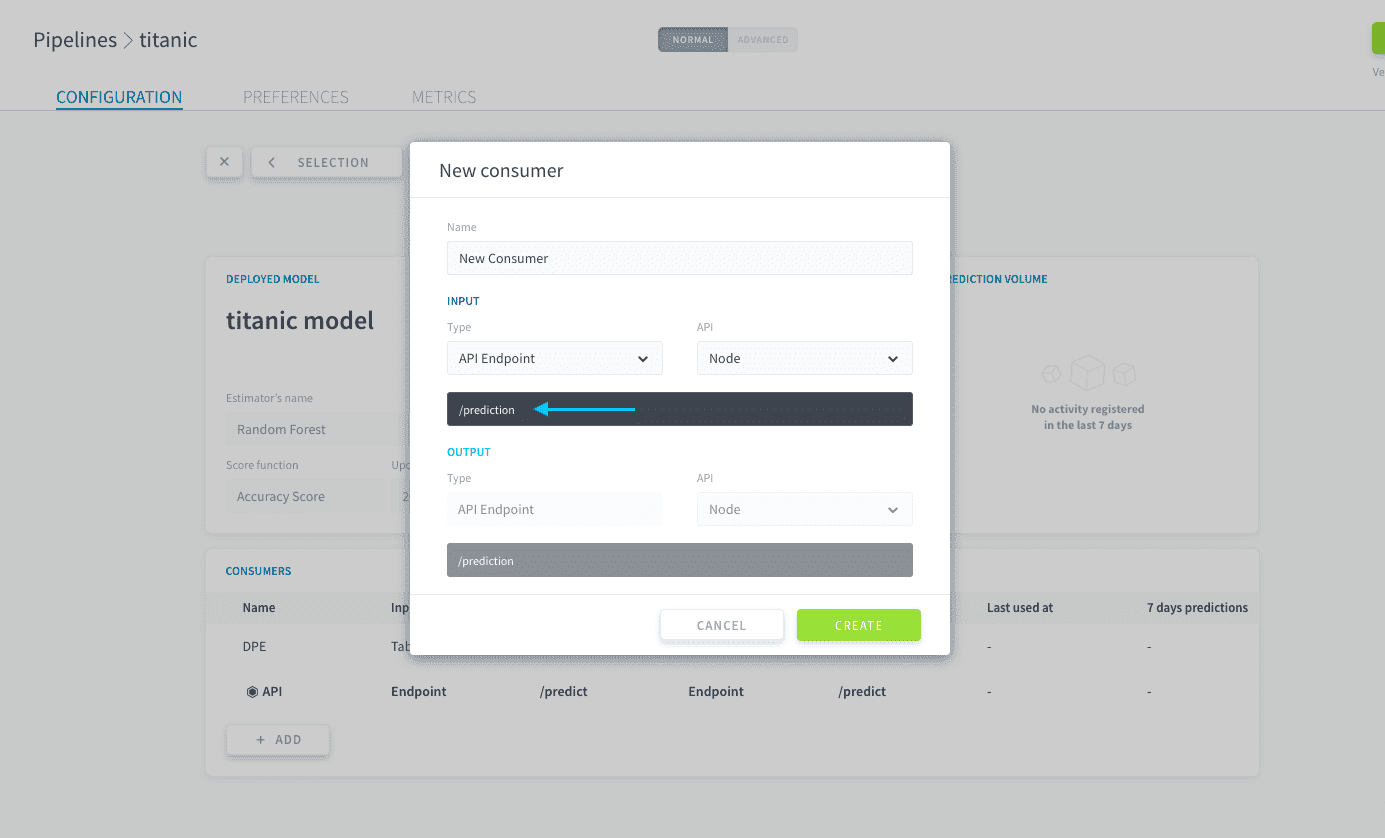
既存のエンドポイントを使用することはできません。他のパイプラインであっても同様です。
テーブル入力
コンサマーを作成する際に、Data Managerテーブルのいずれかを指定します。
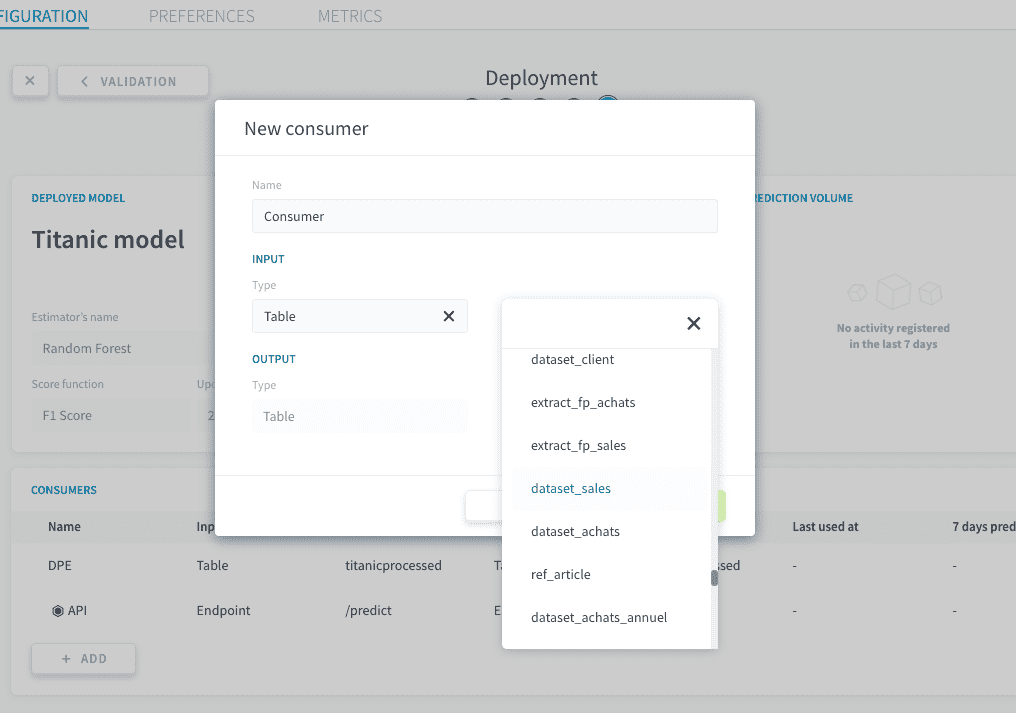
Data Managerテーブルの属性は、モデルの特徴と同じ名前である必要はありません。マッピングは、生成されたPredict Actionでカスタマイズできます。ただし、モデルのすべての特徴は、入力テーブルに何らかの形で存在する必要があります。
バケット入力
コンサマーを作成する際に、Data Storeバケットのいずれかを指定します。その結果として生成されたPredict Actionは、バケットに保存されているすべてのファイルについて予測を試みます。ただし、モデルが非構造化データで学習されている必要があります。
出力オプション
ForePaaSでは、コンサマーの出力として次のオプションから選択できます。
APIエンドポイント出力
APIエンドポイントを入力として選択すると、このオプションが自動的に選択されます。エンドポイントは入力と同じです。
テーブル出力
バケットまたはテーブルを入力として選択すると、このオプションが自動的に選択されます。入力と同じテーブルまたは別のテーブルを選択できます。
Data Managerテーブルの属性は、モデルの予測値と同じ名前である必要はありません。マッピングは、生成されたPredict Actionでカスタマイズできます。
コンサマーを使用して予測を実行する
コンサマーが作成されると、予測を実行するために使用できます。
- コンサマーの入力または出力としてAPIエンドポイントを使用すると、呼び出し可能なAPIエンドポイントが作成されます。
- コンサマーの入力または出力としてテーブルを使用すると、自動的にData Processing EngineのPredict Actionが生成され、実行できます。
- コンサマーの入力としてバケットを使用すると、自動的にDPE Predict Actionが生成され、実行できます。
APIエンドポイントを使用する
構造化データの場合
目 👁️ アイコンをクリックしてAPIコントロールパネルを開きます。
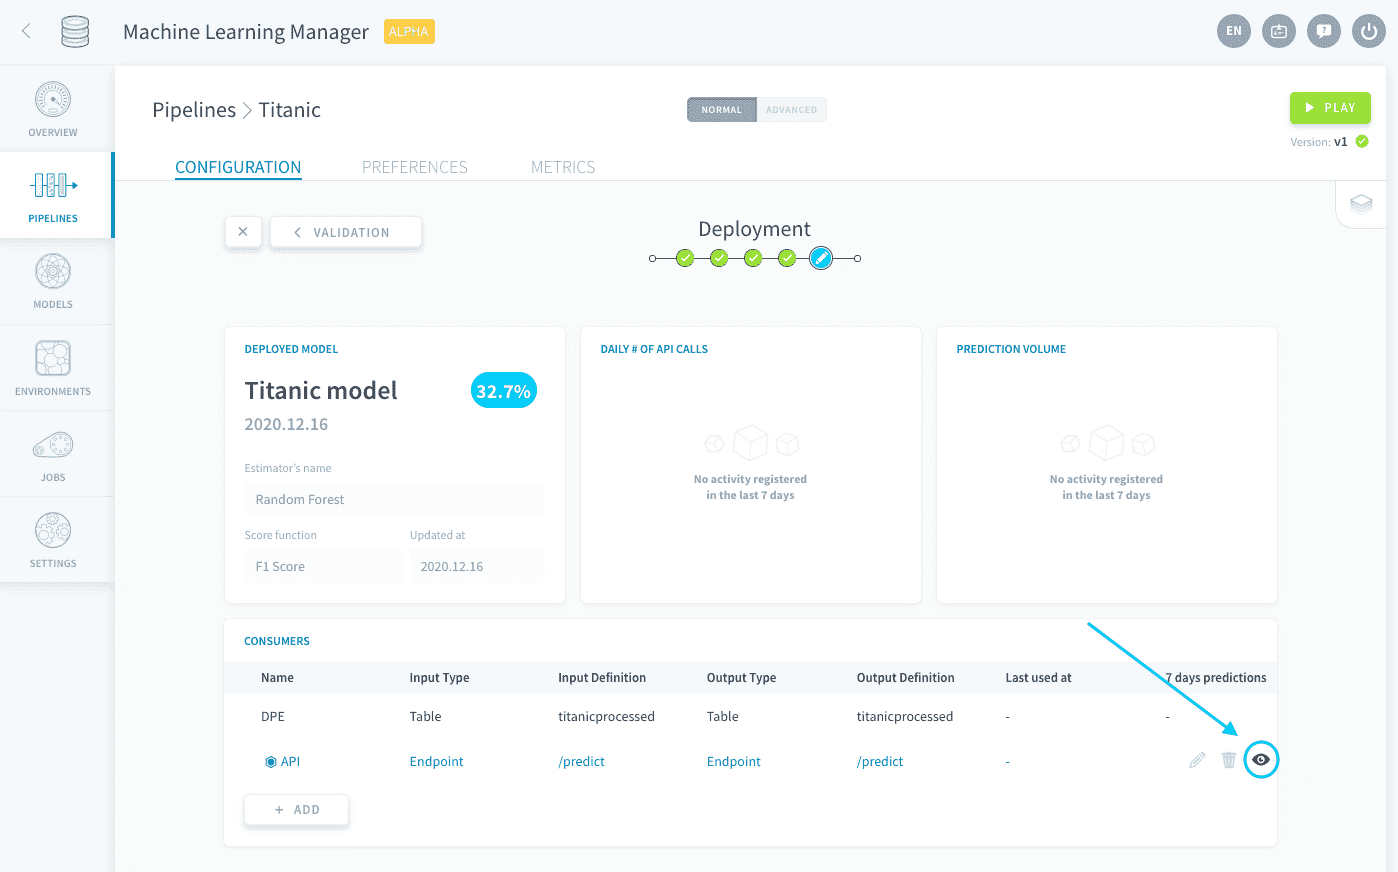
APIエンドポイントから予測を実行するには、まず認証トークンを生成する必要があります。API & secret keysを入力し、APIコントロールパネルに指定されたコマンドを実行することで、簡単にこのトークンを生成できます。
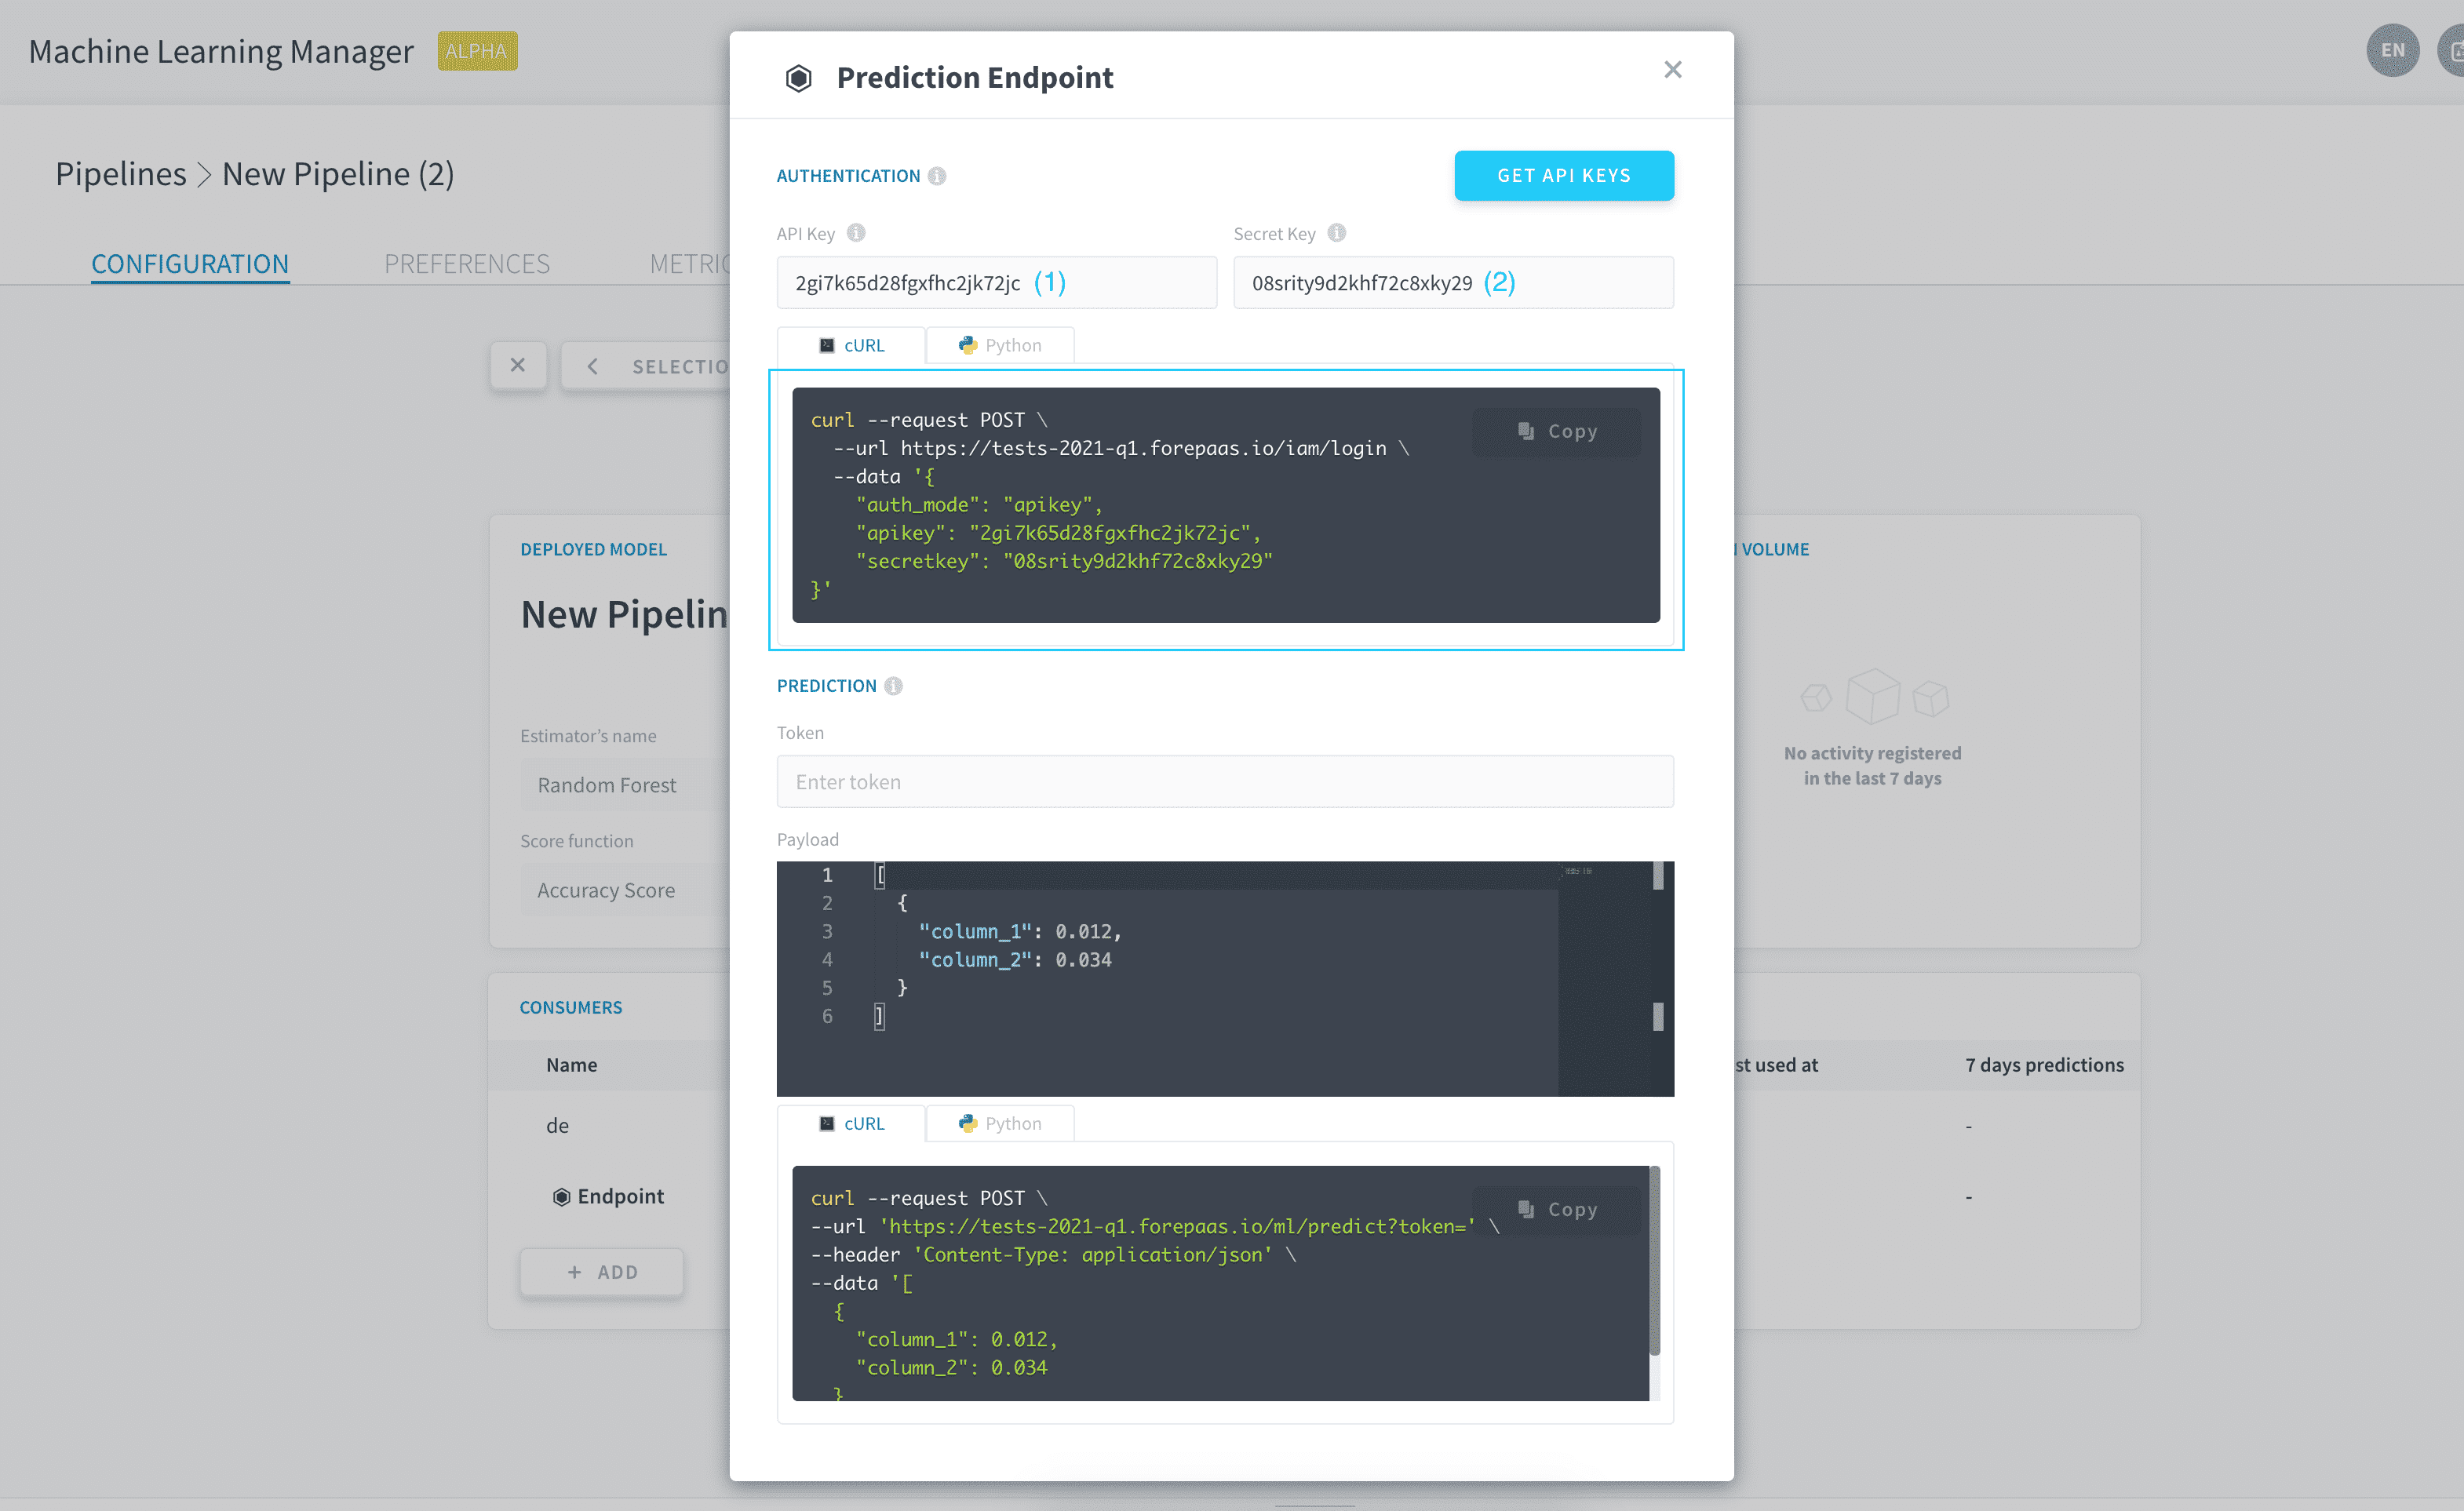
予測ジョブを実行するには、APIコントロールパネルで提供されるサンプルコマンドを実行できます。リクエストには2つのパラメータを入力する必要があります。認証トークンと予測を実行するデータです。各データポイントは、モデルの特徴とその値を含む辞書で表されます。複数のデータポイントを一度に予測するには、配列に複数の辞書を含めます。
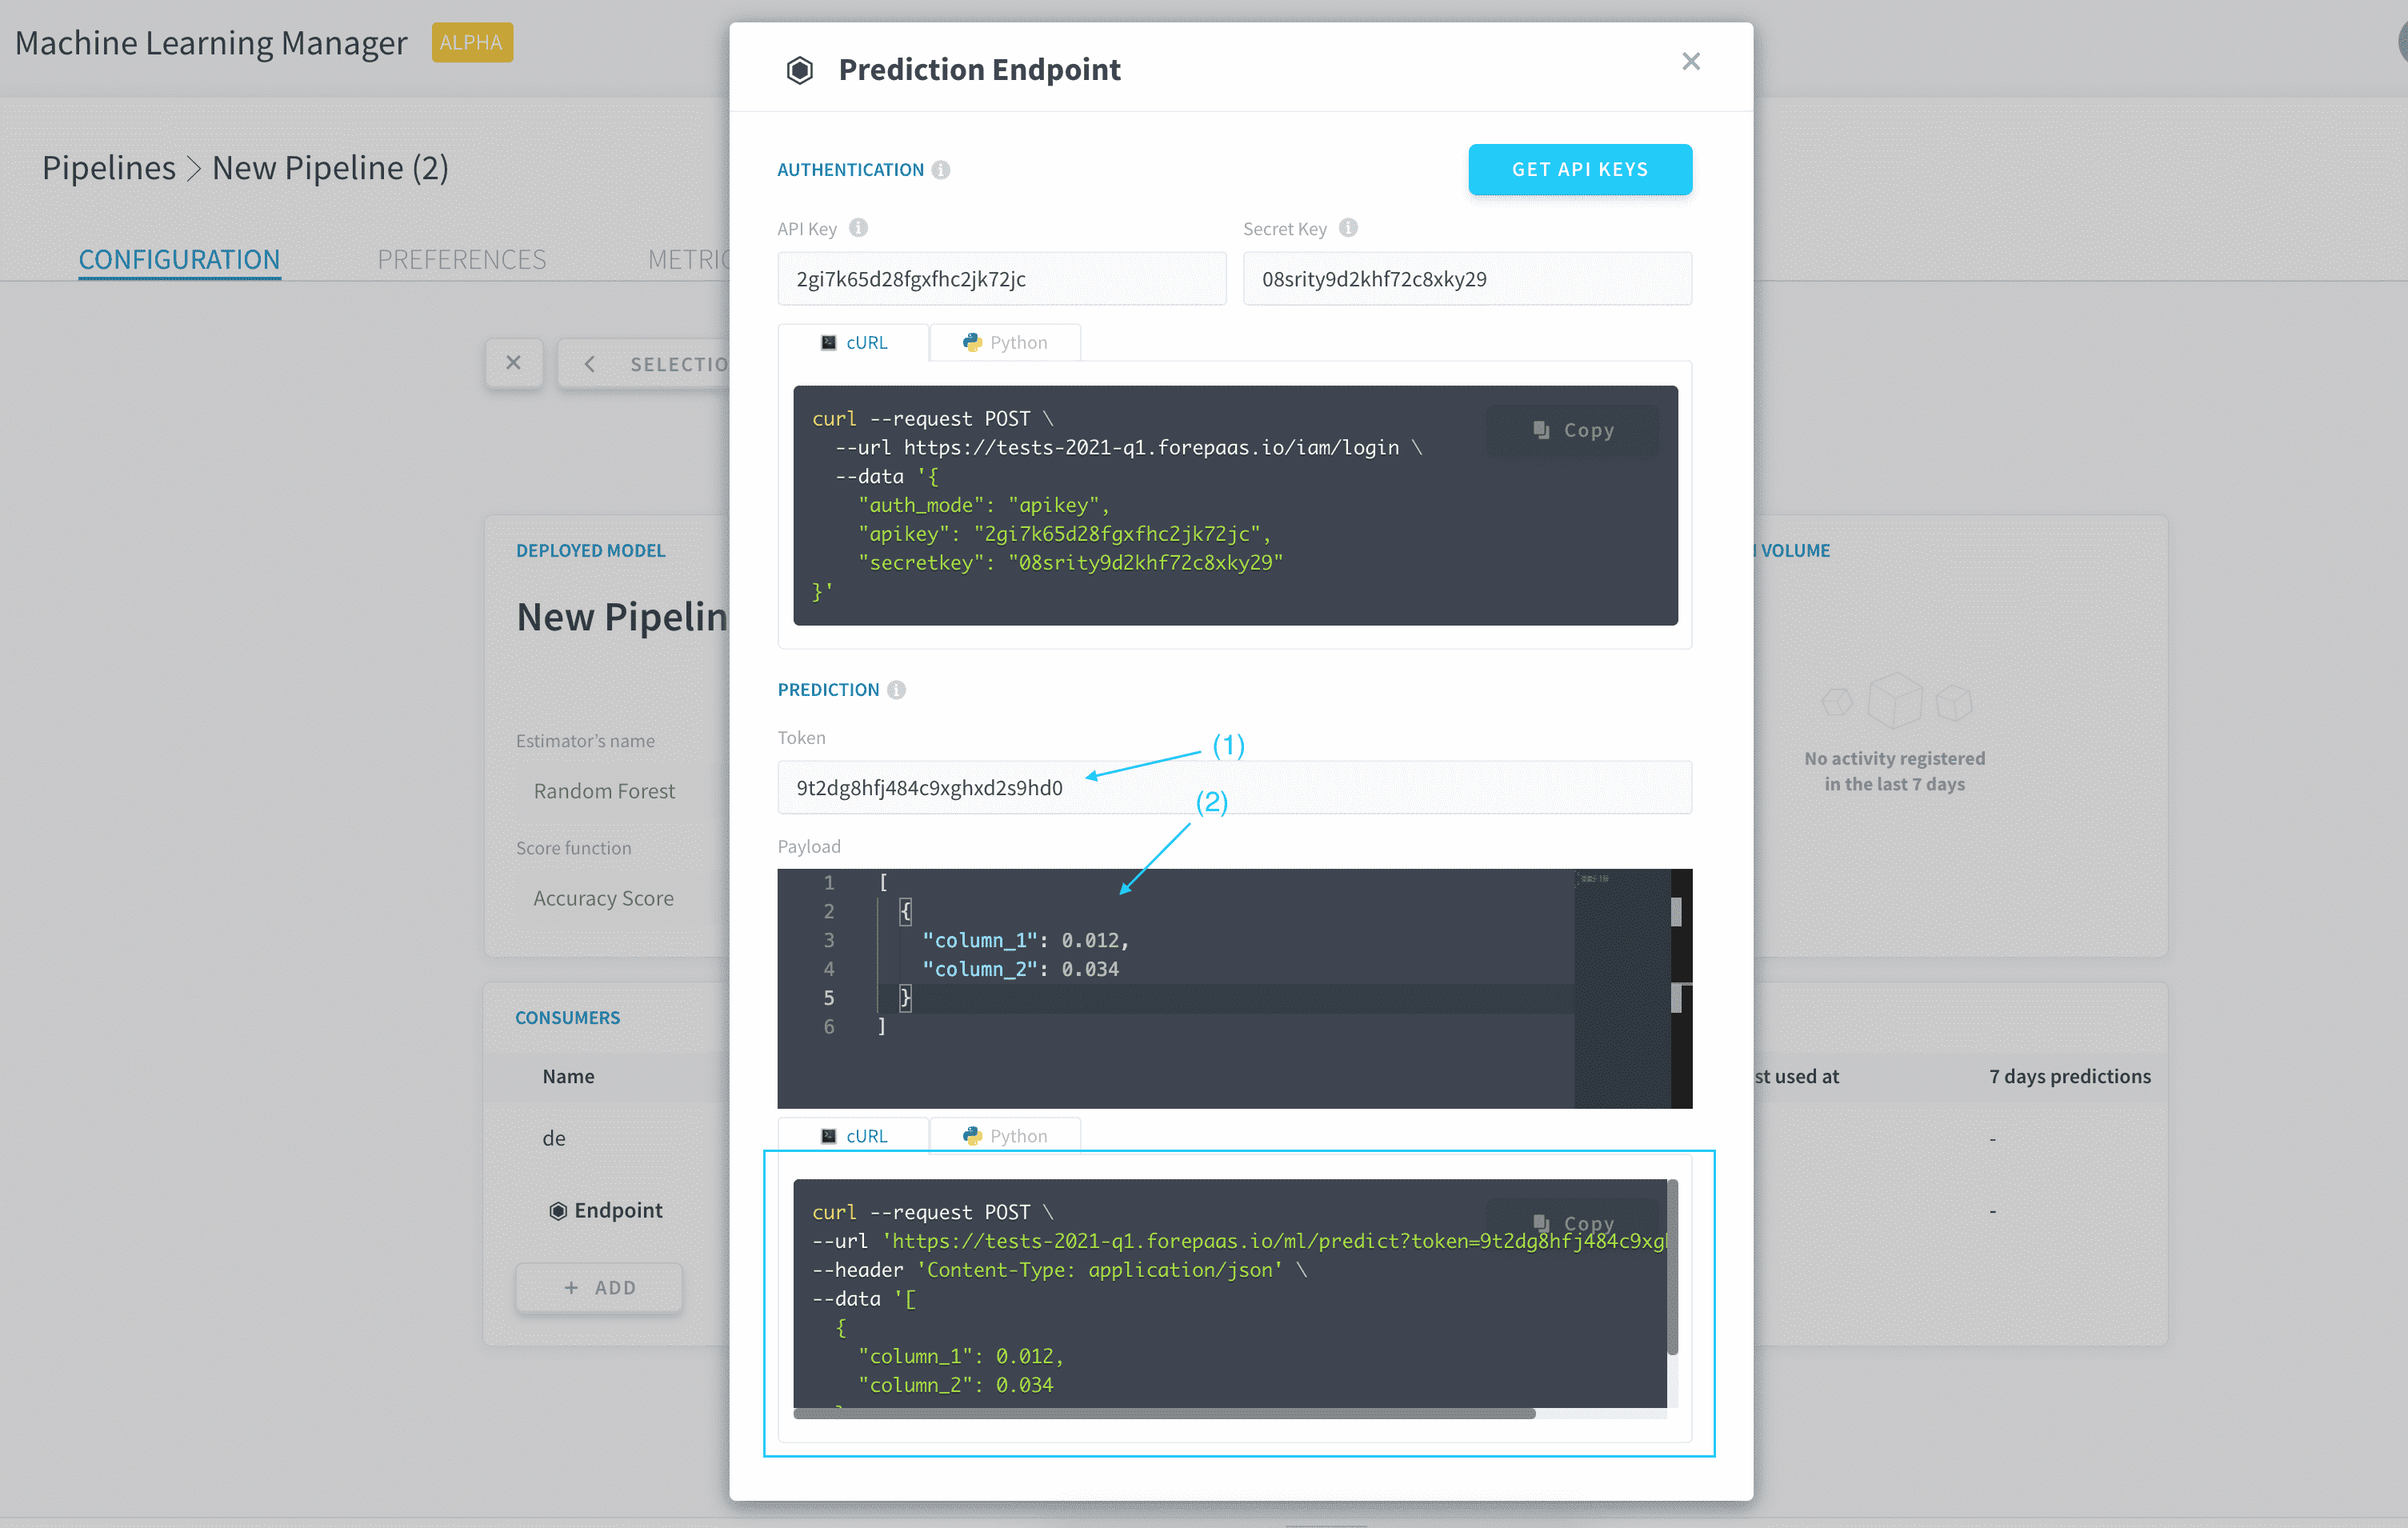
コントロールパネルには、変数名と値の入力方法を示すためのテンプレートデータペイロードが事前に入力されています。
非構造化データの場合
非構造化データモデルを予測に使用する場合、実際の非構造化オブジェクト(画像など)を供給する必要があります。プラットフォームは自動的にそれらを「numpy化」、標準化、正規化します。
非構造化データモデルの予測を取得するには、content-typeをmultipart/form-dataに設定したファイルを含むエンドポイントにPOSTリクエストを送信します。
DPE Predict Actionを使用する
コンサマーに関連付けられたPredict Actionは、デフォルトでData Processing EngineのMachine LearningリポジトリのActionsメニューに生成されます。
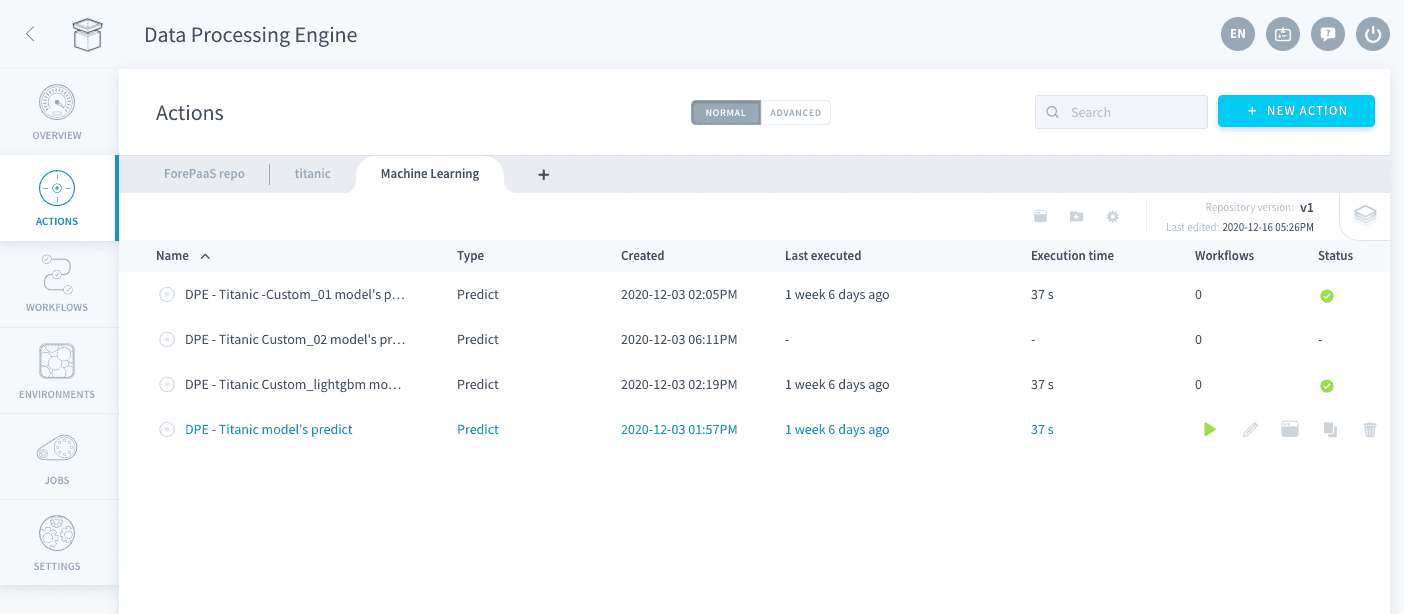
Predict Actionの設定と実行方法を学びます。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして、プロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼し、見積もりを取得してください。
Data Platformを構築するチームと直接やり取りし、質問をする、フィードバックを提供する、専用Discordチャネルで参加してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。