

スコアリングと検証
このページでは、Machine Learning Managerについて説明します。これは、ForePaaS Legacy Platformのサービスで、OVHcloud Data Platformでは利用できません。現在のドキュメントを参照してください。
パイプラインで学習させたモデルの性能を評価するには、バイアスのない方法でスコアリングすることをおすすめします。スコアリング結果は、常にモデルがスコアリングされるデータセットに依存します。
特定のデータセットでモデルをスコアリングするには、そのセット内の各データポイントについてモデルを使用して予測を行い、予測値と真の値との差異を基本的なスコアリング関数を使用して定量化します。
任意のデータセットでモデルをスコアリングできます。ただし、通常はモデルの学習に使用されたデータでスコアリングを行うことはおすすめしません。これは、モデルが新しいデータに一般化する能力を評価したいからです。ForePaaSパイプラインでは、モデルを2つの異なるデータセットでスコアリングできます: テストデータセットと検証データセットです。
検証
検証は、機械学習における方法で、初期の学習セットからサブセットを抽出し、それを使用してすべての学習済みモデルをスコアリングし、最適なモデルを選択するためのものです。抽出されたサブセットを検証セットと呼びます。このセットは、初期の学習セットの残りの部分で学習されたモデルの公平な評価を提供します。また、最終的なモデルの評価、すなわち一般化エラーの定量化を行うために、テストデータセットが隔離されたままであることを確保します。 検証についてさらに学ぶ。
パイプラインでは、以下のいずれかを実行できます:
シンプルな検証
シンプルな検証では、初期の学習セットからサブセットを抽出し、それを検証セットとして使用します。これを使用するには、検証タイプとしてシンプルな検証を選択します:
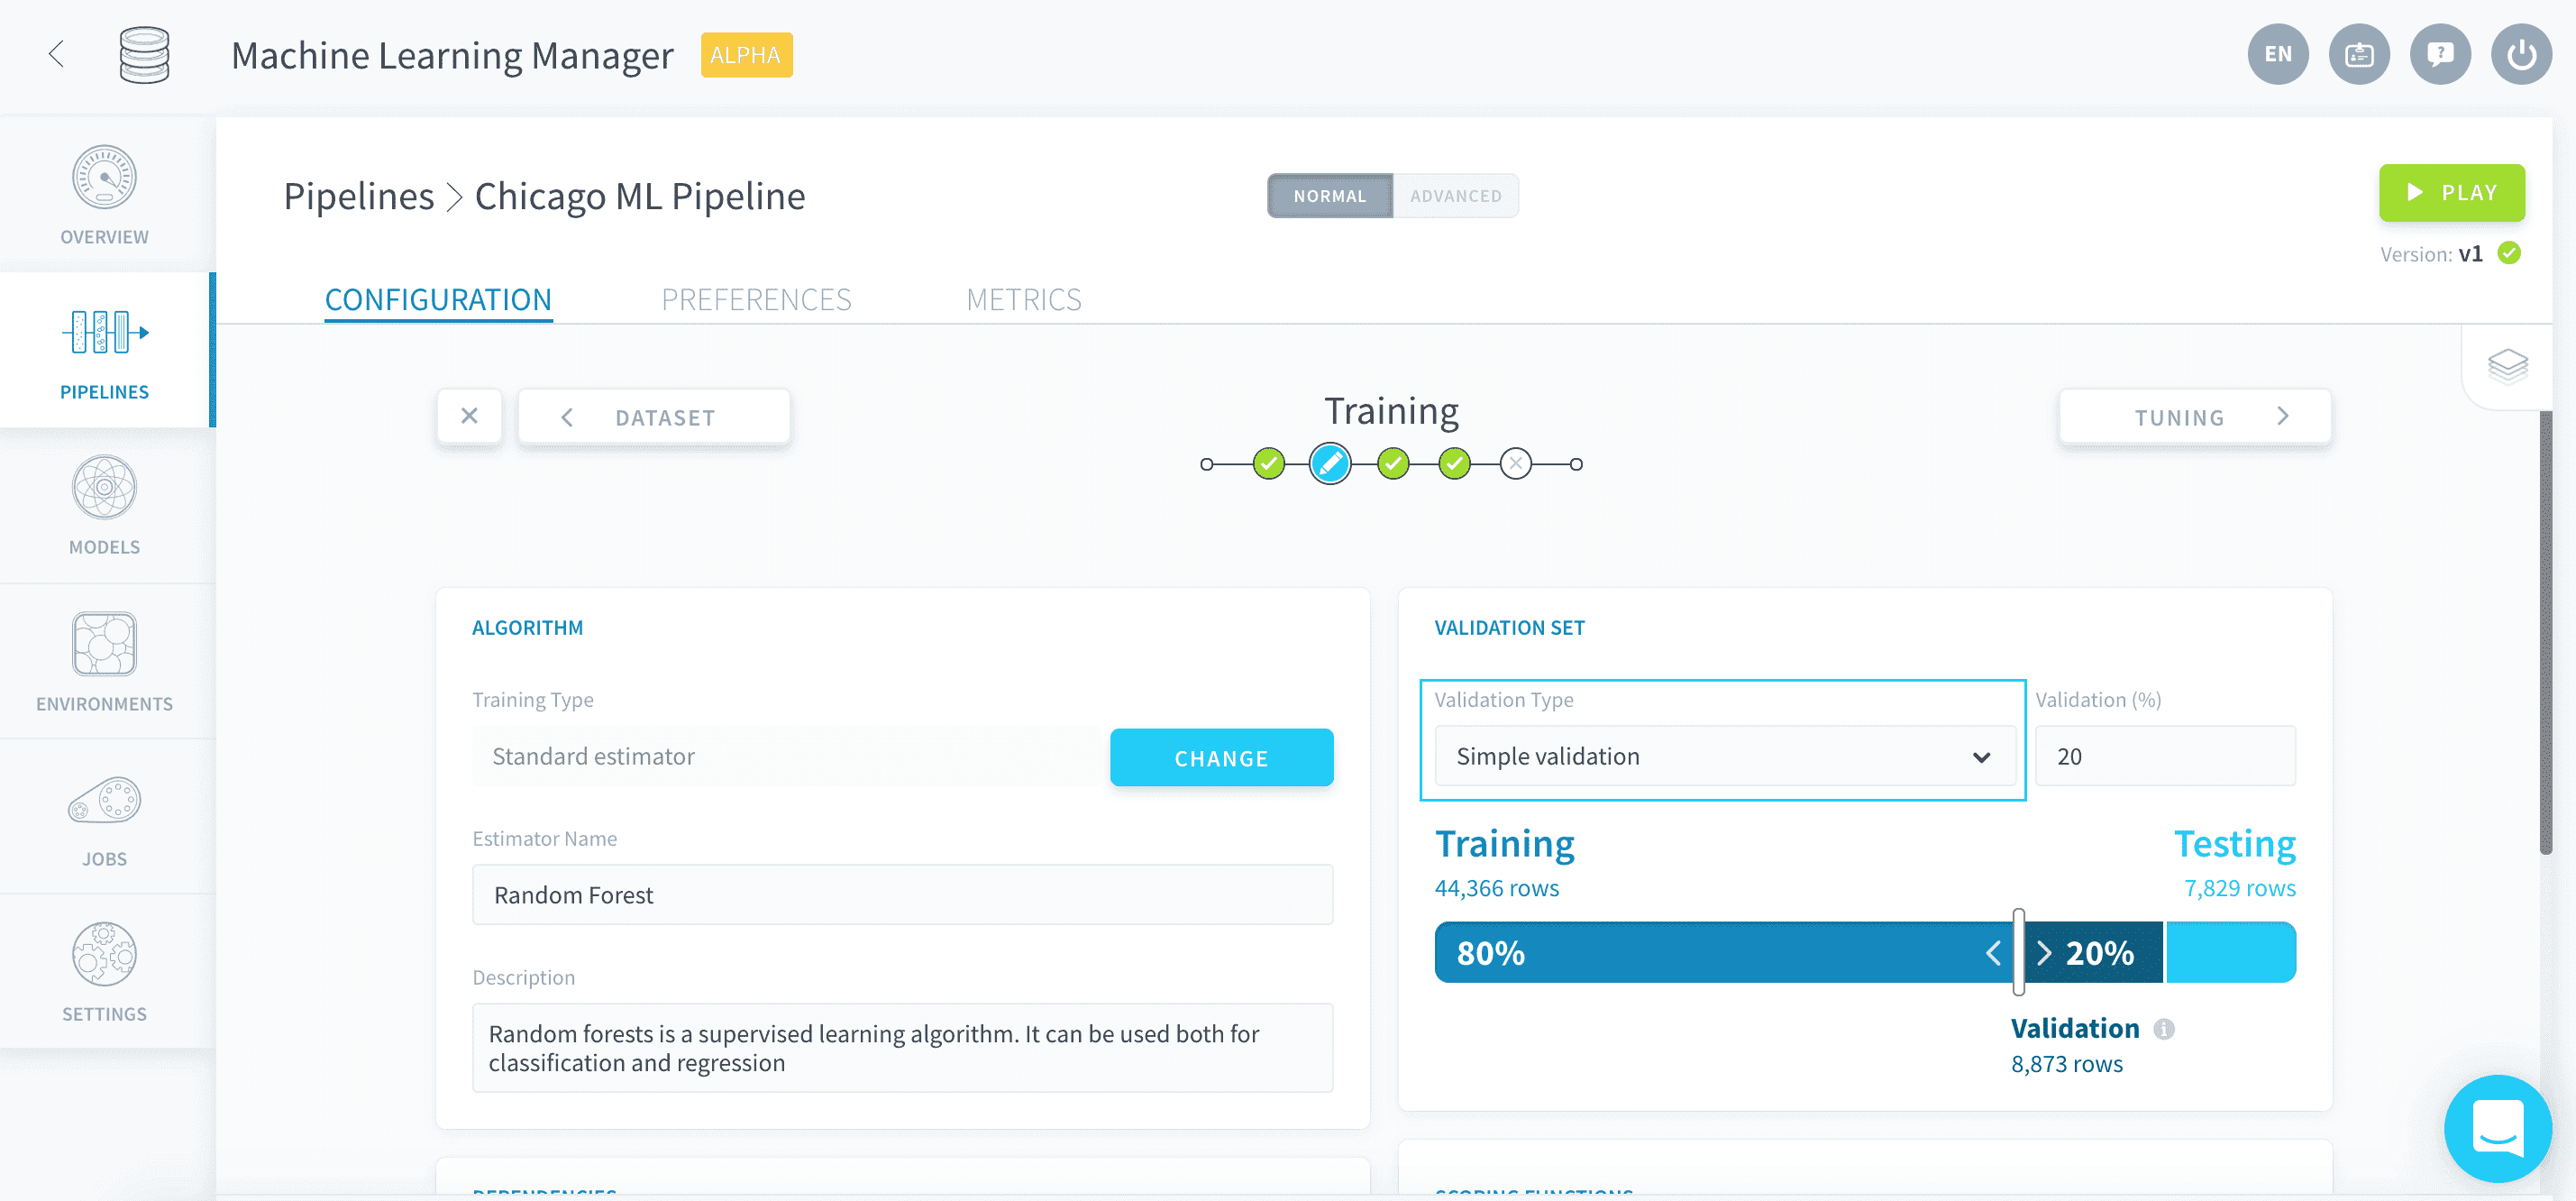
検証セットのサイズを初期学習セットの割合として選択します。スライダーを動かすか、検証フィールドに希望するパーセンテージを入力します:
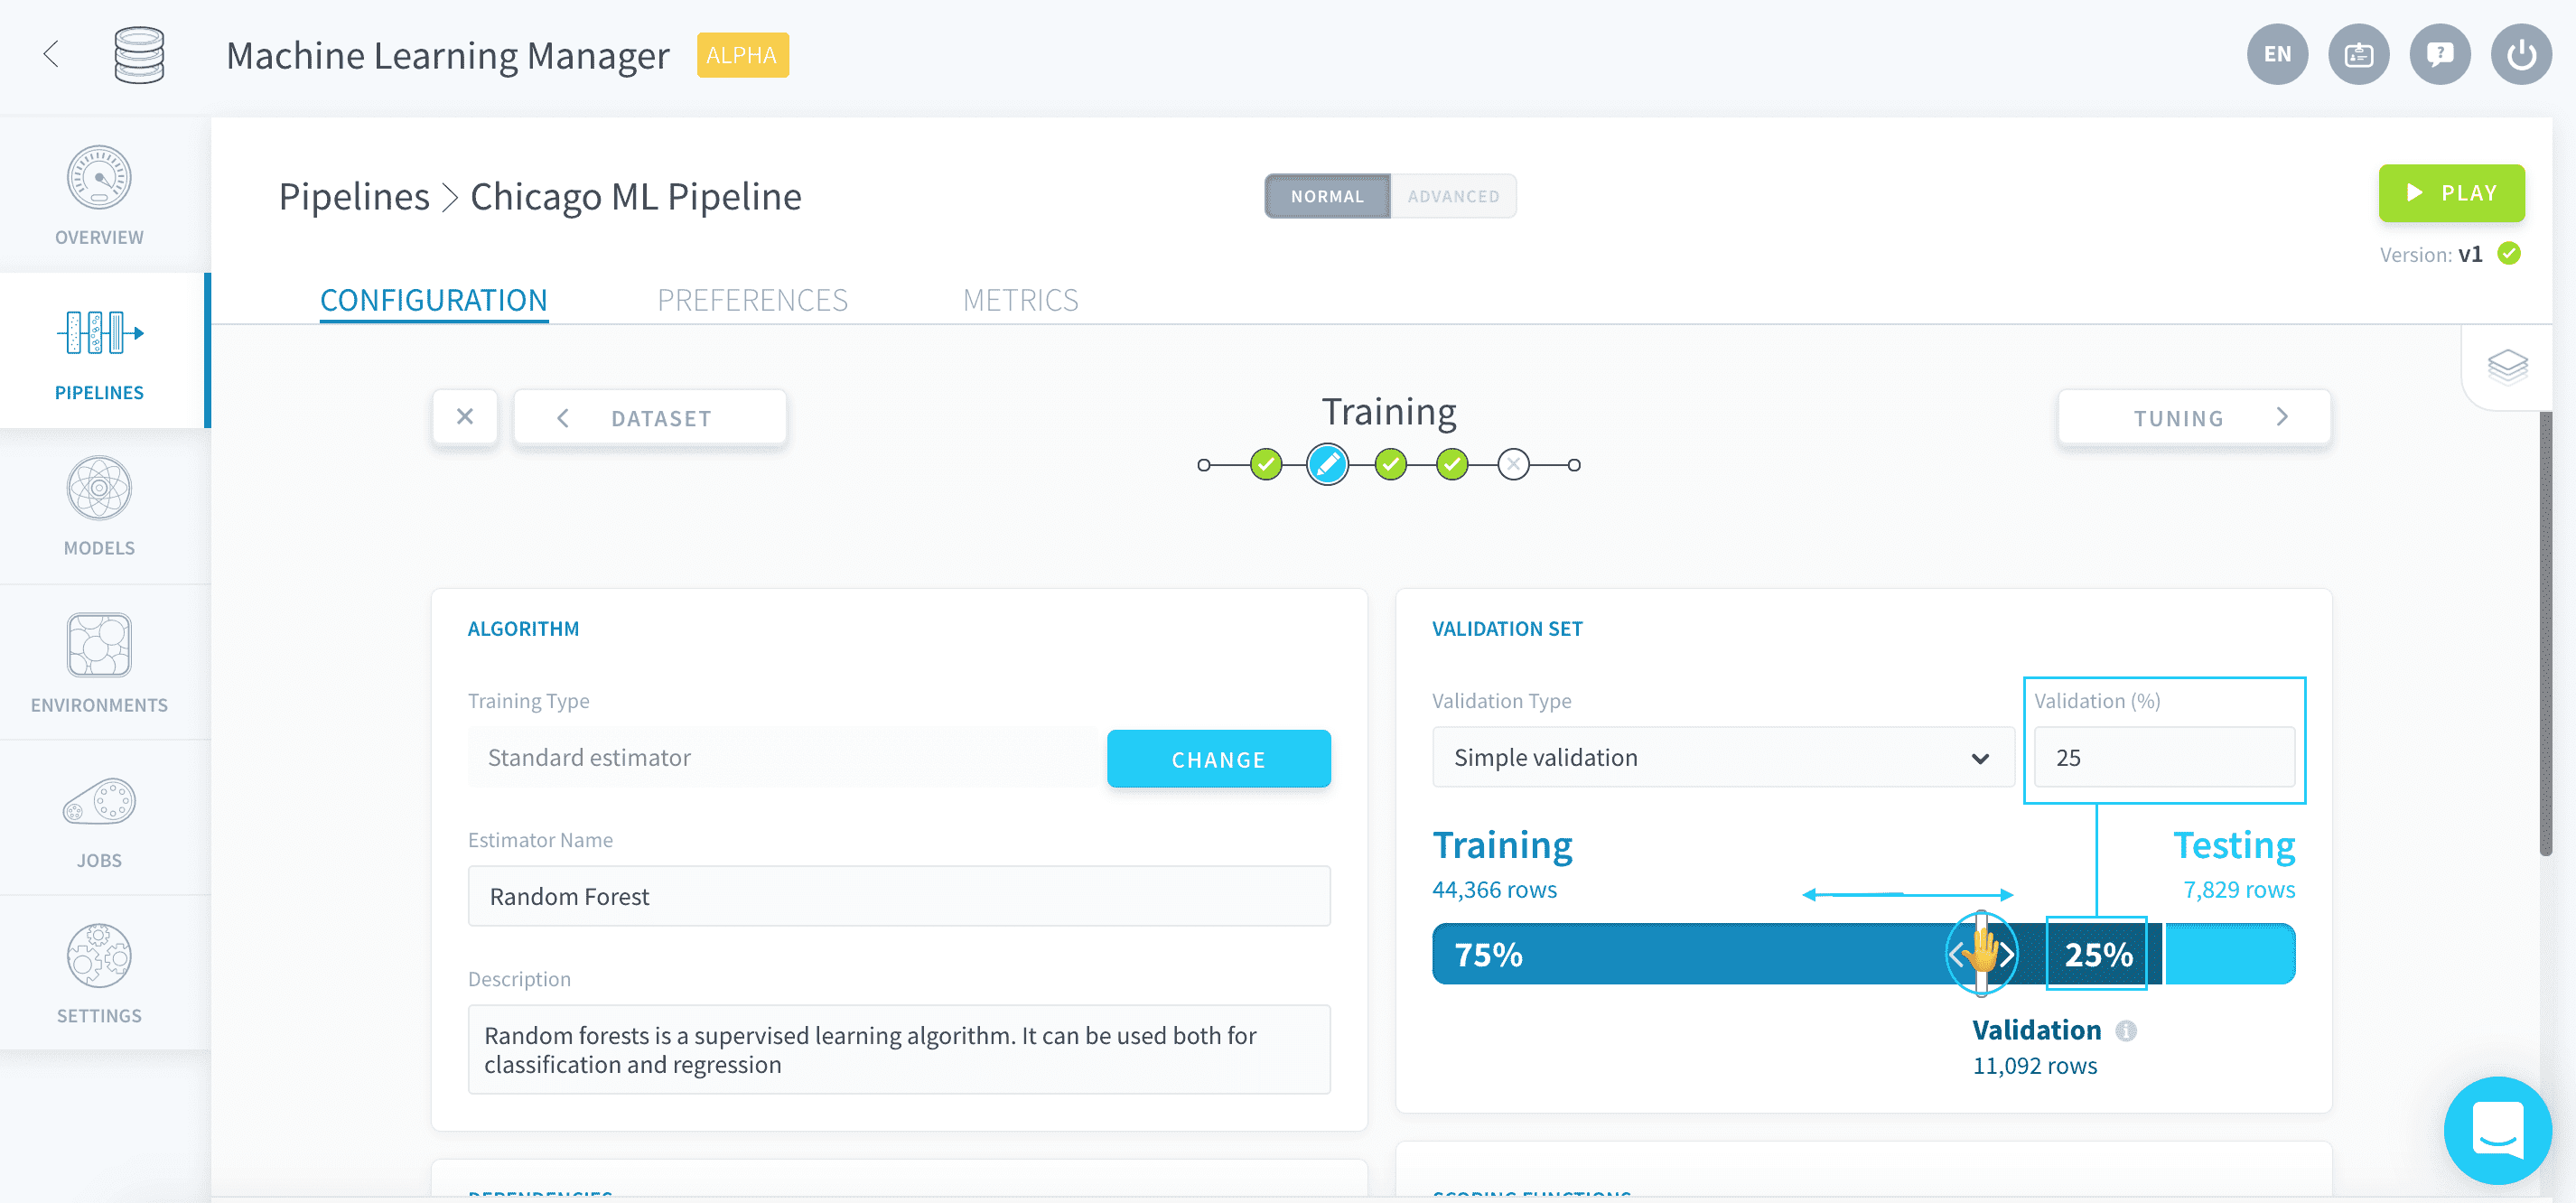
検証サイズとして0を選択すると、パイプラインの検証が無効になります。
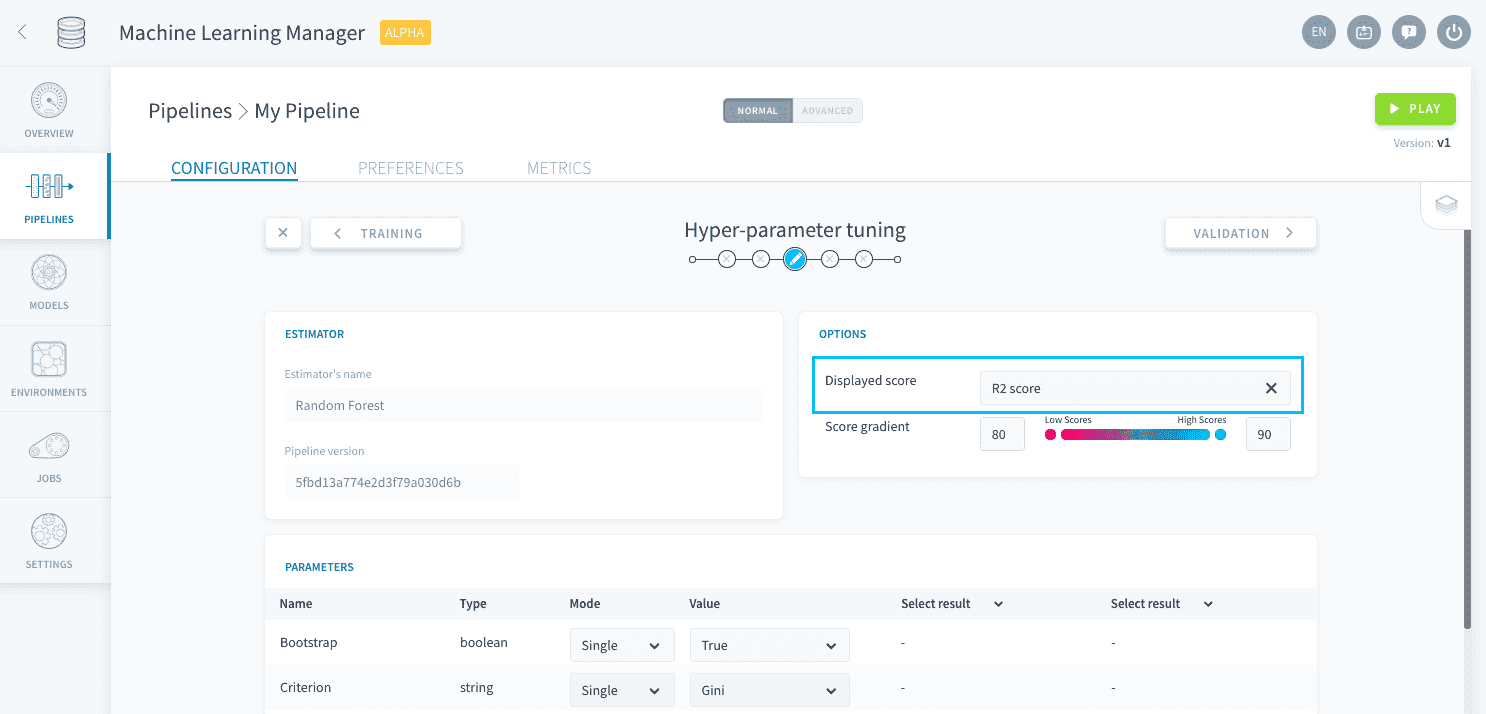
学習ジョブが実行されると、パイプラインは自動的に生成されたモデルを検証セットでスコアリングします。その結果として得られるスコアを、パイプラインの残りの部分では検証スコアと呼びます。1つの学習ジョブあたりに使用されるスコアリング関数は1つだけです。それは、チューニングステップのビジュアルオプションパネルに入力されたスコアリング関数です。
クロス検証
[クロス検証](https://en.wikipedia.org/wiki/Cross-validation_(statistics)は、初期の学習セットを特定の数のサブセットに分割することです。この数を*フォールド数*と呼びます。その後、[シンプルな検証](/ja/legacy/ml-pipelines-configure-training-validation#simple-validation)がその回数だけ実行され、各サブセットが順番にシンプルな検証セットとして使用されます。この方法により、初期の学習セット内のデータポイントが1つも未使用のままになることはありません。
選択したフォールド数だけモデルを学習させる必要があるため、クロス検証を使用すると非常にリソースを消費することがあります。
これを使用するには、検証タイプとしてk-foldクロス検証を選択します:
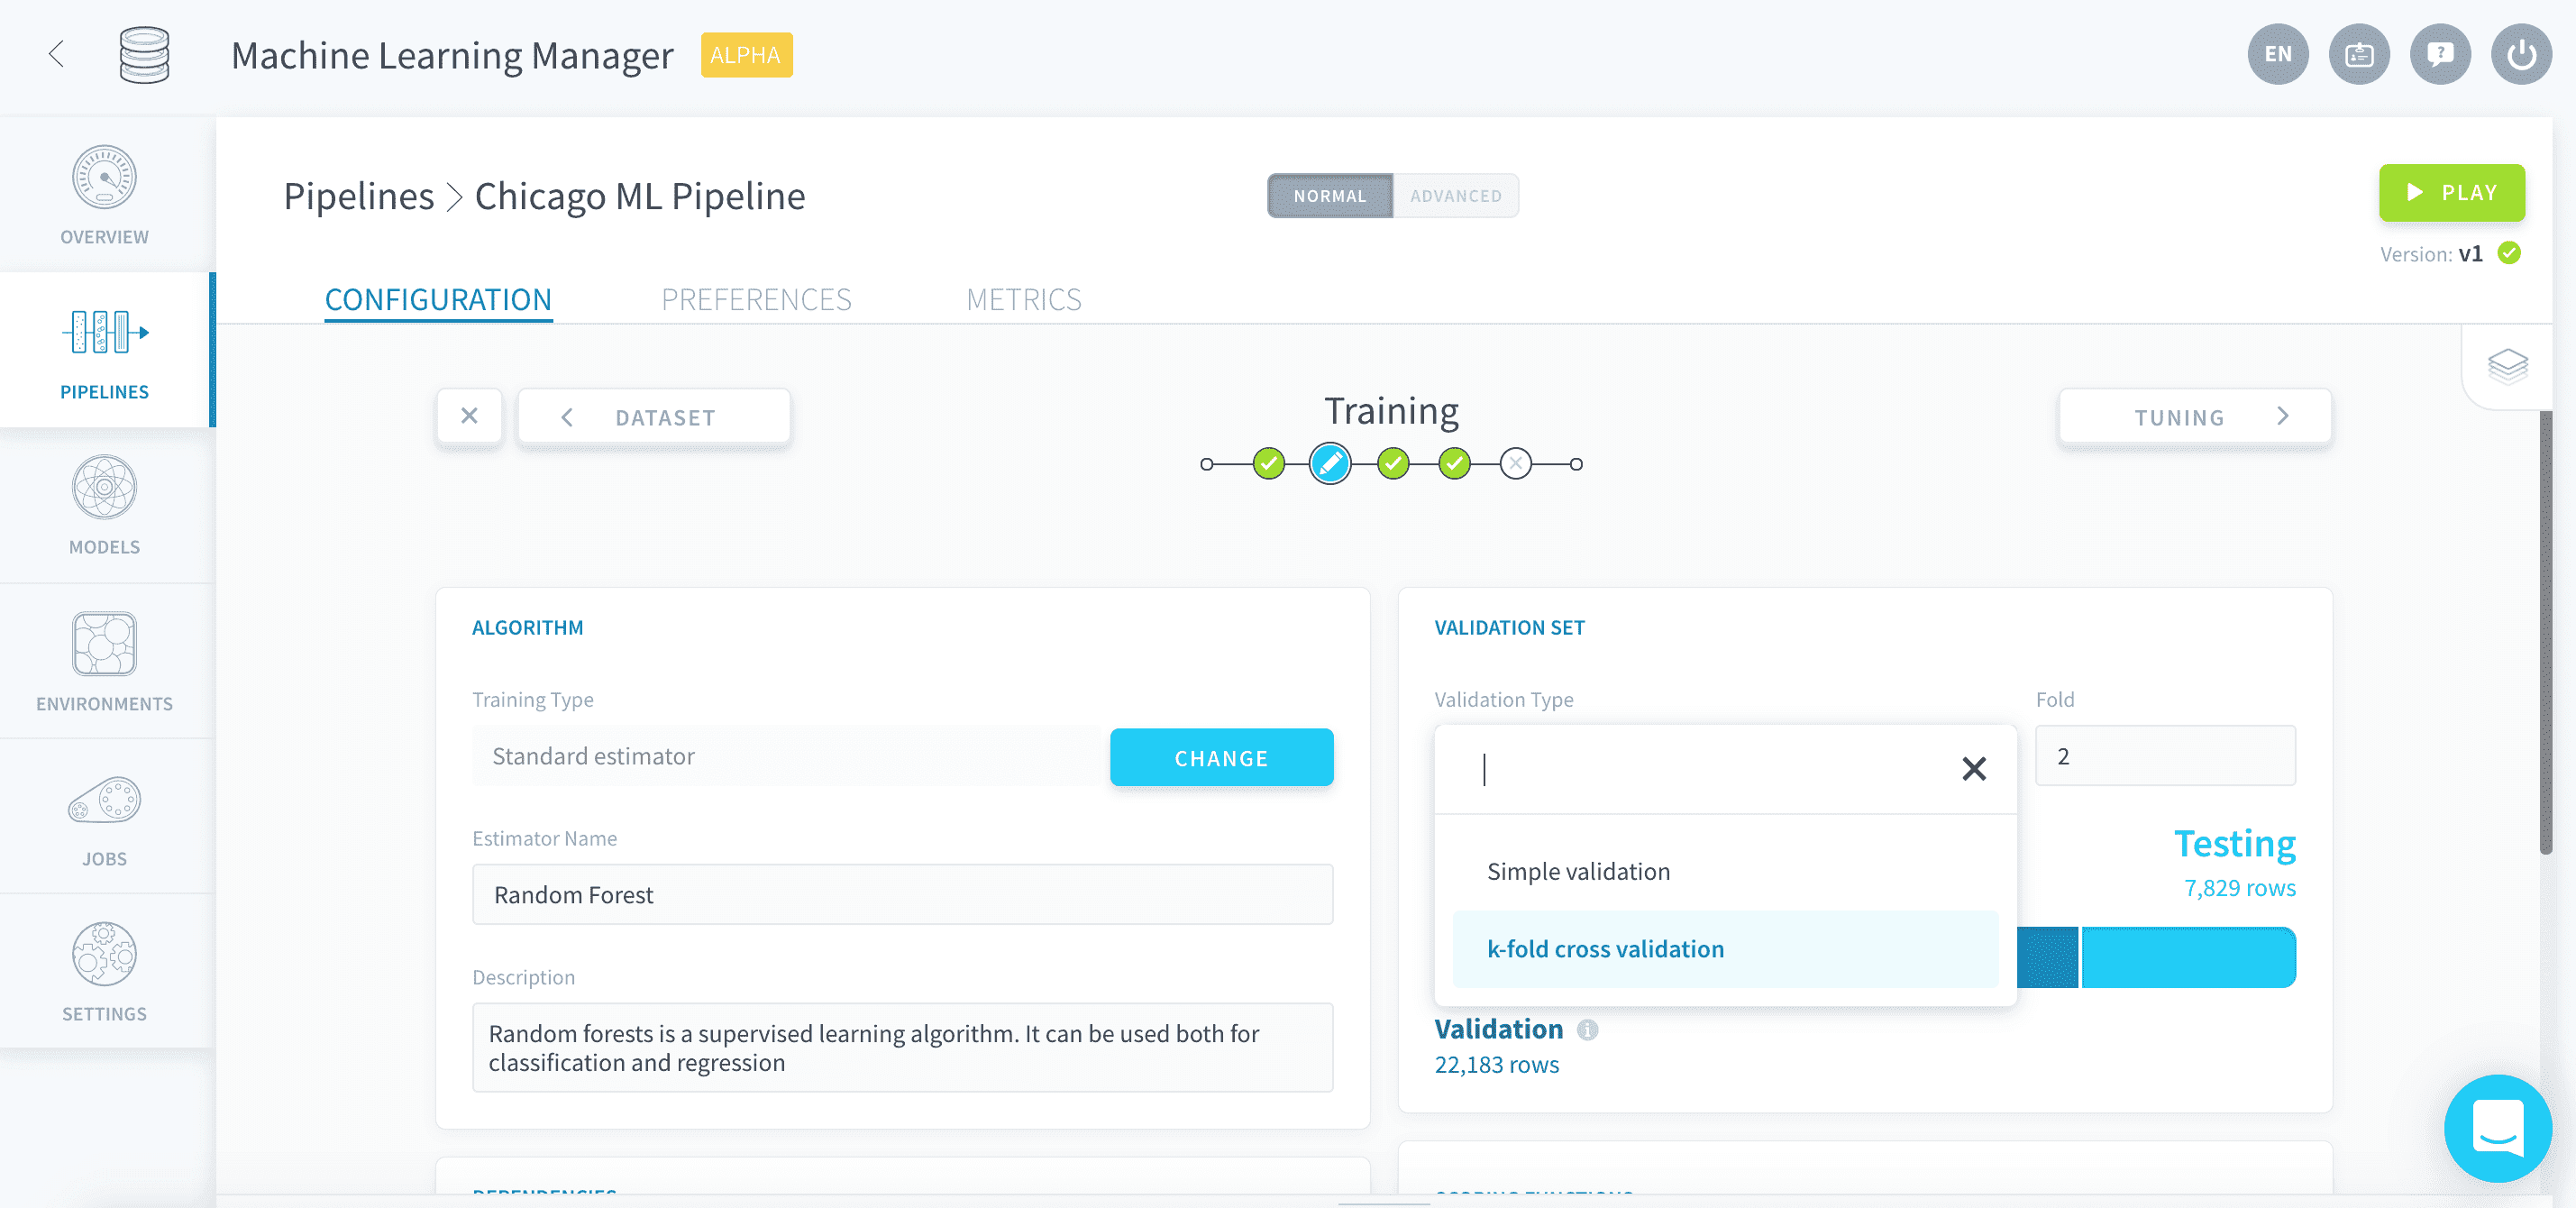
フォールドに選択したフォールド数を入力します:
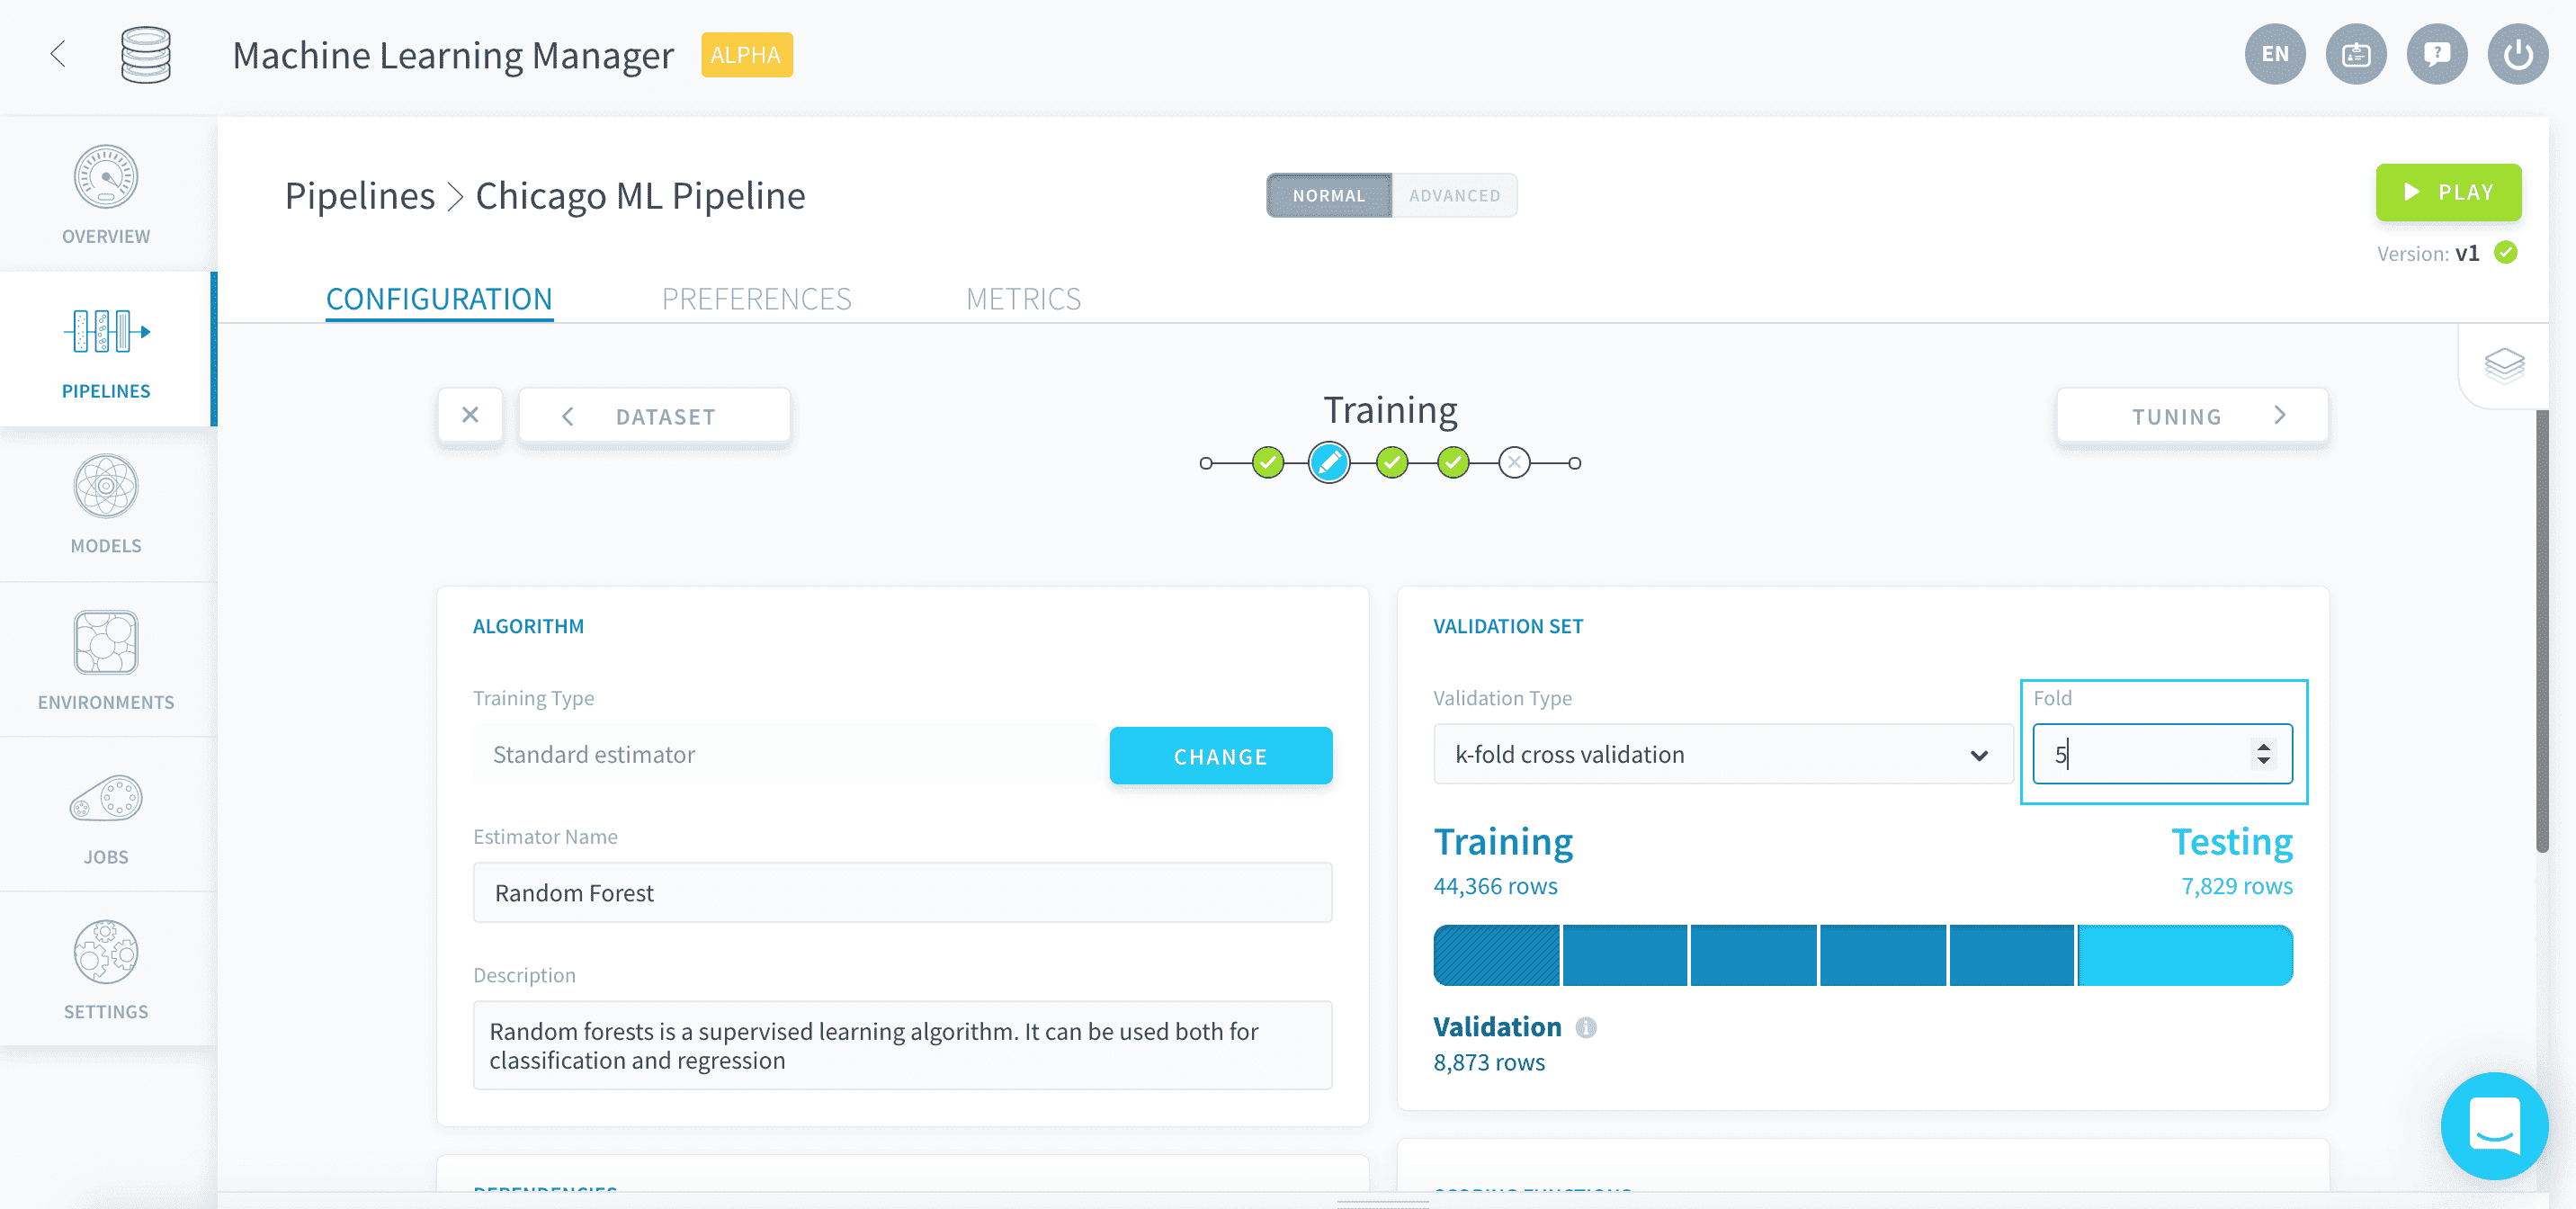
学習ジョブが実行されると、パイプラインは自動的に生成されたモデルを各フォールドで順番にスコアリングします。その結果として得られるスコアは平均化され、パイプラインの残りの部分で表示される検証スコアが生成されます。
1つの学習ジョブあたりに使用されるスコアリング関数は1つだけです。それは、チューニングステップのビジュアルオプションパネルに入力されたスコアリング関数です。
スコアリング
トレーニングステップの最初で推定器を選択するたびに、デフォルトのスコアリング関数が自動的にリストに追加されます。このデフォルトスコアは、推定器が分類器か回帰器かによって異なります。

テストジョブが実行されると、リスト内のすべてのスコアがテストセットで同時に計算されます。
各スコアリング関数には閾値が関連付けられています。これは、モデルが検証セットとテストセットの両方で保存されるために達成する必要がある最小スコアです。
- 学習ジョブ中: 選択したスコアが検証セットでその閾値に達しない場合、モデルは保存されません。
- テストジョブ中: どのスコアもそのそれぞれの閾値に達しない場合、モデルは保存されません。
スコアリング関数は、隣の星 ⭐ アイコンをクリックして主要なものとして設定できます。これは、パイプラインの残りの部分で表示されるデフォルトのスコアを意味します。
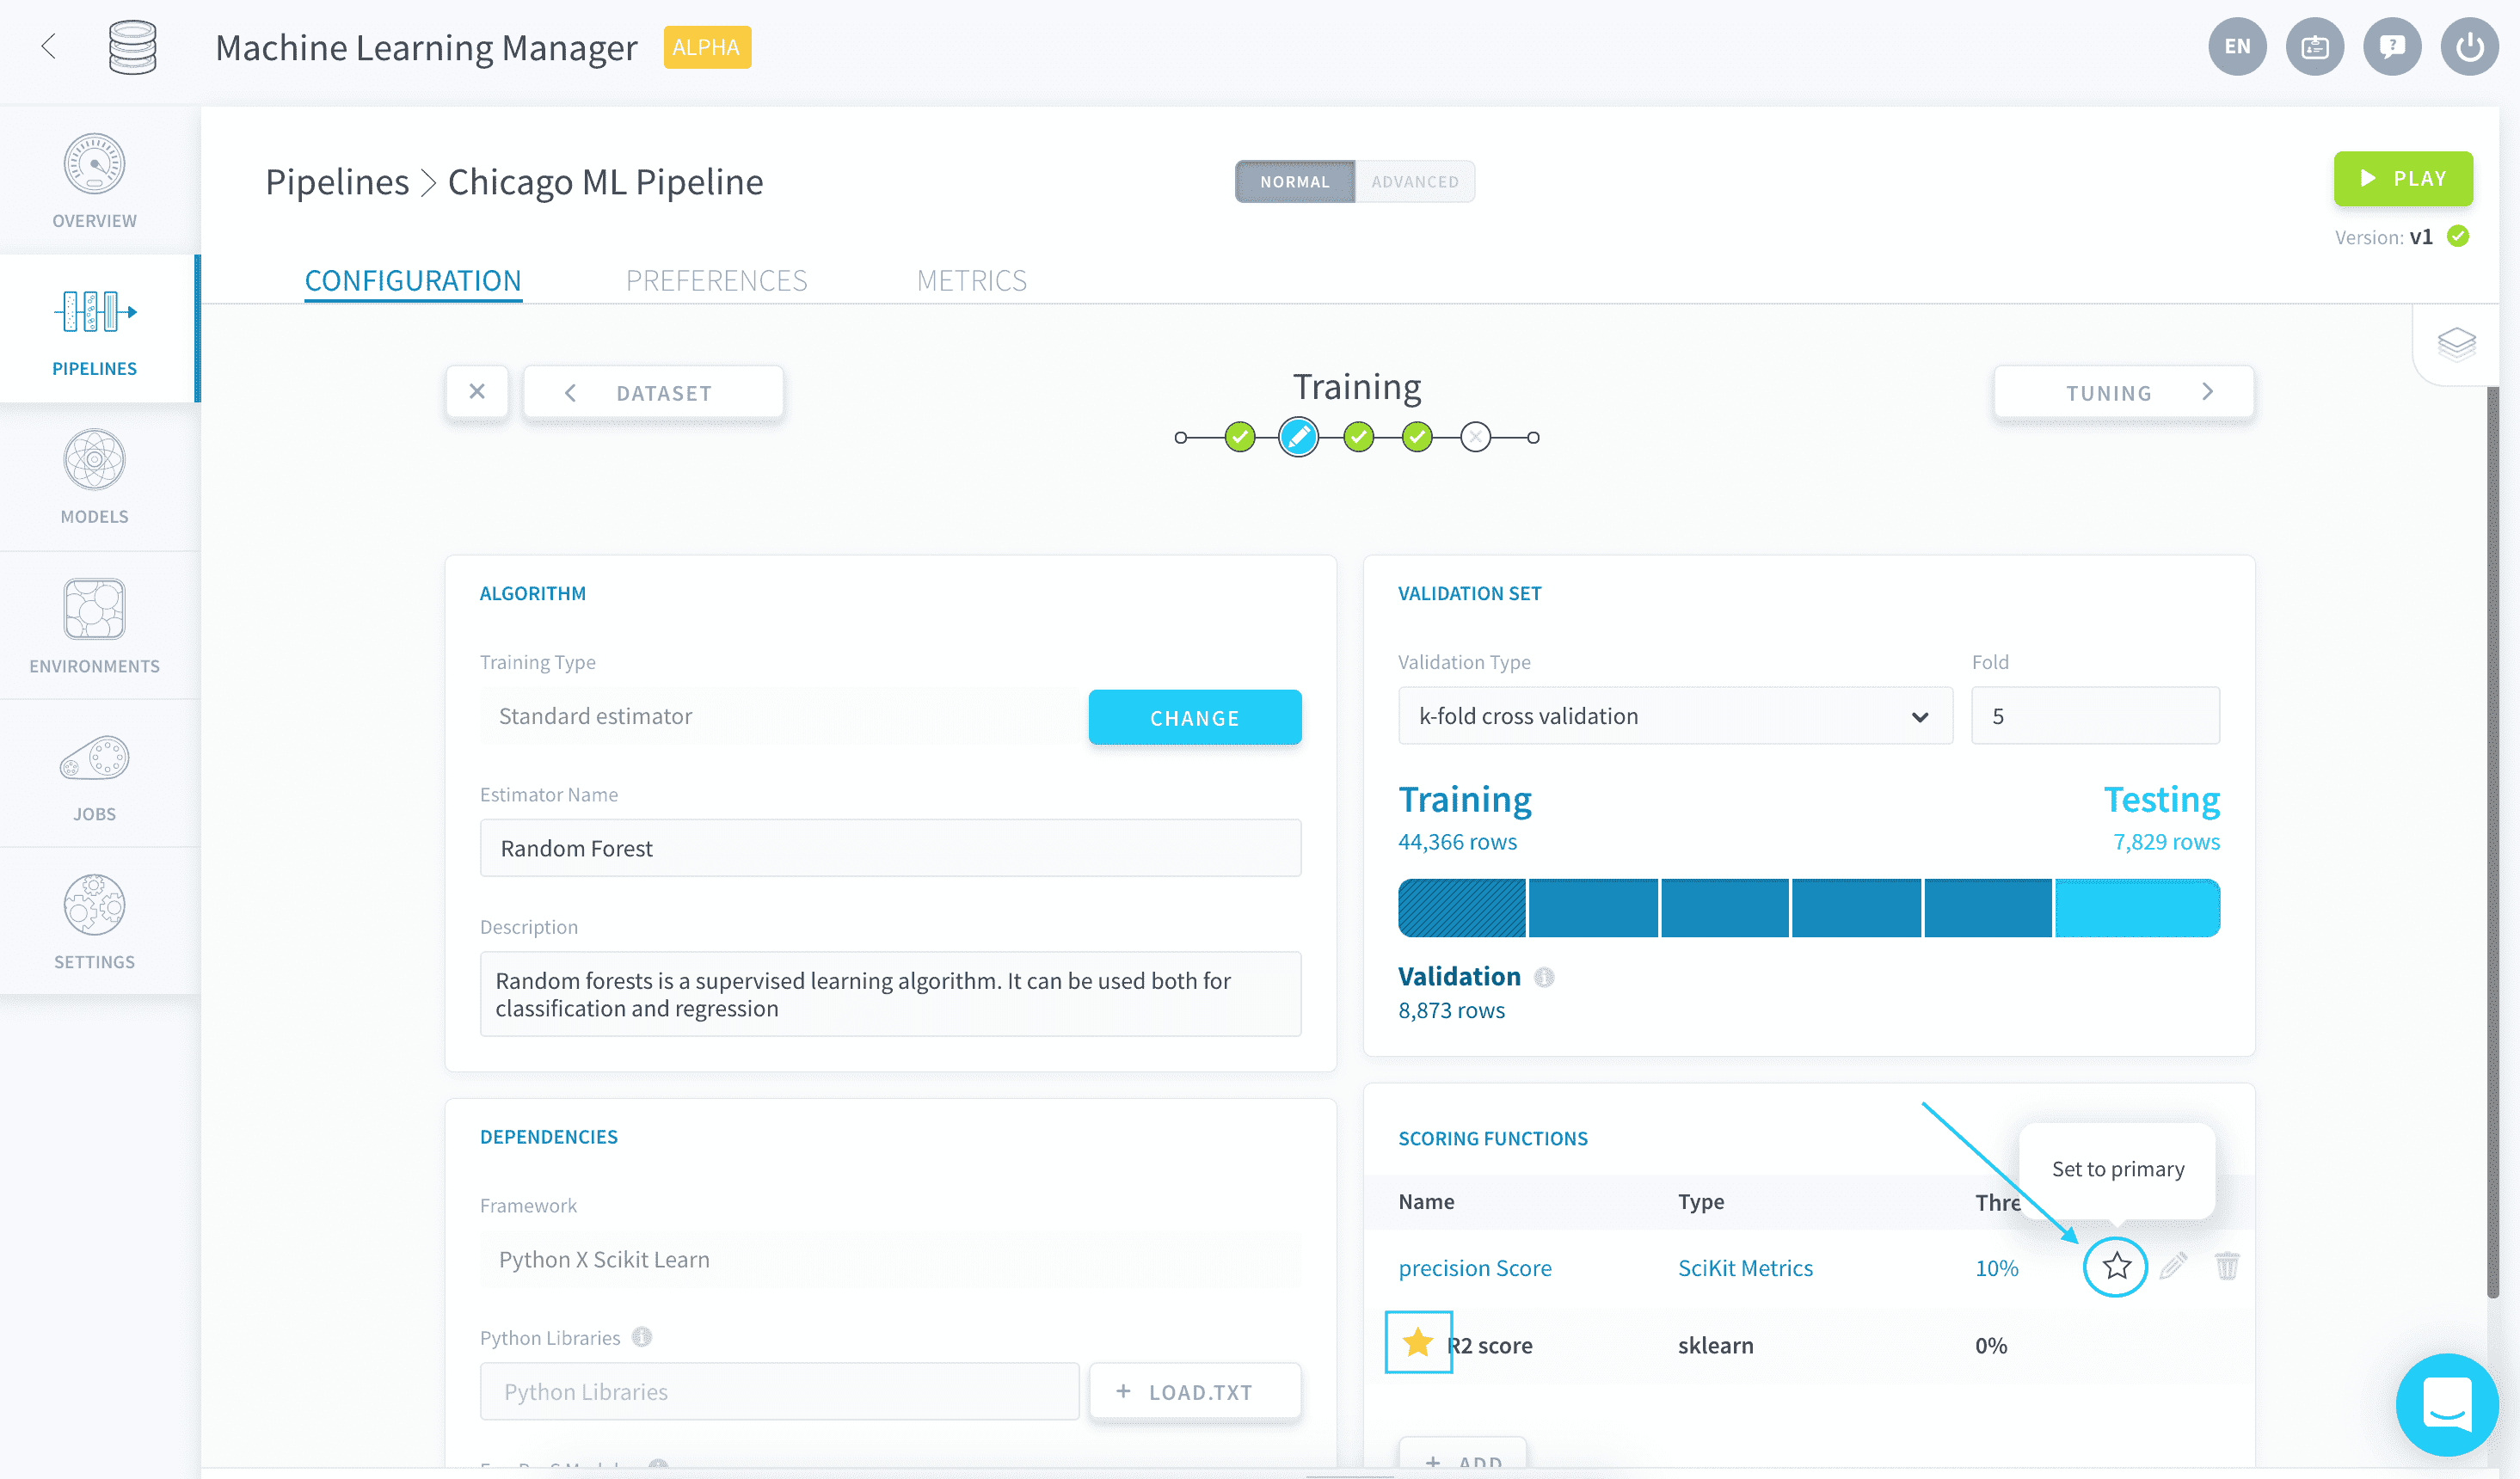
新しいスコアリング関数を追加する場合、標準スコアリング関数から最も人気のあるスコアのカタログから選択するか、独自のカスタムスコアリングスクリプトをアップロードできます。
標準スコアリング関数
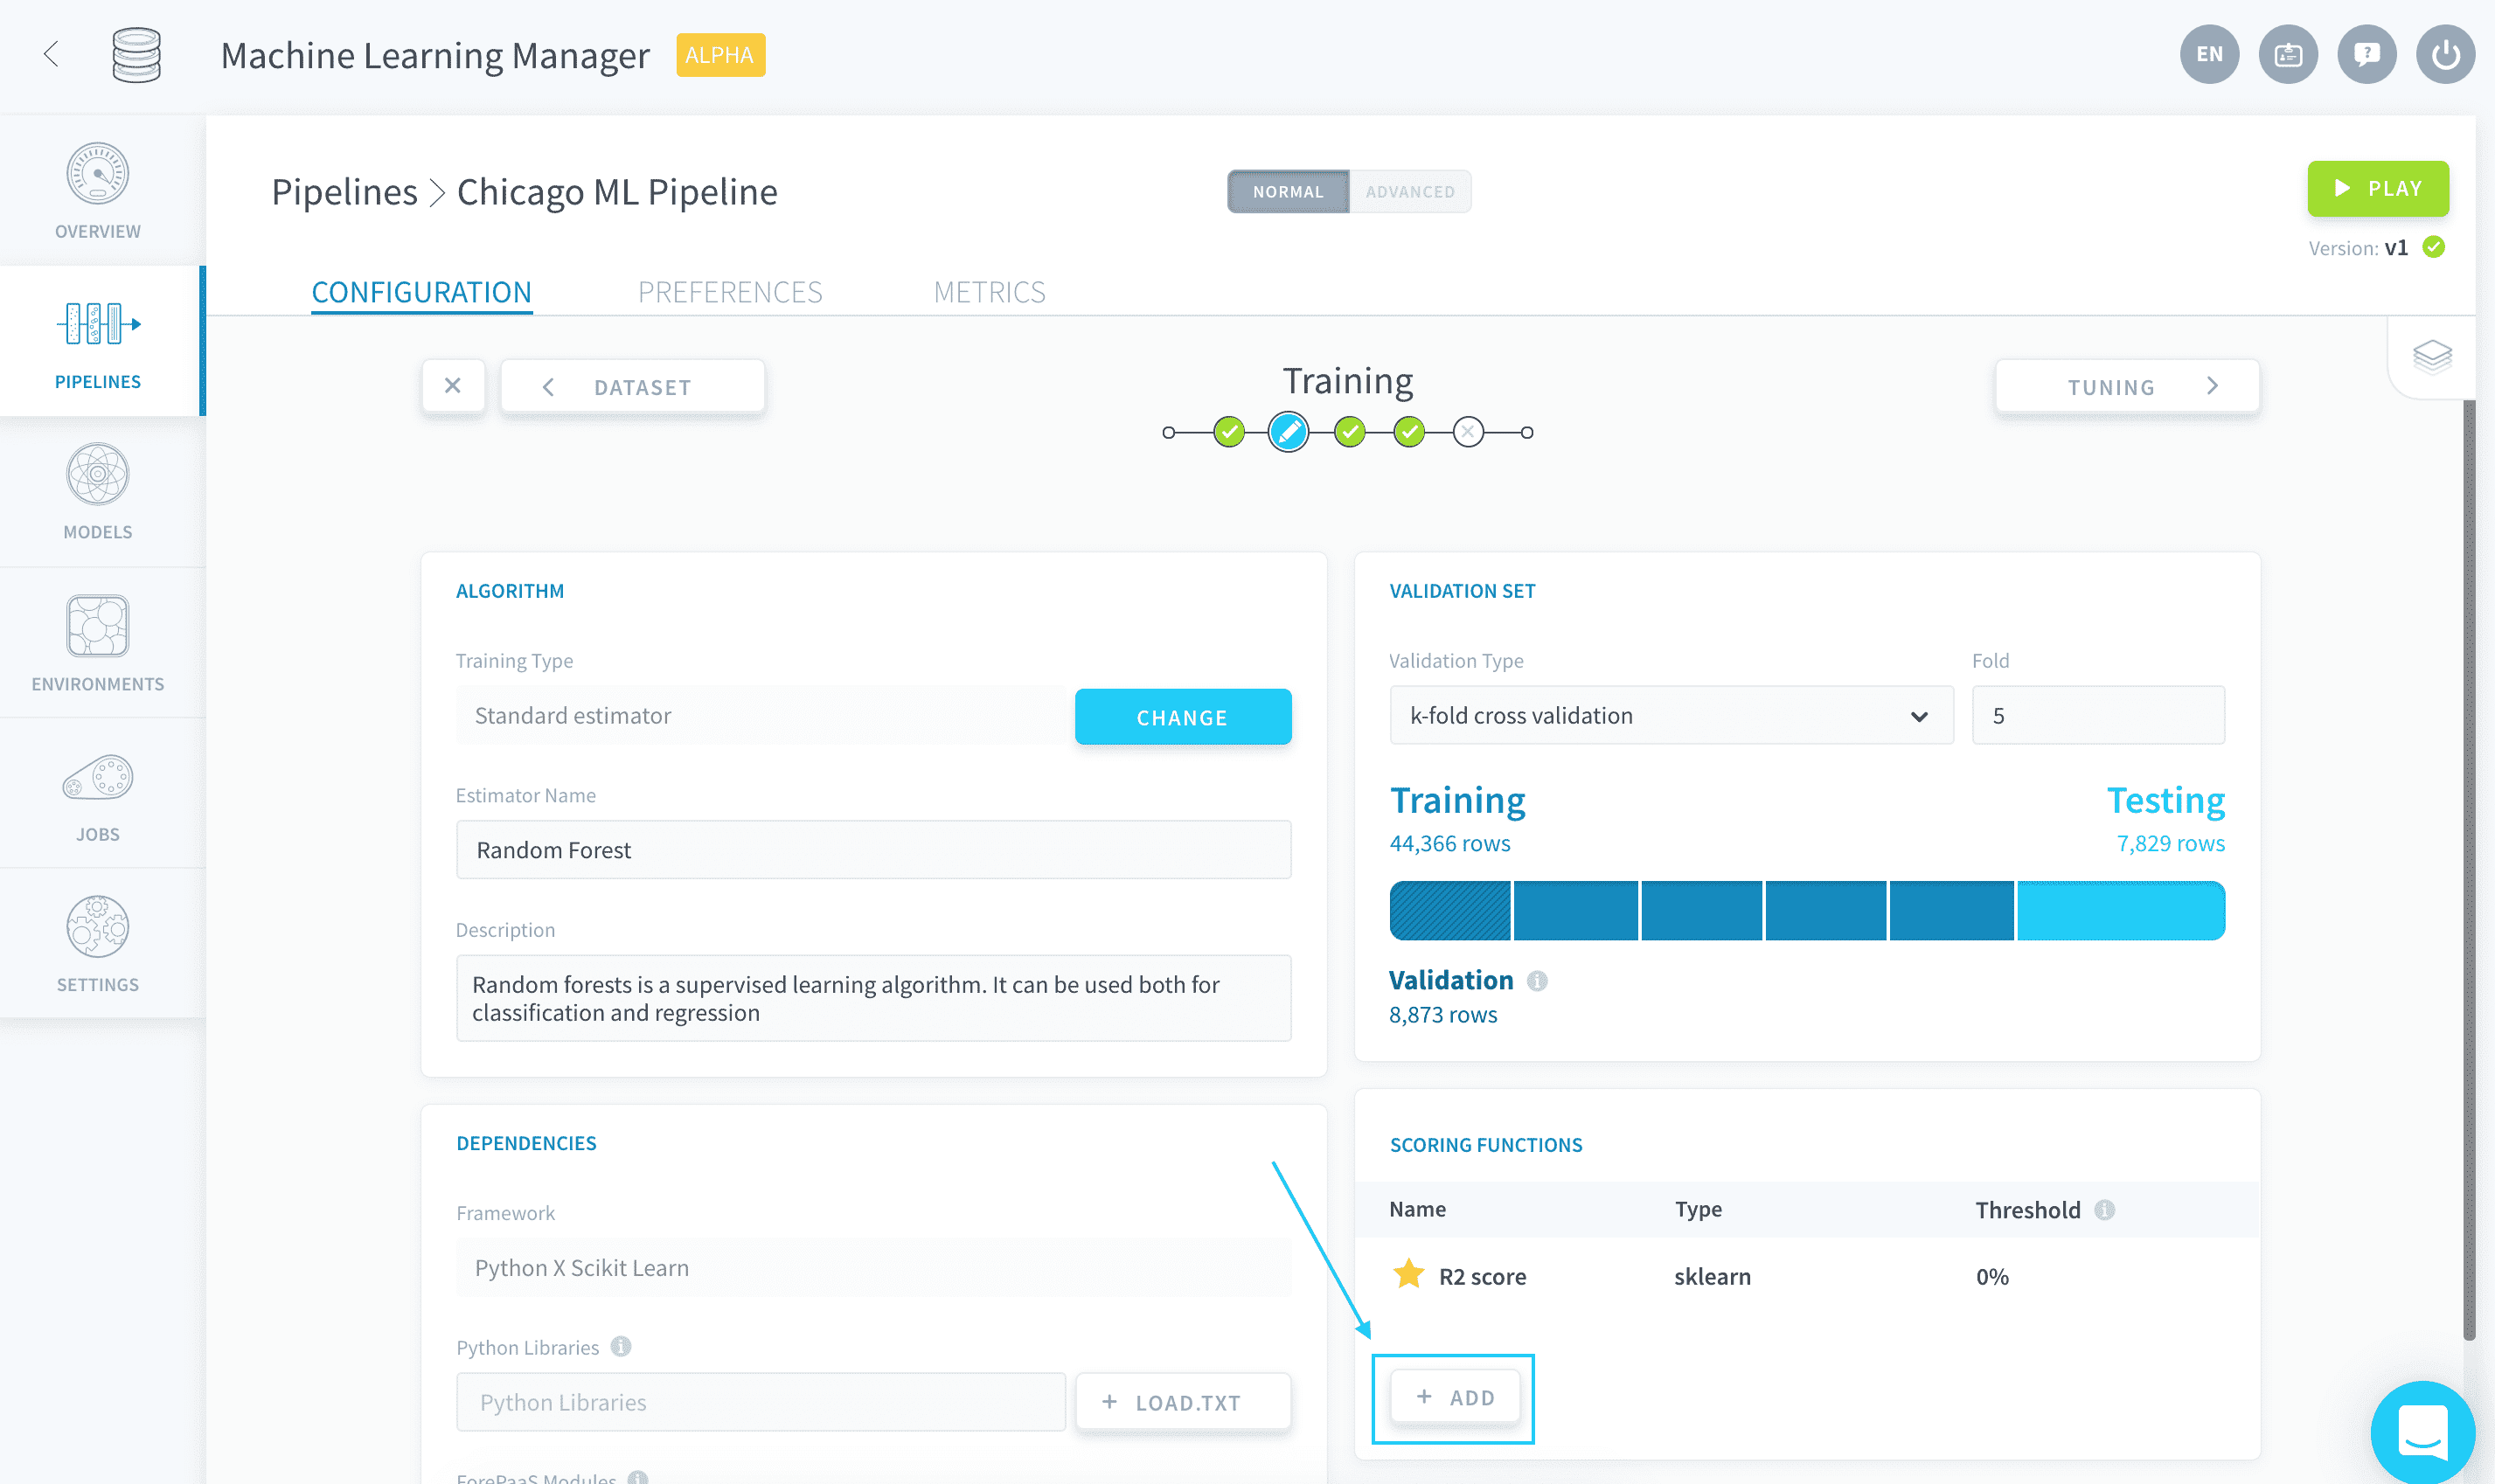
標準スコアリング関数を追加するには、追加をクリックします。
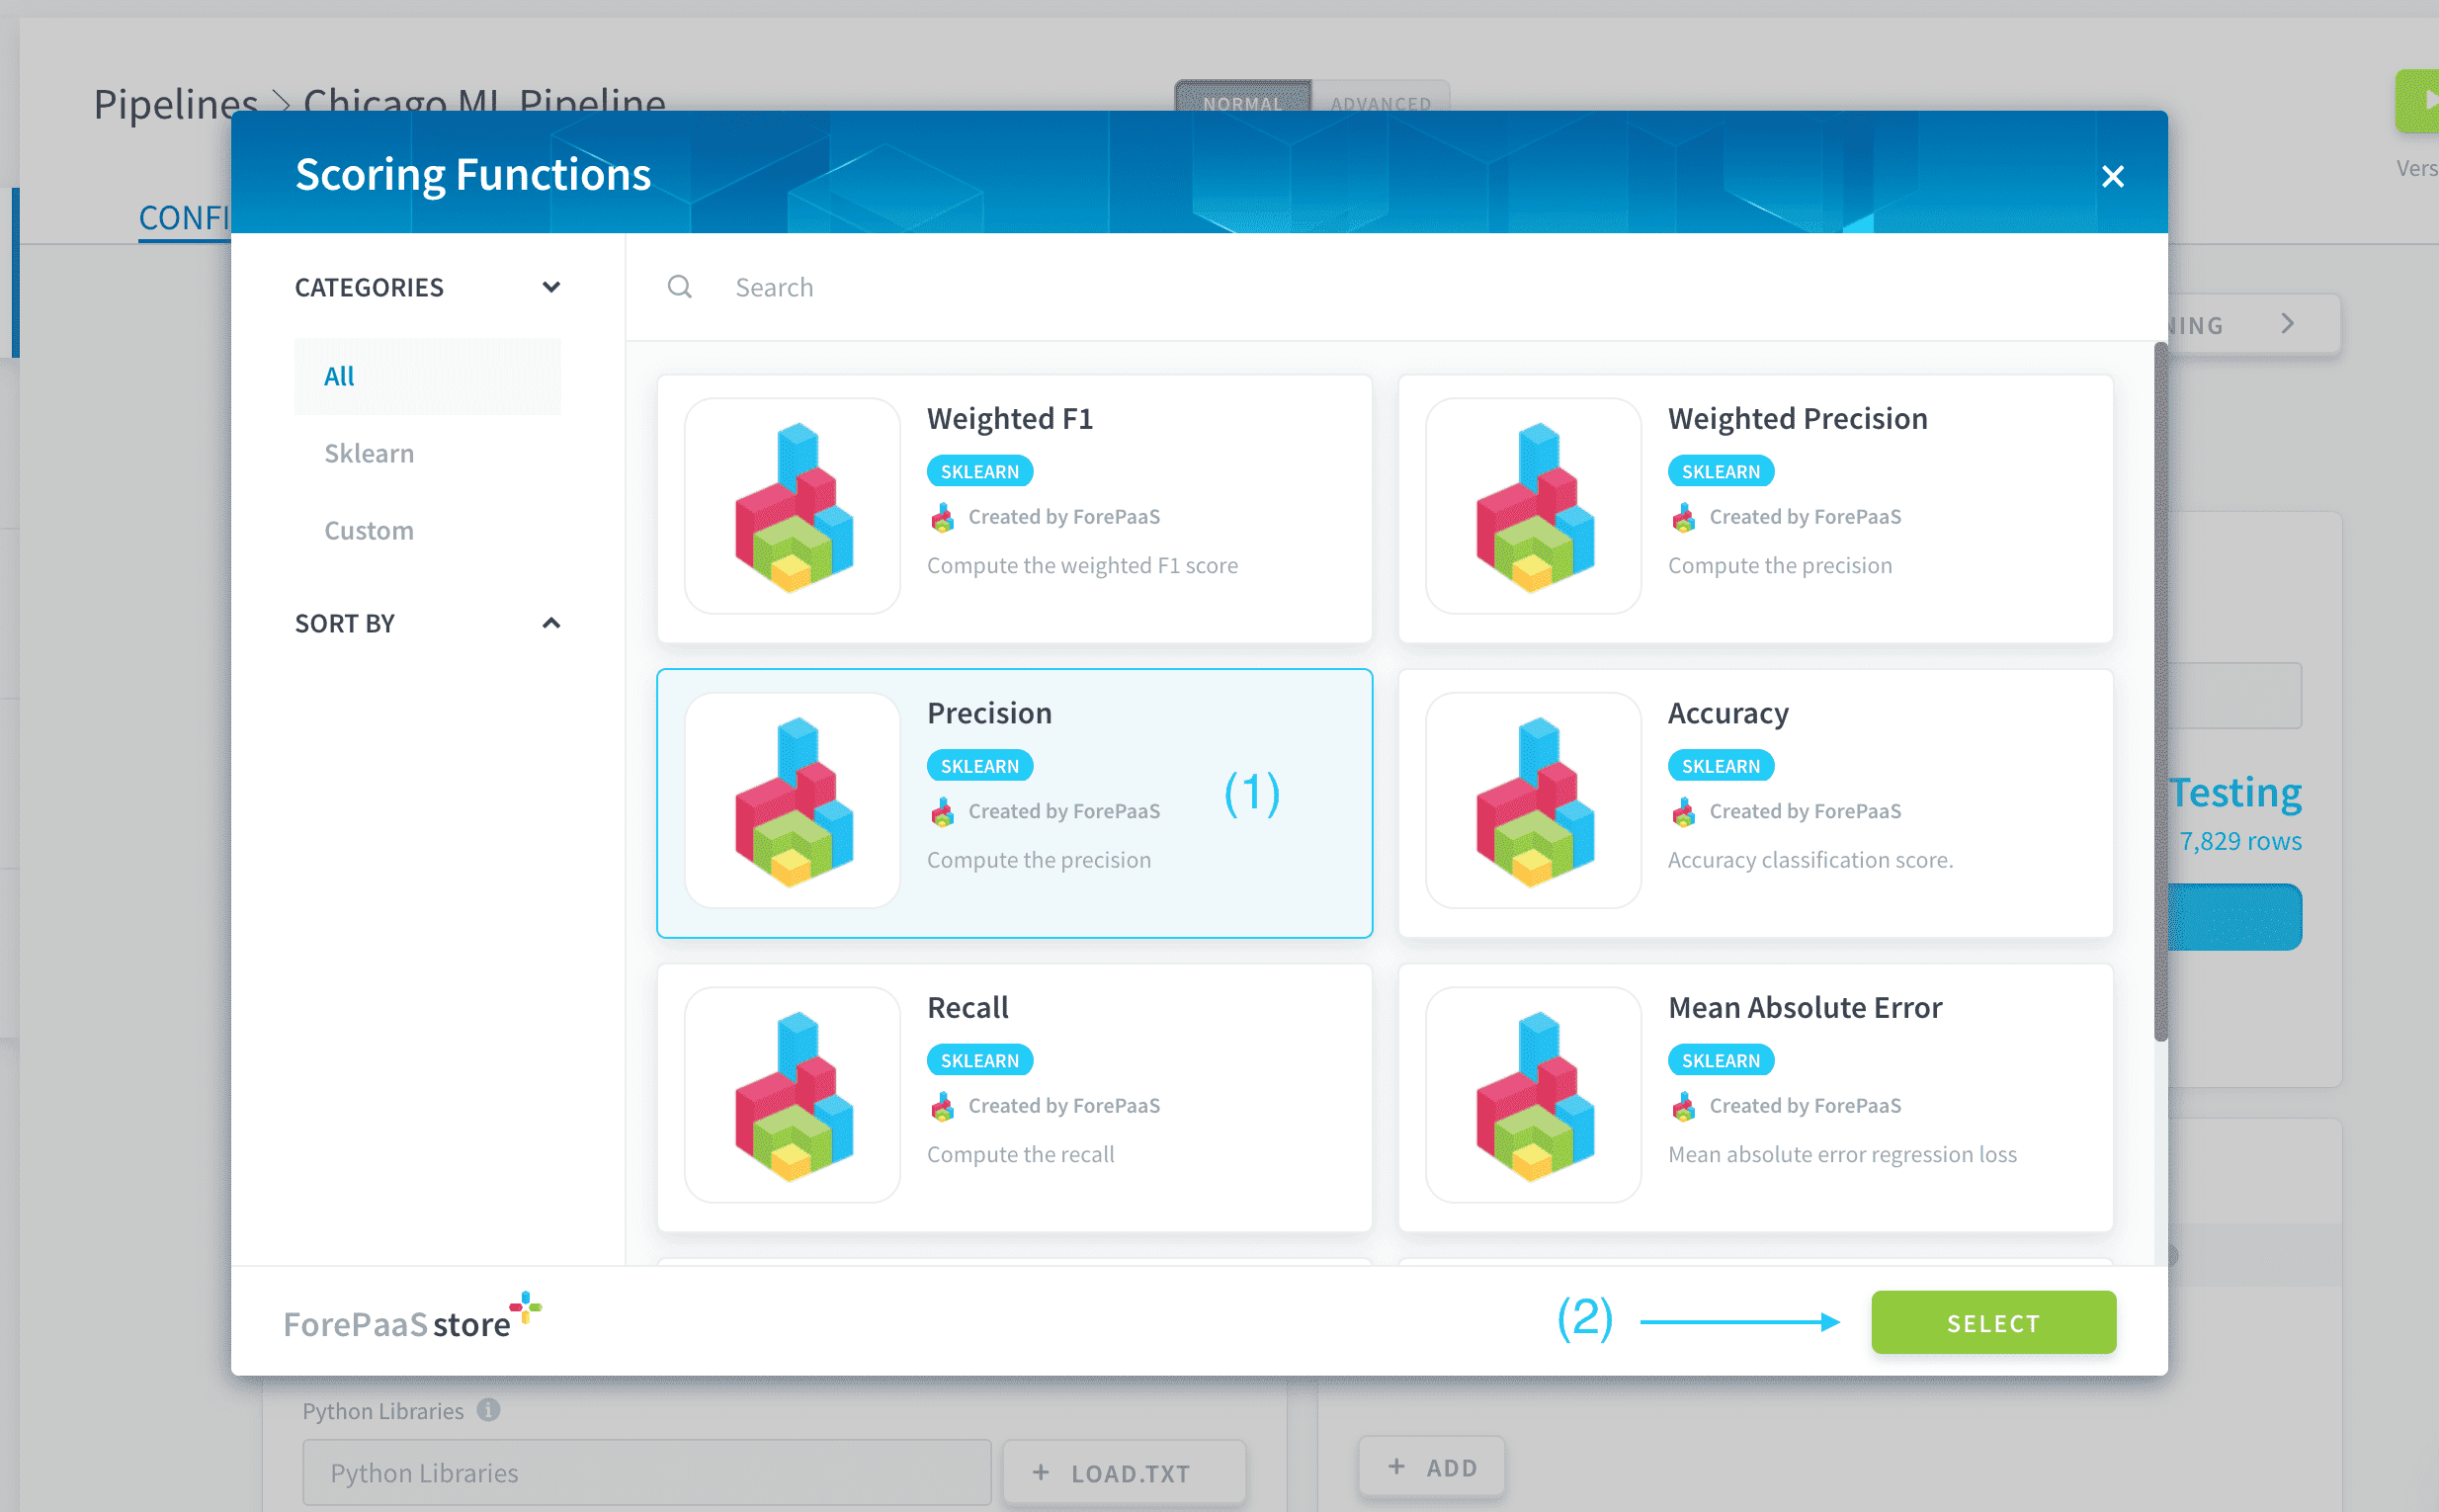
ストアから希望する標準推定器を選択し、選択を押します。
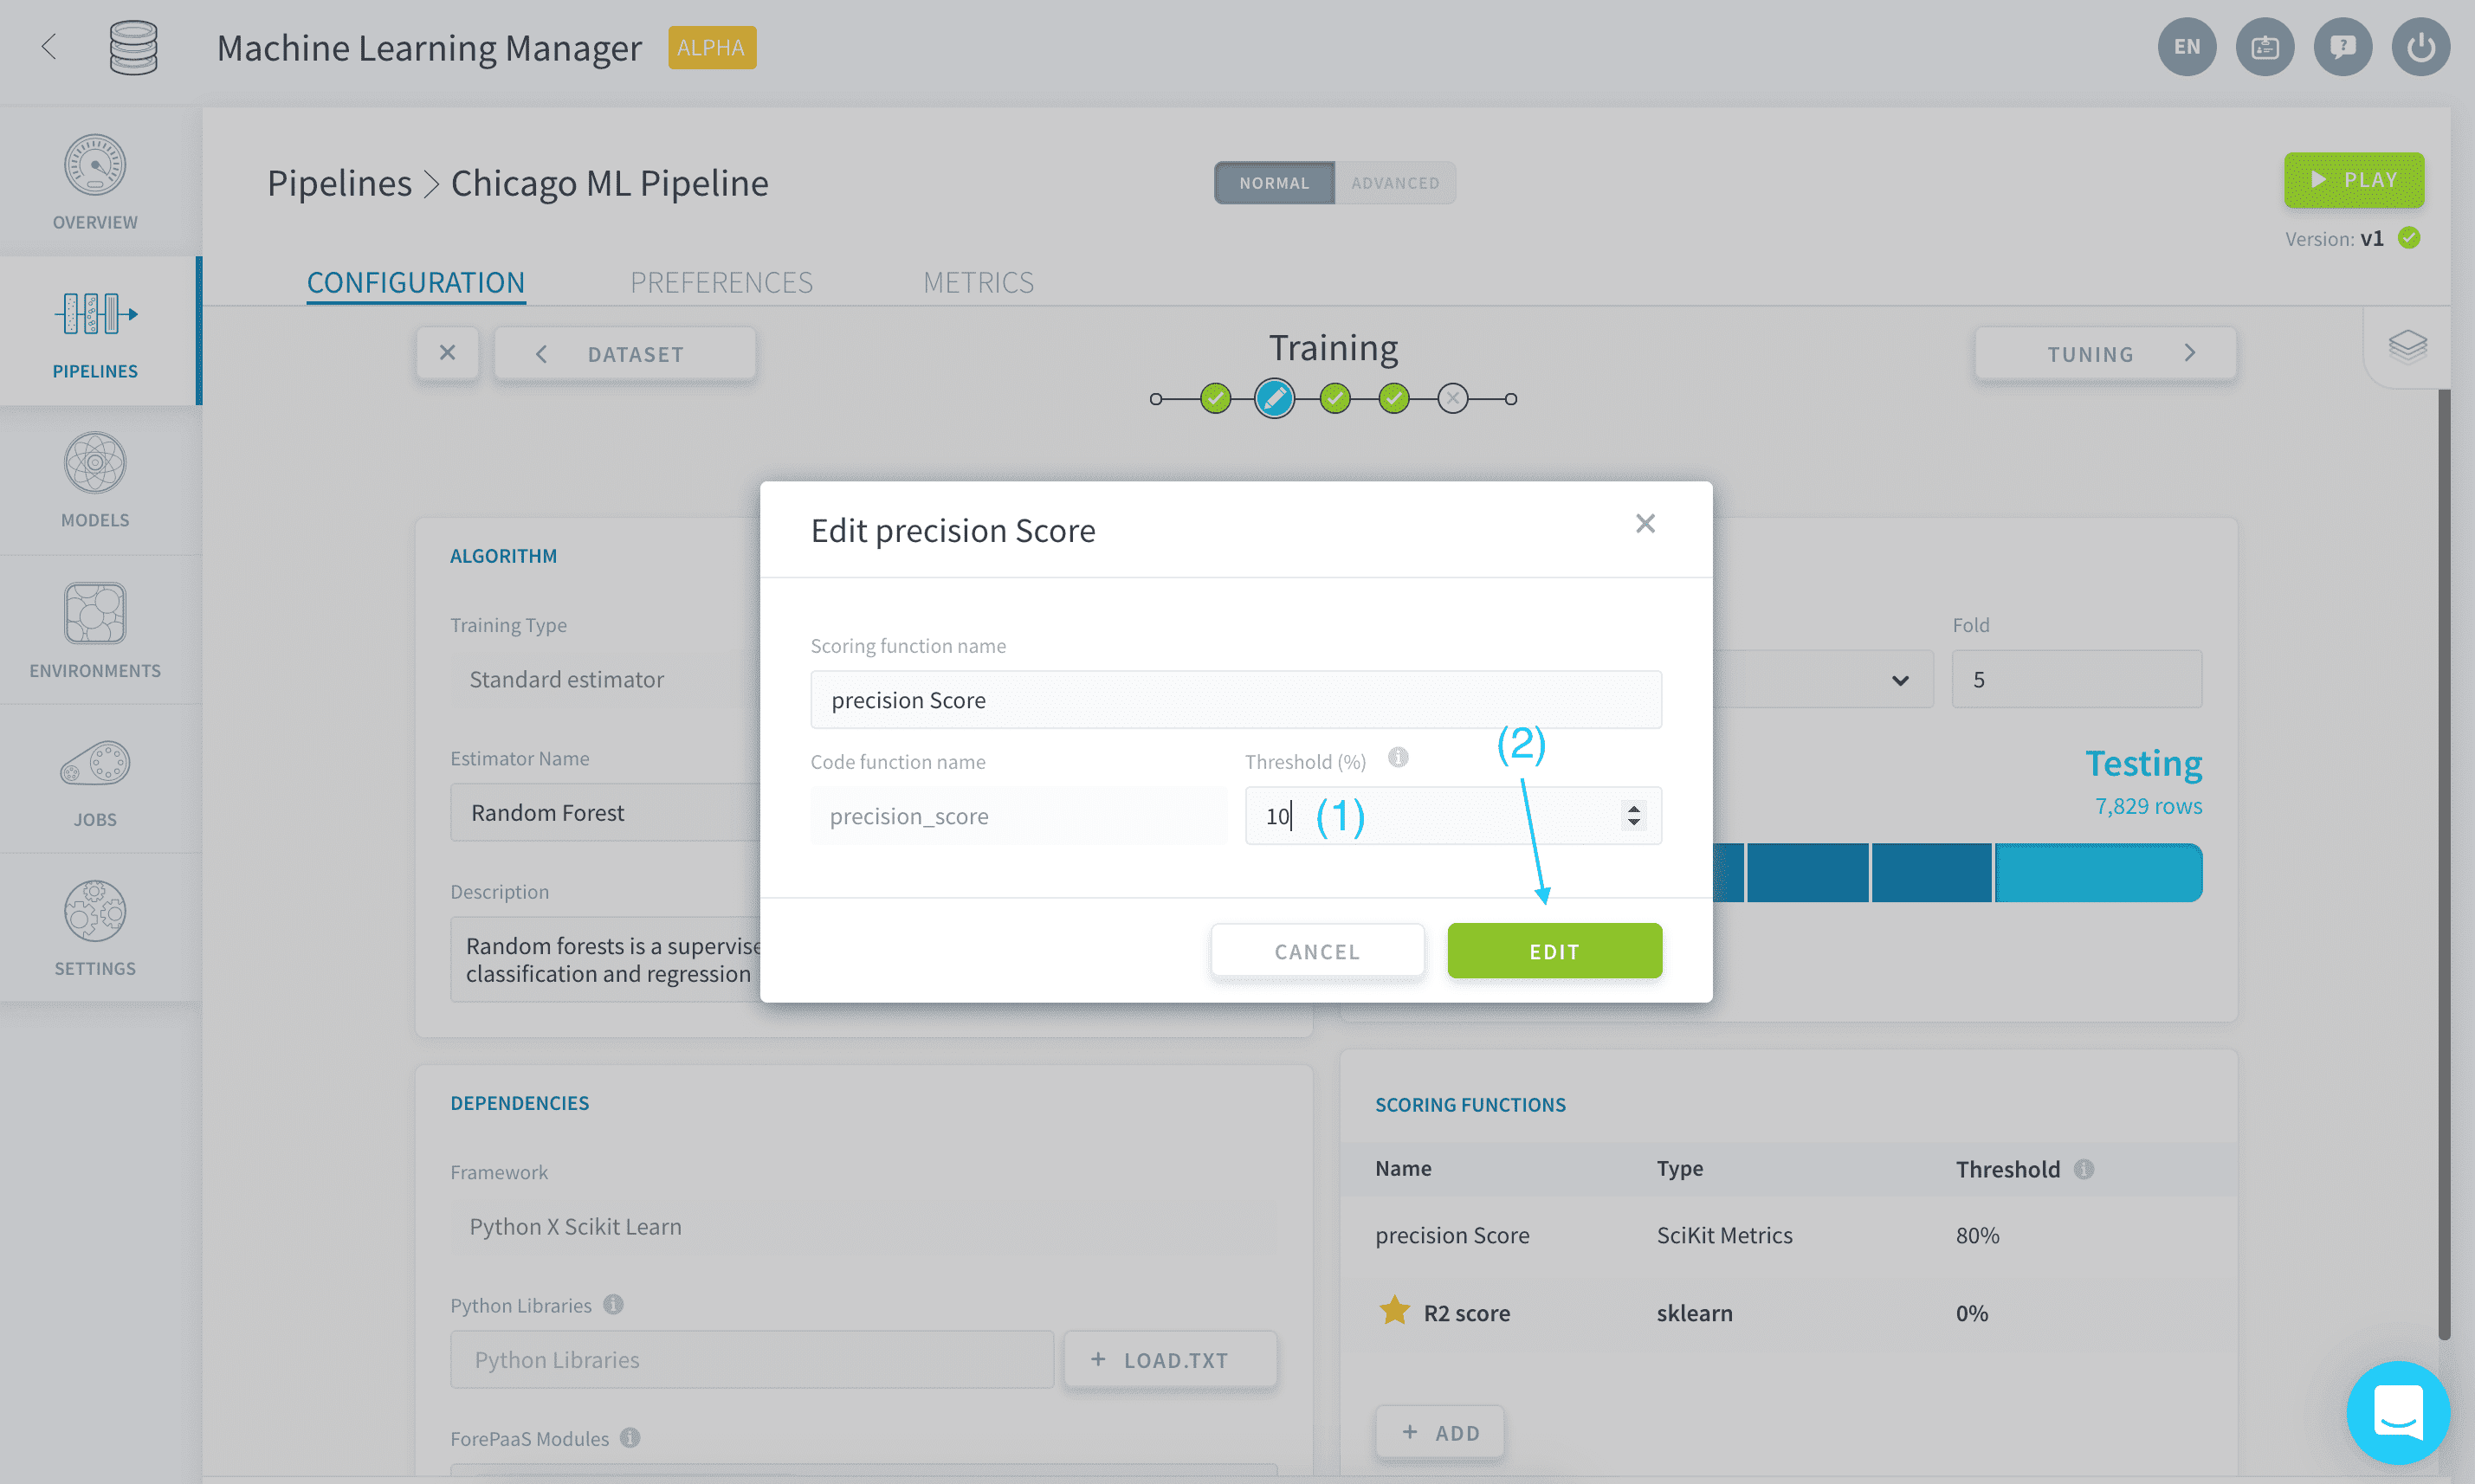
新しいスコアのデフォルト閾値が自動的に設定されます。変更するには、新しいスコアの行の編集 ✏️ アイコンをクリックします。
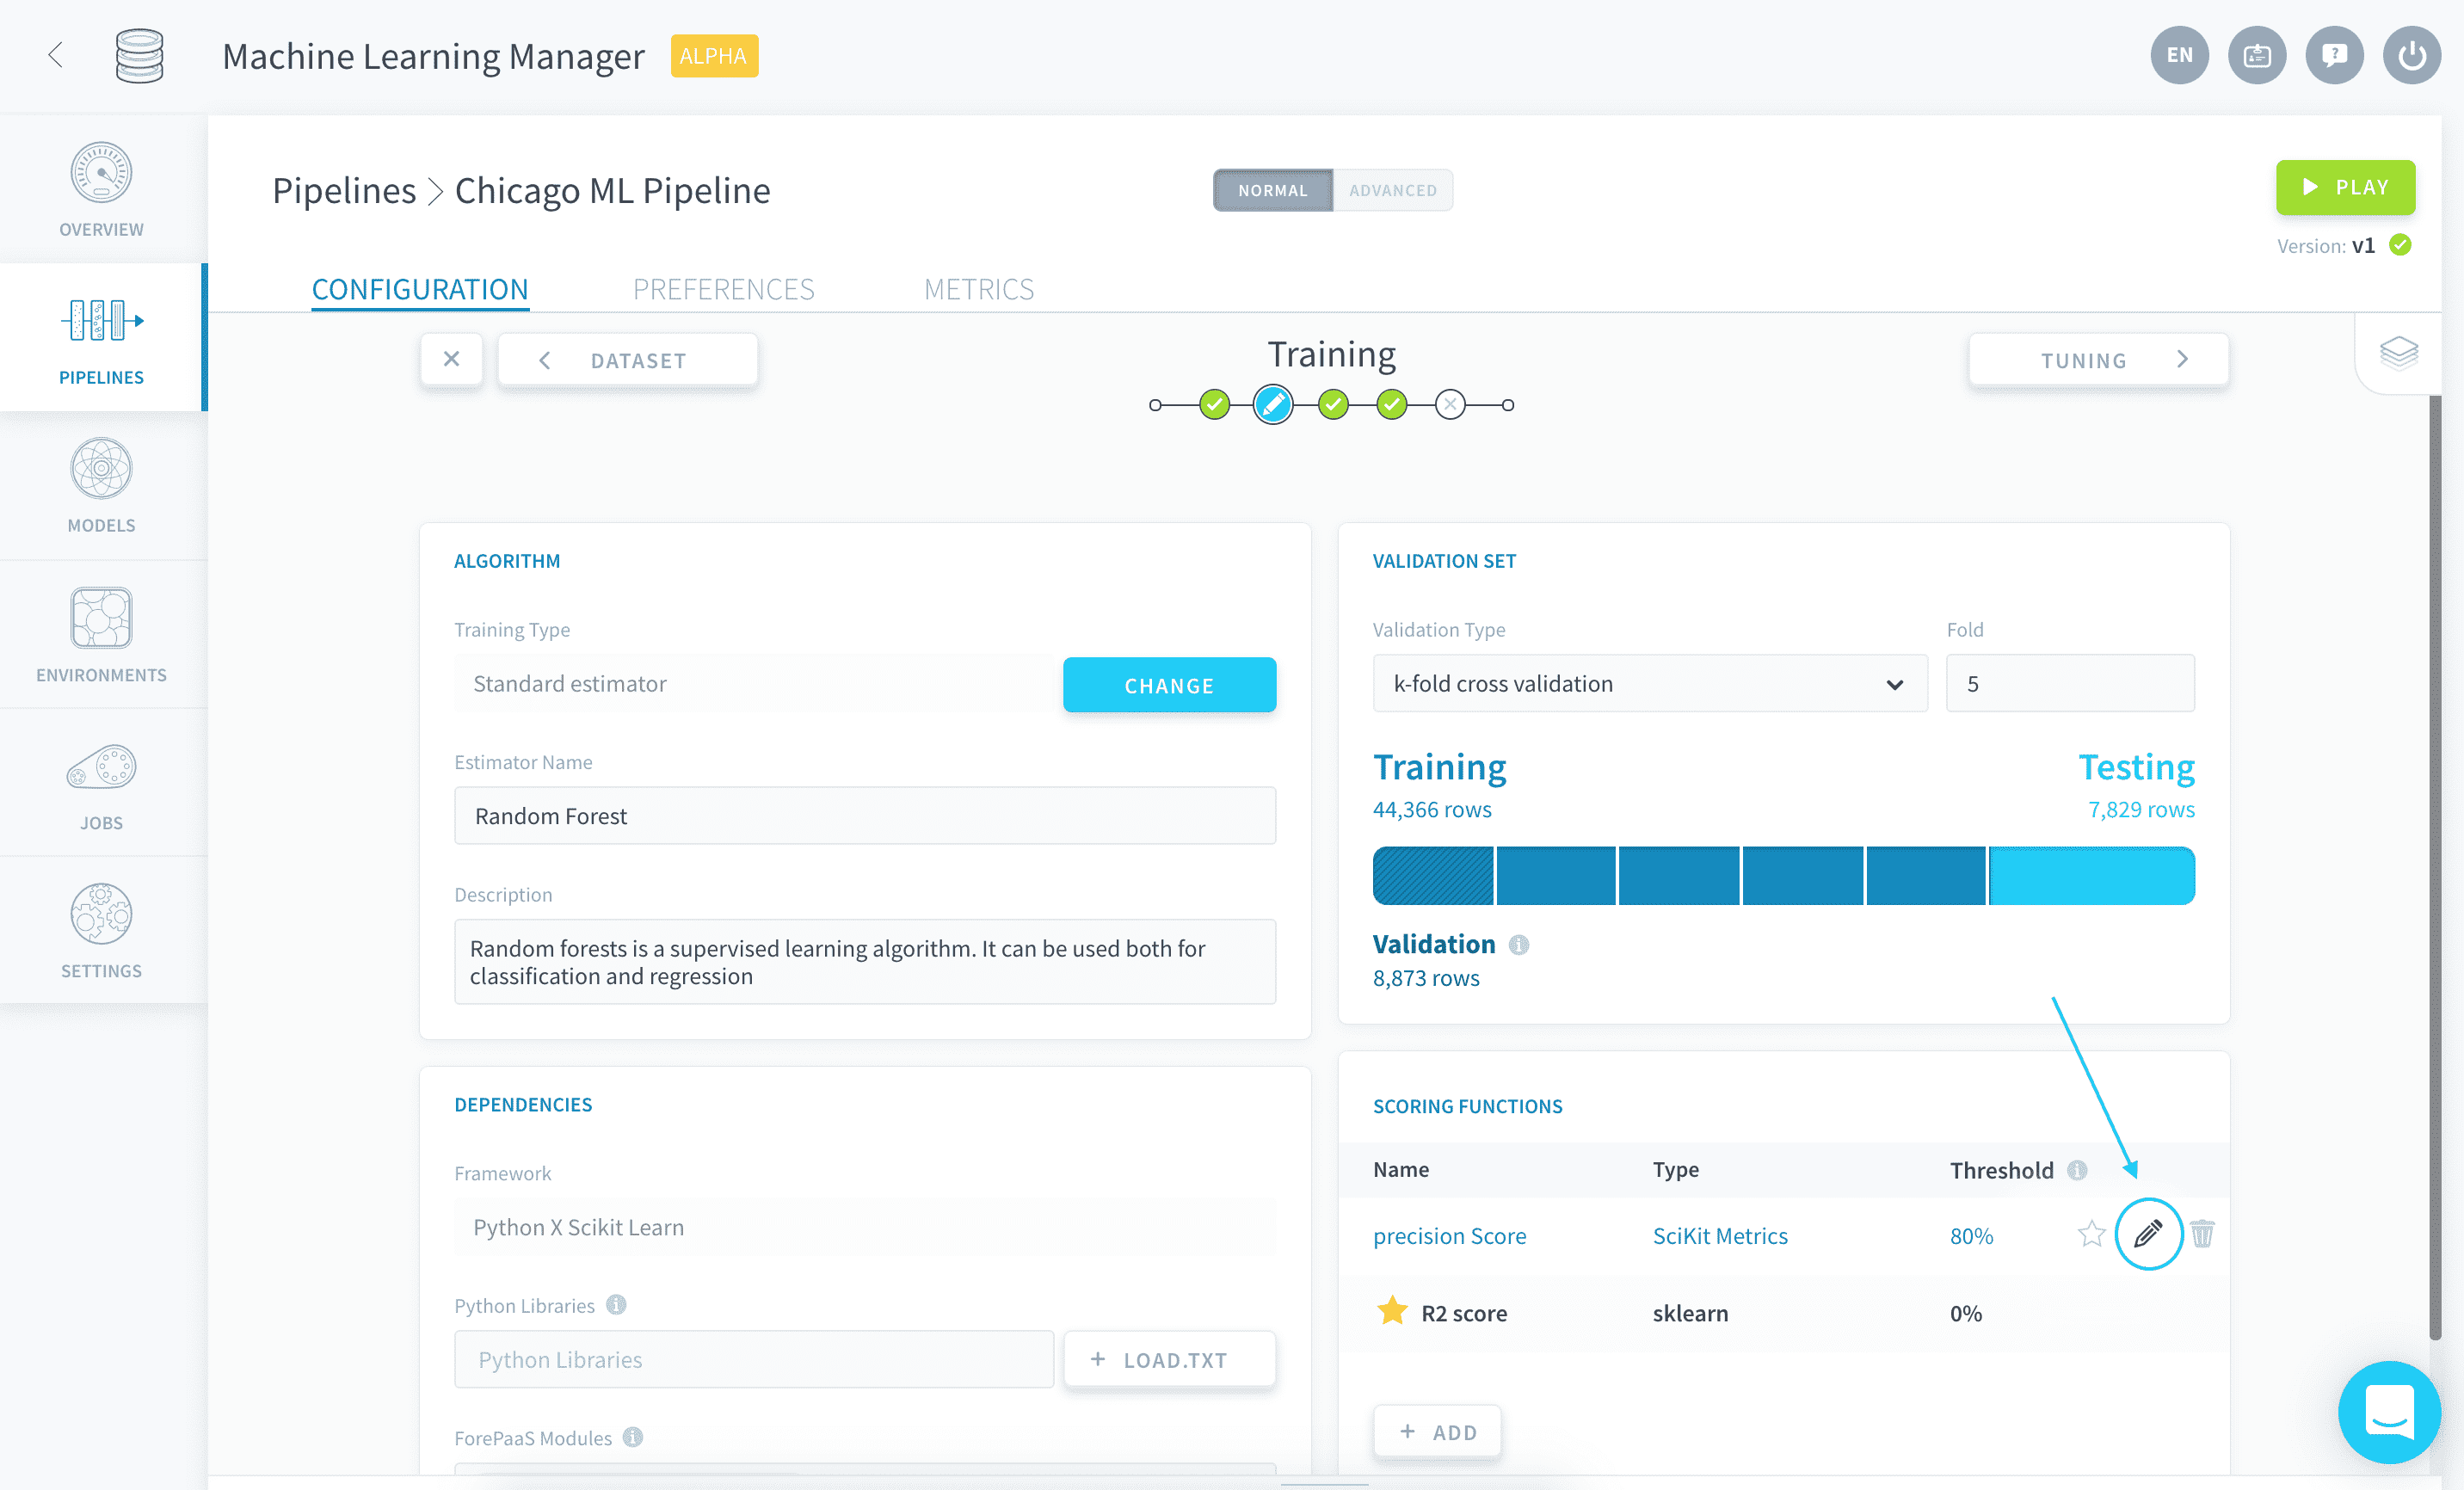
その後、新しい選択した閾値をパーセンテージとして入力できます。
カスタムスコアリング関数
独自のカスタムスコアリングスクリプトを追加するには、追加をクリックします。
ストアからカスタムスコアを選択し、選択を押します。
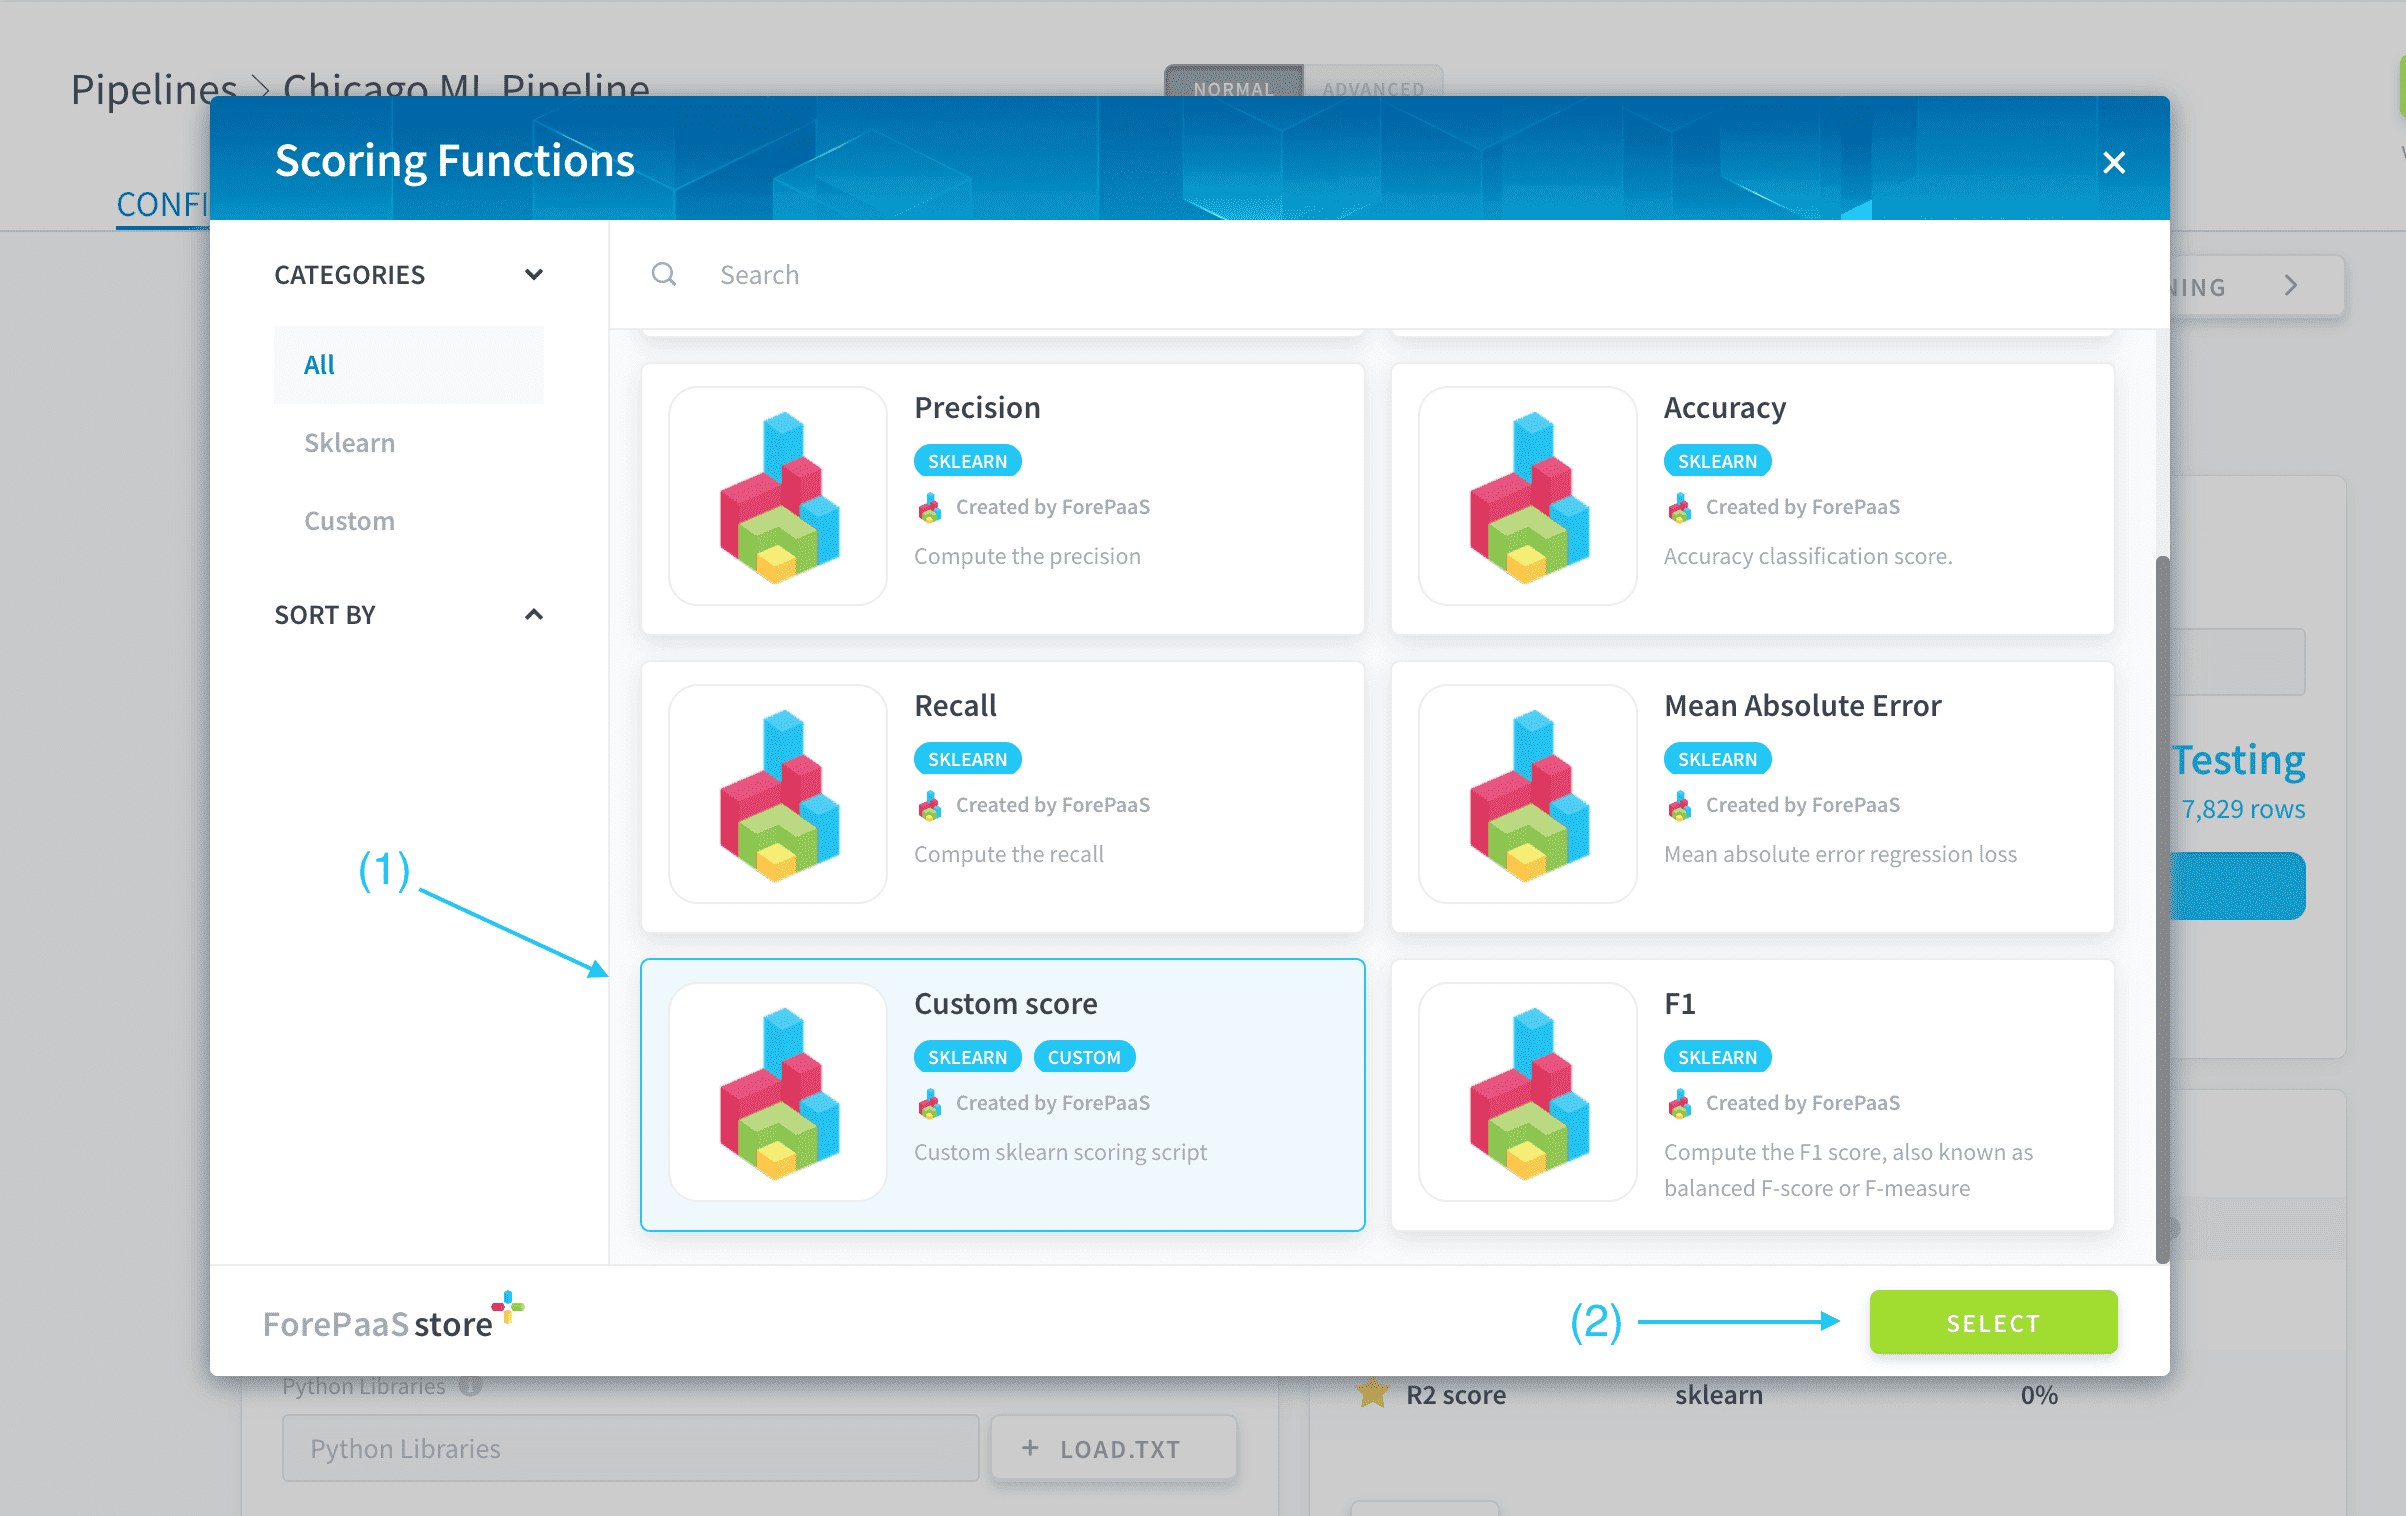
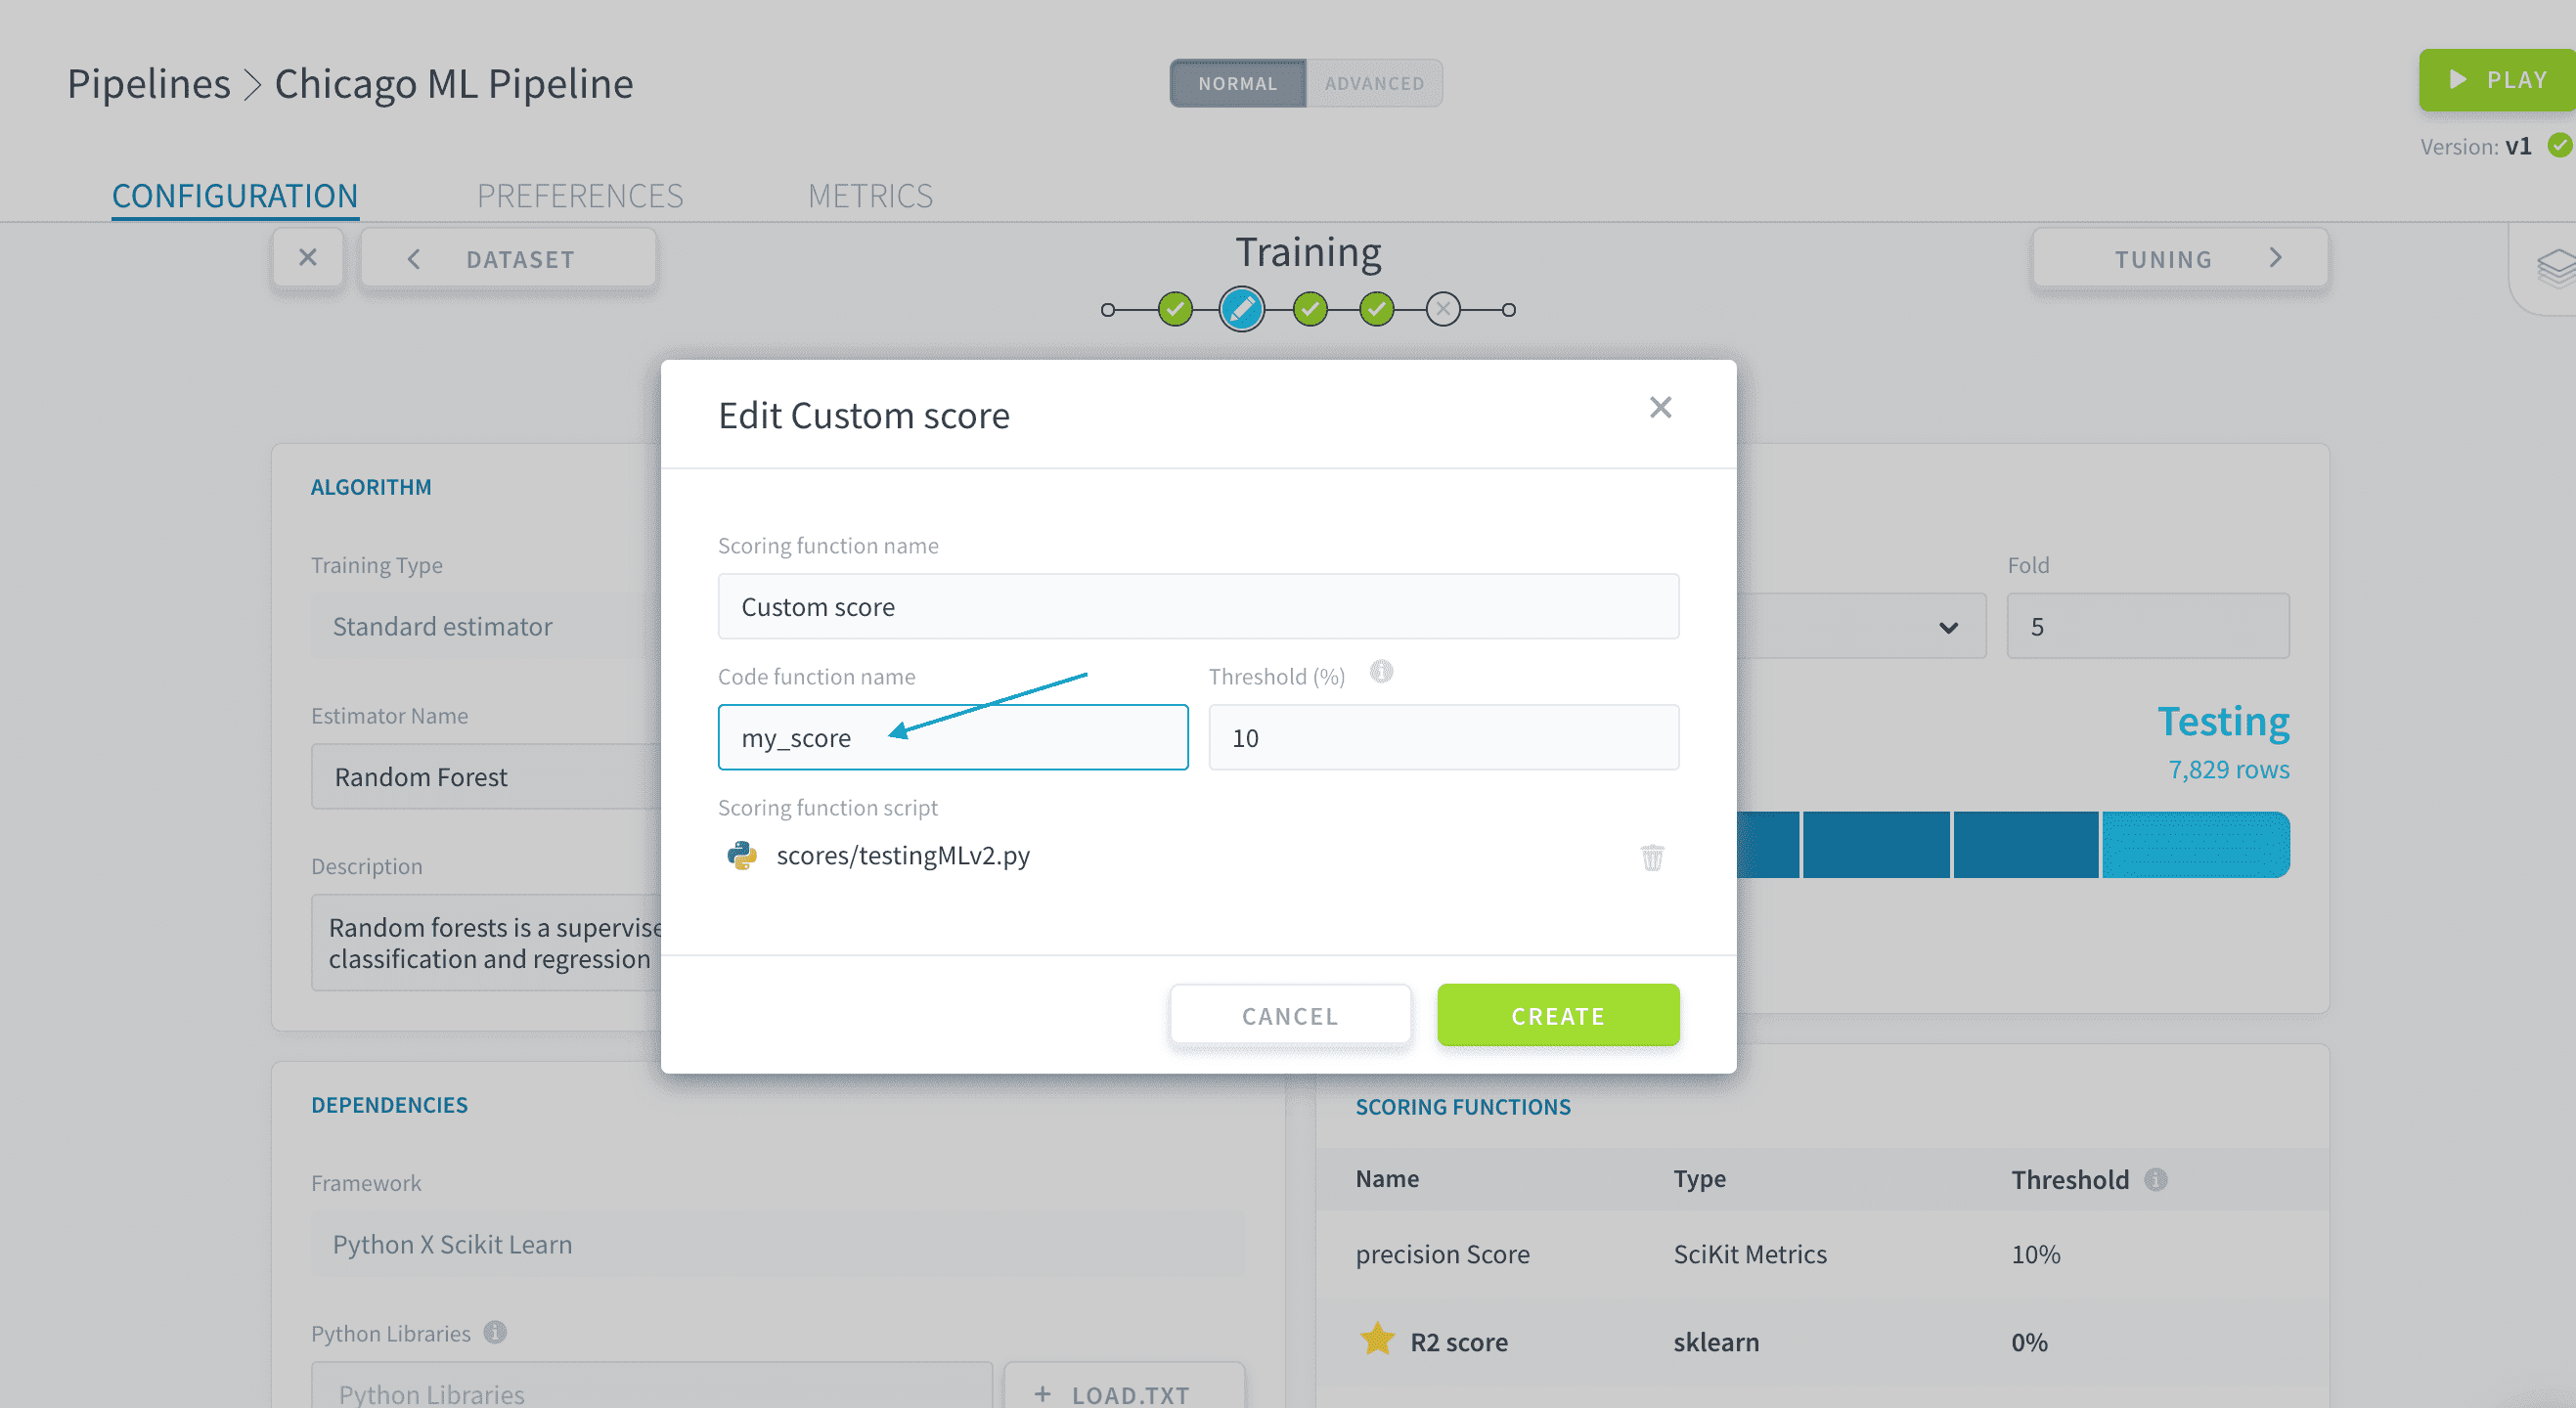
名前と閾値を入力し、専用のボックスにカスタムPythonスコアリングスクリプトをアップロードします。この.pyスクリプトには、2つの配列を受け取り、それぞれ予測値と真の値を表し、スコアを表す数値を返す関数を含める必要があります。
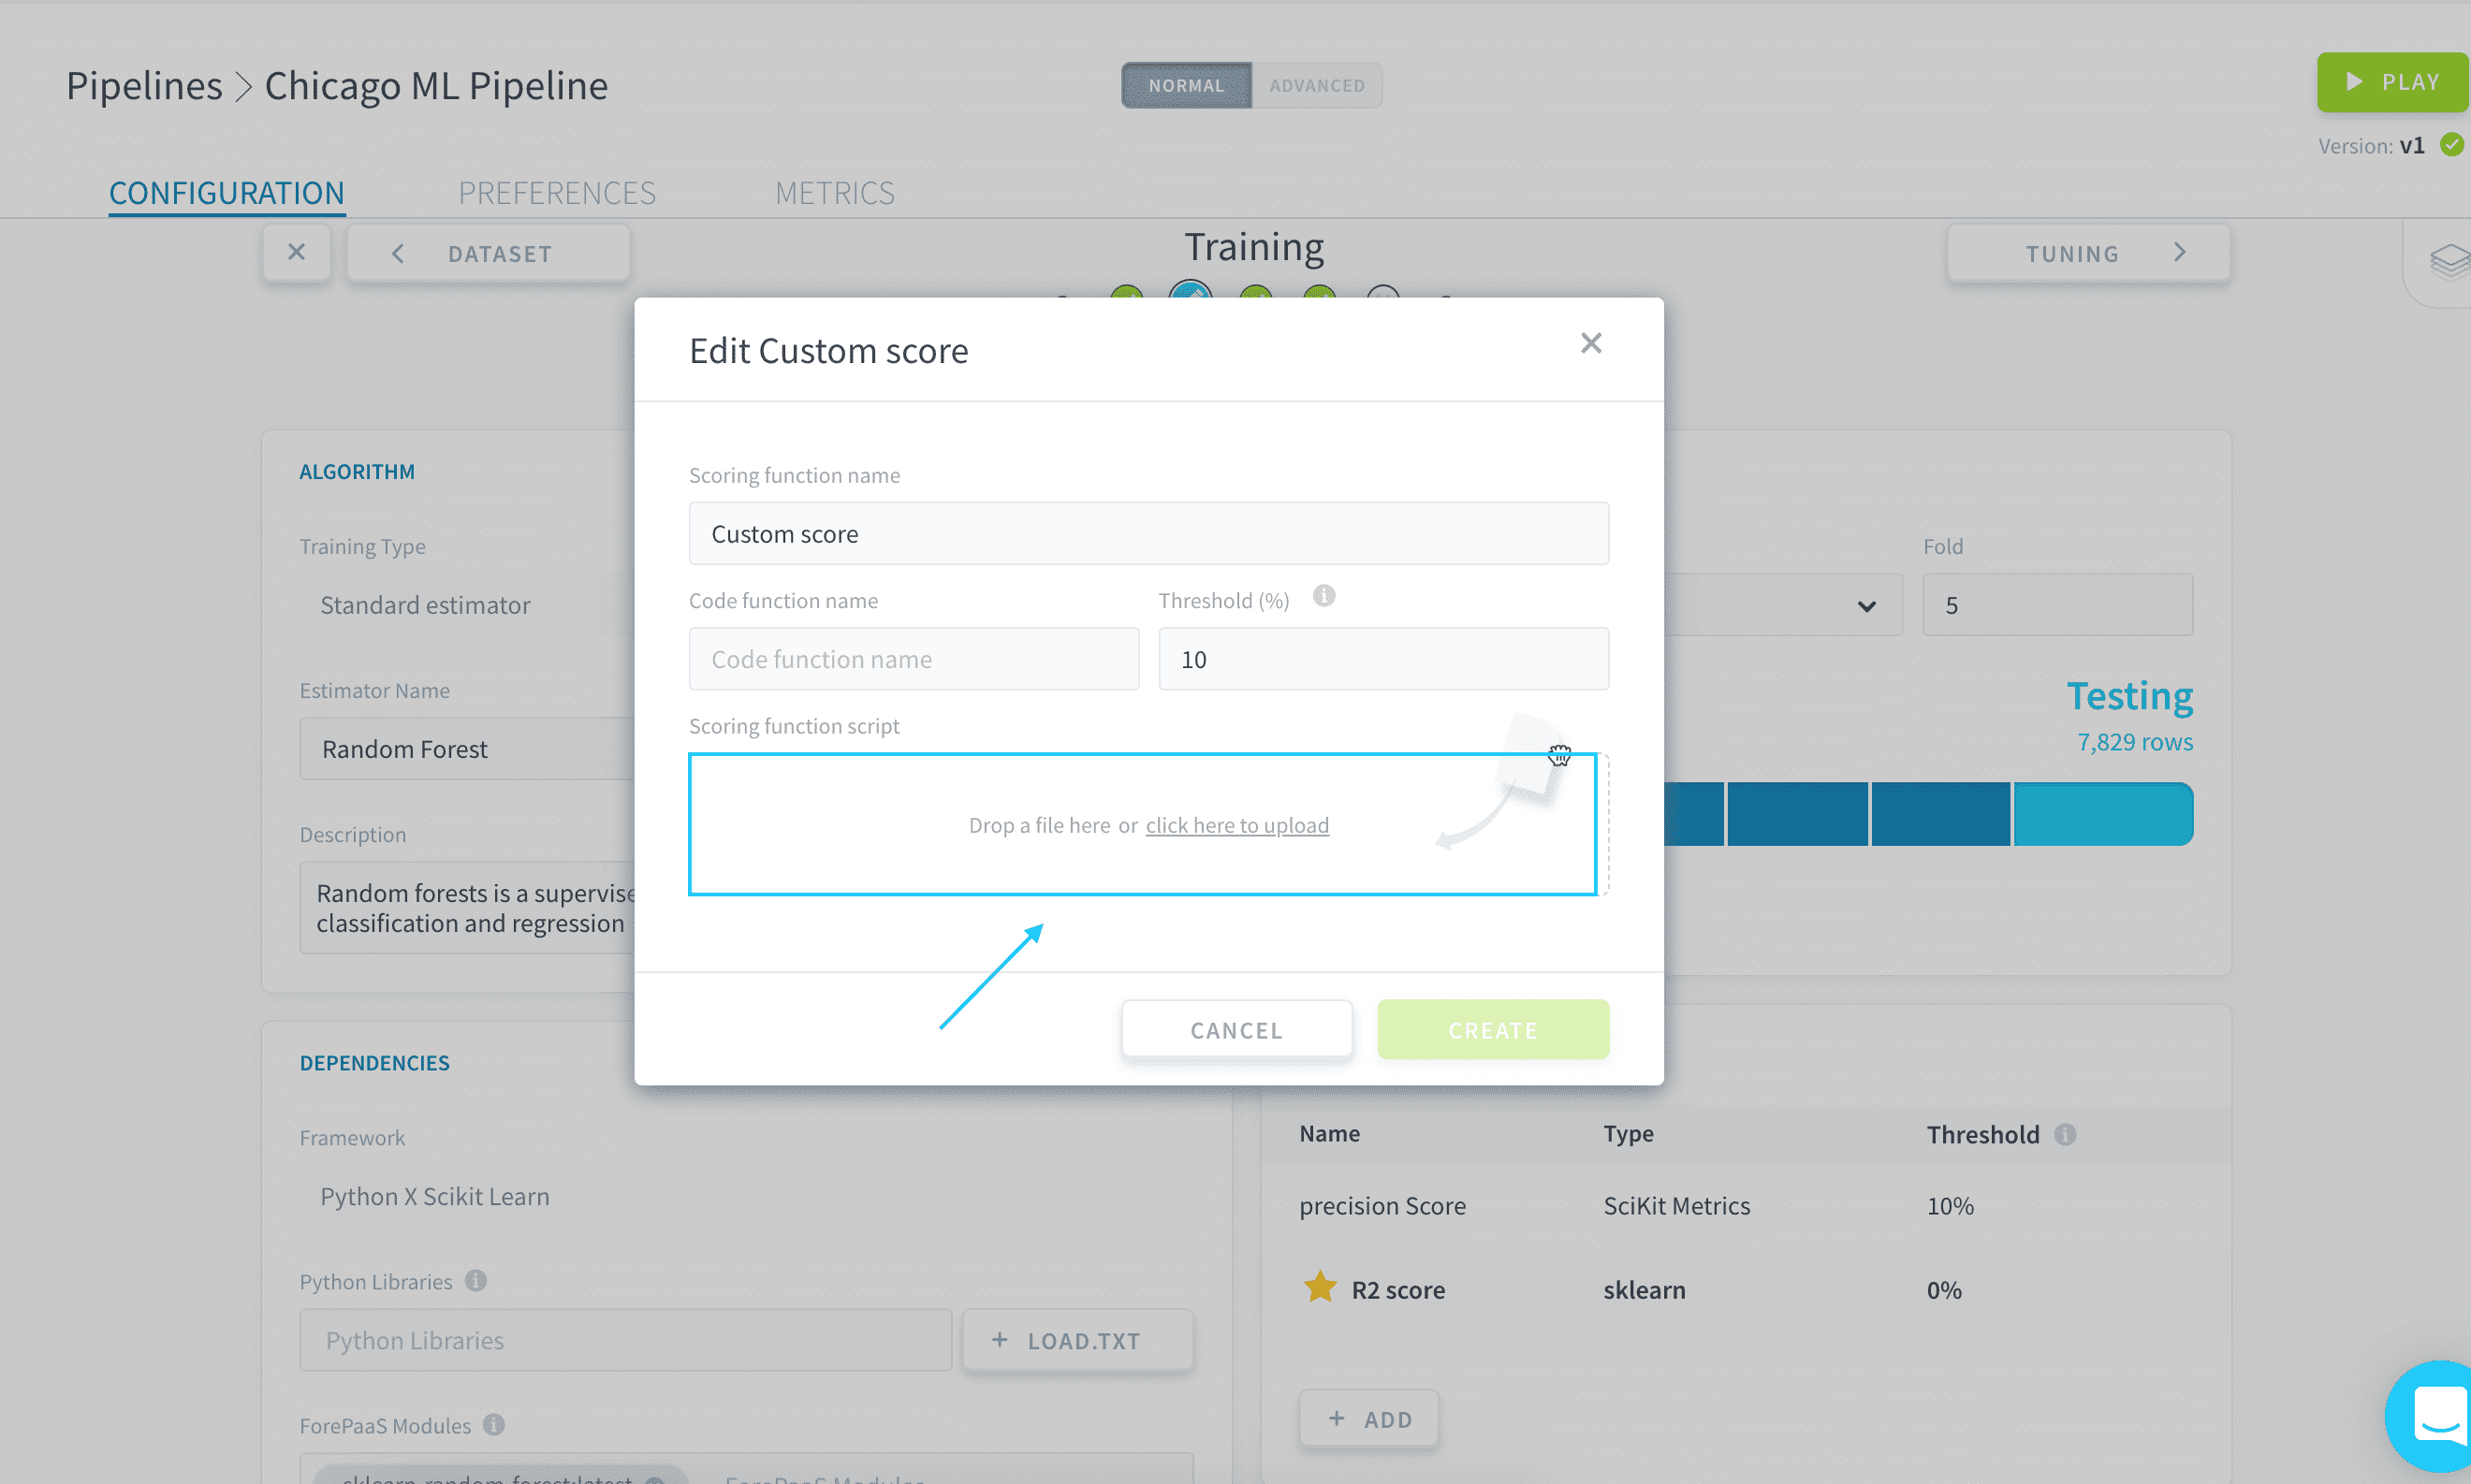
前述の関数の名前をコード関数名に記入します:
カスタムスクリプトテンプレート
以下はカスタムスコアリングスクリプトのテンプレートです:
さらに詳しく知る
ソリューションの実装に関するトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして見積もりを受け取り、プロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼してください。
Data Platformの構築チームと直接質問し、フィードバックを共有し、交流するには、専用のDiscordチャンネルにアクセスしてください。
OVHcloudサービスに関するサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。