

分割大規模ジョブを分割する
Data Processing Engine でアクションを実行する際は、処理されるデータ量について考慮することが重要です
目的
データ処理エンジンでアクションを実行する際には、処理されるデータ量を考慮することが重要です。大量のデータの場合、ワーカーの最大コンピューティングパワーに達するリスクがあります。これらのアクションを処理するためには、アクションの実行を複数の小さなタスクに分割することができます。この分割されたワークロードは、複数のワーカー間で並列に共有することができます。
セグメンテーションのオプションは、データワークロードをどのように分割するかを指定するためのものです。実行は複数のタスクに分割され、各タスクは一度に小さな値のセットを管理します。
セグメンテーションのオプションは、慎重に設定してください。セグメンテーションの選択によって、アクションの速度が大幅に向上する場合もあれば、低下する場合もあります。
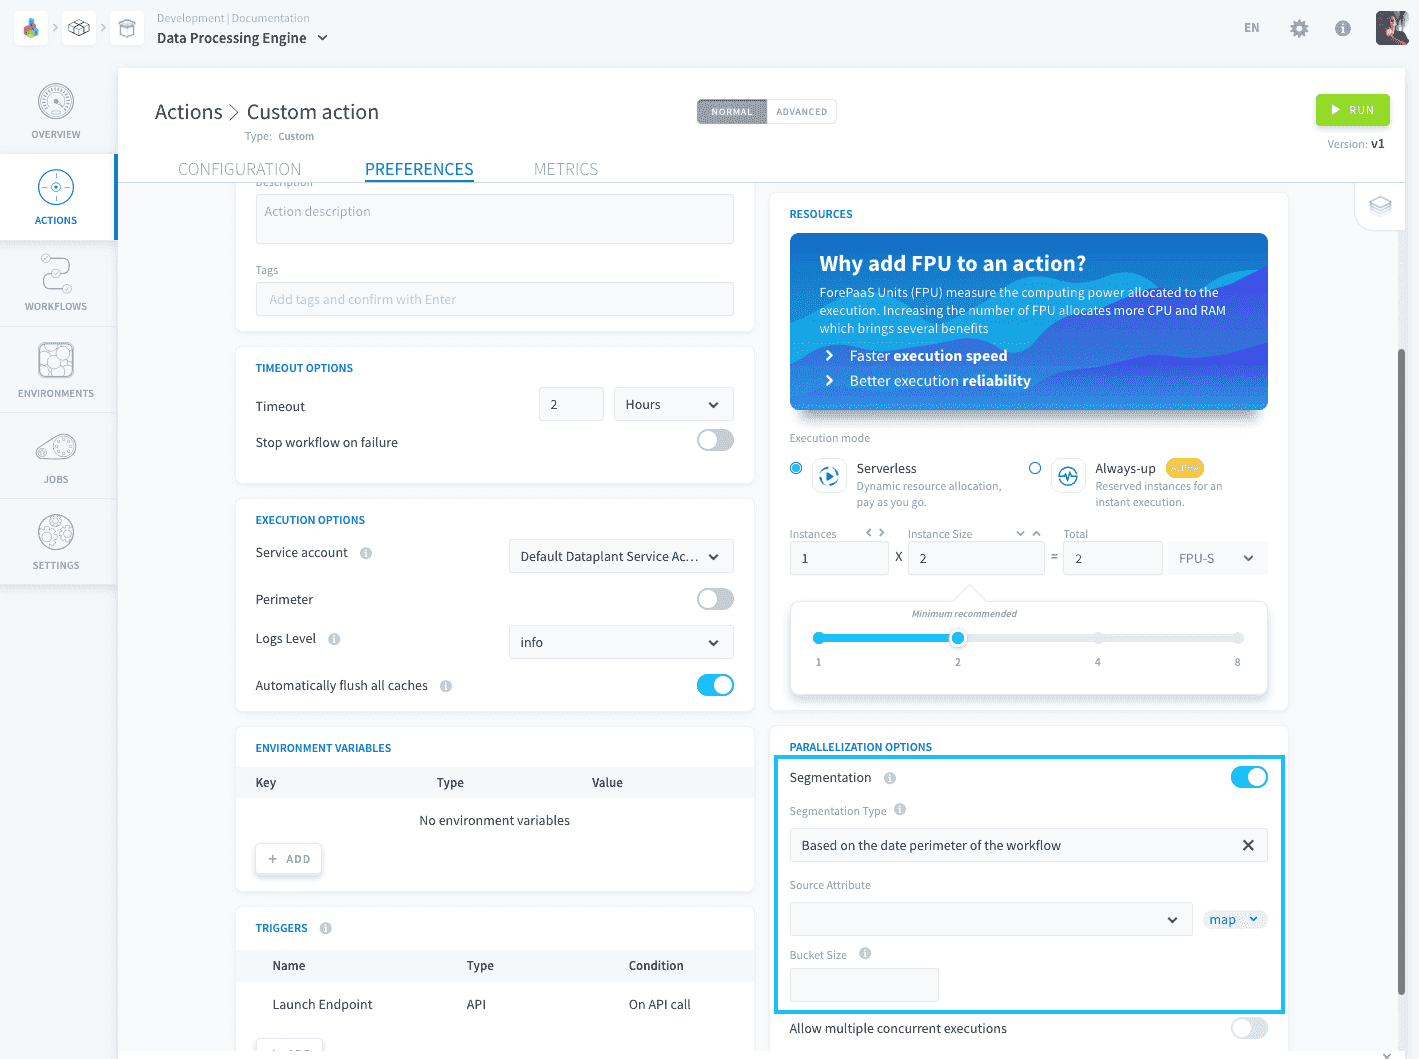
プラットフォーム内では、データソースや使用するアクションの種類によって、複数のセグメンテーションモードが利用可能です。
2. ワークフローの日付範囲に基づく
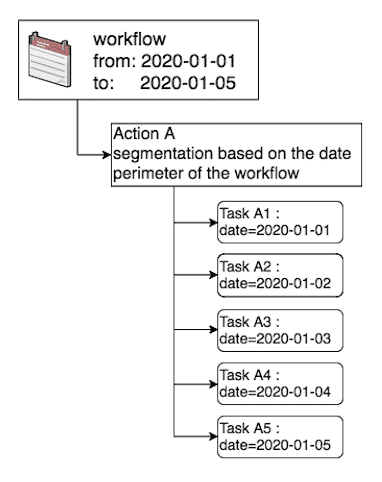
ソースデータに日付属性が含まれている場合、アクションを別々のプロセスに分割し、特定の日付または日付のグループ(バケット)に対して個別に処理することが可能です。この場合、各タスクは抽出が必要な日付に対してフィルタを適用します。
互換性
このセグメンテーションオプションは、以下のアクションおよびソースとのみ互換性があります:
バケットサイズ
ソースに多くの日付が含まれている場合、多くの小さなタスクが生成され、アクションの実行時間に特に有益ではない場合があります。これは、ミリ秒単位の時間情報を記録できるdatetime型の属性を扱う場合に特に一般的です。
タスクを過剰に生成しないようにするために、1つのタスクで複数の日付を管理できるようにするには、「バケットサイズ」オプションを使用できます。バケットのサイズを設定するだけで、1回のタスクで管理したい日付の数を決定できます。デフォルトの「バケットサイズ」値は1です。つまり:
- バケットサイズを設定しない場合、各タスクは1つの日付を処理します
- バケットサイズを2に設定した場合、各タスクは2つの日付を処理します
- バケットサイズを10に設定した場合、各タスクは10つの日付を処理します
- そして、そのように続きます...
「バケットサイズ」がどのような役割を果たすのかまだ不明な場合は、「バケットサイズリファレンス」でさらに詳しくご確認ください。
構成
このセグメンテーションオプションを設定するには、「セグメンテーションタイプ」のドロップダウンからワークフローの日付範囲に基づくを選択し、属性を選択してください。
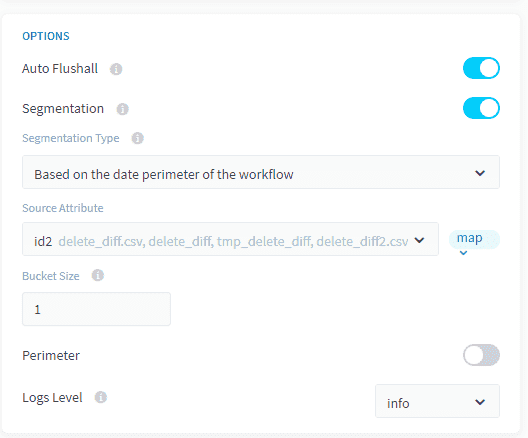
エキスパートモードインターフェースを使用している場合、アクションのJSON設定に以下のフィールドを追加する必要があります。
この種類のセグメンテーションをさらに深く学ぶためのチュートリアルシリーズ
3. プロジェクトテーブルの属性に基づく
このオプションは、データモデル内の指定されたテーブル(通常はリファレンステーブル)の列に含まれる値のリストを使用して、アクションをセグメント化することを可能にします。例えば、以下のケースを考えてみましょう。ソーステーブル「orders」から宛先テーブル「aggr_date」へデータを読み込むアクションのセグメンテーションオプションを設定しようとしている場合です。
| リファレンステーブル | ソーステーブル | 宛先テーブル |
|---|---|---|
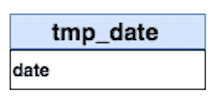 | 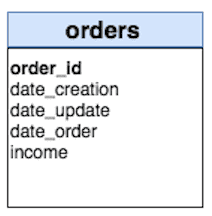 | 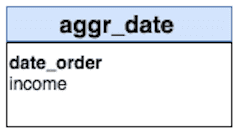 |
仮に、注文日「date_order」ごとに「income」データを集計したいとします。例えば、「tmp_date」テーブルは、注文が行われたすべての日付の参照テーブルとして機能し、例えば2019-01-01から2019-01-03までの日付のリストを含んでいるとします。
このセグメンテーションモードを有効にすると、アクションを含むメインステージに対して自動的にプレステージが生成されます。このプレステージには、アクションを別々のタスクに分割するための利用可能な日付の一意のリストが含まれます。以下の図に示すようにです:
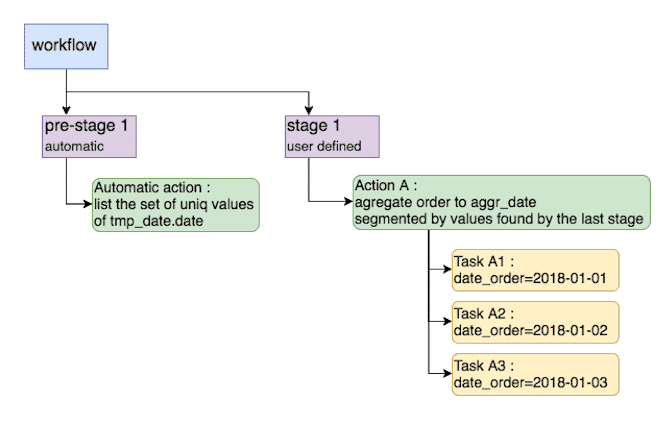
このようにすることで、ソーステーブル「orders」のデータが、1日ずつデスティネーションテーブル「aggr_date」に読み込まれます。
互換性
このセグメンテーションオプションは、以下のアクションおよびソースとのみ互換性があります:
バケットサイズ
ソースにセグメンテーションに使用する属性内に大量のユニークな値が含まれている場合、多数の小さなタスクが生成され、アクションの実行時間に特に有益ではない可能性があります。
タスクが過剰に生成されないようにするために、1つのタスクでセグメンテーション属性の複数の値を管理できるようにするには、「バケットサイズ」オプションを使用できます。バケットのサイズを設定して、タスクが一度に管理する値の数を決定します。デフォルトの「バケットサイズ」値は1です。つまり、
- バケットサイズを設定しない場合、各タスクは1つの値を処理します
- バケットサイズを2に設定した場合、各タスクは2つの値を処理します
- バケットサイズを10に設定した場合、各タスクは10つの値を処理します
- そして、そういった具合です...
「バケットサイズ」がどのような役割を果たすのかまだ不明な場合は、「バケットサイズのリファレンス」でさらに詳しくご確認ください。
構成
このセグメンテーションオプションを設定するには、「セグメンテーションの種類」のドロップダウンから プロジェクトテーブルの属性に基づく を選択してください。
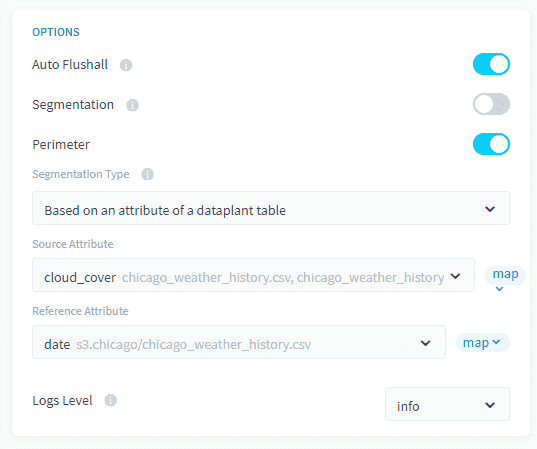
専門家モードのインターフェースを使用している場合、アクションのJSON設定に以下のフィールドを追加する必要があります。
この種類のセグメンテーションをさらに深く学ぶためのチュートリアルシリーズ
3. 事前定義されたセットに基づく
このモードを使用して、セグメンテーション基準としてハードコードされた値のセットを使用します。そのためには、セグメンテーションを適用するソーステーブルの列を選択し、値のセットを手動で入力する必要があります。各入力値に対して、タスクが生成されます(バケットサイズが1に設定されている場合)。
互換性
このセグメンテーションオプションは、次のアクションとソースのみと互換性があります。
バケットサイズ
セグメンテーションに使用される属性内に多くのユニークな値がソースに含まれている場合、多くの小さなタスクが生成され、アクション実行時間に特に有益ではない可能性があります。
多くのタスクを生成するのを避けるために、「バケットサイズ」オプションを使用して、各タスクがセグメンテーション属性の複数の値を一度に処理できるようにすることができます。バケットのサイズを設定して、一度に処理したい値の数を決定します。デフォルトの「バケットサイズ」値は1です。つまり:
- バケットサイズを設定しない場合、各タスクは1つの値を処理します。
- バケットサイズを2に設定した場合、各タスクは2つの値を処理します。
- バケットサイズを10に設定した場合、各タスクは10つの値を処理します。
- そして、そういった具合です...
「バケットサイズ」が何をするのかまだ不明な場合は、バケットサイズリファレンスでさらに詳しく知ることができます。
構成
このセグメンテーションオプションを構成するには、「セグメンテーションタイプ」ドロップダウンから事前定義されたセットに基づくを選択します。
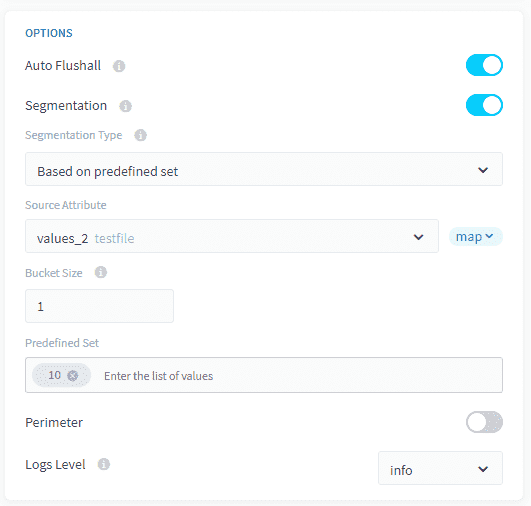
エキスパートモードインターフェースを使用している場合は、アクションJSON構成に次のフィールドを追加する必要があります。
この種類のセグメンテーションについてさらに詳しくなるためのチュートリアルシリーズ
4. 固定行数に基づく
このセグメンテーションモードを使用すると、バケットサイズ変数で定義された固定行数を使用して、ソースからのデータの読み込みを分割できます。
各タスクは「バケットサイズ」に等しい特定の行数を処理します。
- バケットサイズが1000に設定されている場合、各タスクは1000行を抽出します。
- バケットサイズが50000に設定されている場合、各タスクは50000行を抽出します。
- など...
互換性
このセグメンテーションオプションは、次のアクションとソースのみと互換性があります。
構成
このセグメンテーションオプションを構成するには、「セグメンテーションタイプ」ドロップダウンから固定行数に基づくを選択します。
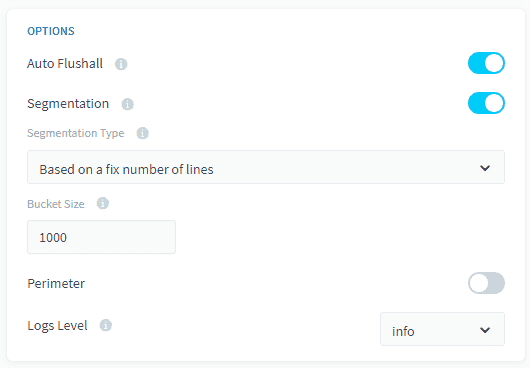
エキスパートモードインターフェースを使用している場合は、アクションJSON構成に次のフィールドを追加する必要があります。
このセグメンテーションタイプは、SQLServer、PostgreSQLなどのデータベースソースで使用できます。ただし、この場合、プロジェクトがテーブルのすべての属性へのアクセス権を付与されていることを確認してください。そうしないと、アクションをセグメント化しようとした際に、権限不足のためにSELECTクエリが拒否される可能性があります。
この種類のセグメンテーションについてさらに詳しくなるためのチュートリアルシリーズ
5. ソースのアカウントに基づく
sourcesのようなユーザーアカウント固有のソース(例:SNS)の場合、Connectors内で同じソースに対して複数のアカウントを構成できます。その後、これらのアカウントを利用して、そのソースを使用するDPEアクションを複数のタスクに分割できます。各タスクは1つまたは複数のアカウントからデータを取得します。
互換性
このセグメンテーションオプションは、次のアクションとソースのみと互換性があります。
バケットサイズ
ソースに多くのアカウントが含まれている場合、多くの小さなタスクが生成され、アクション実行時間に特に有益ではない可能性があります。
多くのタスクを生成するのを避けるために、「バケットサイズ」オプションを使用して、各タスクが一度に複数のアカウントを処理できるようにすることができます。バケットのサイズを設定して、一度に処理したいアカウントの数を決定します。デフォルトの「バケットサイズ」値は1です。つまり:
- バケットサイズを設定しない場合、各タスクは1つのアカウントを処理します。
- バケットサイズを2に設定した場合、各タスクは2つのアカウントを処理します。
- バケットサイズを10に設定した場合、各タスクは10つのアカウントを処理します。
- そして、そういった具合です...
「バケットサイズ」が何をするのかまだ不明な場合は、バケットサイズリファレンスでさらに詳しく知ることができます。
構成
このセグメンテーションオプションを構成するには、「セグメンテーションタイプ」ドロップダウンからワークフローの日付範囲に基づくを選択します。
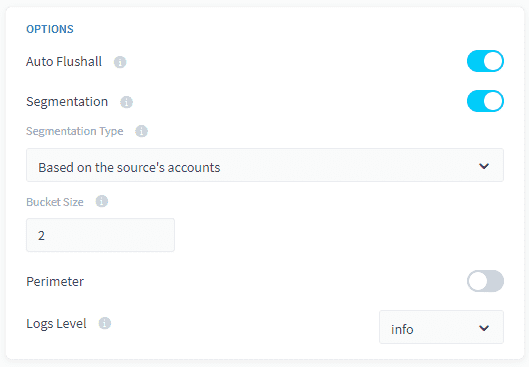
エキスパートモードインターフェースを使用している場合は、アクションJSON構成に次のフィールドを追加する必要があります。
この種類のセグメンテーションについてさらに詳しくなるためのチュートリアルシリーズ
6. ファイルに基づく
遠隔ソースフォルダ内の同じ構造を持つソースの場合、このセグメンテーションモードを使用すると、DPEがフォルダ内のすべてのファイルを自動的に見つけ、特定のファイル数を持つタスクを作成できます。各ファイルの「load_from.source」アクションでソースファイルを置き換えます。
互換性
このセグメンテーションオプションは、次のアクションとソースのみと互換性があります。
バケットサイズ
ソースに多くのファイルが含まれている場合、多くの小さなタスクが生成され、アクション実行時間に特に有益ではない可能性があります。
多くのタスクを生成するのを避けるために、「バケットサイズ」オプションを使用して、各タスクが一度に複数のファイルを処理できるようにすることができます。バケットのサイズを設定して、一度に処理したいアカウントの数を決定します。デフォルトの「バケットサイズ」値は1です。つまり:
- バケットサイズを設定しない場合、各タスクは1つのファイルを処理します。
- バケットサイズを2に設定した場合、各タスクは2つのファイルを処理します。
- バケットサイズを10に設定した場合、各タスクは10つのファイルを処理します。
- そして、そういった具合です...
「バケットサイズ」が何をするのかまだ不明な場合は、バケットサイズリファレンスでさらに詳しく知ることができます。
構成
このセグメンテーションオプションを構成するには、「セグメンテーションタイプ」ドロップダウンからファイルに基づくを選択します。
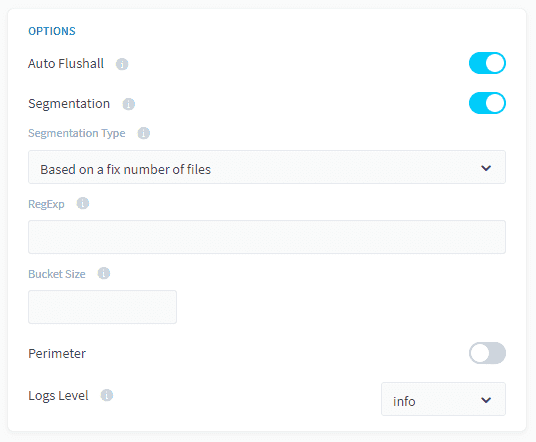
エキスパートモードインターフェースを使用している場合は、アクションJSON構成に次のフィールドを追加する必要があります。
この種類のセグメンテーションについてさらに詳しくなるためのチュートリアルシリーズ
7. 自動セグメンテーション
このオプションを使用すると、セグメンテーション設定の構成を心配する必要がありません。自動的に構成されます。ただし、このオプションはすべてのデータソースまたはすべてのアクションタイプで利用可能ではありません。
以下に、サポートされているアクションのサポートされているデータソースのリストおよびジョブに設定するワーカーの数についての説明を示します。
テーブルからファイルへのアクションでサポートされているデータソース
- PostgreSQL: ワーカーの最大数に制限はありません。
ロードアクションでサポートされているデータソース
- Apache Kafka: トピックパーティションごとに最大1つのワーカー。
自動セグメンテーションを有効にするには、インスタンス数を増やす必要があります。 インスタンス数を最大ワーカー数に許可されている数まで増やすことができます。 例えば、ロードアクションのKafkaトピックに3つのパーティションがある場合、そのアクションには最大3つのワーカーを設定できます。 インスタンス数を3未満に設定した場合、例えば2つに設定した場合、ワーカーの1つが2つのパーティションを処理します。 これはリソース構成で設定され、コンピューティングパワーを水平にスケーリングすることでインスタンス数を増やすことができます。
DPEアクションのセグメンテーションおよびペリメーターオプションについての追加情報は、DPEアクション設定の追加リマーク記事を参照してください。
さらに詳しく
当社のソリューションのトレーニングや技術的な実装についての支援が必要な場合は、営業担当者にお問い合わせください、またはプロフェッショナルサービスページをご覧ください。見積もりをリクエストして、当社の専門家にプロジェクトを分析してもらうことができます。
Data Platformの開発チームと直接質問したり、フィードバックを送信したり、交流したりするには、専用のDiscordチャネルをご利用ください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
コミュニティユーザーに参加してください。
1: S3はAmazon Technologies, Inc.の商標です。OVHcloudのサービスは、Amazon Technologies, Inc.によってスポンサーされ、推奨され、またはその他の方法で提携しているものではありません。