

事前定義された値セットに基づくセグメンテーションの概要
選択した値セットに対してアクションを実行し、同時にセグメンテーションを行うことができます
目的
選択した値セットに対してアクションを実行し、同時にセグメンテーションを行うことができます。
使用例:
- 特定のショッピングサイトやアイテムのセットに基づくセグメンテーション
- ビジネスルールAをデータセットAに対して集約アクションAで適用し、ビジネスルールBをデータセットBに対して集約アクションBで適用する
セグメンテーションの機能の動作と仕様について詳しくは、こちらのページでご確認いただけます。
必要条件
このセグメンテーションタイプを使用する前に、以下の点を確認する必要があります:
1. ソーステーブルでvar_name属性がインデックス付けされていますか?
インデックス付けされていない場合、抽出クエリが大幅に遅くなります。
2. ソースおよび宛先データベースに十分なCPUがありますか?
selectおよびinsert操作はCPU集約型です。- 例えば、データベースに1つのCPUしかない場合、6つのワーカーを同時に設定してDBMSインスタンスに対して選択と挿入を行うのは良いアイデアではありません...
一般的なルール:同時に実行される各ワーカーに対して1つのCPUが利用可能である必要があります。
3. 同じステージであまりにも多くのタスクを生成しないでください。
Data Processing Engine (DPE) が良好に動作するように、500を超えるタスクを持つステージを作成することはお勧めしません。
これは厳密な制限ではありませんが、500を超えるタスク数が増えるにつれてパフォーマンスの低下が観察されることがあります。 タスク数を減らすには、バケットサイズを大きく設定し、各タスクがより多くの値を管理できるようにすることができます(つまり、最終的にはタスク数が少なくなります)。
互換性
このセグメンテーションオプションは、以下のアクションとソースとのみ互換性があります:
このタイプのセグメンテーションの使用方法
以下は、表示モードと高度なJSONモードの間のクイックビューです。
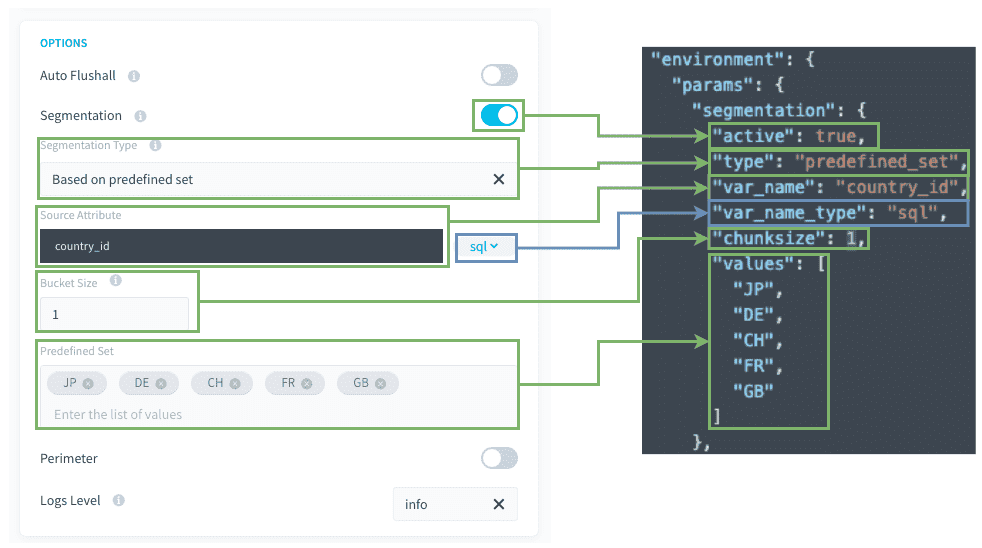
ソースの属性 / var_name: ソースのフィルタリングに使用されるSQL属性。
バケットサイズ / Chunksize: 各タスクでフィルタリングする値の数。
事前定義されたセット / values: フィルタリングするためのハードコードされた値のセット。
その他のヒント
SQL式を使用できます
segmentation.var_name(属性の最後の部分)では、DBMSと互換性のあるSQL式を使用できます。DBMSは時間の経過とともに変化する可能性があるため、SQL式を使用する場合は、再確認して修正する必要がある場合があります。
例えば、以下のような場合があります:
背景でどのように動作しますか?
このセグメンテーションモードは、プロジェクトテーブルの属性に基づくセグメンテーションと同じように動作します。唯一の違いは、値が設定に既に設定されていることであり、Lakehouse Managerテーブル属性ではなく、プレステージが必要ないことです。
さらに詳しく
当社のソリューションのトレーニングや技術的なサポートが必要な場合は、営業担当者にお問い合わせください、またはプロフェッショナルサービスページをご覧ください。見積もりをリクエストして、当社の専門家にプロジェクトを分析してもらいます。
Data Platformを構築するチームと直接質問し、フィードバックを共有し、交流するには、専用のDiscordチャネルをご利用ください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
コミュニティに参加してください。