

For AI agents: the complete documentation index is available at https://docs.dataplatform.ovh.net/ja/llms.txt, the full documentation bundle is available at https://docs.dataplatform.ovh.net/ja/llms-full.txt, and this page is available as Markdown at https://docs.dataplatform.ovh.net/ja/dpe-actions-custom.md.
  • 🇯🇵 日本語
  • カスタムアクションを使用してカスタムPythonスクリプトを実行する

    この記事では、Data PlatformのPythonデータ処理エンジンを使用するアクションについて説明します。Apache Sparkクラスターを使用する場合は、Custom PySpark actionを参照してください

    目的

    Info

    この記事では、Data PlatformのPythonデータ処理エンジンを使用するアクションについて説明します。Apache Sparkクラスターを使用するには、Custom PySpark actionを参照してください。

    カスタムアクション は、スケーラブルなクラウドクラスタ環境でカスタムPythonスクリプトを実行することを可能にします。

    当社のSoftware Development Kit (SDK)を使用して、プラットフォームのさまざまなコンポーネントと簡単にやり取りすることができます。 カスタムアクションを使用すると、以下のようなさまざまなユースケースを実装できます。

    • データウェアハウス上で操作アルゴリズムまたはETLジョブを実行する
    • 単純なデータ分析または機械学習アルゴリズムを実行する
    • Data Platform マーケットプレイスにないデータソースからデータを抽出するために、コネクタを作成する必要がありません
    • リアルタイムデータ(MQTT、Kafkaなど)を抽出する
    Info

    カスタムアクションは、Data Processing Engineの機能セット全体を活用できます。例えば、アルゴリズムの実行を並列化するためのセグメンテーションの力や、即時またはスケジュールに基づいてトリガーされるワークフロー内でのオーケストレーションなどです。

    カスタムアクションの設定

    プロジェクトのData Processing Engineで、新しいアクションボタンをクリックします。アクションの種類としてカスタムを選択します。
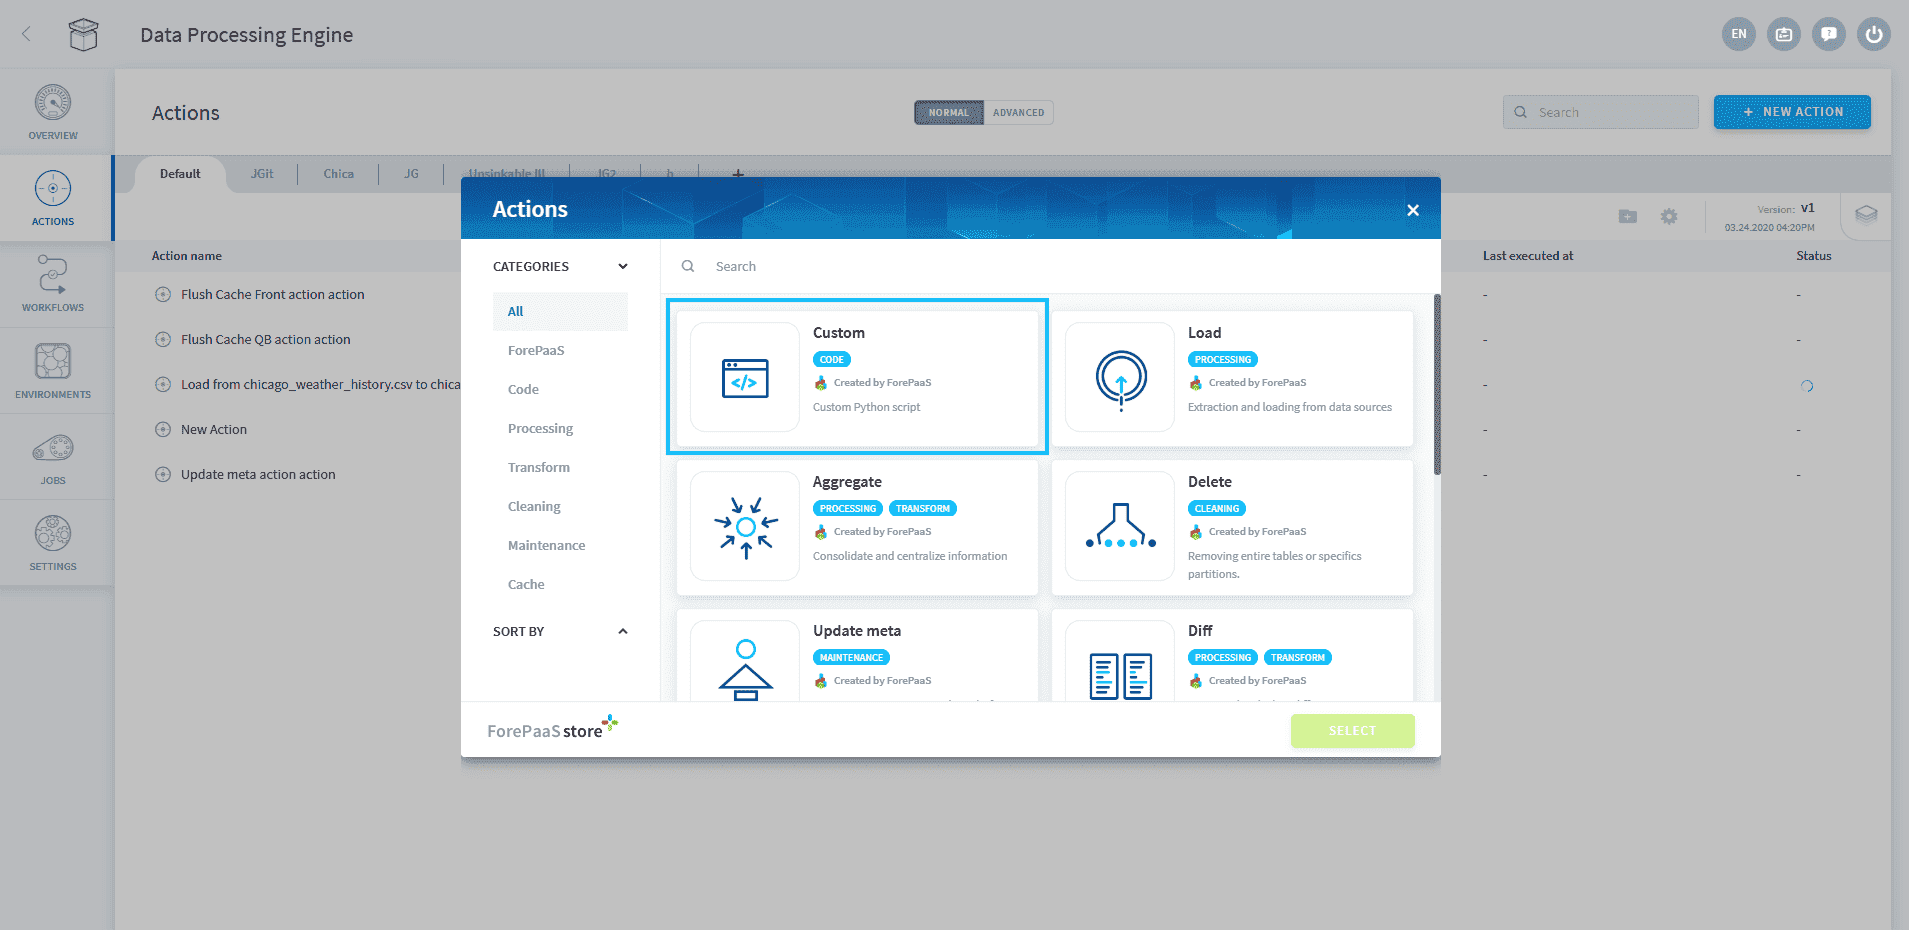
    カスタムアクションの作成画面

    .pyスクリプトを「ドラッグ&ドロップ」セクションにドラッグ&ドロップしてください。 または、ボイラープレートから開始オプションを選択して、プラットフォームのPythonインターフェースでサンプルコードスニペット付きで直接開始できます。
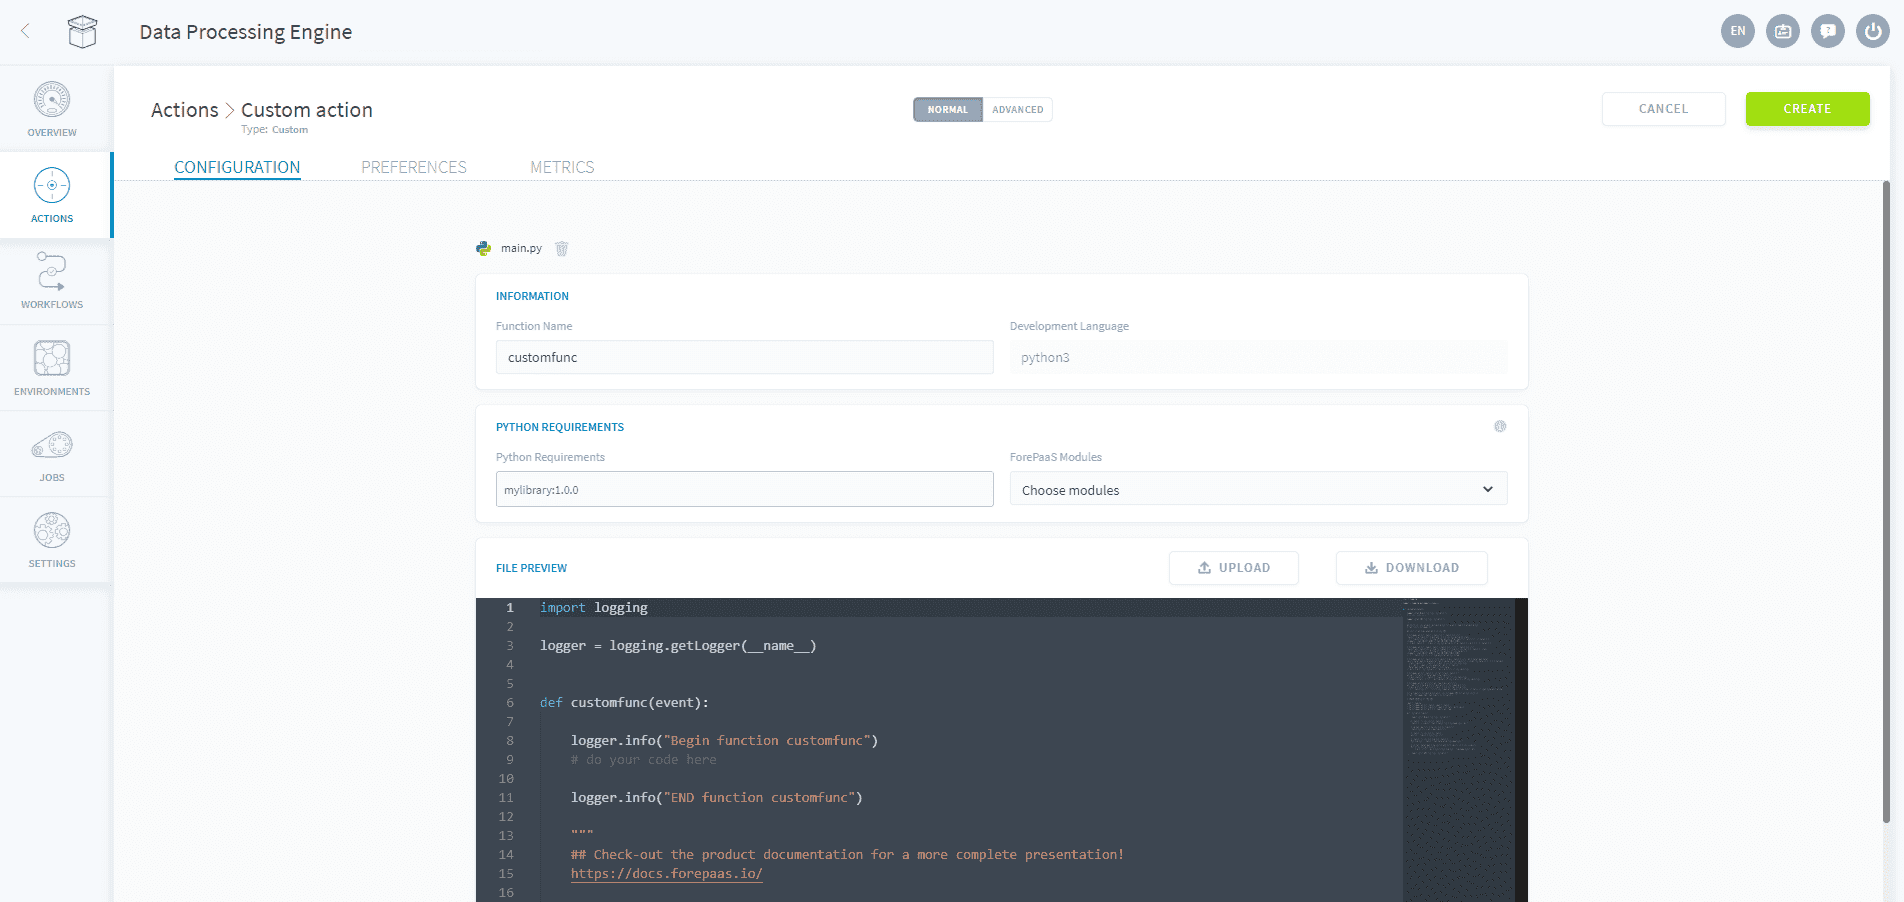
    カスタムアクションの作成画面

    関数を実行する名前は、手動で入力する必要があります 画面の上部にある情報パネル(こことデフォルトで:「customfunc」)に。

    ソースファイルを編集インターフェース上で直接編集するか、必要に応じて新しいファイルをドロップすることができます。独自のアクションを開発する際には、Software Development Kit (SDK)で提供されている機能を使用して、プラットフォームの他のコンポーネントと簡単に相互作用することができます。

    すべての利用可能なSDK機能についてさらに詳しく知るには、以下の記事を参照してください:

    すべてのSDKメソッドを確認する

    Info

    スクリプトが標準出力または標準エラーに書き込むすべての内容、print()呼び出しを含むものは、loggingモジュールを通じて出力されたメッセージとともにジョブログに表示されます。

    ヘルパーパネルの使用
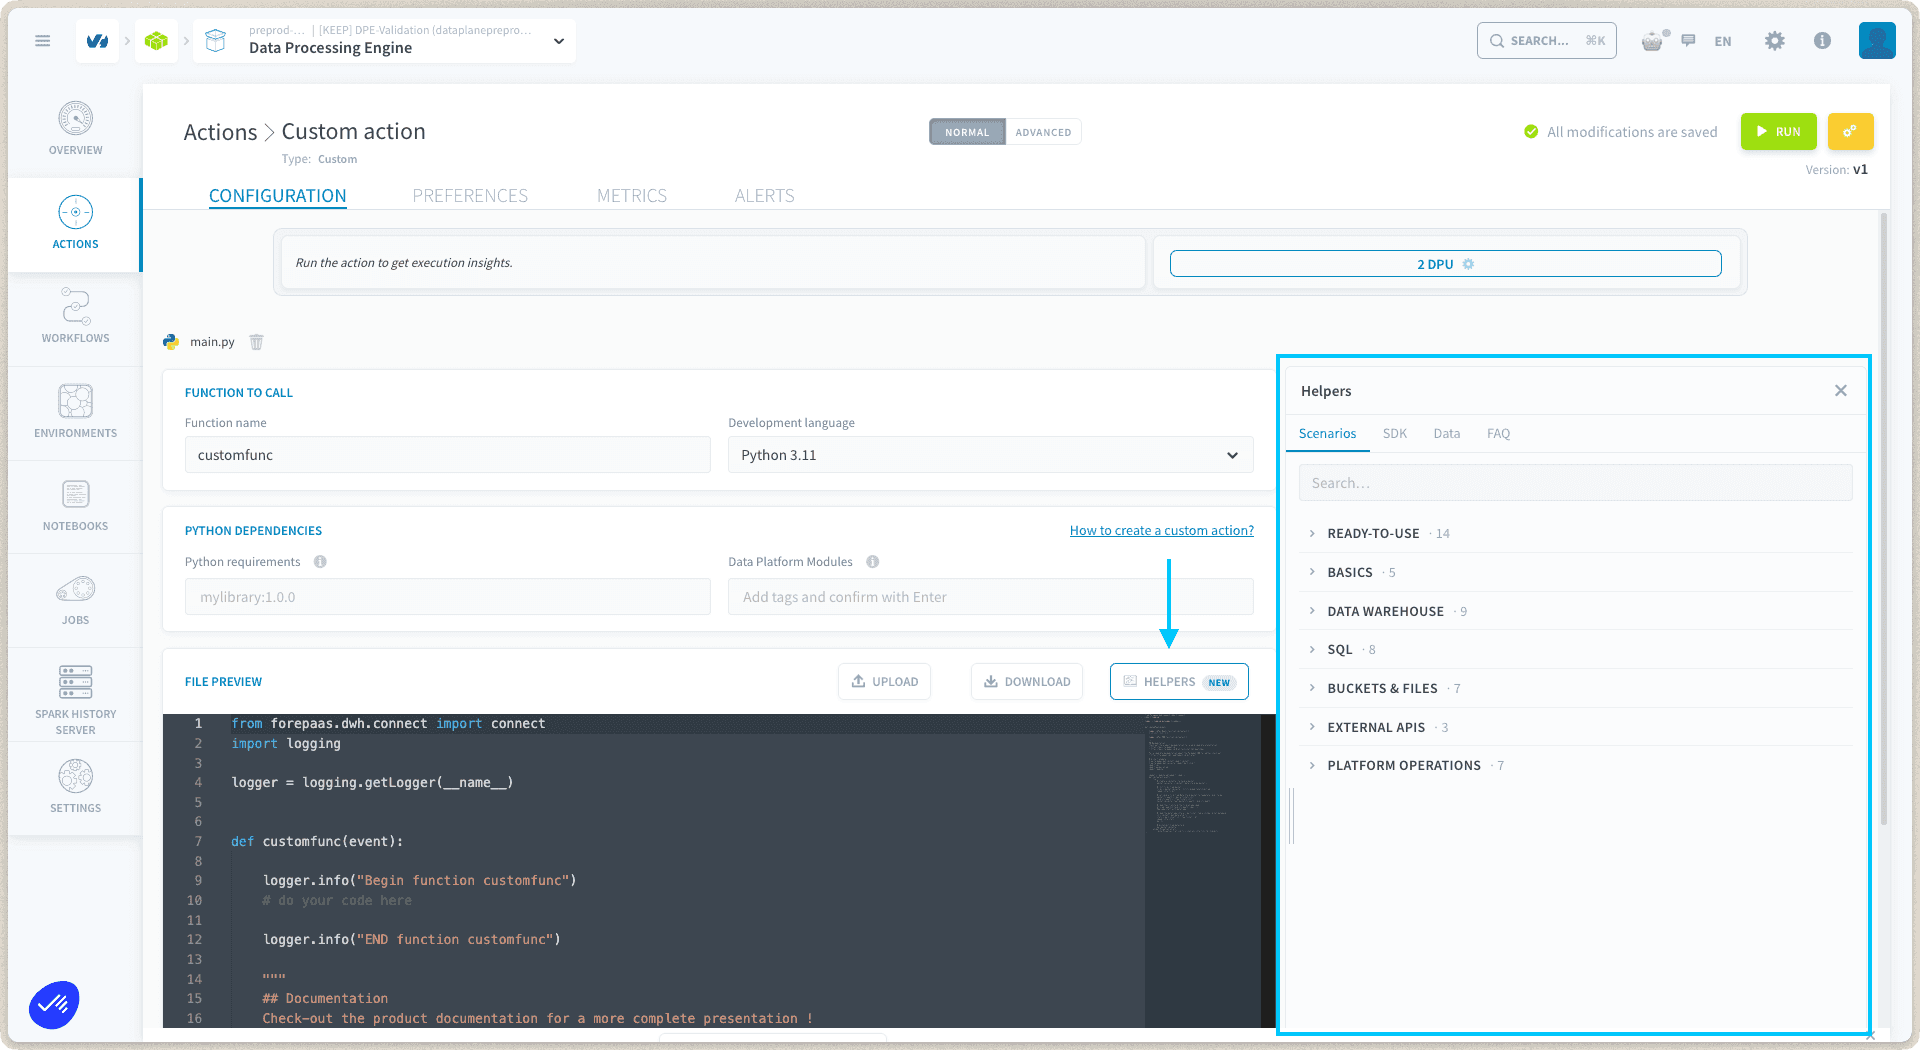
    DPE カスタムアクションヘルパー

    カスタムアクションエディタにはヘルパーパネルが含まれており、スクリプトを離れることなくガイダンスを見つけることができます。

    • シナリオ: カテゴリ別に整理された、コピーして使用する準備ができたアクションスクリプトです。
    • SDK ガイド: スクリプトから呼び出すことができる SDK メソッドのドキュメントです。
    • データ: エディタから直接プロジェクトのデータを閲覧し、コードを書く際に名前や構造を確認できます。
    • FAQ: カスタムアクションに関するよくある質問への回答です。
    Info

    ヘルパーコンテンツは、ノートブック内のData Platform Extensionを駆動するのと同じライブカタログですので、常に最新の状態です。

    依存関係の管理

    言語バージョンの設定

    カスタムアクションのPythonバージョンを以下のいずれかから選択できます:

    • Python 3.11
    • Python 3.9 (デフォルトオプション)

    -- :::info -- ワークフロー は一度に複数のバージョンで実行できません。 -- :::

    Info

    定期的に利用可能なバージョンを更新し、ベストプラクティスの開発フレームワークを提供しています。言語バージョンがサポートされている限り、既存の作業は新しいバージョンに移行されません。

    Pythonパッケージのインストール

    特定のパッケージをインストールする必要がある場合があります。デフォルトで含まれていないパッケージを追加するには、「Python Requirements」フィールドに「pip」(Pythonパッケージマネージャー)の基本的なリクエストファイルで使用される形式に従って追加してください。その後、キーボードの「ENTER」キーを押してください。

    これは、Enterキーを押した後の見た目です:
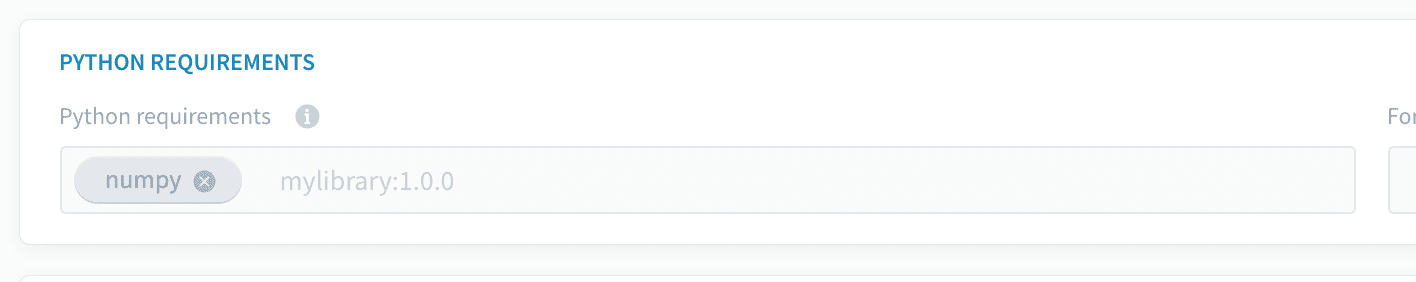
    Creation screen of a custom action
    Info

    When working with a Custom Action in an Always-up execution environment, updating dependencies triggers a redeployment of the environment to put the changes into effect.

    Gitリポジトリからのパッケージのインストール

    GitHub または GitLab のリポジトリから直接 Python パッケージをインストールするには、requirements に git+ プレフィックスを使用します。

    git+https://github.com/{OWNER}/{REPO}.git

    特定のバージョンを固定するには、タグまたはコミットハッシュを追加します。

    git+https://github.com/{OWNER}/{REPO}.git@<tag>

    最新リリースの自動インストール

    最新の公開リリースを常にインストールするには、バージョンタグを手動で追跡することなく、@latestを使用します。

    git+https://github.com/{OWNER}/{REPO}.git@latest

    プラットフォームは、git+プレフィックスと@latestサフィックスを検出し、インストールする前に自動的に最新のリリースタグを解決して置き換えます。

    Info

    Git 依存関係を追加または変更した後、Force Build をクリックして再インストールします。モジュールの新しいバージョンが公開されるたびに、タグやコミットハッシュを手動で更新する必要はありませんが、最新リリースは実行時に自動的に取得されないため、Force Build を手動で実行する必要があります。

    依存関係のデフォルトリスト

    Warning

    Data Platform は、バグ修正をインストールできるように、マイナーバージョンの更新をブロックしています。ライブラリのより新しいバージョンが必要な場合は、「Requirements」フィールドに同じパッケージを新しいバージョンで追加することで、手動で上書きすることができます。

    以下は、Data Processing Engineワーカーに同梱されているすべてのパッケージとそのバージョン(pipの要件ファイルで見つけることができるもの)のリストです:

    すべてのデフォルトPythonパッケージを確認する

    サンプルスクリプトの例

    ファイルの抽出とデフォルトデータセットへの読み込みの例

    import logging
    import sys
    from forepaas.dwh import connect
    from forepaas.dwh import bulk_insert
    
    def customfunc(event):
        logger = logging.getLogger(__name__)
        
        try:
            logger.info("Begin function")
            
            # Connect to the source connector
            connector = connect("dwh/dropbox_test/consommations.csv")
            
            # Upload raw file from the source connector
            connection_str = get_raw(connector)
            
            # Connect to the source
            source = connect(connection_str)
            
            # Connect to the destination connector
            destination = connect("dwh/default_dataset/consommations")
            
            # Extract dataframe from source and bulk insert into the destination
            for df in extract(source):
                stats, error = bulk_insert(destination, "consommations", df)
                logger.info(stats)
                logger.info(error)
            
            del connector, source, destination
            logger.info("END function")
            
        except Exception as e:
            raise Exception("err:{} L:{}".format(e, sys.exc_info()[2].tb_lineno))
    

    2つのデータセット間のデータ転送の例

    import logging
    import sys
    from forepaas.dwh import connect
    from forepaas.dwh import bulk_insert
    
    def customfunc(event):
        logger = logging.getLogger(__name__)
        
        try:
            logger.info("Begin function")
            
            # Connection to a source datastore
            connector = connect("dwh/default_dataset/consommations")
            
            # Data extraction from the source by a SELECT
            lines = connector.select("consommations", {"filter_attribute": "2018-01-01"})
            
            del connector
            
            # Treatment of each line of the data
            for line in lines:
                line["new_insight"] = (line["factor1"] + line["factor2"] * 2) / 100
            
            # Connection to the destination datastore
            connector = connect("dwh/analytics_dataset/agr_consommations")
            
            # Bulk insert into the destination
            stats, err = bulk_insert(connector, "agr_consommations", lines)
            logger.info(stats)
            logger.info(err)
            
            del connector
            logger.info("END function")
            
        except Exception as e:
            raise Exception("err:{} L:{}".format(e, sys.exc_info()[2].tb_lineno))
    

    さらに進む

    トレーニングや技術的なサポートが必要な場合は、営業担当者にお問い合わせください。または、Professional Servicesページをご覧になり、見積もりをリクエストして、専門家によるプロジェクト分析を受けてください。

    質問をする、フィードバックを提供する、および専用のDiscordチャネルを通じてData Platformを構築するチームと直接交流してください。

    サポートが必要な場合は、ヘルプセンターでリクエストを作成してください。

    当社のユーザーコミュニティにご参加ください。