

ワークフローで設定された日付範囲に基づくセグメンテーションを発見する
よくある日常的な使用方法として、Data Processing Engine (DPE) のアクションに対して、今日までのX日間のデータを管理するように要求する必要があります
目的
よくある日常的な使用方法として、Data Processing Engine (DPE) のアクションに対して、今日までのX日間のデータを管理するように要求する必要があります。
他の場合、アクションが特定の歴史的な日付セットにのみ作用するようにする必要があることもあります。 このセグメンテーションの種類は、基本的に「テーブルの属性の値に基づくセグメンテーション」と同様に動作しますが、値はワークフロー設定で設定した日付から得られるものであり、Lakehouse Manager テーブルから得られるものではありません。
使用例
- ソースからデータを取得する(X日前から今日まで)(日次相対日付の使用)
- ソースからデータを2つの正確な日付の間で取得する(歴史的なデータの取得、ワンショット使用)
- 集計テーブルを2つの日付の間のみ再計算する(日次相対日付の使用またはワンショット使用)
ソースデータに日付属性が含まれている場合、アクションを個別のプロセスに分割し、各プロセスが特定の日付または日付グループに対して個別にアドレスを指定できるようにすることができます。 この場合、各タスクは抽出する必要がある日付に対してフィルタを適用します。
セグメンテーションの実際の製品ドキュメントページは、機能の動作と仕様を詳しく説明していますこのページでご覧いただけます。
必要条件
このセグメンテーションの種類を使用する前に、いくつかの点を確認する必要があります:
1. ソーステーブルでvar_name属性がインデックス付けされていますか?
そうでない場合、抽出クエリは大幅に遅くなります。
2. ソースおよび宛先データベースに十分なCPUがありますか?
selectおよびinsert操作はCPU集約的であることを覚えておいてください。- 例えば、データベースにCPUが1つしかない場合、6つのワーカーを同時に設定してDBMSインスタンスに対して選択と挿入を行うのはおそらく良いアイデアではありません...
一般的なルール:同時に実行される各ワーカーに対して1つのCPUが利用可能である必要があります。
3. 同じステージであまりに多くのタスクを生成しないでください。
Data Processing Engine (DPE) のパフォーマンスを維持するために、500タスクを超えるステージを設定しないことをお勧めします。
これは厳密な制限ではありませんが、この閾値を超えるとパフォーマンスの劣化が観察されることがあります。 タスク数を減らすには、バケットサイズを大きく設定し、各タスクがより多くの値を管理できるようにすることができます(つまり、最終的にはタスクが少なくなります)。
互換性
このセグメンテーションオプションは、次のアクションとソースのみと互換性があります:
この種類のセグメンテーションの使用方法
以下に、表示モードと高度なJSONモードの違いを簡単に説明します。
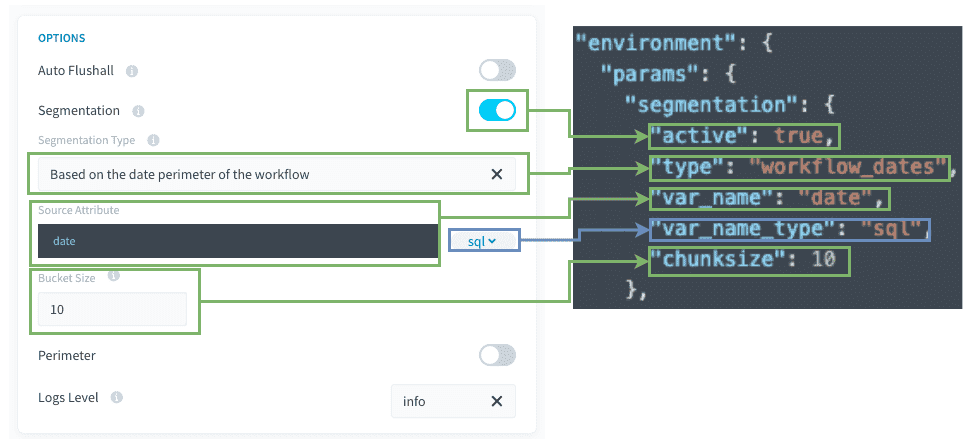
ソースの属性 / var_name: ソースのフィルタリングに使用されるSQL属性。
バケットサイズ / Chunksize: 各タスクでフィルタリングする値の数。
その他のヒント
SQL式を使用できます
segmentation.var_name(属性の最後の部分)では、DBMSと互換性のあるSQL式を使用できます。DBMSは時間の経過とともに変化する可能性があるため、これらのSQL式を使用することを決定した場合は、再確認して修正する必要がある場合があります。
例えば、次のようにすることができます:
バックエンドでどう動作するのか?
このセグメンテーションモードは、プロジェクトテーブルの属性に基づくセグメンテーションと同様に動作します。唯一の違いは、値がワークフローの日付範囲から得られるものであり、Lakehouse Managerテーブルの属性から得られるものではないため、プレステージが必要ないことです。
さらに詳しく
トレーニングや技術的なアシスタンスを受けて当社のソリューションを実装するには、営業担当者にお問い合わせください、またはプロフェッショナルサービスページを訪れて、専門家によるプロジェクト分析のための見積もりを依頼してください。
Data Platformを構築するチームと直接質問し、フィードバックを共有し、相互作用するには、専用のDiscordチャネルをご利用ください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。