

パイプラインを実行する
このページでは、OVHcloud Data Platformで利用できないForePaaS Legacy PlatformのサービスであるMachine Learning Managerについて説明しています。最新のドキュメントを参照してください。
パイプラインが設定されたら、ジョブと呼ばれるさまざまなタスクを実行するために実行できます。これらのジョブは、大量のデータや処理頻度に対応するためにForePaaS技術を使用して実行されます。
パイプラインの実行は、モデルが自然なライフサイクルを通じて進化するための核心部分です。設定した構成に従って、追加のデータを取り込み、モデルを再トレーニングし、新しいモデルをデプロイし、予測を行うことができます。
パイプラインジョブ
4種類のジョブがあり、トリガーを使用して手動または自動的に実行できます。
パイプラインジョブを手動で実行するには、右上の再生 ▶️ ボタンをクリックします。
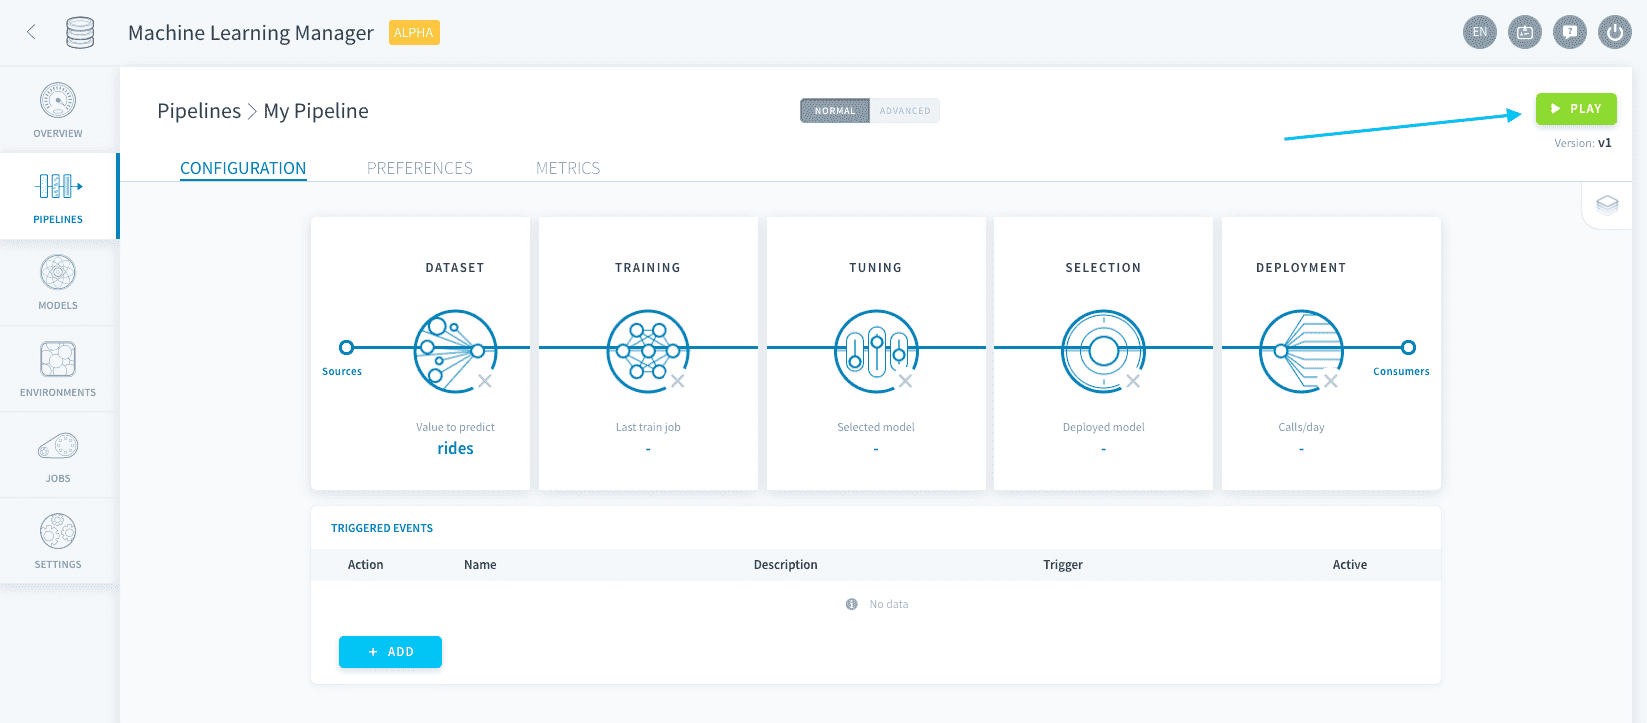
次に、実行するジョブとその方法を指定できます。
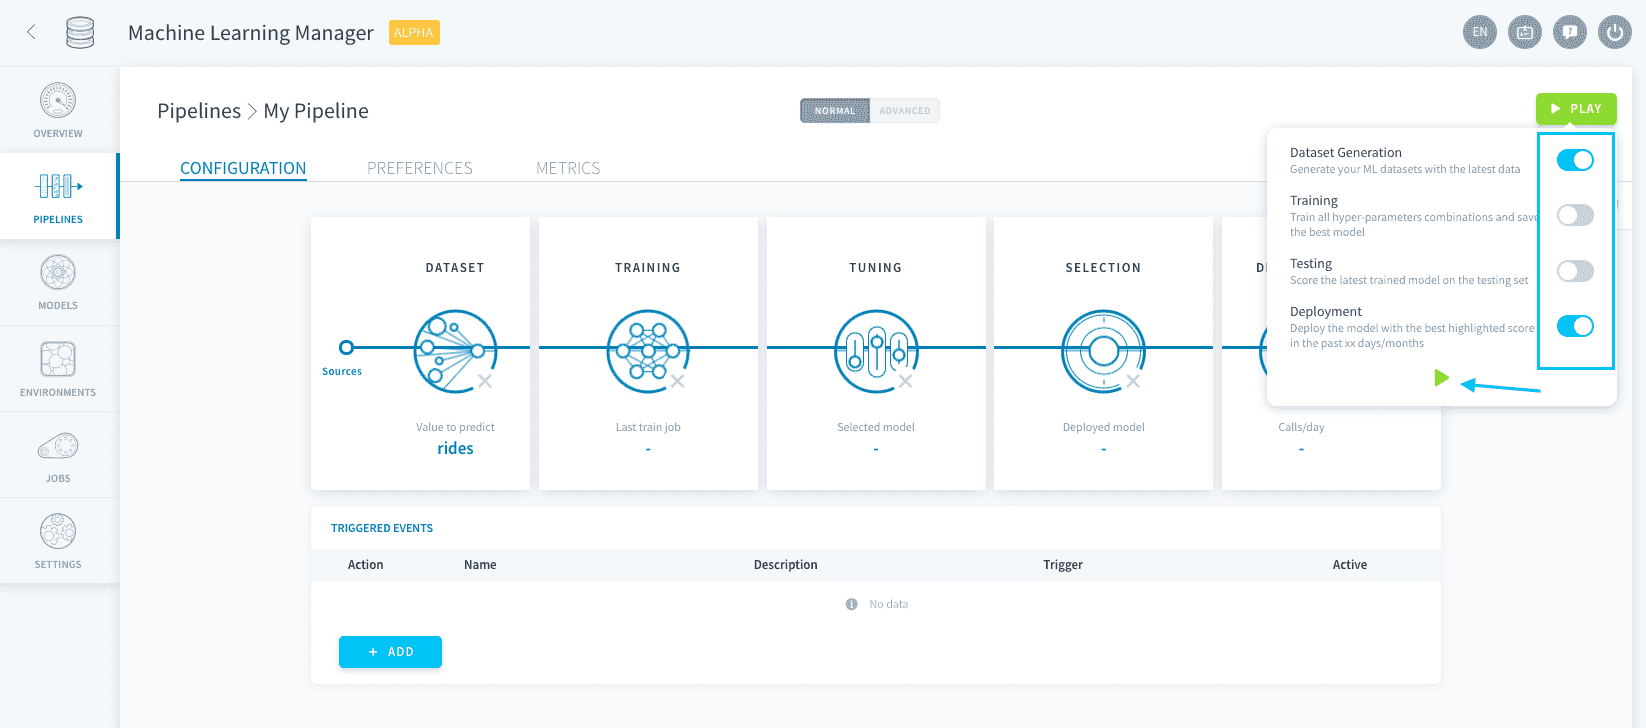
データセット生成ジョブ
データセット生成ジョブは、データ入力を使用してトレーニング、テスト、検証データセットを作成(または追加)するために使用されます。
トレーニングとテストセットは、Data ManagerのMLテーブルとしてモデリングされ、保存されます。
データセット生成ジョブを起動すると、トレーニングと検証セットから以前のデータが削除されます。次に、データセットステップで設定したルールに従って、データ入力内のテストセットにまだないデータポイントがトレーニングとテストセットに分割されます。検証セットは、トレーニングステップで設定したルールに従って生成されます。
テストセットは、パイプラインの設定からデータセットを手動でリセットしない限り、自然に消去されることはありません。
トレーニングジョブ
トレーニングジョブは、アルゴリズムとハイパーパラメータの組み合わせに基づいてモデルをトレーニングし、検証セットでスコアリングするために使用されます。
トレーニングジョブは、FPU-Gを使用してグラフィックス処理ユニット(GPU)で加速できます。
テストジョブ
テストジョブは、すべての追加されたスコアリング関数を使用して、テストセットでモデルを評価するために使用されます。
テストジョブは、FPU-Gを使用してグラフィックス処理ユニット(GPU)で加速できます。
デプロイジョブ
デプロイジョブは、予測を行うためのモデルのインターフェースである推論APIをデプロイするために使用されます。デプロイされるモデルは、モデル選択ステップで指定した基準に基づいています。
トリガーを設定する
再生 ▶️ ボタンを手動でクリックする必要はなく、特定の時刻やイベントでパイプラインを実行するようにトリガーを設定できます。
パイプラインの設定を管理する
設定タブでは、パイプラインの実行に関する基本的なオプションを設定できます。例えば、割り当てられたリソース、タイムアウト設定、ログ設定や必要に応じてデータセットをリセットすることもできます。
パイプラインをスケーリングする
各パイプラインは、設定で独立してスケーリングでき、トレーニング、スコアリング、データセット生成ジョブに割り当てられるリソースを指定できます。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして見積もりを依頼し、当社のプロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼してください。
Data Platformの開発チームと直接質問したり、フィードバックを送信したり、相互作用したりするには、専用のDiscordチャネルにアクセスしてください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。