

トレーニング手順を選択する
このチュートリアルでは、Machine Learning Managerを使用します。これは、OVHcloud Data Platformでは利用できないForePaaS Legacy Platformのサービスです。現在のチュートリアルを参照してください。
パイプラインの構築の次のステップに進み、モデルの核心となるトレーニング手順を設定する時が来ました。
このチュートリアルで学ぶ内容は次のとおりです:
アルゴリズムを選択する
ForePaaS Platformでは、業界標準のAIアルゴリズムを簡単に選択したり、独自のアルゴリズムを使用したりできます。ForePaaS Platformには、多くのAIアルゴリズムが用意されています。技術的なアルゴリズムについて学ぶ手間を省き、ビジネスニーズに集中できるようにするのが目的です。
次の画面で、Standard Estimatorsを選択します。
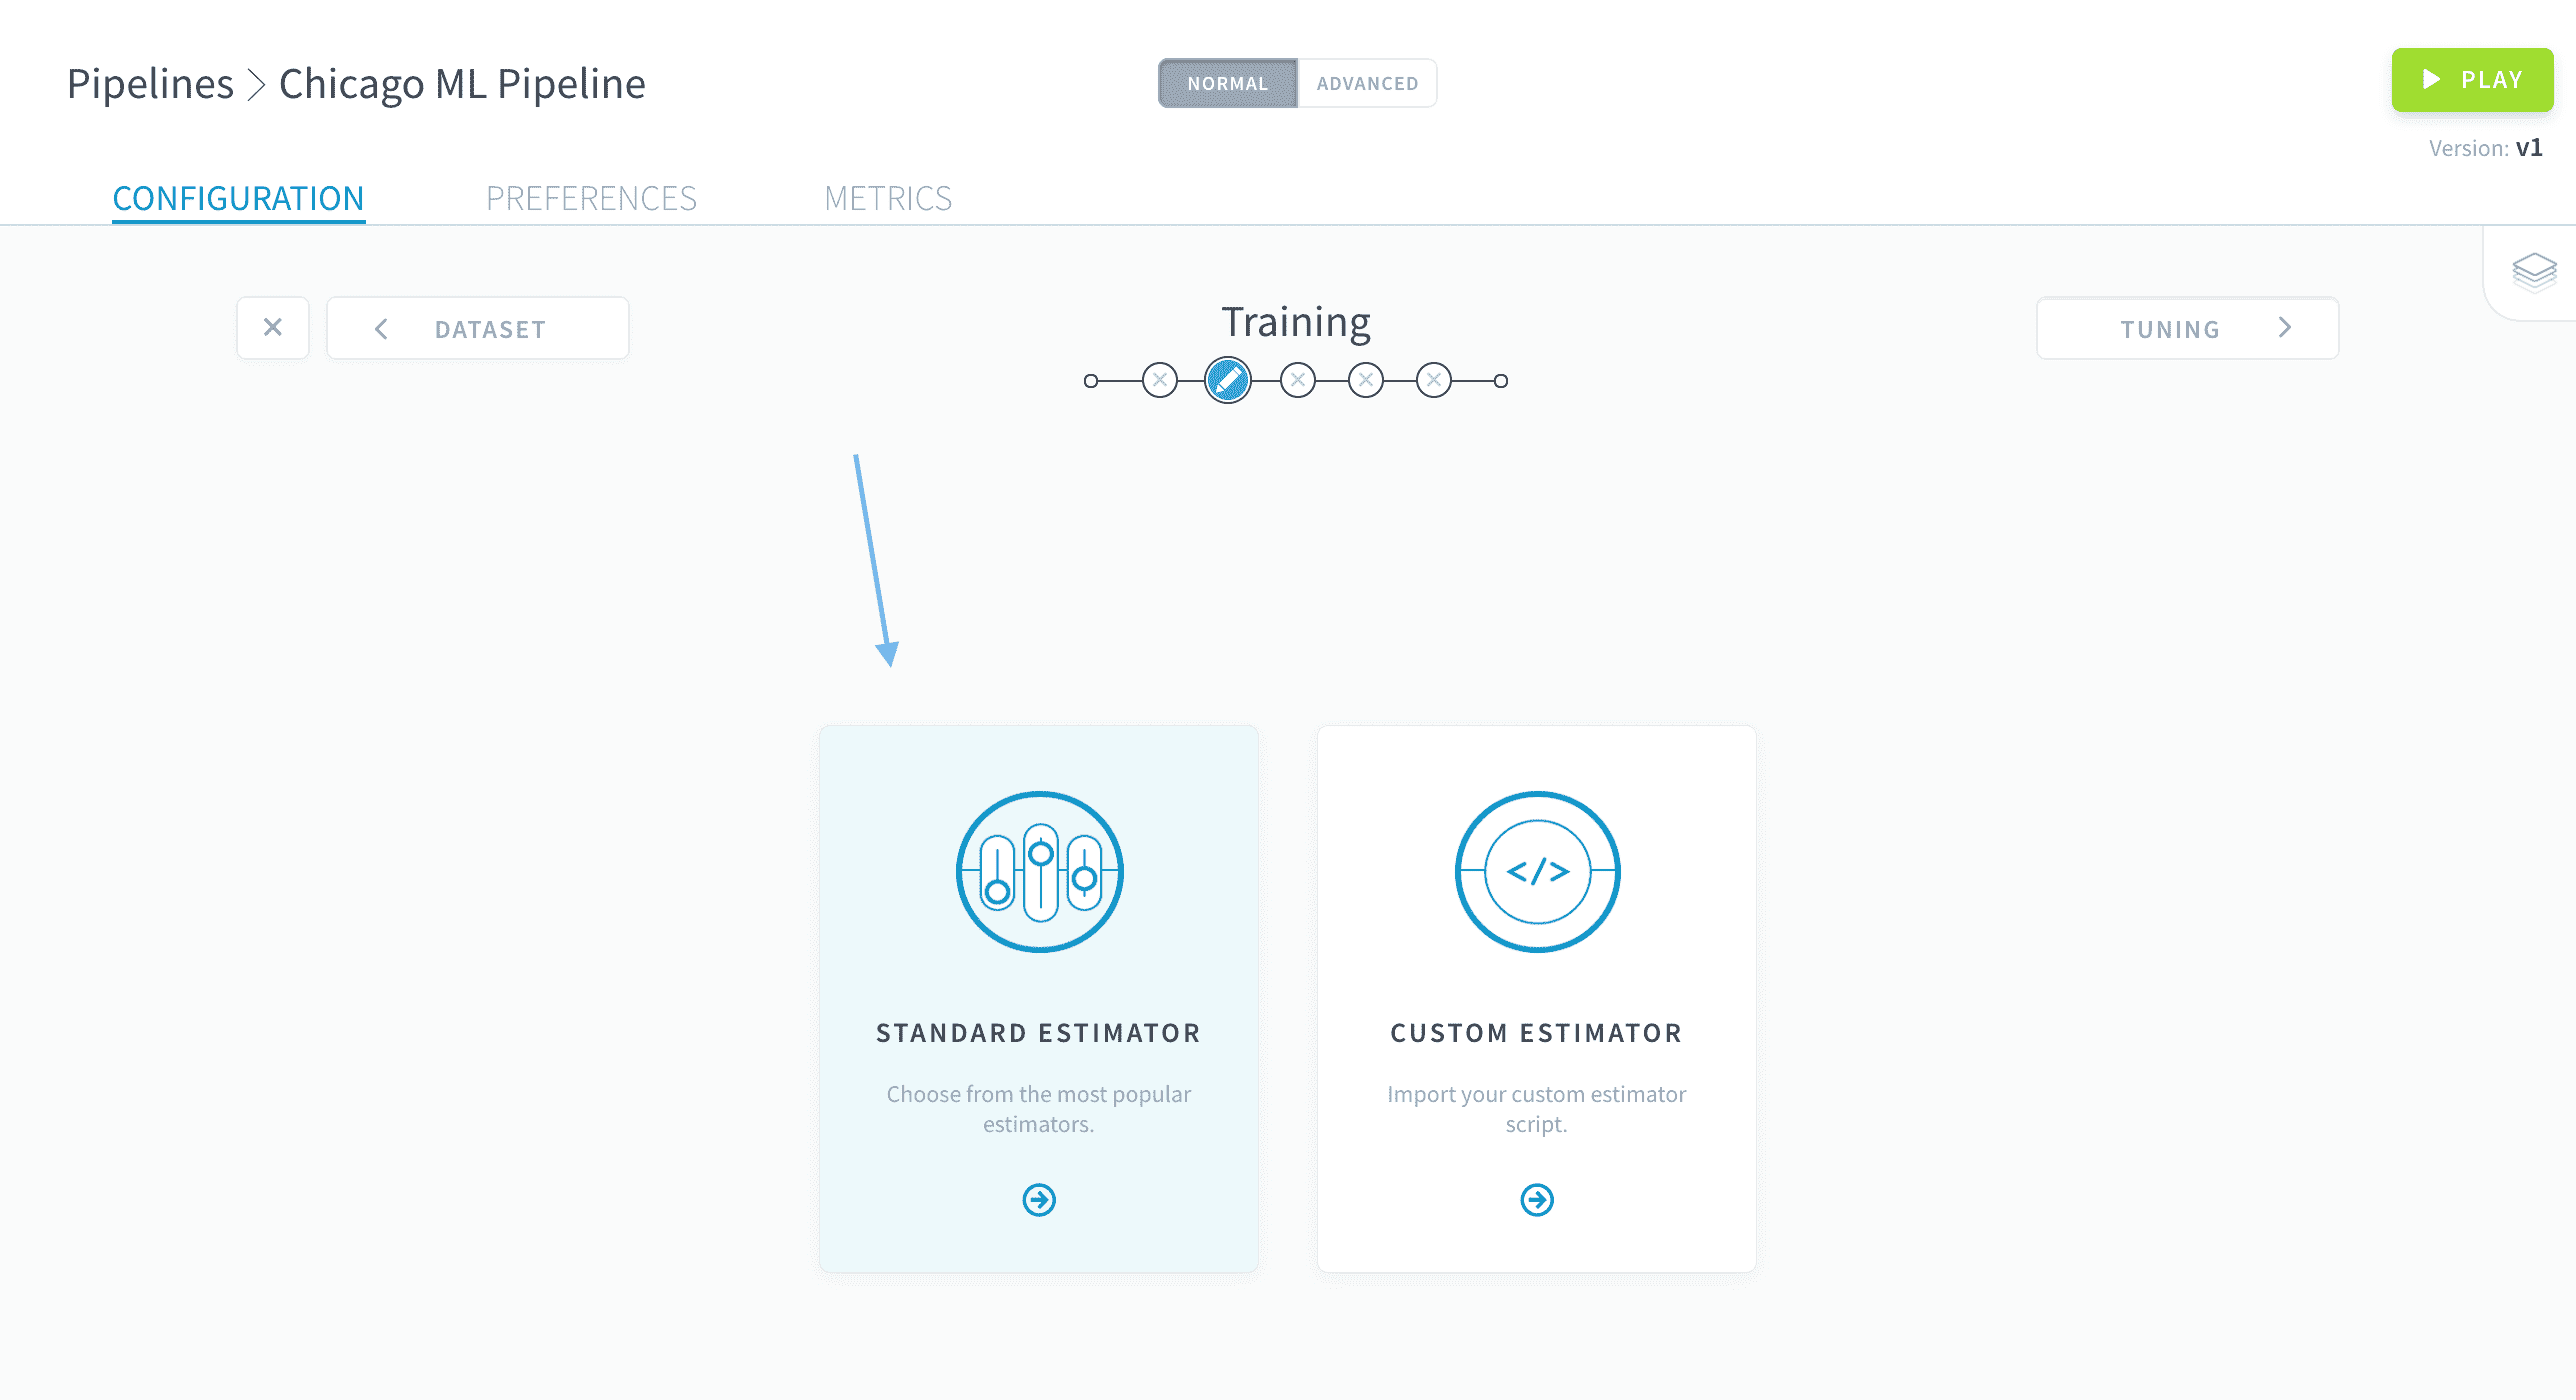
この問題には、決定木のランダムフォレストを使用しましょう。決定木は、数値変数のセットに基づいてカテゴリラベル(例:True/Falseまたは1/0)を予測するために使用される最もメインストリームのアルゴリズムの一つです。また、理解、実装、解釈が簡単です。これは、シカゴの交通例に適しています。
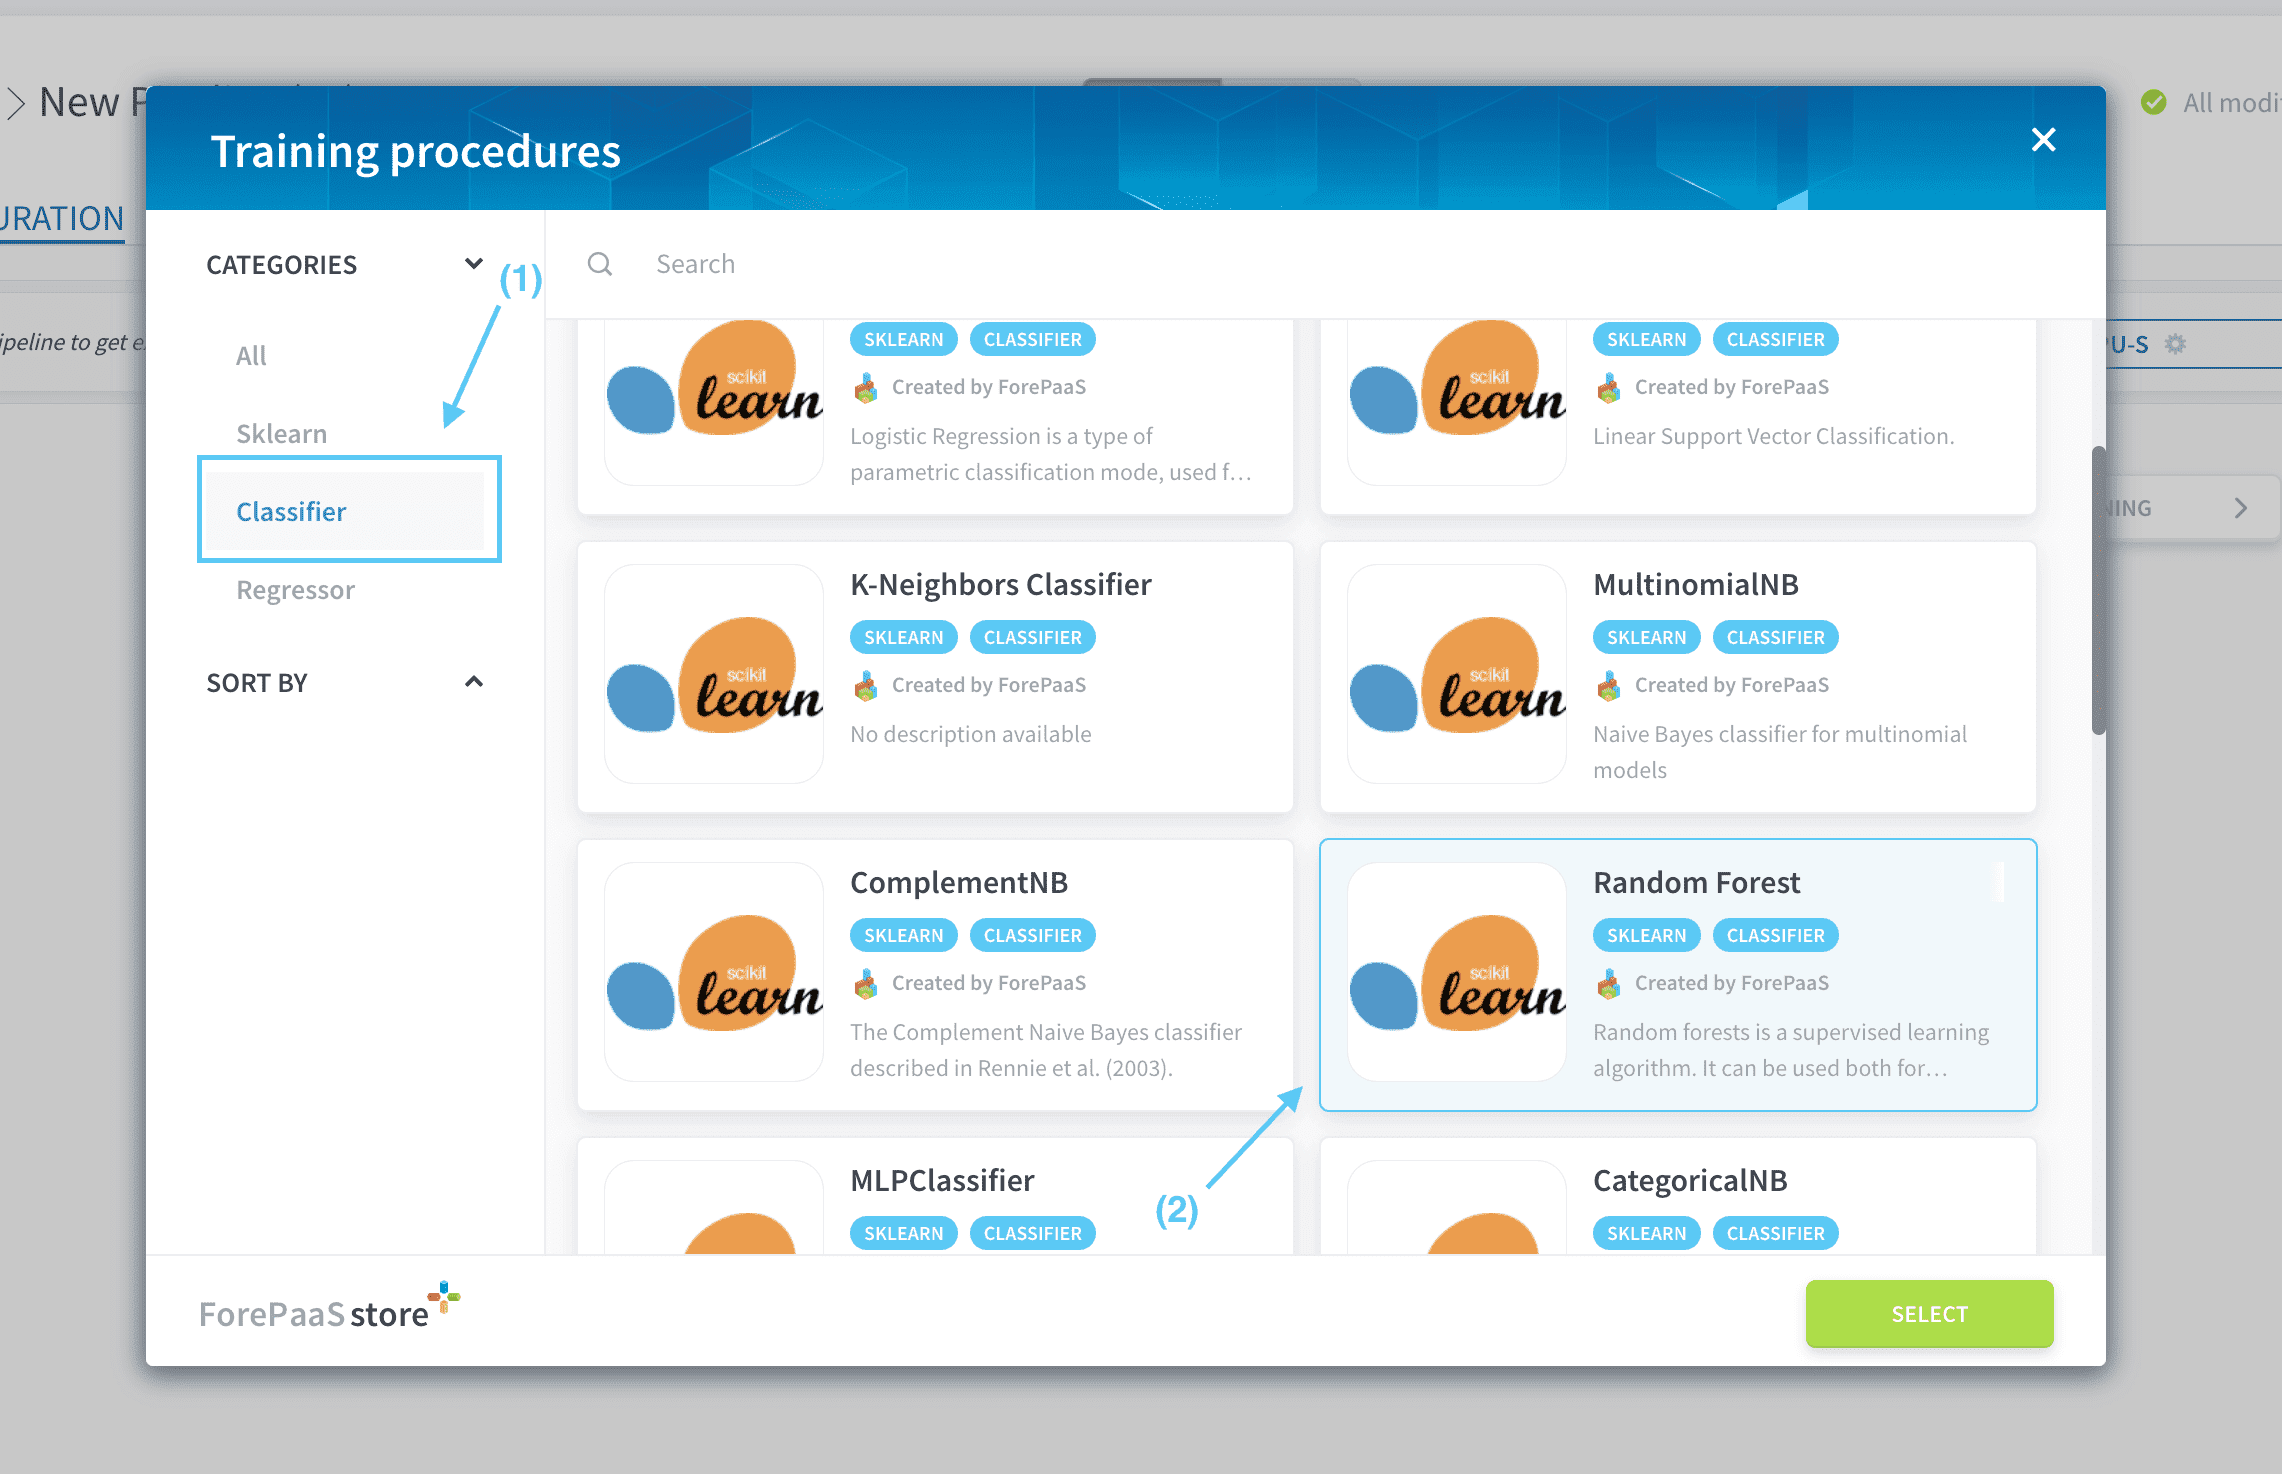
まず、ストアでClassifierカテゴリをフィルタリングし、Scikit LearnのRandom Forest(classifierバージョン - Random Forest Regressorではありません)を選択し、Selectを押します。
AlgorithmおよびDependenciesパネルは、あなたが選択した内容を反映するように自動的に設定されています。ライブラリ要件を扱う必要はありません。私たちがその部分を担当します!
Dependenciesボックスで事前インポートされたライブラリとモジュールを消さないように注意してください。そうしないと、パイプラインは実行されません。
スコアリングと検証を設定する
続ける前に、いくつかの概念について説明します。これらは、完璧な予測モデルを構築するために重要です💡。
あなたはベースアルゴリズムを選択しましたが、まだ微調整が必要です。そのためには、モデルのパフォーマンスを測定できるようになる必要があります。まだトレーニング段階にあるため、テストセットには触れられません。ベストプラクティスでは、検証セット🕵️♂️を定義する必要があります。
検証セットは、トレーニングセットのサブセットで、モデルを微調整している間にモデルをスコアリングするために使用されます。一方、テストセットは、最終モデルが新しいリアルワールドデータでどれだけうまく動作するかを測定するために使用されます。
言い換えれば、あなたのパイプラインは、初期のリアルワールドデータを次の3つのデータセットに分割します: トレーニングセット:モデルをトレーニング(または「フィット」)するために使用されます。 検証セット:トレーニング段階中にモデルフィットの公平な評価を提供するために使用されます。 テストセット:完全にトレーニングされたモデルの公平な評価を提供するために使用されます。
しかし、心配する必要はありません!ForePaaS Platformでは、検証データセットを簡単に作成し、予測モデルをスコアリングすることができます。
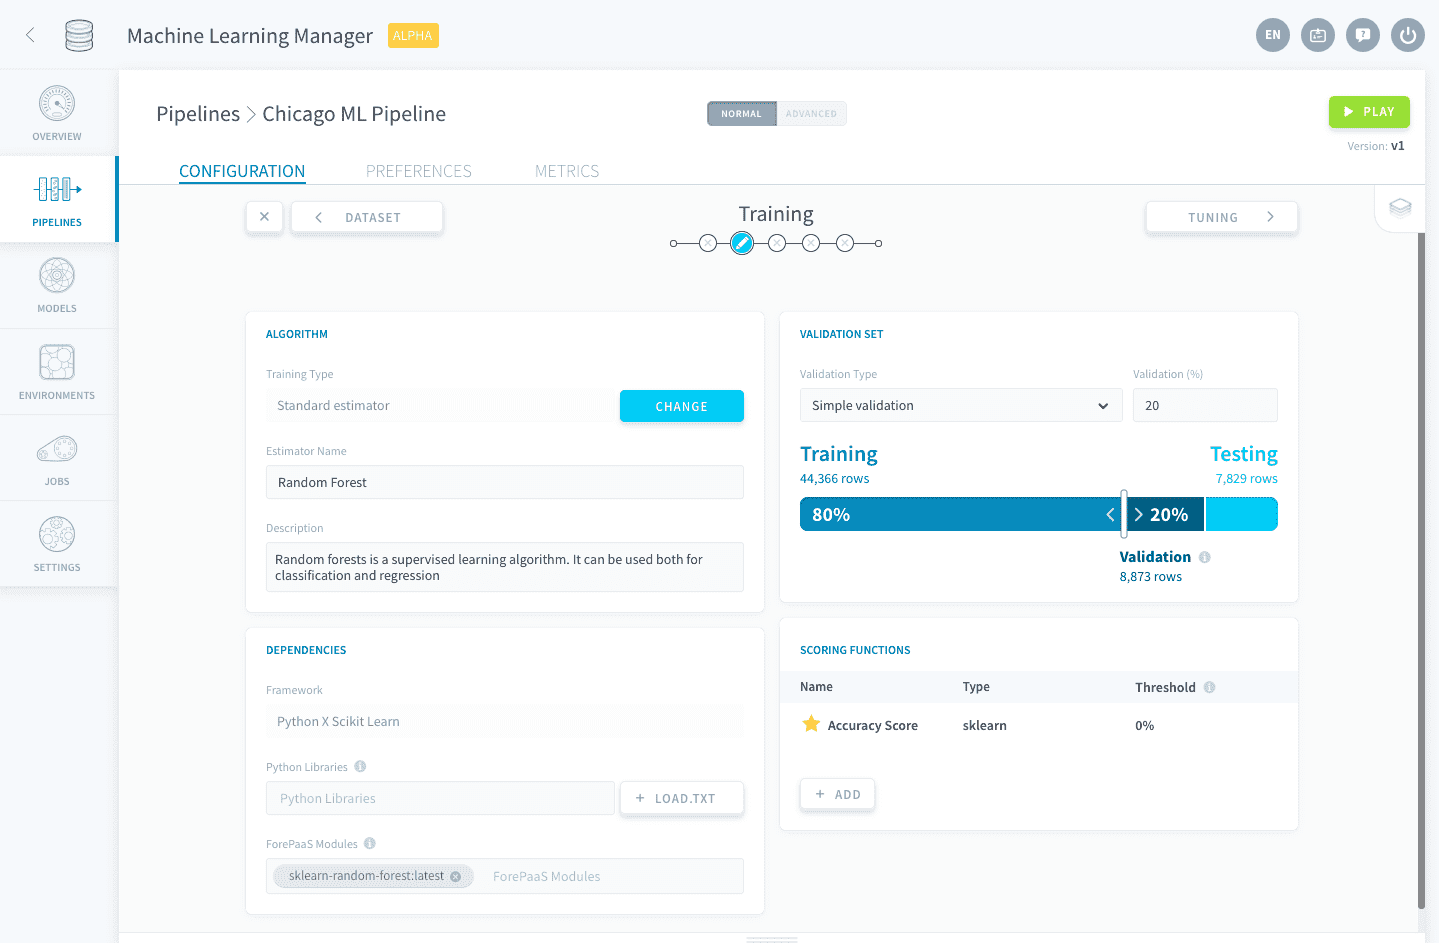
ForePaaS Platformでは、モデルをスコアリングするための2つの検証タイプを選択できます:クロスバリデーションまたはシンプルなバリデーション - 今は後者に従いましょう。スライドバーを使用して、検証セットが元のトレーニングセットの20%を表すようにします:
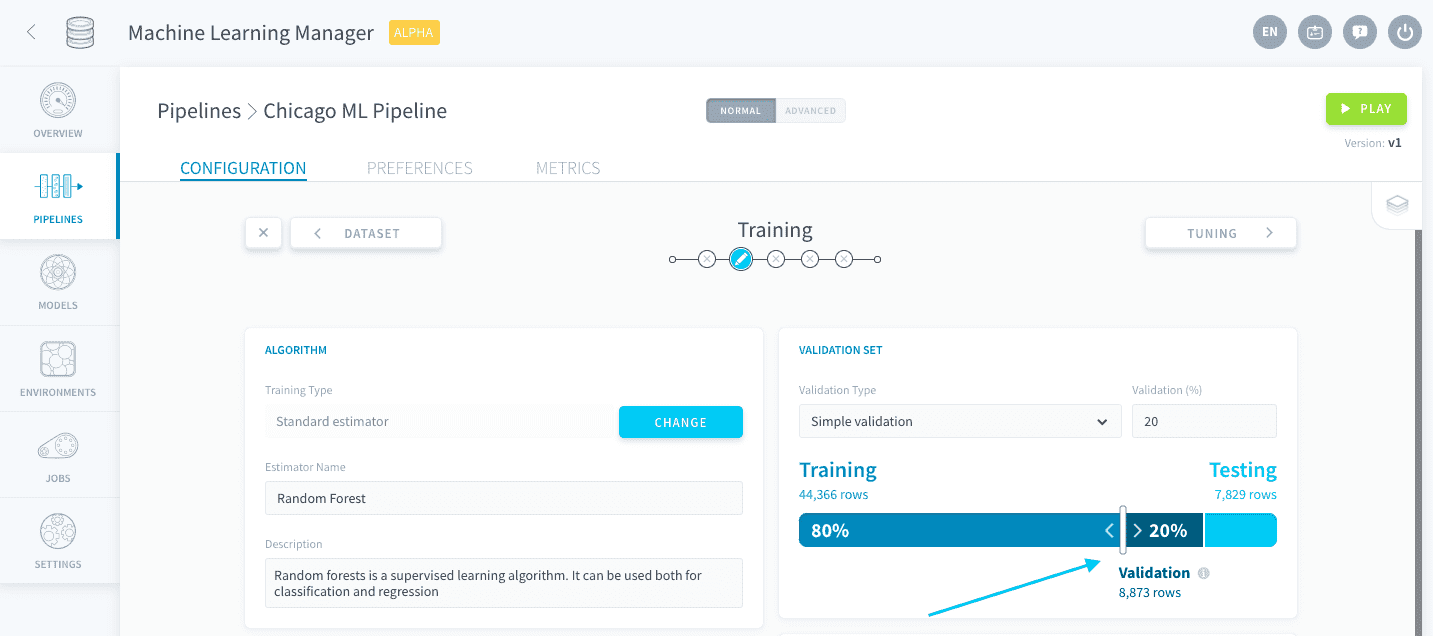
注意:テストセットのサイズは、最初のステップで行う必要があるため、編集できなくなります。
検証データセットをスコアリングする方法はたくさんあり、ForePaaS Platformでは、好きなだけスコアリング関数を選択できます。簡単にするために、ForePaaS Platformではデフォルトで正確性が選択されています。
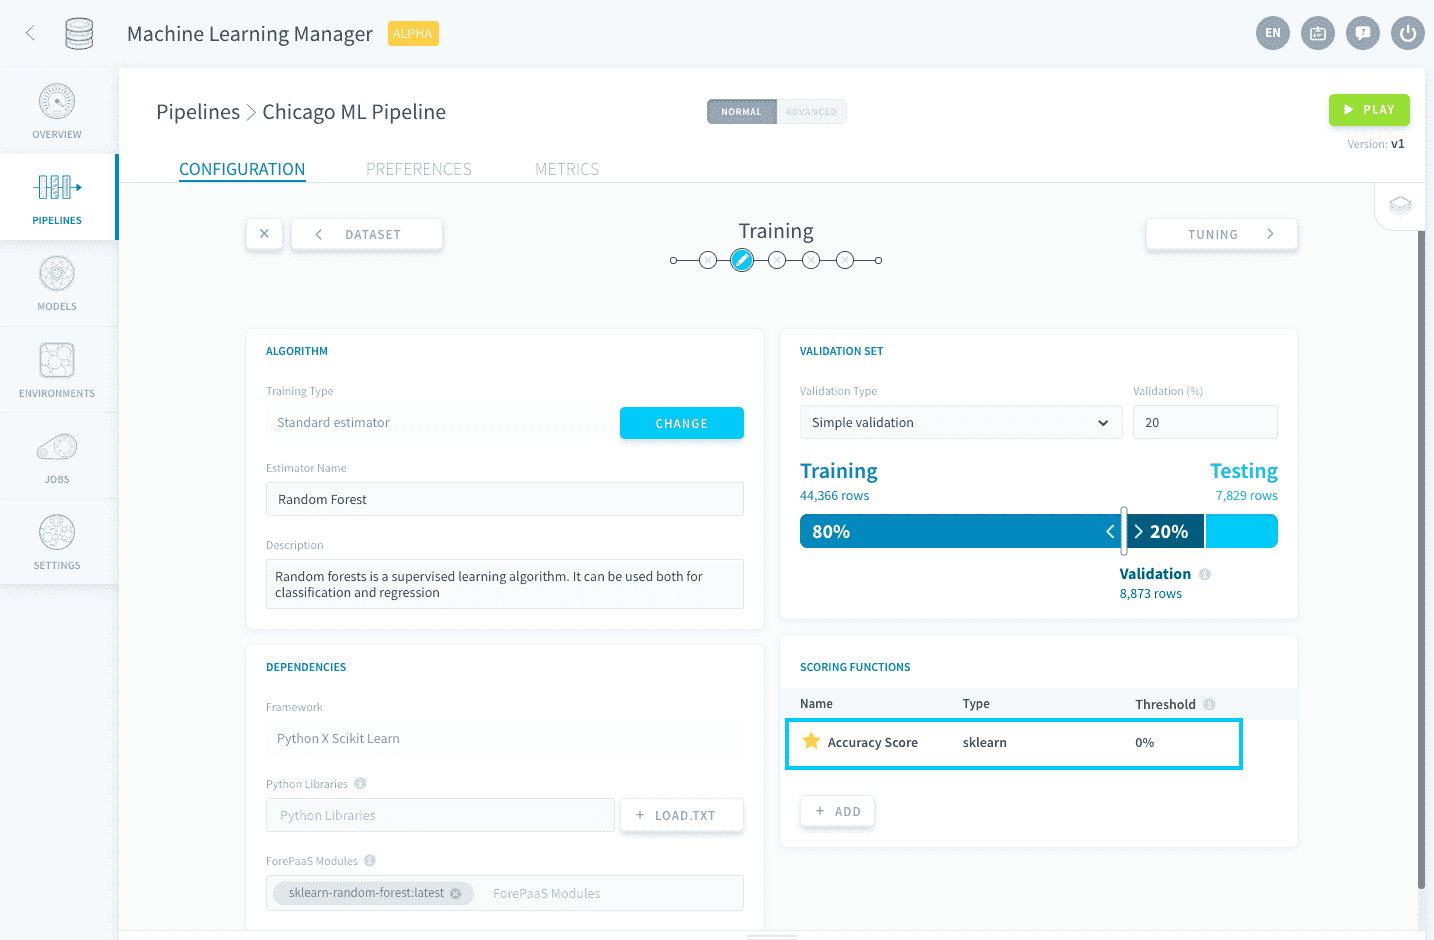
プラットフォームはまた、自動的に閾値を0%に設定しました。この値は、パイプライン内のモデルが保存されるために必要な最小スコアを表します(検証セットとテストセットの両方)。追加されたスコアのいずれかがその閾値に達しないモデルは破棄されます。
次のステップに進む前に、画面が最終的に次のようになるようにしてください:
パイプラインを実行する準備はほぼ整いました!次のステップは、あなたが選択したランダムフォレストアルゴリズムのハイパーパラメータを微調整することです🕹。