

セグメンテーション「プロジェクトテーブルの属性に基づく」の概要
Lakehouse Managerのテーブルの選択した属性からの値を処理するタスクにアクションを分割します
目的
アクションは複数のタスクに分割され、各タスクは Lakehouse Managerの指定テーブルから選択した属性からの値の一部を管理します。
セグメンテーションの実際の製品ドキュメントページは、機能の動作と仕様を詳しく説明しています このページで。
必要条件
このセグメンテーションタイプを使用する前に、確認する必要がある点があります。
1. var_name 属性はソーステーブルでインデックス付けされていますか?
そうでない場合、抽出クエリは大幅に遅くなります。
2. ソースおよび宛先データベースに十分なCPUがありますか?
selectとinsert操作はCPU集約的です。- 例えば、データベースにCPUが1つしかない場合、DBMSインスタンスに対して同時に6つのワーカーを設定して選択と挿入を行うのはおそらく良いアイデアではありません...
一般的なルール:同時に実行される各ワーカーに対して1つのCPUが利用可能である必要があります。
3. 同じステージであまり多くのタスクを生成しないでください。
Data Processing Engine (DPE) が良好に動作するように、500を超えるタスクを持つステージを持つことを避けることをお勧めします。
これは厳密な制限ではありませんが、500を超えるタスクの数が増えるにつれてパフォーマンスの低下が観察されることがあります。 タスクの数を減らすには、バケットサイズを大きく設定して、各タスクがより多くの値を管理するようにすることができます(つまり、最終的にはタスクが少なくなります)。
このタイプのセグメンテーションの使用方法?
例として、以下の prim_ticket テーブルに対して aggregate アクションを使用し、dateごとにすべてのチケット収入を集計し、結果をテーブルagg_dateに挿入します。
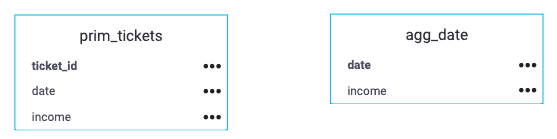
このアクションの実行時間を最適化するために、ワークロードは各日付値に基づいて複数のタスクに分割されます。
高度なパラメータの理解
さらに進む前に、Preferences タブがAdvanced modeのJSONフィールドとどのように対応するかを説明します。 明確さのために、技術的なJSON名を以下に使用します。
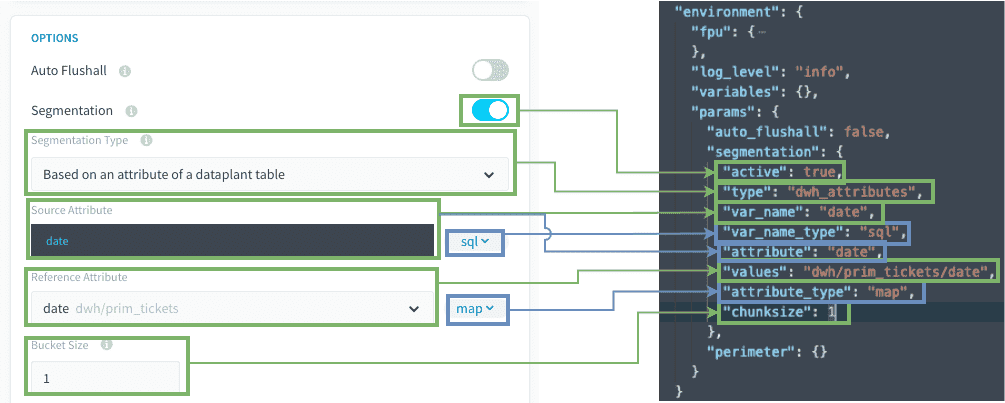
青い四角形はUIで明確さのためにのみ使用されます。緑のパラメータはDPEで使用されるものです。
ソースの属性 / var_name: ソースのフィルタリングに使用されるSQL属性。
参照属性 / Values: 値のセットが取得されるアドレス。 データセットテーブルからの場合は "dwh/TABLE_NAME/ATTRIBUTE_NAME" の形式で指定する必要があります。 ソースからの場合は "dwh/SOURCE_NAME/TABLE_NAME/ATTRIBUTE_NAME" の形式で指定する必要があります。
バケットサイズ / Chunksize: 各タスクでフィルタリングされる値の数。
適切なセグメンテーション属性の選択
適切なセグメンテーション属性を選択することは、成功した高速なデータパイプラインの鍵です。良いセグメンテーション属性の特徴は次のとおりです。
1. 基数
属性の基数は、ソーステーブルの行数に対してあまり高くない必要があります。
Analytics Managerで簡単なCOUNT DISTINCTクエリを使用して基数を確認できます。
2. 行の分布
理想的には、各値の行数の分布はほぼ等しくなる必要があります。
3. 値は長いテキストではありません...
...そうでないとジョブコントローラーに負荷がかかります。
4. aggregate, diff, delete_diff アクションの場合
セグメンテーション属性は宛先テーブルの主キーの一部である必要があります。
そうでない場合、各グループのデータが不完全になる可能性があります。
例えば、ticket_idにセグメンテーションを使用し、dateごとに集計する場合、タスク1は最初のチケット収入を挿入し、次にタスク2は同じ日付内で発生したチケット2の収入で収入を更新します...
5. 適切な候補のヒント
- 事実の日付を記述する属性はしばしば良い候補です:
- それはしばしばあなたの集計テーブルの主キーにあります
- それは低いから中程度の基数を持つかもしれません
- それは時間を通じて行の分布が比較的良いかもしれません
- 主要な参照テーブルの一部である属性も良い候補になります。
その他のヒント
1. SQL式を使用できます
segmentation.values(属性の最後の部分)とsegmentation.var_nameの場合、DBMSと互換性のあるSQL式を使用できます。DBMSは時間の経過とともに変化する可能性があるため、これらのSQL式を使用することを決めた場合は、再確認して修正する必要があることをご了承ください。
例えば、次のようにすることができます:
2. segmentation.values テーブルはソーステーブルと異なる場合があります
segmentation.valuesのセットがソーステーブルと異なるテーブルに含まれている場合、アクションで使用されるソーステーブルと同じテーブルを指定する必要はありません。
これは、毎回全テーブルを再計算するのではなく、特定の要素を絞り込むのに役立ちます。
例えば、segmentation.valuesは参照テーブルまたは一時テーブルから提供される場合があり、新しく入ってきたデータのみを管理します。
背景でどう動作するか?
アクションにプロジェクトテーブルの属性に基づくセグメンテーションがある場合、 アクションを実行するか、ワークフロー内のアクションを実行すると、次のように実行されます。
- 隠れたプレステージは、
segmentation.valuesフィールドで指定されたtable/attributeからすべての異なる値を取得します。
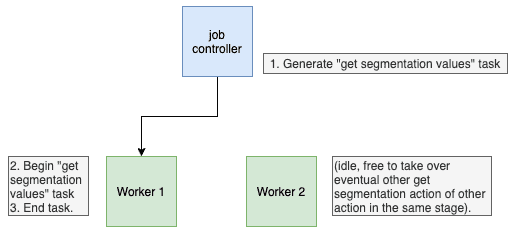
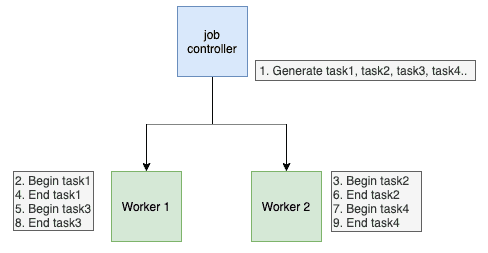
- ジョブコントローラーは、ステップ1で見つかった値の中から、各タスクで異なる値(または
chunksize構成に応じて値のセット)を持つ複数のタスクにアクションを分割します。 - それから各ワーカーが各タスクを順番に実行します。 これは、タスクが何百もあっても問題ありません。アクションはワーカーの数に応じて並列化されます。
技術的な説明
セグメンテーション構成の各部分がどのように使用されるかを正確に確認しましょう。 次のセグメンテーション構成で:
- プレステージタスクは、
prim_ticketからすべての異なるdate値を取得し、segmentation.valuesアドレスを実際の値に置き換えます。segmentation.valuesアドレスが構築される方法に注意してください。 このアドレスは、アクションで実際に選択されたsource tableとは異なる場合があります。
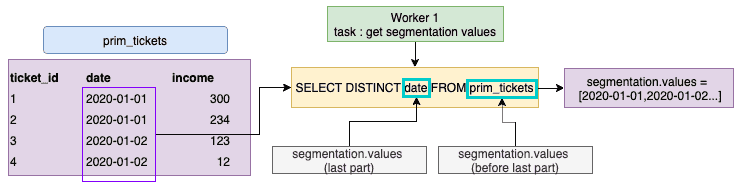
- ジョブコントローラーは、
segmentation.valuesの長さとchunksize(各タスクが処理する必要がある値の数)に基づいてタスクを作成します。 - 各ワーカーはタスクを順番に処理します。これは集計アクションの例です。注意点として;
segmentation.var_nameは抽出クエリのWHERE句でフィルタリングする属性として使用されます。したがって、segmentation.valuesで使用されるものとは異なる場合があります。
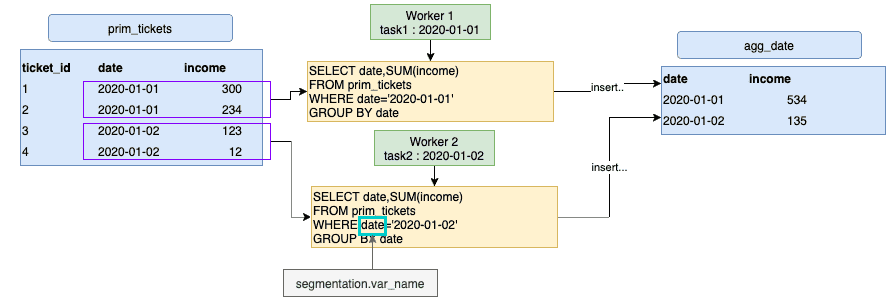
さらに詳しく
トレーニングや技術的なサポートを受けて当社のソリューションを実装するには、営業担当者にお問い合わせください、または当社の専門家がプロジェクトを分析するために見積もりを依頼するには、Professional Servicesページをご覧ください。
質問をする、フィードバックを提供し、Data Platformを構築するチームと直接交流するには、専用のDiscordチャネルにアクセスしてください。
OVHcloudサービスについてサポートが必要な場合は、Help Centreでリクエストを作成してください。
コミュニティに参加してください。