

Deduplicate アクションを使用して重複行を削除する
Deduplicate アクションは、テーブルから重複行を削除し、重複キーごとに1行だけを保持します
目的
Deduplicate アクションは、テーブルから重複行を削除し、インプレースで実行し、重複キーごとに1行だけを保持します。典型的なユースケースは、テーブルが追加モードで読み込まれたが、アップサートが意図されていた場合です。テーブルの識別子フィールドで重複を削除すると、アップサートが生成したテーブルと同じテーブルが正確に生成されます。他のアクションと同様に、これはオンデマンドで実行できます。または、cron トリガーでスケジュールしたり、ワークフロー内でオーケストレーションしたりできます。
このアクションは、lakehouse (Iceberg)およびPostgreSQLデータセットに格納されたテーブルで動作します。
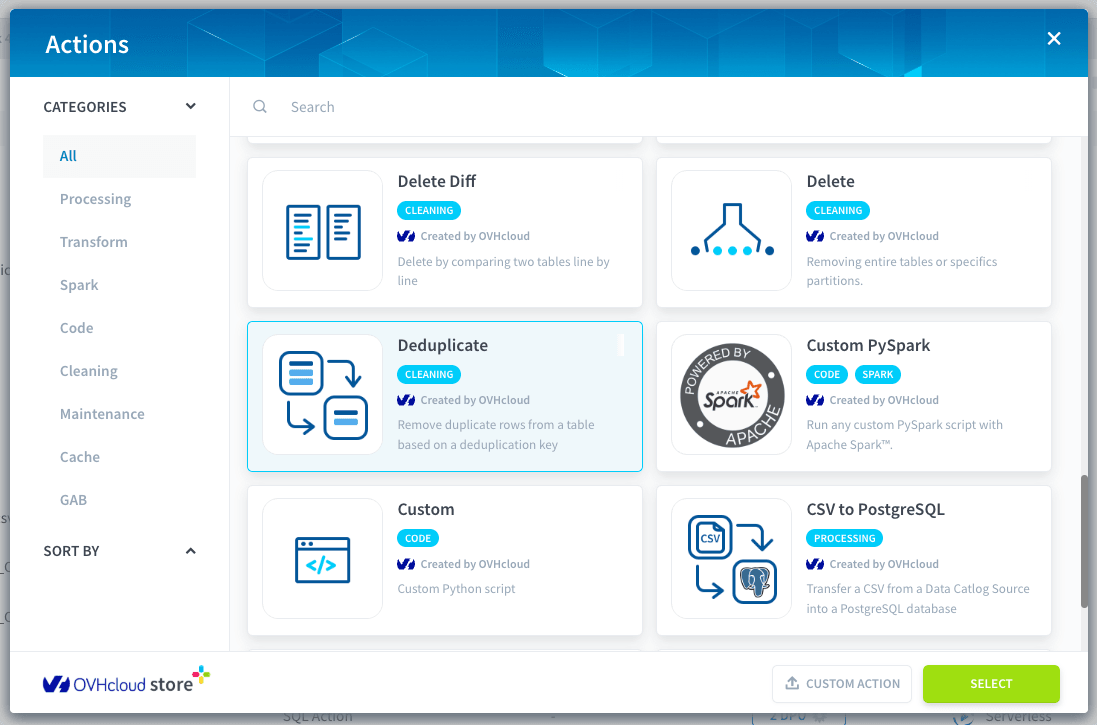
Deduplicate は、ターゲットテーブル自体を変更します。Lakehouse テーブルでは、以前の状態はスナップショットとして利用可能なため、タイムトラベルで実行を元に戻すことができます。PostgreSQL テーブルでは、削除は永続的です。削除する準備ができていないものを重複を削除する前に、バックアップオプションを有効にしてください。
Deduplicate アクションを構成する
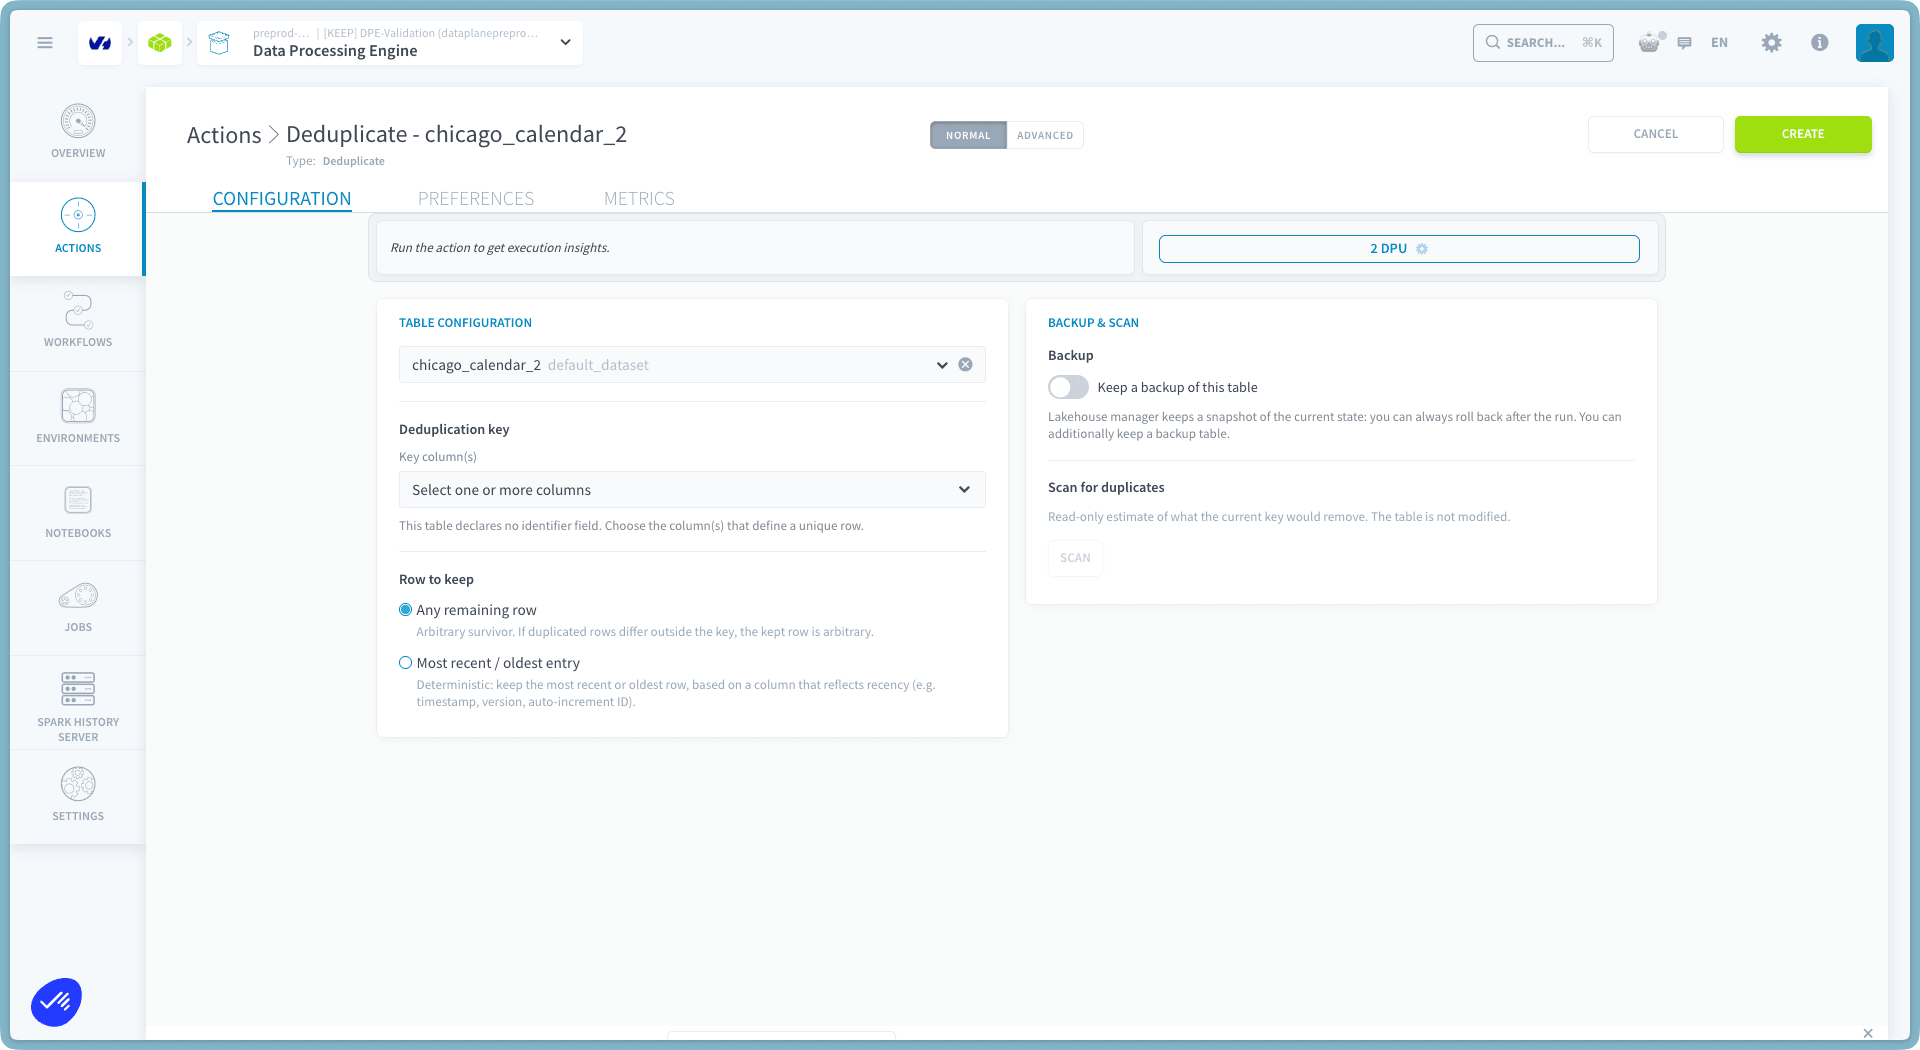
構成画面には、左側にテーブル構成、右側にバックアップ&スキャンの2つのパネルがあります。左側のパネルでは、テーブル、重複キー、および保持する行を選択します。右側のパネルでは、実行を保護し、アクションを作成する前にその効果をプレビューします。
テーブルを選択する
テーブルセレクターからターゲットテーブルを選択します。各エントリには、テーブル名とその所属するデータセットが表示されます。アクション名は選択したテーブルから事前入力されます。例えば、Deduplicate - orders です。
重複キーを選択する
重複キーは、ユニークな行を定義する列のセットです。実行後、テーブルにはこれらの列の組み合わせごとに1行だけが含まれます。
テーブルが識別子フィールドを宣言している場合、それらはキーセレクターの上に表示され、キーはそれらで事前入力されます。これは推奨されるキーです。これは、テーブルがインジェスト時にアップサートロードを実行した場合と同じように、テーブルの重複を削除します。
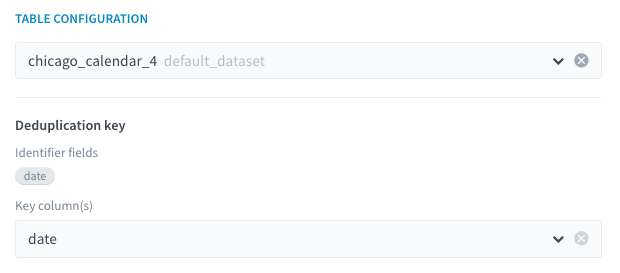
代わりに、既存の列のセットを選択することもできます。選択内容がテーブルの宣言された識別子フィールドと異なる場合、警告が表示され、テーブル自身の定義による重複ではない行が削除される可能性があることをお知らせします。テーブルが識別子フィールドを宣言していない場合は、データにユニークな行を定義する列または列を選択してください。
キー列が空の行は、標準的なSQL GROUP BY セマンティクスに従ってグループ化されます。同じキー列にNULLがある2つの行は、互いに重複としてカウントされます。
保持する行を選択する
複数の行が同じキーを共有する場合、保持する行設定は、どの行が生き残るかを決定します。
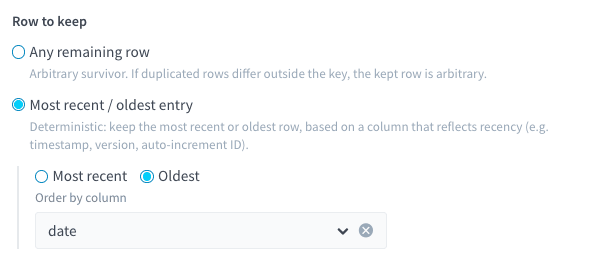
- 任意の残っている行(デフォルト):生き残る行は任意です。これは、重複行が同一のコピーである場合に適した選択です。重複行がキーの外で異なる場合、保持される行は任意です。
- 最新 / 最古のエントリ:決定的です。最新または最古を選択し、並べ替え列を選択します。更新タイムスタンプ、バージョン番号、または自動増分IDなど、新しさを反映する日付、タイムスタンプ、または数値列です。並べ替え列が空の行は最後にランク付けされます。値がある行は常に値がない行よりも優先されます。
バックアップを保持する
このテーブルのバックアップを保持するをオンにして、削除する前にテーブルの完全なコピーを作成します。コピーは<table>_backup_<id>と名付けられ、Lakehouse Managerに他のテーブルと同様に登録されます。
バックアップは、実行で実際に削除する重複がある場合にのみ作成され、ターゲットテーブルに触れる前に行数が確認されます。バックアップを作成または確認できない場合、実行は停止し、テーブルはそのまま残ります。バックアップテーブルは、実行が失敗した場合でも自動的に削除されません。必要がなくなったら、自分で削除してください。
Lakehouse テーブルでは、現在の状態のスナップショットが保持されるため、バックアップは追加の安全網です。PostgreSQL テーブルでは、バックアップは削除された行を回復する唯一の方法です。
重複をスキャンする
アクションを作成する前に、スキャンをクリックして、現在の構成で削除されるものの読み取り専用の見積もりを取得します。スキャンはテーブルを変更しません。選択したテーブルと少なくとも1つのキー列が必要です。
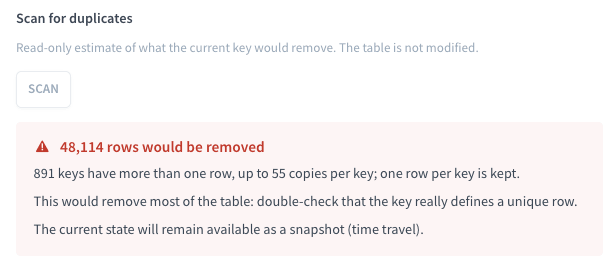
結果カードには、次の内容が表示されます。
- 削除される行の数と適用されるサバイバー規則;
- 1つ以上の行を持つキーの数と、キーごとの最悪のコピー数;
- 以前の状態が利用可能なままになるか(Lakehouse スナップショット)または削除が永続的か(PostgreSQL)を示します。
スキャンでキーに重複が見つからない場合、カードは削除するものはないことを確認します。テーブルの半分以上が削除される場合、追加の警告が表示され、キーが本当にユニークな行を定義しているかどうかを確認するよう促します。テーブルの大部分を削除することは通常、キーが間違っていることを意味します。例えば、1つの日付列だけが、1日あたり多くの行を持つテーブルにあります。
スキャン結果は、テーブル、キー、またはサバイバー規則を変更するたびに破棄されます。新しい見積もりを取得するには、再度実行してください。同じ統計は、各実行の開始時に再計算されるため、実行はスキャンでプレビューした内容を確認します。
重複削除の実行方法
テーブルを保持するデータセットのエンジンによって、メカニズムが異なります。
各実行は、テーブルをスキャンして開始します。スキャンでキーに重複が見つからない場合、実行はすぐに終了し、テーブルは変更されません。
このアクションは、行のみを削除します。テーブルのスキーマ、パーティション、または識別子フィールドを変更することはありません。
Lakehouse テーブルでは、アクションが実行されている間にデータセットに一時的な<table>_dedup_tmpテーブルが表示される場合があります。このテーブルは、実行の終了時に自動的に削除され、ハードエラーの残骸は次の実行の開始時にクリーンアップされます。
アクションが実行されている間にターゲットテーブルに書き込まないでください。同時書き込みはサポートされていません。Lakehouse テーブルでは、競合するコミットが失敗し、自動ロールバックが実行前の状態を復元します。
実行結果を確認する
各実行は、実行ログに要約を書き込みます。実行前後の行数、削除された行数、重複があったキーの数、使用されたキー、および実行を元に戻す方法です。バックアップオプションが有効な場合、要約にはバックアップテーブルの名前も含まれます。例えば:
デデュプリケーションを元に戻す
- Lakehouse テーブル: 実行のログにプリラン スナップショット ID が印刷されます。スナップショット保持期間(デフォルトで 14 日間)内に、time travelを使用してテーブルをそのスナップショットに復元します。
- PostgreSQL テーブル: スナップショットはありませんので、削除自体を元に戻すことはできません。実行にバックアップ オプションが含まれている場合、
<table>_backup_<id>コピーにはテーブルのプリラン内容が正確に保持されています。
例
下記のタブを選択すると、Advanced modeで見る JSON として表示される典型的な構成を確認できます:
append モードで 2 回ロードが実行されたため、orders の各行は 2 回存在します。行は同一のコピーですので、どのサバイバーでも問題ありません。テーブルの識別子フィールド order_id でデデュプリケーションを実行すると、アップサートが生成したテーブルが得られます:
Advanced mode を使用する
アクションの JSON 構成ファイルにアクセスする必要がある場合は、Advanced をページ上部でクリックして Advanced mode を有効にします。
アクションは、次のパラメータを受け取ります:
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして、当社の Professional Services 専門家に見積もりを依頼し、プロジェクトのカスタム分析を依頼してください。
Data Platform を構築するチームと直接質問をし、フィードバックを送信し、交流するには、専用の Discord チャネルをご利用ください。
OVHcloud サービスについてサポートが必要な場合は、Help Centreでリクエストを作成してください。
コミュニティに参加してください。