

IoTフリート監視パイプラインの構築
このチュートリアルでは、Data Platform上の完全なリアルタイムパイプラインについて説明します。カスタムアクションからシミュレートされたIoTセンサーテレメトリをストリーミングする
目的
このチュートリアルでは、Data Platform上の完全なリアルタイムパイプラインを紹介します。カスタムアクションからシミュレートされたIoTセンサーテレメトリをストリーミングし、Apache Kafkaに送信し、Lakehouse Managerテーブルに取り込み、Supersetダッシュボードでフリートの健全性をリアルタイムで可視化します。
最後に、デバイスの健全性、環境のトレンド、異常、ダウンタイムを表示する動作するダッシュボードを作成します。このダッシュボードは、スクリプト化された故障シナリオによって駆動されるため、データは常にストーリーを語ります。
はじめに
必要条件
To follow this tutorial you need:
- OVHcloud Data Platform プロジェクトで、Data Processing Engine、Lakehouse Manager、および Superset/Trino の設定が利用可能です。
- 書き込み可能な Apache Kafka ブローカー。このチュートリアルでは、クライアント証明書(mTLS)認証を使用する OVH 管理 Kafka サービスを使用しますが、接続設定を適応させれば、どのブローカーでも同様のアプローチが可能です。
- ブローカー上に作成された
iot_readingsという名前の Kafka トピック(トピックの自動作成は無効になっていることが多いです)。
最初に、最初のGetting StartedチュートリアルとApache Kafkaからデータをストリーミングするチュートリアルを完了することをおすすめします。このガイドでは、プラットフォームの主要コンポーネントに慣れていることを前提としています。
作成するもの
シナリオ
プロデューサは、3つの地域にわたる4つのサイトに設置された環境センサー(温度、湿度、CO₂、PM2.5)のフリートをシミュレートします。各デバイスの状態マシンがリアルな故障ライフサイクルを駆動するため、データは決して平坦ではありません。
2つのデバイスは固定スケジュールで故障するようにスクリプト化されています。そのため、各実行は常に完全なストーリーを示します。読み取り値は、ランダムノイズを含む圧縮された10分の「日次サイクル」に従います。そのため、トレンドは信頼性があります。デバイスがOFFLINEになると、完全にデータの送信を停止します。これは後でデータに実際のギャップとして現れます。
メッセージ形式について。 Kafkaコネクタは、ルートレベルのJSONフィールドのみを読み取り、メッセージのサンプリングによってテーブルスキーマを推論します。したがって、各メッセージは、安定した型のフィールドをすべて出力します(数値は常に浮動小数点数です。error_code は、正常な場合は文字列 "NONE" です)。時々欠落するフィールド、または時々整数で時々浮動小数点数のフィールドは、推論されたスキーマを破壊します。
ステップ1:Kafkaの認証情報をバケットに保存する
カスタムアクションのソースに証明書やパスワードを貼り付けるのではなく、Lakehouse Manager バケットに保存し、実行時に取得するようにしてください。カスタムアクションはプロジェクトに対して自己認証を行うため、追加の認証情報なしでバケットを読み取ることができます。また、コード内に機密情報を保持する必要もありません。
- Lakehouse Manager で、
iot-demo-certsという名前のバケットを作成します。 - 3つの mTLS ファイルをアップロードします。
プロダクサは、起動時にSDKのバケットコネクタを使用してこれらをダウンロードします。
証明書やキーのファイルをリポジトリにコミットしたり、アクションのソースに貼り付けたりしないでください。それらをバケット内に保持してください。
ステップ2:プロデューサーのカスタムアクションを作成する
プロダクサーをダウンロードし、カスタムアクションとして追加します。
- Data Processing Engine > Actions > New > Custom を選択します。
- ダウンロードした
producer.pyを直接アップロードします。 - アクションの情報パネルでエントリ関数を
customfuncに設定します。 - アクションの Python Requirements に
kafka-pythonを追加します。 - 実行モードを Always-up に設定します。プロデューサは連続的にループするため、Serverless mode ではタイムアウトします。
kafka-python を使用してください。kafka は使用しないでください。PyPI 上の kafka のベアパッケージは、Python 2 専用の放棄されたディストリビューションであり、ワーカーで invalid syntax (simple.py, line 54) が失敗します。kafka-python パッケージが from kafka import ... 名前空間を提供します。
調整可能なパラメータ
すべての設定はファイルの先頭にあります。最も変更する可能性が高い設定は以下の通りです。
コードのハイライト
ファイル全体を読む必要はありませんが、いくつかの部分は知っておく価値があります。
接続ブロック。 ここでブローカーのエンドポイントと認証方法を設定し、実行が有限かどうかを選択します。
バケットからの認証情報。 証明書は実行時に取得され、ハードコーディングされることはありません。したがって、アクション内に機密情報は含まれません。
フリート。 シミュレーションのサイズを変更するには、サイトまたはサイトごとの数を変更します:
失敗シナリオ。 2つのデバイスが固定スケジュールで故障し、これらの期間がOKからDEGRADED、FAULT、OFFLINEへのストーリーのペースを決めます。
アクションを実行します。各メッセージには安定した型を持つ十二のフィールドがすべて含まれているため、データが流れ始めるとすぐにスキーマが完了します。最初のスクリプト化されたデバイスは約十五秒後に劣化しますので、DEGRADED と FAULT のサンプルはすぐに現れます。ハートビート行を確認するためにアクションログを監視してください: sent ~N messages; fleet: {...}。
ステップ3:ソースコネクタを使用してKafkaに接続する
接続 > ソース > Apache Kafka に移動し、接続を作成します。ブローカーのエンドポイントと iot_readings トピックを指定してください。
mTLS ブローカーの場合は、コネクタの SSL フィールド で認証します。CA 証明書、クライアント証明書、クライアントキーをアップロードし、ユーザー名とパスワードは空白のままにしてください。
このコネクタフォームは、ブローカーがクライアント証明書を使用している場合でも、SSLフィールドを公開します。これらのフィールドがmTLSハンドシェイクを動作させます。詳細は、Kafkaコネクタリファレンスをご覧ください。
ステップ 4: メタデータを抽出し、テーブルを作成する
データが流れ始めたら、Analyzerを開き、メタデータを抽出します。
16つの属性が表示されます。プロダクサからの12フィールドに加え、Kafkaが追加した4つのエンベロープ列(timestamp、date、offset_r、partition)です。シンプルな追加のみのテーブルの場合、4つのエンベロープ列はすべてスキップできます。partitionとoffset_rは、アップサートまたは重複排除のセマンティクスが必要な場合のみ保持してください。
プロダクサはtsをISO-8601形式の文字列として出力します。文字列として推論された場合、テーブルでTimestamp型に設定するか、Trinoで解析する(Good to knowを参照)かのいずれかを選択できます。結果のスキーマからLakehouse Managerテーブル iot_readingsを構築します。
完全な列のリスト:
OFFLINEは行値として表示されません。オフラインのデバイスは発信を停止するため、ダウンタイムはdevice_idのギャップ(そのdevice_idに対応する行がない)として表示されます。各デバイスの最新のtsを現在時刻と比較することで検出できます。
ステップ 5: ストリームをテーブルに読み込む
Data Processing EngineでLoadアクションを作成し、iot_readingsトピックをiot_readingsテーブルにマッピングします。Always-upモードで実行して、ライブストリームを継続的に消費するようにします。
Loadアクションは、Kafkaにデータが存在する限り実行を続けます。タイムアウトまで続きます。これはストリーミング読み込みの場合、予想される動作です。
正常に完了したLoadアクションは、メタデータの更新を自動的に実行するため、テーブルの行数は自動的に更新されます。このストリーミングセットアップでは、アクションはAlways-upで実行され、手動で停止するかタイムアウトするかして、クリーンに終了することはありません。そのため、自動更新が実行されない場合があります。その場合、Update Metadataアクションを実行して、Lakehouse Managerの行数が取り込まれたデータを反映するようにします。
ステップ 6: Supersetからテーブルをクエリする
Trinoを介してSupersetをテーブルに接続します。Supersetをまだデプロイしていない場合は、Deploy Apache Supersetに従ってください。
Supersetで、SQLAlchemy URIがtrino://<user>@<trino-host>:<port>/<catalog>形式のデータベース接続を追加します。チャートを構築する前に接続をテストします。これはエンドツーエンドのセットアップで最も頻繁に問題が発生するステップです。
tsが文字列として到着した場合、Trinoでfrom_iso8601_timestamp(ts)を使用して解析し、TIMESTAMP(3) WITH TIME ZONEを返します。解析された列を公開する仮想データセットを作成し、データセットの主要な時系列列としてマークします。これにより、時系列チャートのX軸として利用可能になります。
ステップ 7: ダッシュボードを構築する
完成したダッシュボードは、フリート全体のシングルスクリーンビューです。
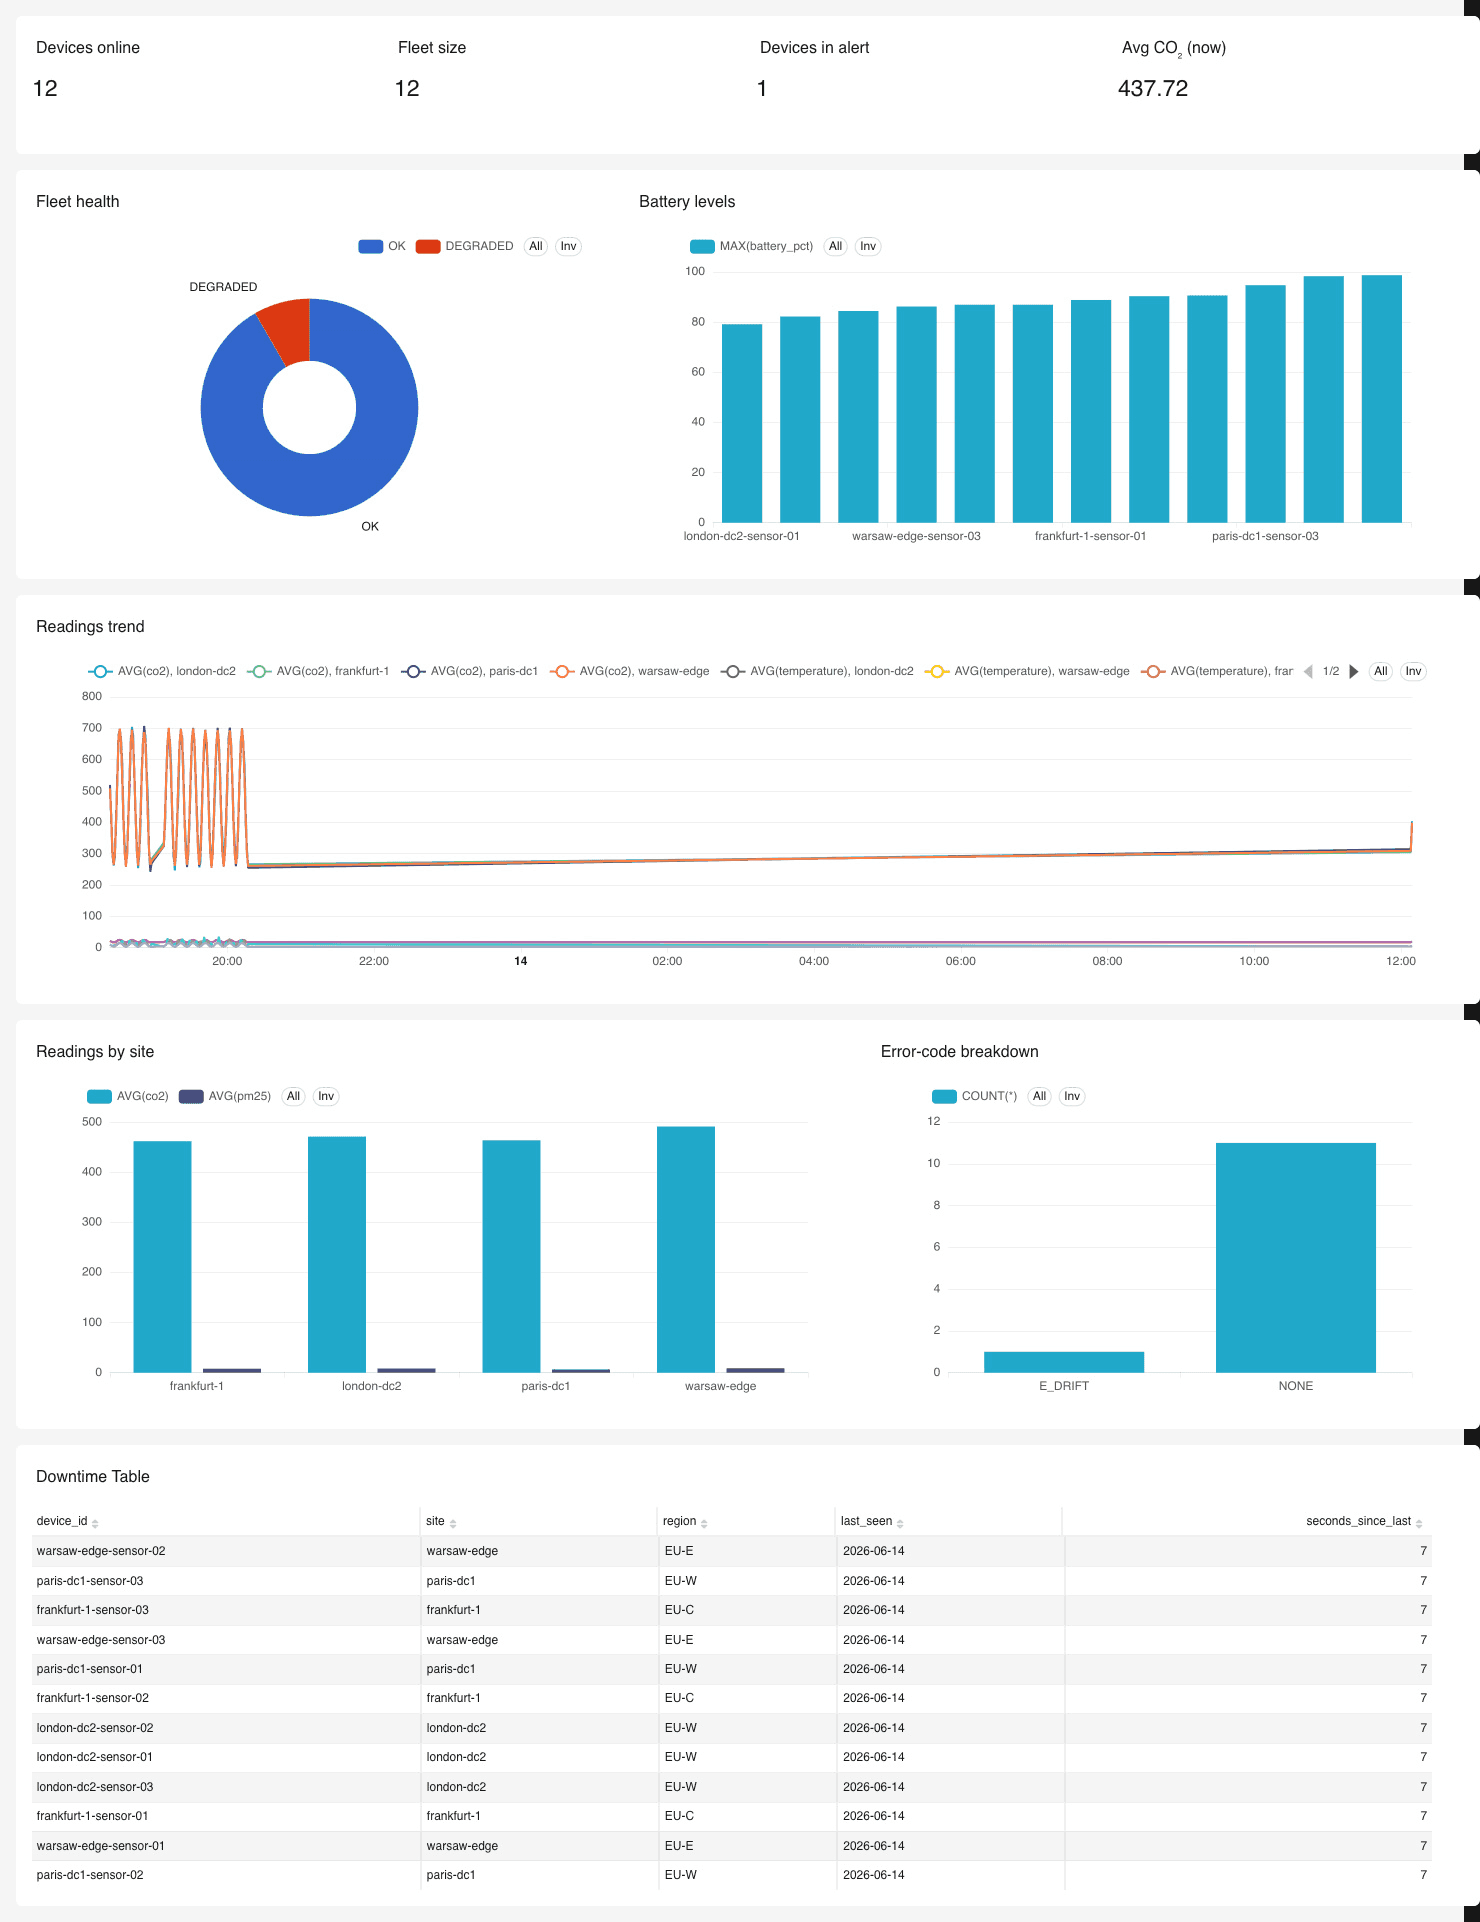
実用的なパネルのセット:
すべてのパネルの正確なTrino SQLと設定、および完全な仮想データセットについては、次のページに従ってください:
Supersetのいくつかのヒント:
- バーチャートでは、カテゴリをX軸に配置し、Dimensionsボックスを空のままにします。Dimensionsは、各バーをサブシリーズに分割するためだけです。
- 閾値線(例: バッテリー警告レベル)は、アノテーションレイヤーを通じて時系列チャートで利用可能です。カテゴリ別のバーチャートでは、代わりに昇順で並べ替えます。テーブルでは、条件付き書式設定を使用します。
- CO₂値(約480)は、温度(約21)とPM2.5(約9)を共通軸で圧倒します。CO₂を別途チャート化するか、二次軸を使用して、小さなメトリクスが読み取り可能なままにします。
- ダウンタイムテーブルは、フリートが健全な場合は空になります。これは正しい動作です。フィルタなしで構築し、すべてのデバイスをリスト表示し、条件付き書式設定で古い行を強調表示して、パネルが壊れているように見えないようにします。
Good to know
- プロダクサはデザイン上終了しません。 これはAlways-upモードの無限ループです。アクションのデフォルトタイムアウトは約2時間です。手動で停止すると、「停止」と表示され、成功ではなく表示されます。これは自然な終了がないためです。クリーンな成功実行を得るには、
MAX_RUNTIME_SECSを秒単位の数値に設定します。ループはフラッシュされ、閉じられ、合計がログに記録され、終了します。継続的にライブなダッシュボードを維持するには、Noneのままにします。 - Update Metadataで行数を更新します。 正常に終了したLoadアクションは、テーブルメタデータを自動的に更新します。このストリーミングセットアップでは、アクションはAlways-upで実行され、停止またはタイムアウトする代わりにクリーンに終了することはありません。したがって、ステップ5で説明したように、行数が取り込まれた内容を反映するには、Update Metadataアクションを実行する必要がある場合があります。
- 時系列用に
tsを解析します。 列が文字列の場合、from_iso8601_timestamp(ts)で解析し、Supersetで時系列列としてマークします。 - 解析不能な行に対処します。 テストメッセージが
tsが有効なタイムスタンプではない行を残した場合、from_iso8601_timestampはINVALID_FUNCTION_ARGUMENTをスローします。解析をtry(from_iso8601_timestamp(ts))でラップして、悪い行がnullに解決されるようにするか、行を削除します。
構築したもの
現在、完全なストリーミングパイプラインを持っています。カスタムアクションがシミュレートされたテレメトリを生成し、Kafkaがそれを輸送し、コネクタとLoadアクションがそれをLakehouse Managerに取り込み、SupersetがTrinoを介してそれをライブで可視化します。スクリプト化された故障が進行するにつれて、ダッシュボードは全体のストーリーを通過します。健全なフリート、劣化して故障するデバイス、ダウンタイムテーブルとトレンドのギャップとして現れるダウンタイムのウィンドウ、そして最後にデバイスを正常に戻す修理です。
ここから、別のデバイス次元テーブルを追加したり、さらに多くのメトリクスを追加したり、プロダクサを変更して独自の実際のセンサーデータを再生するように適応させたりできます。
このパターンはスケーラブルです。 同じ構成要素は、はるかに大きなパイプラインに組み合わされます。1つのトピックが1つのテーブルにマッピングされるため、複数のデータストリームを処理するには、構成要素を繰り返します。さらに多くのKafkaトピックを追加し、各トピックのメタデータを独自のLakehouse Managerテーブルに抽出し、トピックからテーブルへのマッピングごとに1つのLoadアクションを実行します。1つのプロダクサは複数のトピックに出力でき、SupersetはTrinoを介して結果のテーブルを結合できます。したがって、多トピック、多テーブルフリート(例: 環境読み取り値、エネルギー使用量、デバイスイベントの別々のストリーム)は、このチュートリアルを何度か適用して、1つのダッシュボードセットにフィードするだけです。
さらに詳しく
当社のソリューションのトレーニングや技術的なサポートが必要な場合は、営業担当者にお問い合わせください。または、Professional Services ページをご覧になり、見積もりをご依頼いただき、当社の専門家がプロジェクトを分析してください。
Discord チャネル で、Data Platform を構築するチームと直接質問したり、フィードバックを送信したり、交流したりしてください。
OVHcloud サービスについてサポートが必要な場合は、ヘルプセンター でリクエストを作成してください。
ユーザーコミュニティ に参加してください。