

パイプラインをスケールする
このページでは、OVHcloud Data Platformで利用できないForePaaSレガシープラットフォームのサービスであるMachine Learning Managerについて説明しています。現在のドキュメントを参照してください。
ForePaaSプラットフォームは、データプロジェクトの要件が進化するにつれて簡単にスケールアップできるように設計されています。
Machine Learning Managerでは、各個別のパイプラインを垂直にスケールアップできます。つまり、各ジョブに無制限に多くの計算リソースを追加できます。データセット生成ジョブは、水平にスケールアップすることもできます。つまり、ワークロードを複数の並列インスタンスに分割できます。
現在、トレーニング/テストジョブを水平にスケールアップすることはできません。つまり、分散トレーニングを実行することはできません。当社のエンジニアチームは、この機能を近日中に実装するために努力しています。この機能が必要な場合は、ロードマップポータルにご連絡ください!
ジョブを垂直にスケールアップする
機械学習ジョブの各種に対して、より多くの計算リソースを割り当てることができます。これは、PreferencesタブのResourcesパネルで、各計算インスタンスのForePaaS Units(FPU)の数を増やすことで独立して行うことができます。FPUは処理能力の単位であり、一定量のCPUとメモリへのアクセスを表します。
- FPU-S: 一般的な処理 - ハードウェアの利用可能性に基づき、約0.5 CPUと2 GBのRAMに相当します。
- FPU-G: GPUアクセラレーション - ハードウェアの利用可能性に基づき、約1 GPUと最低5 vCPUと40 GBのRAMを表します。
デフォルトでは、新しく作成されたパイプラインには、各種ジョブごとに4 FPU-Sが割り当てられます。
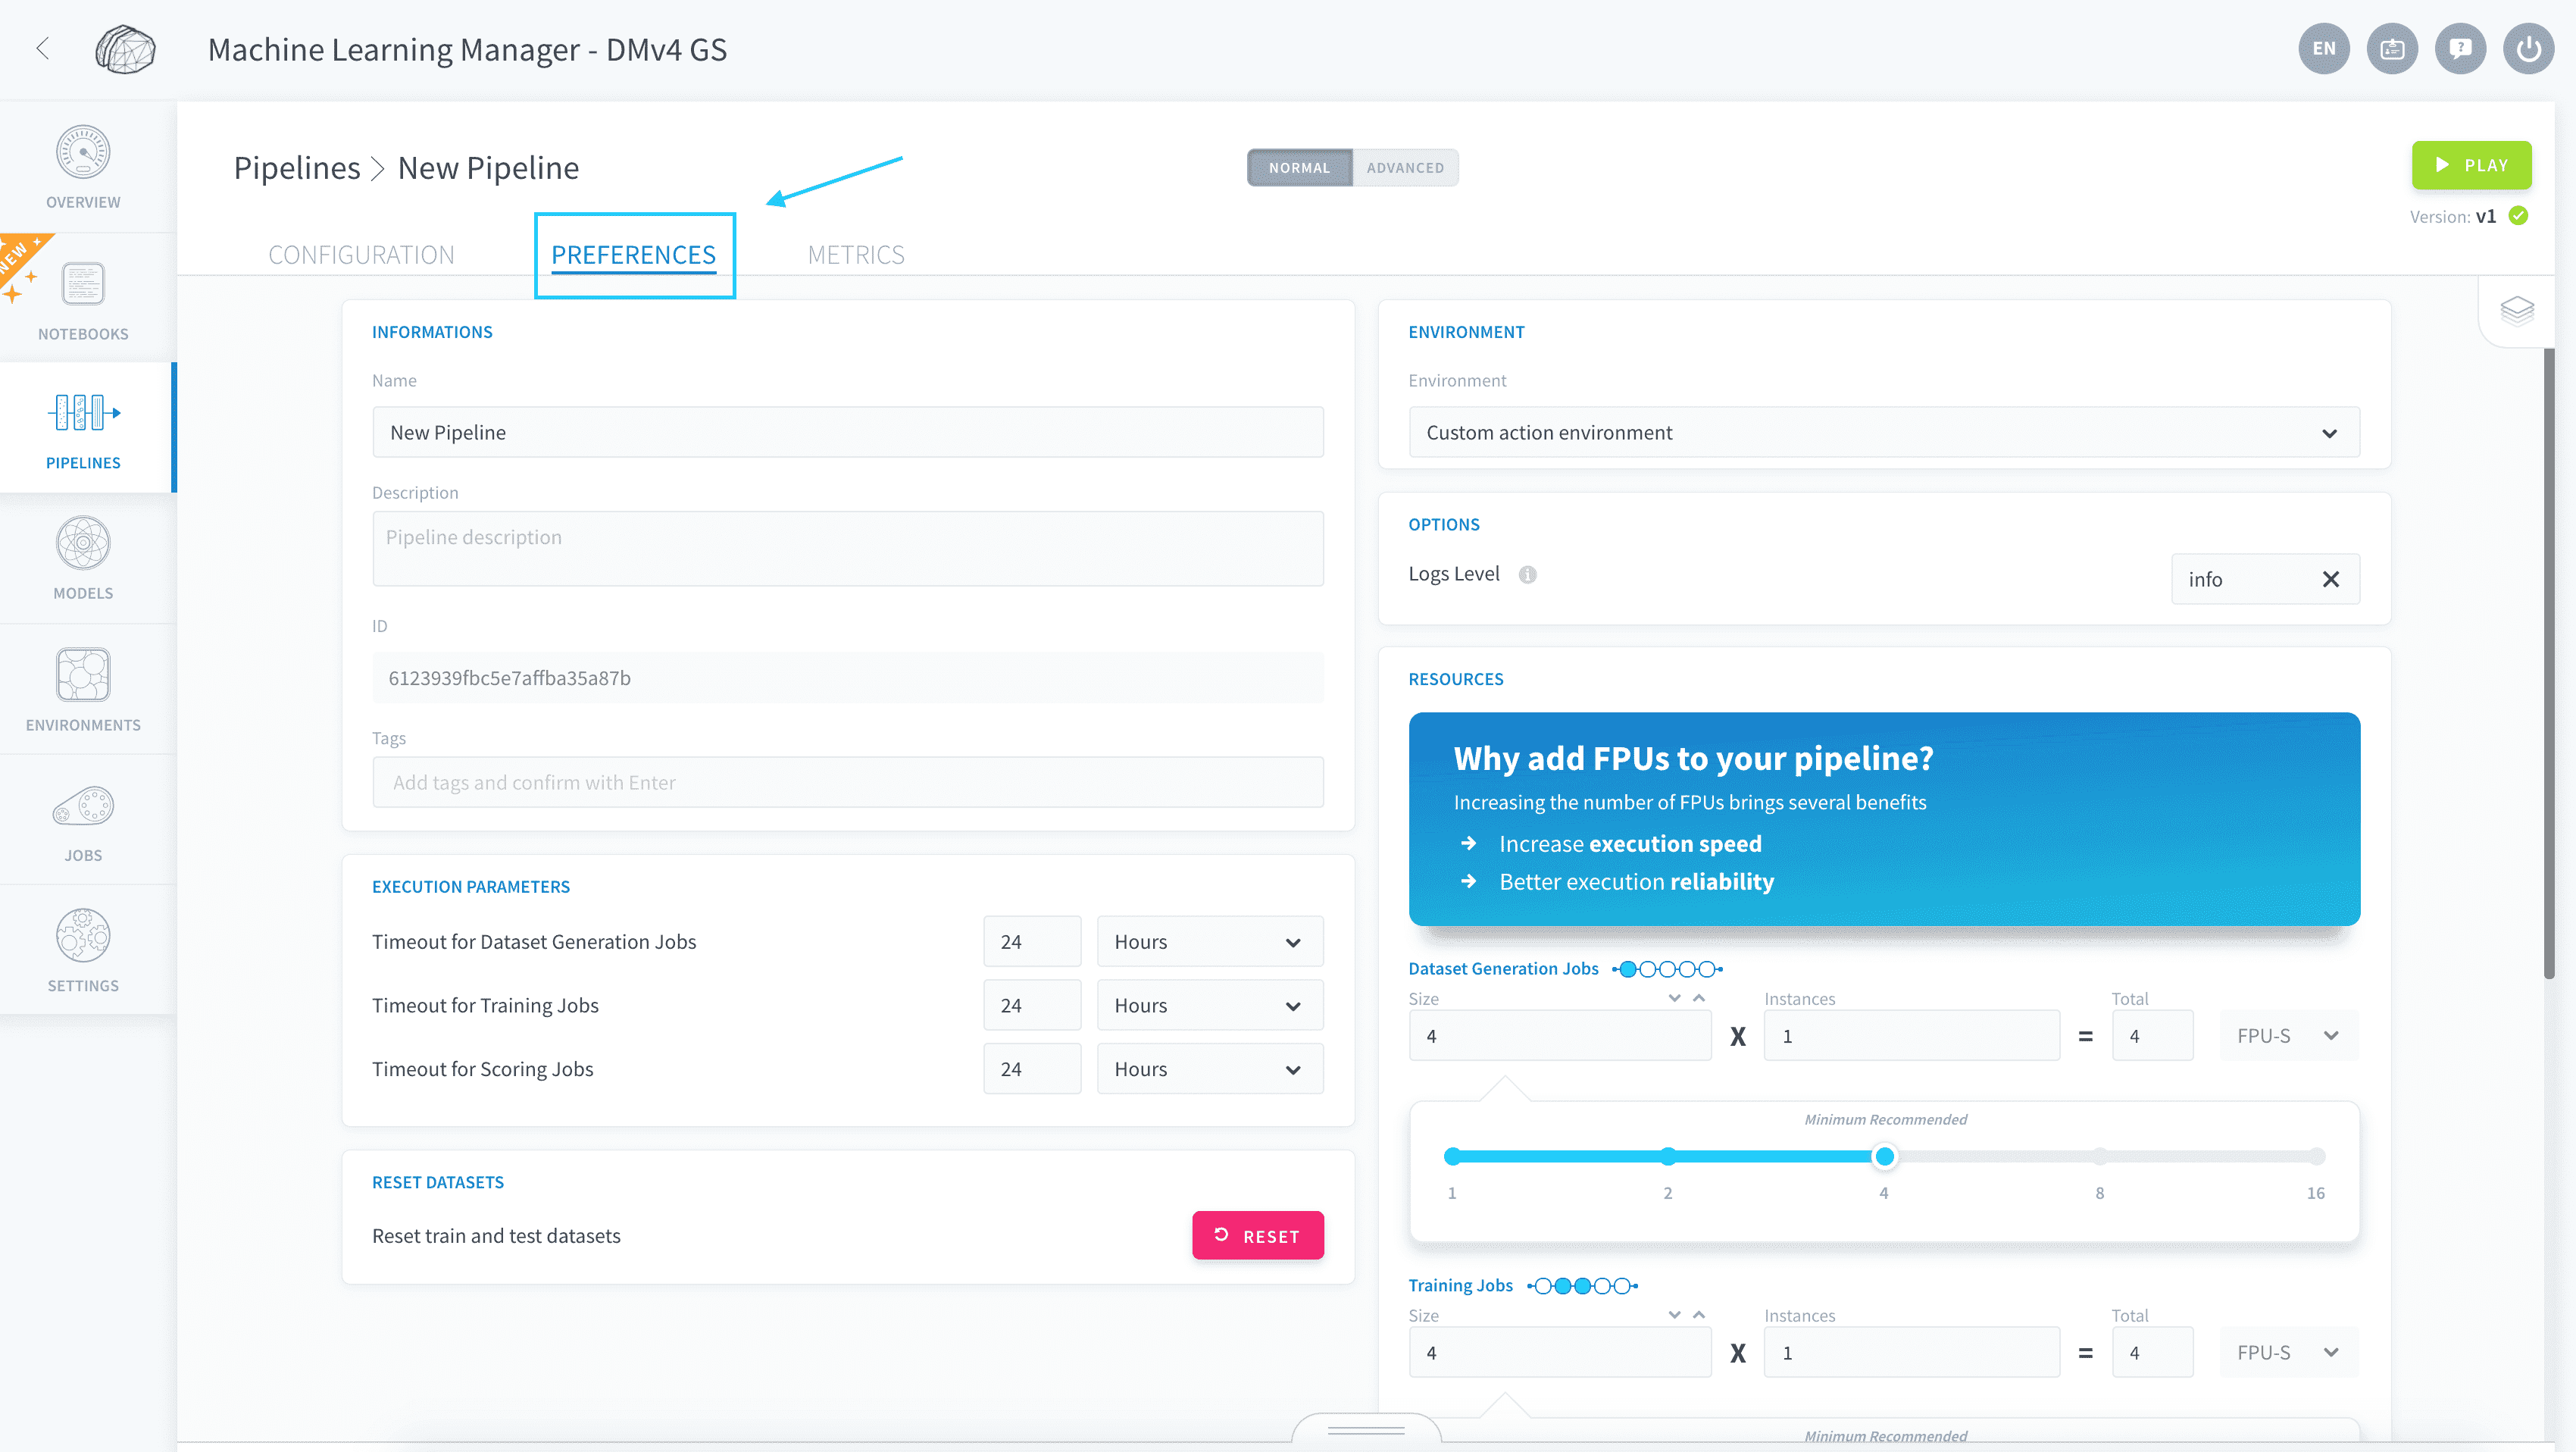
パイプラインジョブに割り当てられるFPUの量を変更するには、Preferencesタブに移動します。
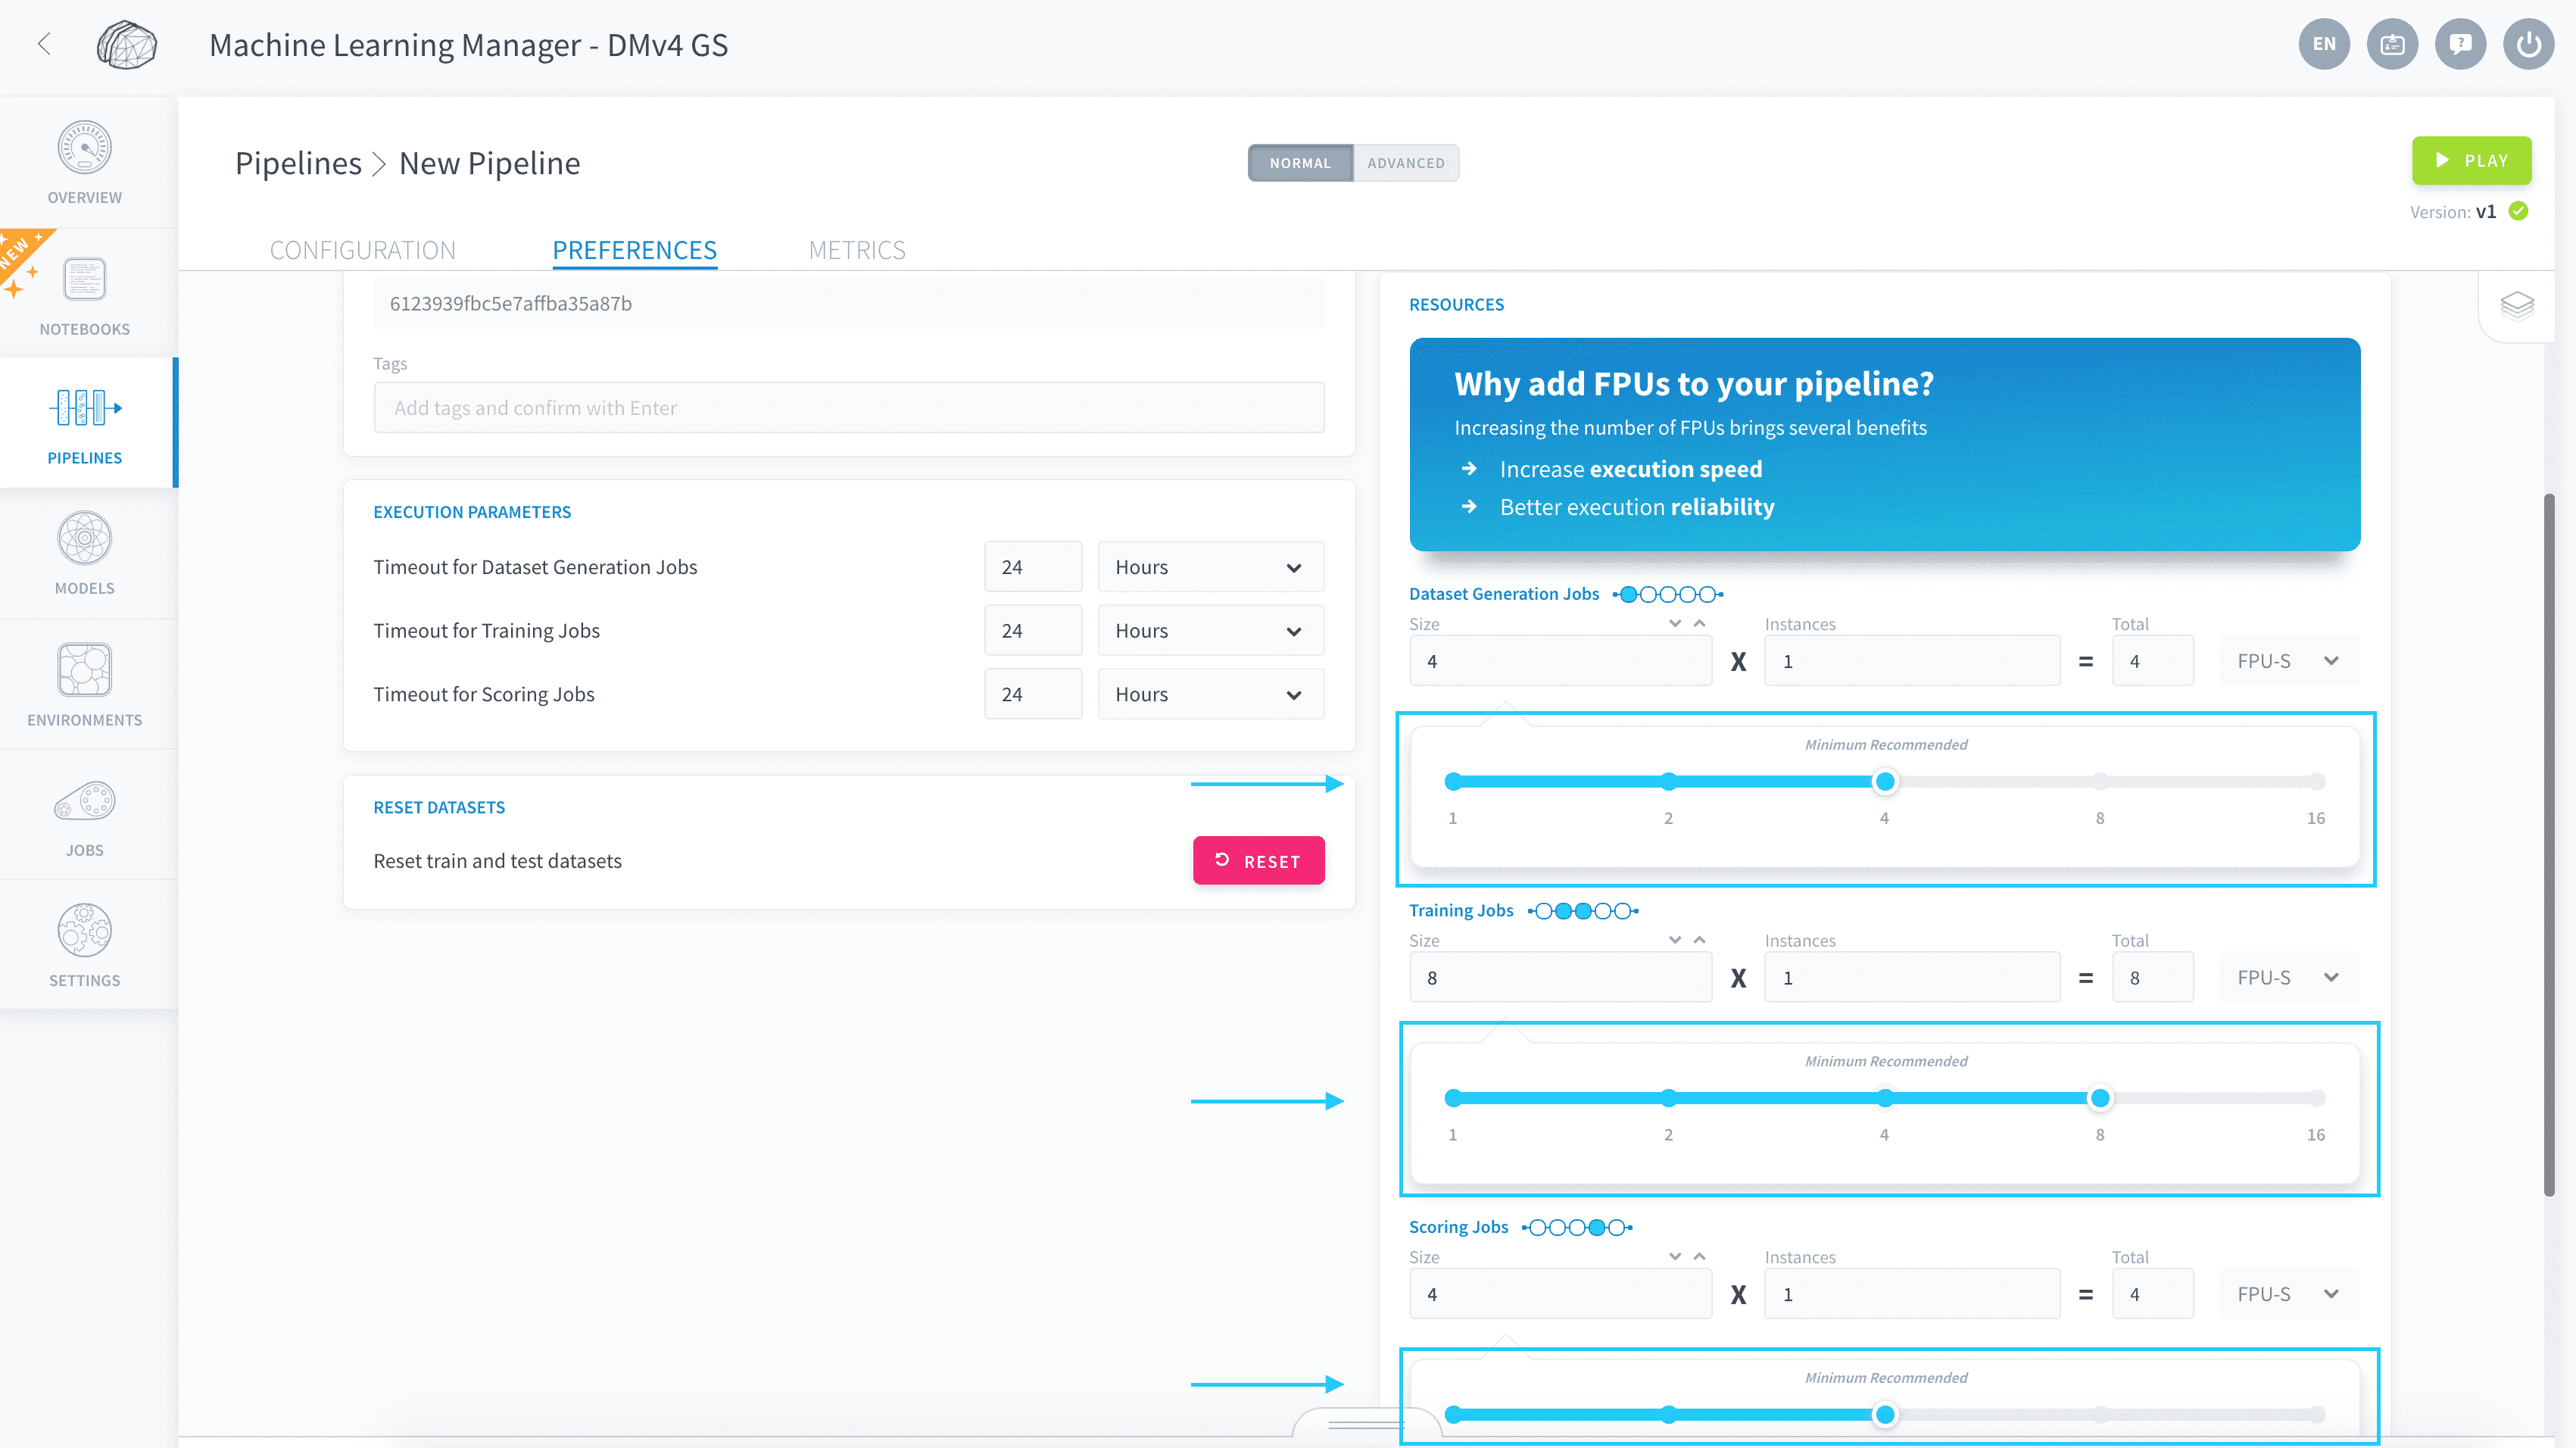
対応するスライダーを使用して、実行に割り当てる希望のFPUサイズを設定します。
処理にGPUを使用する
パイプラインを実行する際に、グラフィックス処理ユニット(GPU)を使用するように設定することで、機械学習およびデータ処理スクリプトの実行速度を大幅に向上させることができます。これを行うには、パイプラインのpreferencesで割り当てられるリソースの種類をFPU-Gに変更します。
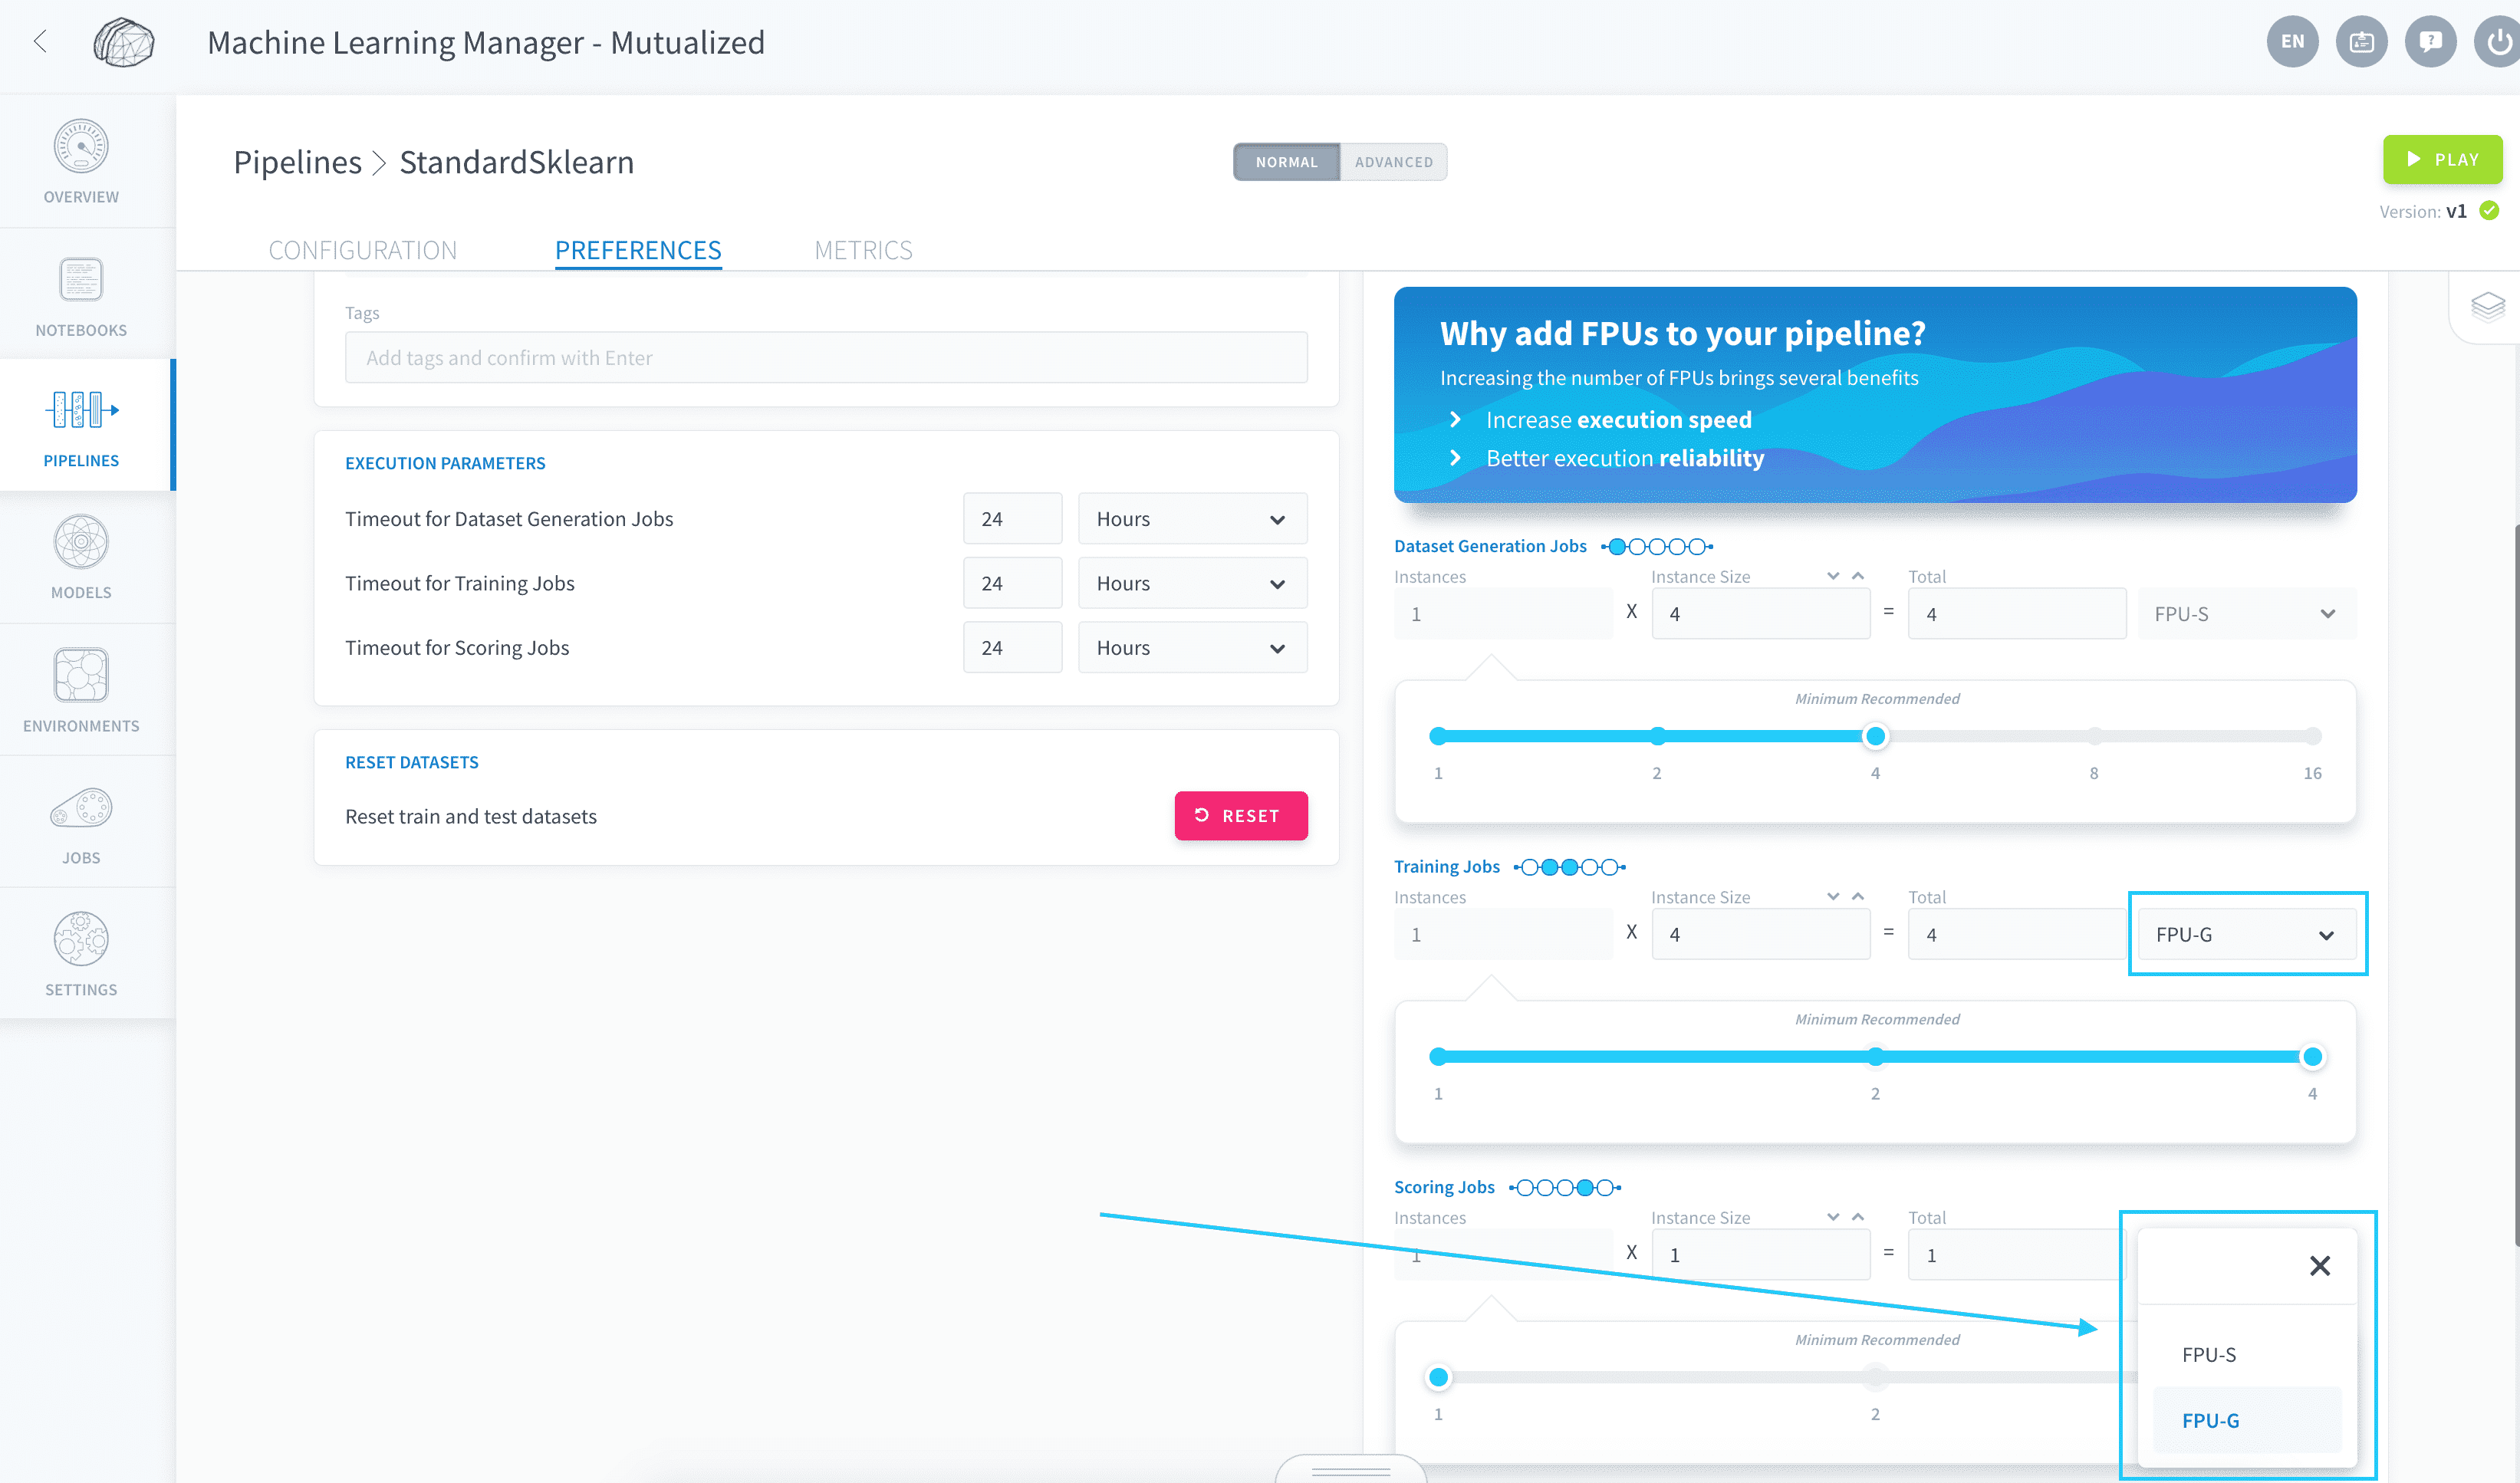
FPU-Gを使用するジョブは、通常、ビルドフェーズが長くなり、数分かかることがあります。
現在、FPU-Gはトレーニングおよびテストジョブで利用可能です。
現在、FPU-Gはすべてのクラウドプロバイダーで利用可能ではありません。Machine Learning ManagerでFPU-Gを見つけることができない場合は、サポートチームにお問い合わせください。ロードマップについての詳細をお知らせします。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術的な支援が必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして、当社のプロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼して見積もりを取得してください。
Data Platformを構築するチームと直接質問をし、フィードバックを提供し、相互作用するには、専用のDiscordチャネルに参加してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。