NYC Taxイー比較分析をPySparkで実施する
このチュートリアルでは、2025年1月の4つの異なるニューヨーク市の交通データセットを比較する分析を拡張します:Yellow Taxi
目的
このチュートリアルでは、2025年1月の4つの異なるニューヨーク市の交通データセットを比較する分析を拡張します:Yellow Taxi、Green Taxi、For-Hire Vehicle (FHV)、およびHigh Volume FHV Trip Records。これらのデータセットを包括的に比較分析することで、ニューヨーク市のライドシェア生態系におけるサービス利用の違いを理解します。
これらのデータセットは、ニューヨーク市の交通ネットワークの異なるセグメントを表しています:
- Yellow Taxi:主にマンハッタンで営業する、街頭で拾うことができる有名な黄色のタクシー
- Green Taxi:ブルックリン、クイーンズ、ブロンクス、スタテンアイランドなどの外郭区に特化した街頭タクシー
- FHV:モバイルアプリで予約できるフォーハイアベヒクル(Uber、Lyftを含む)で、すべての区をカバー
- High Volume FHV:UberやLyftなどの大規模な提供者で、非常に多くの乗車記録がある
乗車数、平均乗車時間、区ごとの乗車地点を比較することで、サービス利用パターンの主要な違いを明らかにします。この分析は、都市計画者、タクシー運営者、ライドシェア会社が市場動向と運営戦略を分析するための貴重な洞察を提供します。
このチュートリアルでは、前回のYellow Taxi分析で学んだデータのクリーンアップと結合技術を活用し、包括的な探索的データ分析(EDA)を実施し、可視化を作成して、異なる交通モードの利用パターンを強調します。
必要条件
この比較分析を開始する前に、以下の準備が整っていることを確認してください:
- データセットアップ:4つのデータセット(
yellow_tripdata_2025_01.parquet、green_tripdata_2025_01.parquet、fhv_tripdata_2025_01.parquet、fhvhv_tripdata_2025_01.parquet)とtaxi_zone_lookup.csvファイルが、Connectorsに読み込まれ、Lakehouse Managerでアクセス可能であること。これらのデータセットは、公式のNYC TLC Trip Record Dataウェブサイトからダウンロードできます。
- 環境:OVHcloud Data Platform上で設定されたPySpark対応のJupyterノートブック
- 前回のチュートリアル:NYC Yellow Taxi Dataset Analysisチュートリアルを完了し、基礎的な理解を得ていること
前回のチュートリアルのステップ1-3に従って、データセットアップが完了していない場合は、以下の手順を実行してください:
- データセットをConnectorsにアップロード
- Lakehouse Managerでテーブルを作成
- Data Processing Engine(DPE)でロードアクションを設定
ステップバイステップチュートリアル
以下に、各ステップについて詳細な説明付きの完全なPySparkコードを提供します。OVHcloud Data Platform上の新しいJupyterノートブックにコピー&ペーストしてください。各セクションには、比較分析プロセスを案内するための包括的なコメントと説明が含まれています。
ステップ1:環境設定とデータ接続
PySparkセッションを初期化し、4つの交通データセットにアクセスするための接続を確立します。
import logging
from forepaas.dwh import connect
from pyspark.sql import SparkSession
from pyspark.sql.functions import lit, col, hour, dayofweek, unix_timestamp, avg, count, sum, when
from pyspark.sql.window import Window
from pyspark.sql.functions import row_number
import matplotlib.pyplot as plt
import seaborn as sns
import pandas as pd

# Configuration variables
DATASET = "default_dataset"
PROJECT_ID = "PROJECT_ID"  # Replace with your actual Project ID
YEAR = "2025"
MONTH = "01"

# Set up logging for debugging
logging.basicConfig(level=logging.INFO, format='%(asctime)s - %(levelname)s - %(message)s')

# Initialize SparkSession
try:
    spark = SparkSession.builder.appName("NYC_Taxi_Comparative_Analysis").getOrCreate()
    logging.info(f"Spark Version: {spark.version}")
except Exception as e:
    logging.error(f"Failed to initialize SparkSession: {e}")
    raise

# Connect to Lakehouse
try:
    cn_prim = connect(f"dwh/{DATASET}/")
    logging.info(f"Connected to Lakehouse - Dataset: {DATASET}")
except Exception as e:
    logging.error(f"Failed to connect to Lakehouse - Dataset: {DATASET} | {e}")
    raise
このコードの機能:
- データ処理と可視化に必要なライブラリをインポート
- デバッグとモニタリングのためのログ設定
- 大規模データ処理に最適化されたPySparkセッションの初期化
- OVHcloud Data Platform Lakehouseへの接続の確立
ステップ2:データ読み込みと初期検査
4つの交通データセットとタクシーゾーンのルックアップテーブルを読み込み、正常に読み込まれたことを確認し、スキーマを検査します。
# Load all datasets from the Lakehouse
yellow_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.yellow_tripdata_2025_01")
green_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.green_tripdata_2025_01")
fhv_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.fhv_tripdata_2025_01")
fhvhv_df = cn_prim.query(f"SELECT * FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.fhvhv_tripdata_2025_01")
taxi_zones_df = cn_prim.query(f"SELECT LocationID, Borough, Zone FROM db_{PROJECT_ID}_{DATASET}.{DATASET}.taxi_zone_lookup")

# Cache DataFrames for improved performance
yellow_df.cache()
green_df.cache()
fhv_df.cache()
fhvhv_df.cache()
taxi_zones_df.cache()

# Verify successful data loading
logging.info(f"Yellow Taxi Records: {yellow_df.count():,}")
logging.info(f"Green Taxi Records: {green_df.count():,}")
logging.info(f"FHV Records: {fhv_df.count():,}")
logging.info(f"High Volume FHV Records: {fhvhv_df.count():,}")
logging.info(f"Taxi Zones Records: {taxi_zones_df.count():,}")

# Inspect dataset schemas
print("=== DATASET SCHEMAS ===")
print("\nYellow Taxi Schema:")
yellow_df.printSchema()
print("\nGreen Taxi Schema:")
green_df.printSchema()
print("\nFHV Schema:")
fhv_df.printSchema()
print("\nHigh Volume FHV Schema:")
fhvhv_df.printSchema()
print("\nTaxi Zones Schema:")
taxi_zones_df.printSchema()
予想される出力:
- Yellow Taxi:約3,475,226レコード
- Green Taxi:約48,326レコード(注:著しく小さい、可能性としては部分的なデータセット)
- FHV:約1,894,659レコード
- High Volume FHV:約20,405,666レコード(最大のデータセット)
- Taxi Zones:265レコード
重要性:
- キャッシュは、特にHigh Volume FHVデータセットにとって、繰り返し操作のパフォーマンスを向上させるために重要です
- スキーマ検査により、標準化が必要な列の違いが明らかになります
- レコード数は、各交通モードの相対的な規模を理解するのに役立ちます
ステップ3:データクリーンと標準化
各データセットをクリーンアップし、無効なレコードを削除し、列名とデータ型を標準化して、すべての交通モードにわたる一貫した分析を実現します。
# Clean Yellow Taxi DataFrame
yellow_df_clean = yellow_df.filter(
    (col("tpep_pickup_datetime").isNotNull()) &
    (col("tpep_dropoff_datetime").isNotNull()) &
    (col("passenger_count").isNotNull()) &
    (col("passenger_count") > 0) &
    (col("trip_distance") > 0) &
    (col("fare_amount") > 0)
).withColumn("pickup_datetime", col("tpep_pickup_datetime")) \
 .withColumn("dropoff_datetime", col("tpep_dropoff_datetime")) \
 .withColumn("trip_duration", unix_timestamp("tpep_dropoff_datetime") - unix_timestamp("tpep_pickup_datetime")) \
 .withColumn("pickup_hour", hour("tpep_pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("tpep_pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Clean Green Taxi DataFrame
green_df_clean = green_df.filter(
    (col("lpep_pickup_datetime").isNotNull()) &
    (col("lpep_dropoff_datetime").isNotNull()) &
    (col("passenger_count").isNotNull()) &
    (col("passenger_count") > 0) &
    (col("trip_distance") > 0) &
    (col("fare_amount") > 0)
).withColumn("pickup_datetime", col("lpep_pickup_datetime")) \
 .withColumn("dropoff_datetime", col("lpep_dropoff_datetime")) \
 .withColumn("trip_duration", unix_timestamp("lpep_dropoff_datetime") - unix_timestamp("lpep_pickup_datetime")) \
 .withColumn("pickup_hour", hour("lpep_pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("lpep_pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Clean FHV DataFrame (Note: PULocationID is string, cast to double)
fhv_df_clean = fhv_df.filter(
    (col("pickup_datetime").isNotNull()) &
    (col("dropoff_datetime").isNotNull()) &
    (col("pulocationid").isNotNull())
).withColumn("trip_duration", unix_timestamp("dropoff_datetime") - unix_timestamp("pickup_datetime")) \
 .withColumn("pickup_hour", hour("pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Clean High Volume FHV DataFrame (uses trip_miles instead of trip_distance)
fhvhv_df_clean = fhvhv_df.filter(
    (col("pickup_datetime").isNotNull()) &
    (col("dropoff_datetime").isNotNull()) &
    (col("trip_miles").isNotNull()) &
    (col("trip_miles") > 0) &
    (col("pulocationid").isNotNull())
).withColumn("trip_duration", unix_timestamp("dropoff_datetime") - unix_timestamp("pickup_datetime")) \
 .withColumn("trip_distance", col("trip_miles")) \
 .withColumn("pickup_hour", hour("pickup_datetime")) \
 .withColumn("day_of_week", dayofweek("pickup_datetime")) \
 .withColumn("PULocationID", col("pulocationid").cast("double"))

# Apply consistent outlier filtering and capping for all datasets
yellow_df_clean = yellow_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("trip_distance") >= 0.1) &
    (col("trip_distance").isNotNull()) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration"))) \
 .withColumn("trip_distance", when(col("trip_distance") > 50, 50).otherwise(col("trip_distance")))

green_df_clean = green_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("trip_distance") >= 0.1) &
    (col("trip_distance").isNotNull()) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration"))) \
 .withColumn("trip_distance", when(col("trip_distance") > 50, 50).otherwise(col("trip_distance")))

fhv_df_clean = fhv_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration")))

fhvhv_df_clean = fhvhv_df_clean.filter(
    (col("trip_duration") >= 60) &
    (col("trip_distance") >= 0.1) &
    (col("pickup_hour").isNotNull()) &
    (col("PULocationID").isNotNull())
).withColumn("trip_duration", when(col("trip_duration") > 3600, 3600).otherwise(col("trip_duration"))) \
 .withColumn("trip_distance", when(col("trip_distance") > 50, 50).otherwise(col("trip_distance")))

# Verify cleaned data counts
logging.info("=== CLEANED DATA COUNTS ===")
logging.info(f"Cleaned Yellow Taxi Records: {yellow_df_clean.count():,}")
logging.info(f"Cleaned Green Taxi Records: {green_df_clean.count():,}")
logging.info(f"Cleaned FHV Records: {fhv_df_clean.count():,}")
logging.info(f"Cleaned High Volume FHV Records: {fhvhv_df_clean.count():,}")
主要なクリーンアップステップ:
- 無効なレコードの削除:Nullの日時、距離が0、乗客数が負の値
- 列の標準化:一貫した
pickup_datetime、trip_duration、pickup_hour、day_of_week、およびPULocationIDを作成
- スキーマの違いを処理:FHVデータセットの
PULocationIDをdoubleにキャスト、High Volume FHVのtrip_milesをtrip_distanceにリネーム
- アウトライアの制限:1時間(3600秒)と50マイルに乗車時間と距離を制限し、極端な値の影響を軽減
- エッジケースのフィルタリング:60秒未満の乗車時間または0.1マイル未満の距離を除外
ステップ4:タクシーゾーン結合による地理的コンテキスト
各クリーンアップ済みデータセットをタクシーゾーンのルックアップテーブルと結合し、地理的分析のための区と区情報を追加します。
# Join all datasets with taxi zones for pickup location context
yellow_df_clean = yellow_df_clean.join(taxi_zones_df, yellow_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

green_df_clean = green_df_clean.join(taxi_zones_df, green_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

fhv_df_clean = fhv_df_clean.join(taxi_zones_df, fhv_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

fhvhv_df_clean = fhvhv_df_clean.join(taxi_zones_df, fhvhv_df_clean.PULocationID == taxi_zones_df.LocationID, "left") \
    .withColumnRenamed("Borough", "pickup_borough") \
    .withColumnRenamed("Zone", "pickup_zone") \
    .drop("LocationID")

# Filter out records with invalid or unknown geographic information
yellow_df_clean = yellow_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

green_df_clean = green_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

fhv_df_clean = fhv_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

fhvhv_df_clean = fhvhv_df_clean.filter(
    (col("pickup_zone") != "Unknown") &
    (col("pickup_borough") != "Unknown") &
    (col("pickup_borough") != "N/A") &
    (col("pickup_borough").isNotNull())
)

# Verify final cleaned data after geographic filtering
logging.info("=== FINAL CLEANED DATA COUNTS ===")
logging.info(f"Final Yellow Taxi Records: {yellow_df_clean.count():,}")
logging.info(f"Final Green Taxi Records: {green_df_clean.count():,}")
logging.info(f"Final FHV Records: {fhv_df_clean.count():,}")
logging.info(f"Final High Volume FHV Records: {fhvhv_df_clean.count():,}")
地理的コンテキストの重要性:
- 市場分析:各サービスが主にどの区をサービスしているかを理解する
- 運営の洞察:リソース配分のための需要の高いゾーンを特定する
- 競合分析:異なる地域でのサービス浸透度を比較する
- 都市計画:交通インフラの決定を支援する
ステップ5:包括的な探索的データ分析(EDA)
すべての4つの交通モードにわたって包括的な比較分析を実施し、利用パターン、市場シェア、運営特性を特定します。
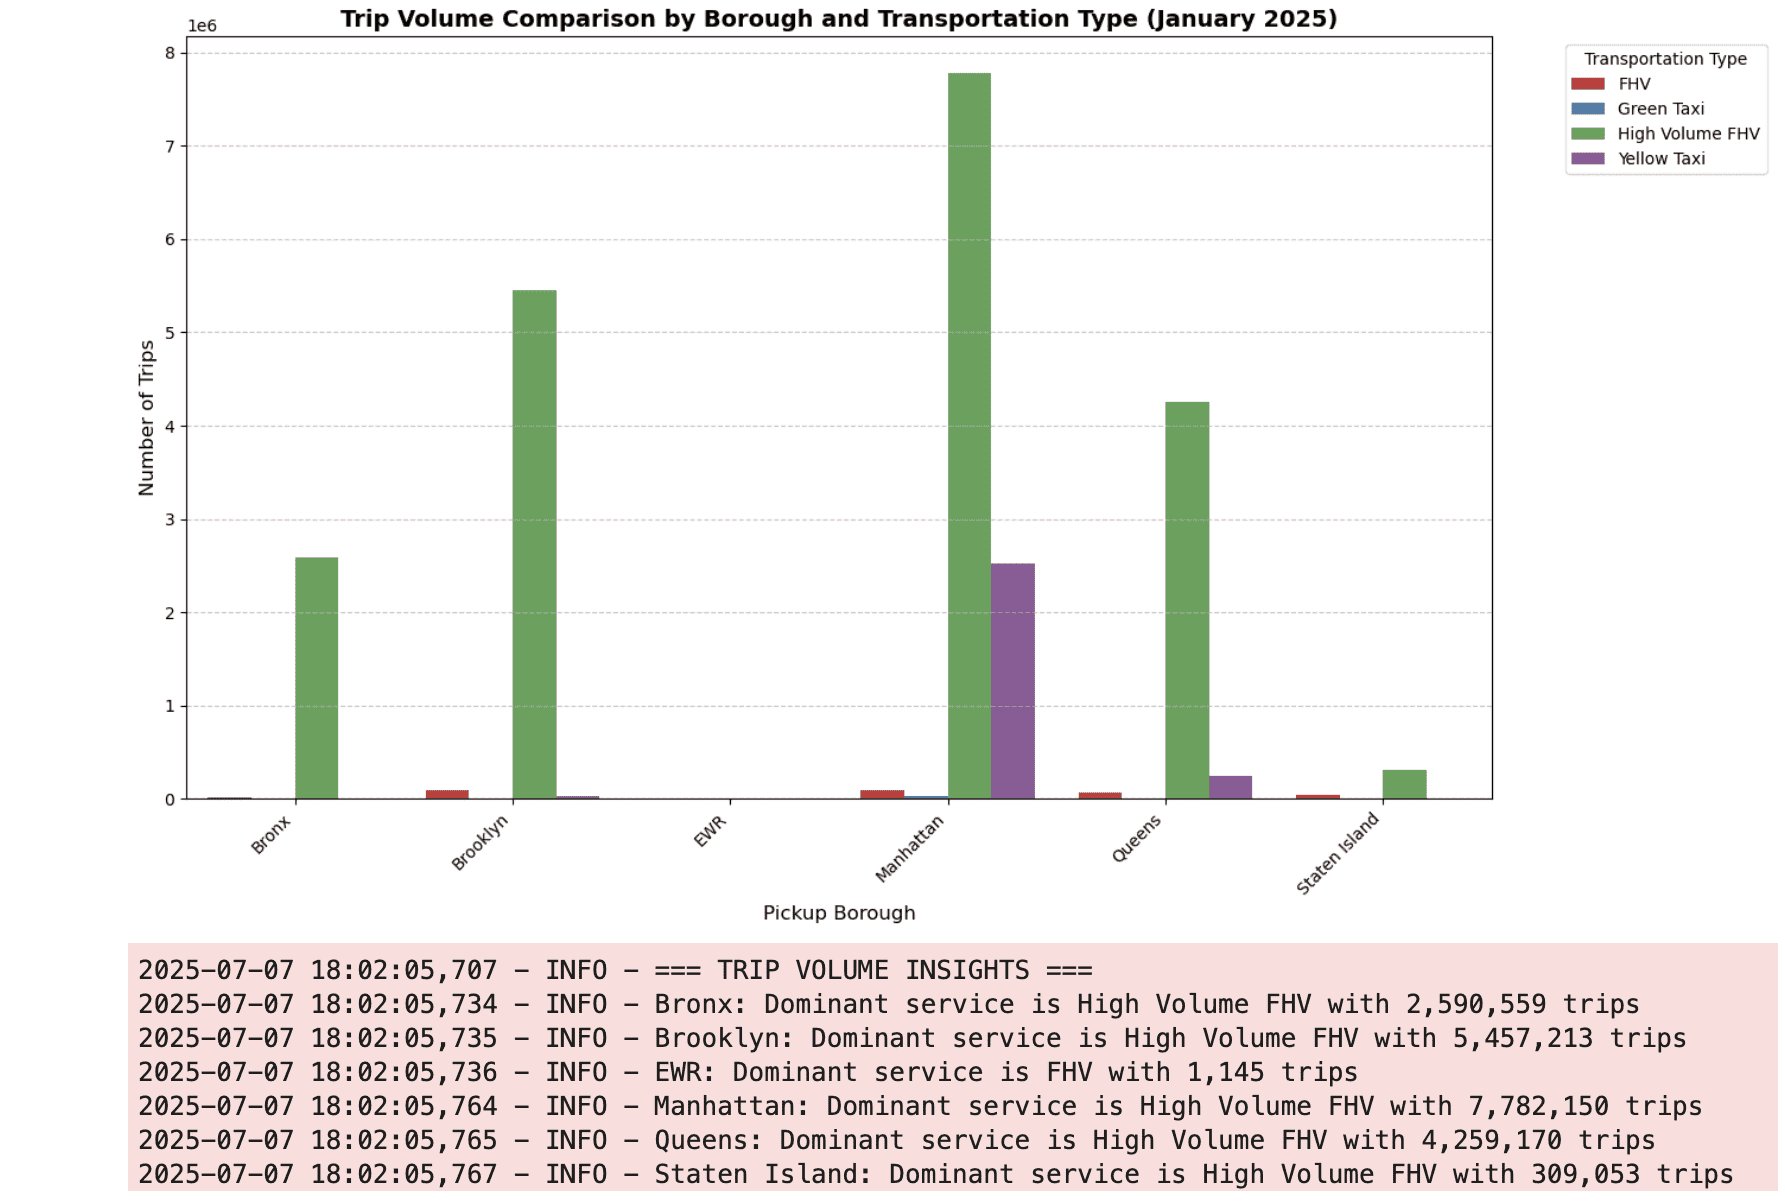
分析1:区別の乗車数比較
# Add trip_type identifier to each dataset
yellow_df_clean = yellow_df_clean.withColumn("trip_type", lit("Yellow Taxi"))
green_df_clean = green_df_clean.withColumn("trip_type", lit("Green Taxi"))
fhv_df_clean = fhv_df_clean.withColumn("trip_type", lit("FHV"))
fhvhv_df_clean = fhvhv_df_clean.withColumn("trip_type", lit("High Volume FHV"))

# Create unified dataset for comparative analysis
# Note: Excluding trip_distance as FHV dataset lacks this field
combined_df = yellow_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type") \
    .union(green_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type")) \
    .union(fhv_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type")) \
    .union(fhvhv_df_clean.select("pickup_borough", "trip_duration", "pickup_hour", "day_of_week", "pickup_zone", "trip_type"))

# Calculate trip volume by borough and taxi type
trip_volume_by_borough = combined_df.groupBy("trip_type", "pickup_borough") \
    .agg(count("*").alias("num_trips")) \
    .orderBy("pickup_borough", "trip_type")

# Convert to Pandas for visualization
trip_volume_by_bpd = trip_volume_by_borough.toPandas()

# Create comprehensive visualization
plt.figure(figsize=(14, 8))
sns.barplot(data=trip_volume_by_bpd, x="pickup_borough", y="num_trips", hue="trip_type", palette="Set1")
plt.xlabel("Pickup Borough", fontsize=12)
plt.ylabel("Number of Trips", fontsize=12)
plt.title("Trip Volume Comparison by Borough and Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.xticks(rotation=45, ha='right')
plt.legend(title="Transportation Type", bbox_to_anchor=(1.05, 1), loc='upper left')
plt.grid(axis='y', linestyle='--', alpha=0.7)
plt.tight_layout()
plt.show()

# Log key insights
logging.info("=== TRIP VOLUME INSIGHTS ===")
for borough in trip_volume_by_bpd["pickup_borough"].unique():
    borough_data = trip_volume_by_bpd[trip_volume_by_bpd["pickup_borough"] == borough]
    dominant_service = borough_data.loc[borough_data["num_trips"].idxmax()]
    logging.info(f"{borough}: Dominant service is {dominant_service['trip_type']} with {dominant_service['num_trips']:,} trips")
分析2:平均乗車時間の比較
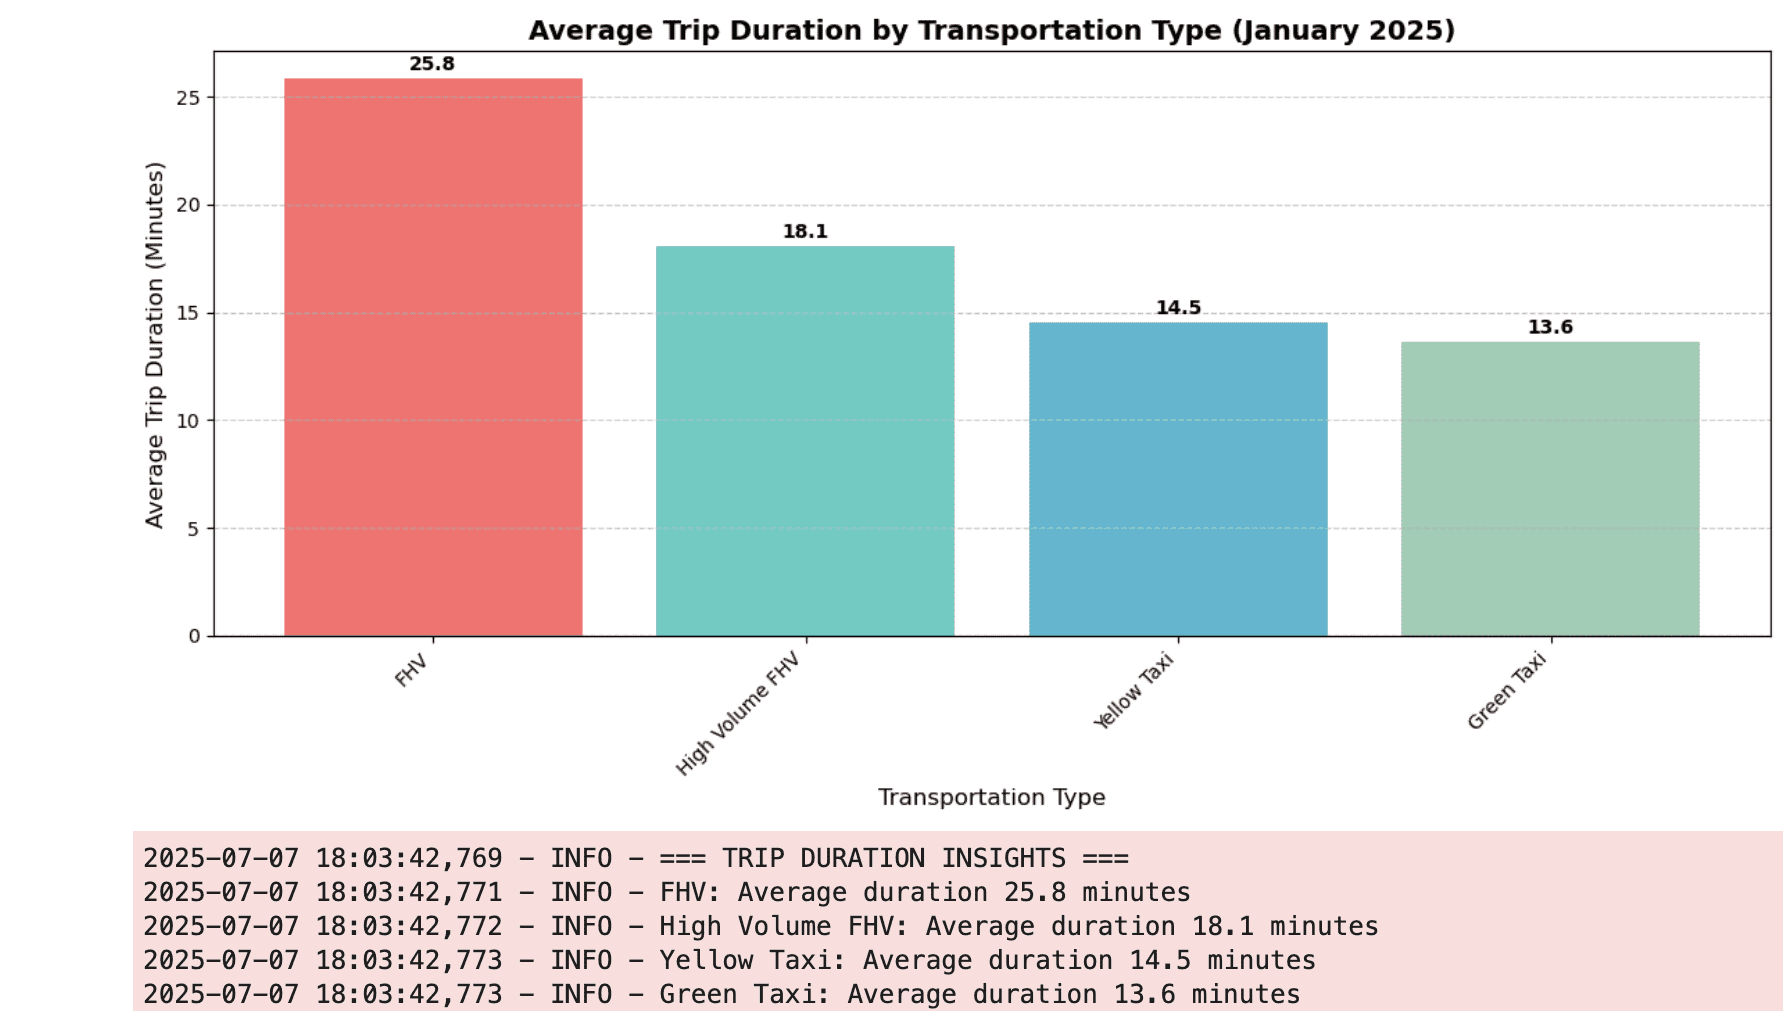
# Calculate average trip duration by transportation type
duration_by_type = combined_df.groupBy("trip_type") \
    .agg(avg("trip_duration").alias("avg_duration_seconds")) \
    .orderBy("avg_duration_seconds", ascending=False)

# Convert to Pandas and add minutes column
duration_by_type_pd = duration_by_type.toPandas()
duration_by_type_pd["avg_duration_minutes"] = duration_by_type_pd["avg_duration_seconds"] / 60

# Create visualization
plt.figure(figsize=(12, 6))
bars = plt.bar(duration_by_type_pd["trip_type"], duration_by_type_pd["avg_duration_minutes"],
               color=['#FF6B6B', '#4ECDC4', '#45B7D1', '#96CEB4'])
plt.xlabel("Transportation Type", fontsize=12)
plt.ylabel("Average Trip Duration (Minutes)", fontsize=12)
plt.title("Average Trip Duration by Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.xticks(rotation=45, ha='right')
plt.grid(axis='y', linestyle='--', alpha=0.7)

# Add value labels on bars
for bar, value in zip(bars, duration_by_type_pd["avg_duration_minutes"]):
    plt.text(bar.get_x() + bar.get_width()/2, bar.get_height() + 0.2,
             f'{value:.1f}', ha='center', va='bottom', fontweight='bold')

plt.tight_layout()
plt.show()

# Log duration insights
logging.info("=== TRIP DURATION INSIGHTS ===")
for _, row in duration_by_type_pd.iterrows():
    logging.info(f"{row['trip_type']}: Average duration {row['avg_duration_minutes']:.1f} minutes")
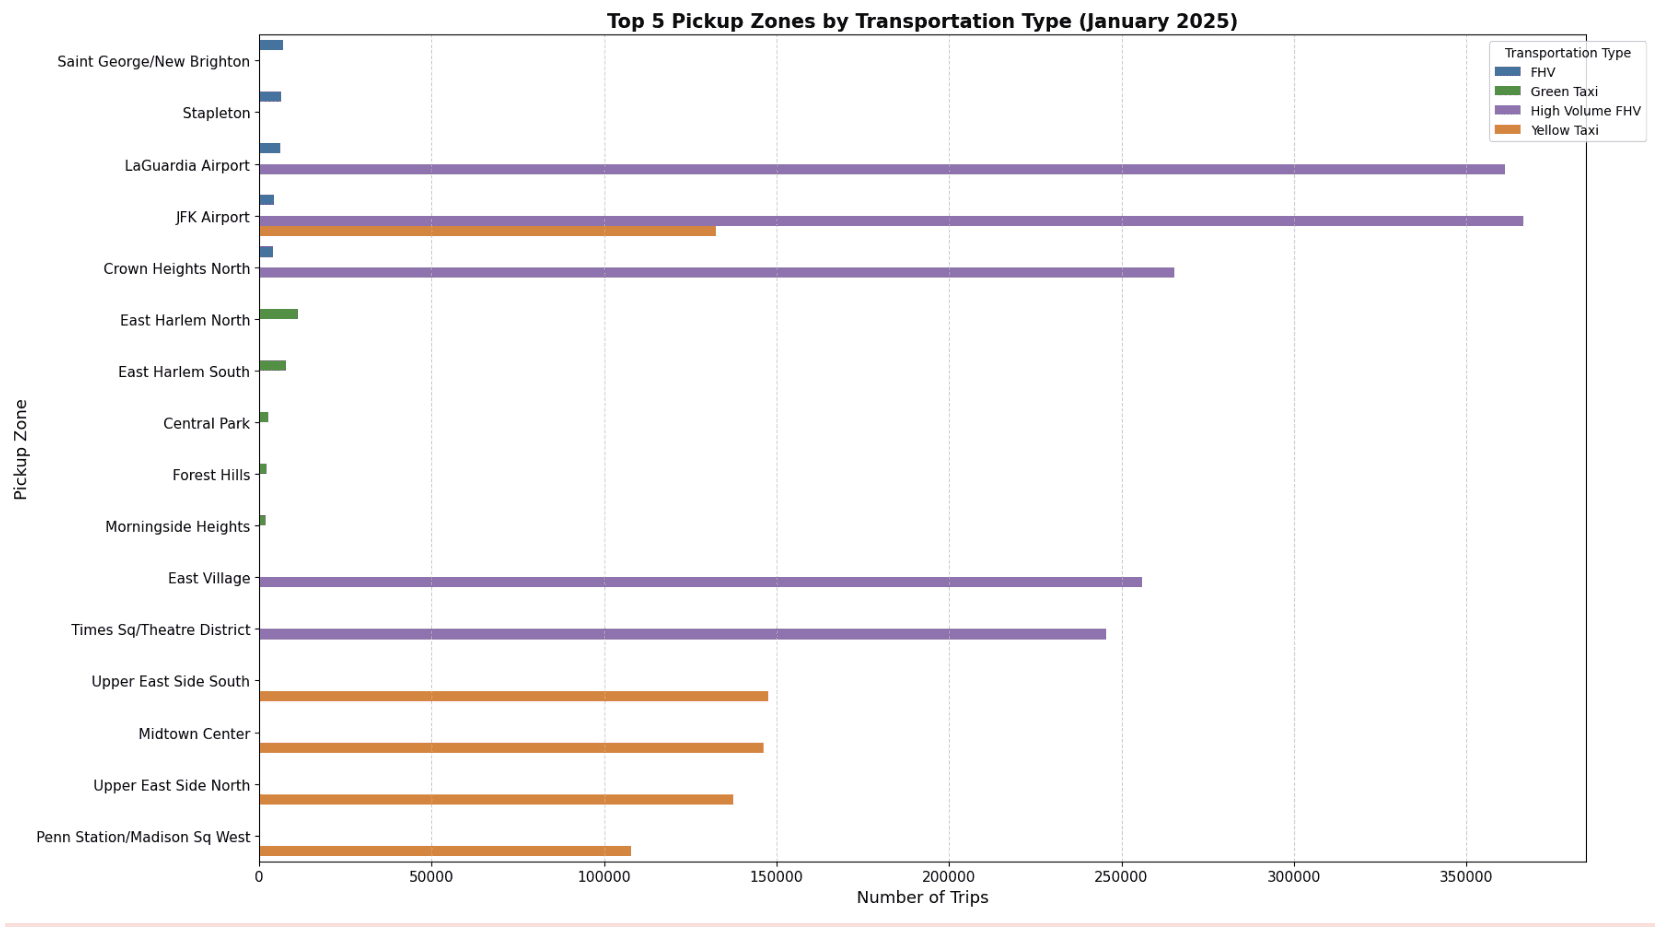
分析3:交通タイプ別の主要な乗車地点
# Calculate top pickup zones for each transportation type
zone_trips_by_type = combined_df.groupBy("trip_type", "pickup_zone") \
    .agg(count("*").alias("num_trips")) \
    .orderBy("trip_type", "num_trips", ascending=[True, False])

# Select top 5 zones per transportation type using window function
windowSpec = Window.partitionBy("trip_type").orderBy(col("num_trips").desc())
zone_trips_top5 = zone_trips_by_type.withColumn("rank", row_number().over(windowSpec)) \
    .filter(col("rank") <= 5) \
    .drop("rank")

# Convert to Pandas for visualization
zone_trips_top5_pd = zone_trips_top5.toPandas()

# Create comprehensive visualization
plt.figure(figsize=(16, 10))
sns.barplot(data=zone_trips_top5_pd, x="num_trips", y="pickup_zone", hue="trip_type", palette="Set3")
plt.xlabel("Number of Trips", fontsize=12)
plt.ylabel("Pickup Zone", fontsize=12)
plt.title("Top 5 Pickup Zones by Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.legend(title="Transportation Type", bbox_to_anchor=(1.05, 1), loc='upper left')
plt.grid(axis='x', linestyle='--', alpha=0.7)
plt.tight_layout()
plt.show()

# Log top zones for each service
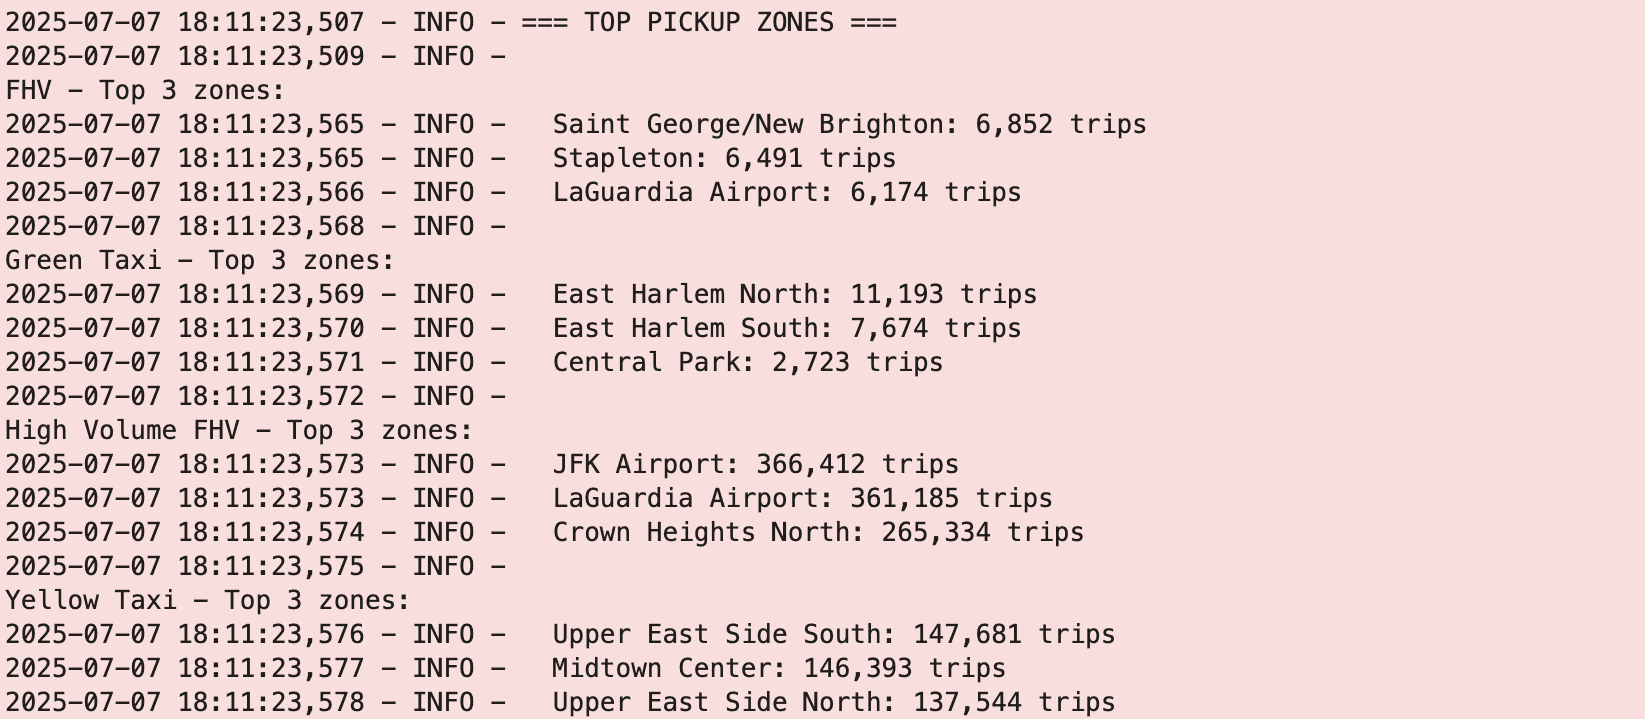
logging.info("=== TOP PICKUP ZONES ===")
for trip_type in zone_trips_top5_pd["trip_type"].unique():
    top_zones = zone_trips_top5_pd[zone_trips_top5_pd["trip_type"] == trip_type].head(3)
    logging.info(f"\n{trip_type} - Top 3 zones:")
    for _, zone in top_zones.iterrows():
        logging.info(f"  {zone['pickup_zone']}: {zone['num_trips']:,} trips")
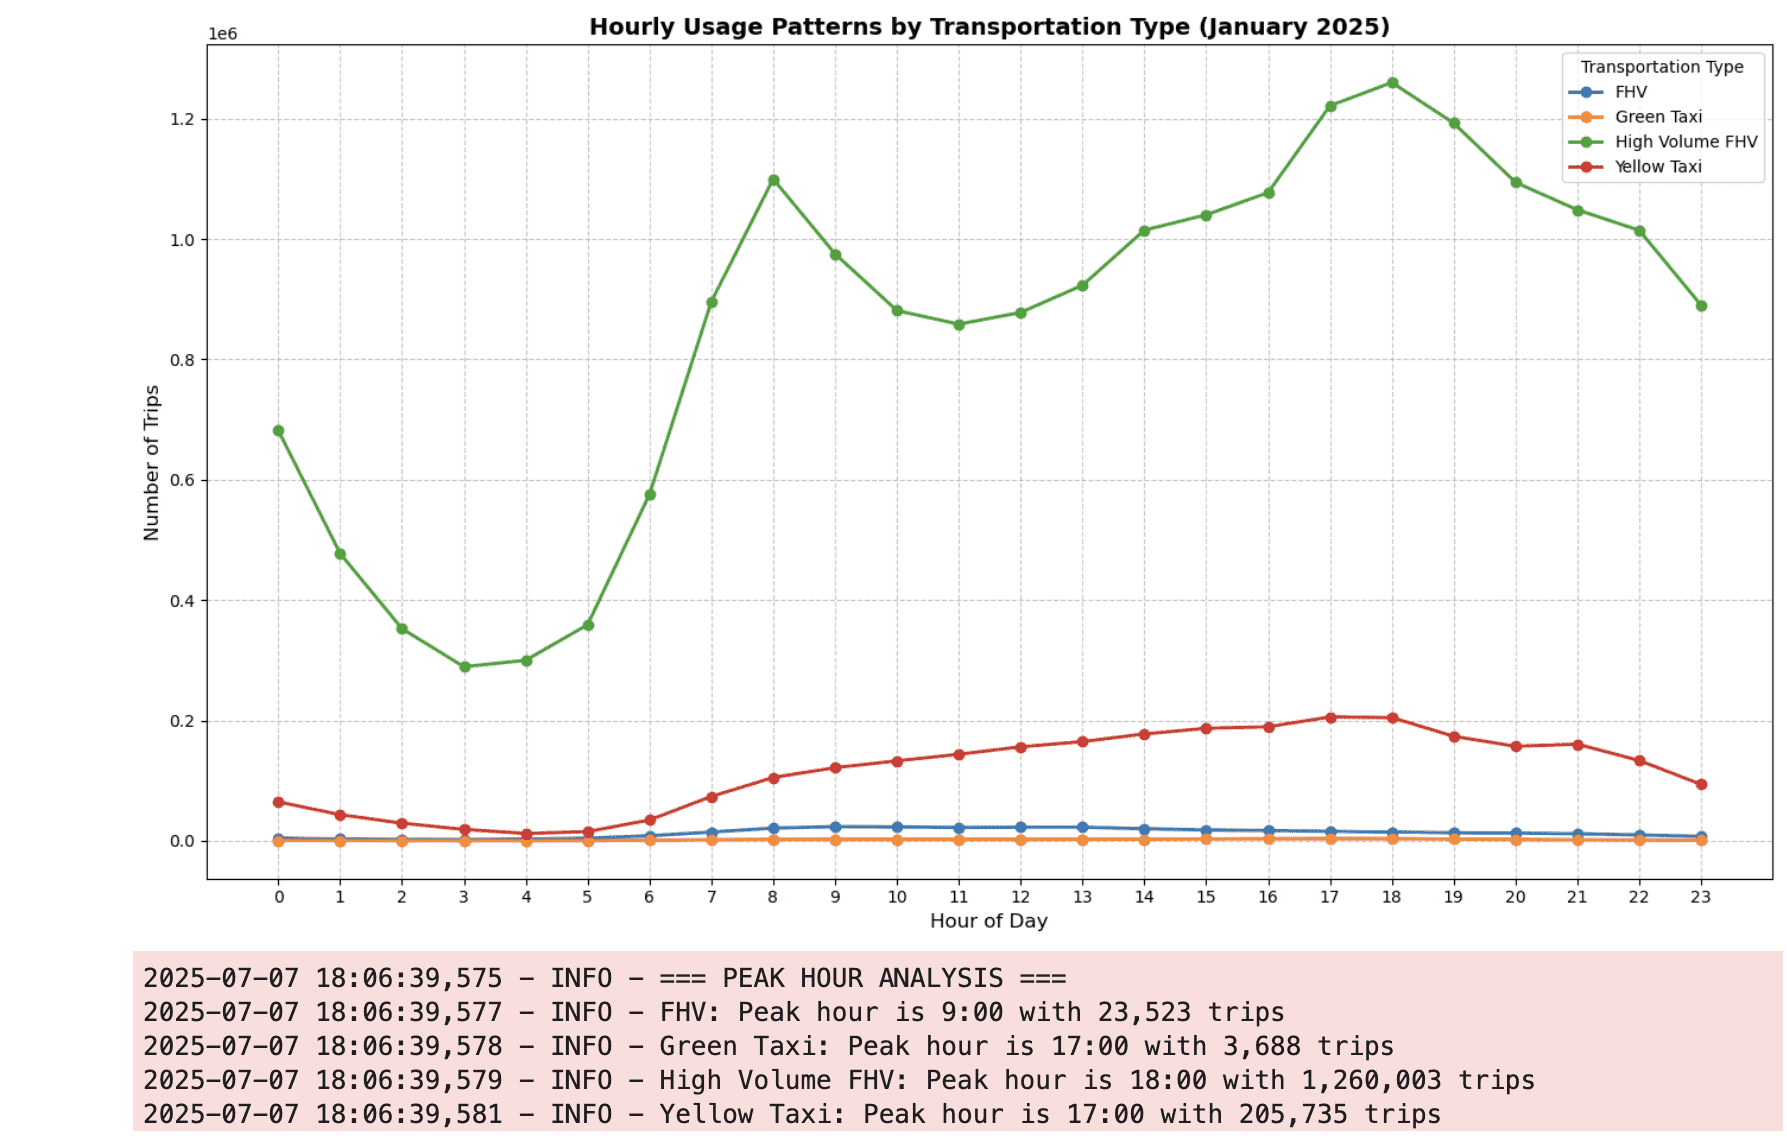
分析4:時間帯別の利用パターン
# Analyze hourly usage patterns by transportation type
hourly_usage = combined_df.groupBy("trip_type", "pickup_hour") \
    .agg(count("*").alias("num_trips")) \
    .orderBy("trip_type", "pickup_hour")

# Convert to Pandas
hourly_usage_pd = hourly_usage.toPandas()

# Create line plot showing hourly patterns
plt.figure(figsize=(14, 8))
for trip_type in hourly_usage_pd["trip_type"].unique():
    data = hourly_usage_pd[hourly_usage_pd["trip_type"] == trip_type]
    plt.plot(data["pickup_hour"], data["num_trips"], marker='o', linewidth=2, label=trip_type)

plt.xlabel("Hour of Day", fontsize=12)
plt.ylabel("Number of Trips", fontsize=12)
plt.title("Hourly Usage Patterns by Transportation Type (January 2025)", fontsize=14, fontweight='bold')
plt.legend(title="Transportation Type")
plt.grid(True, linestyle='--', alpha=0.7)
plt.xticks(range(0, 24))
plt.tight_layout()
plt.show()

# Identify peak hours for each service
logging.info("=== PEAK HOUR ANALYSIS ===")
for trip_type in hourly_usage_pd["trip_type"].unique():
    data = hourly_usage_pd[hourly_usage_pd["trip_type"] == trip_type]
    peak_hour = data.loc[data["num_trips"].idxmax()]
    logging.info(f"{trip_type}: Peak hour is {peak_hour['pickup_hour']}:00 with {peak_hour['num_trips']:,} trips")
主要な発見と洞察
市場シェア分析
マンハッタンの優位性:
- Yellow Taxis:特にミッドタウン地域でマンハッタンに強い存在感を維持
- High Volume FHV:すべての区で大きな市場浸透度を示し、最高の絶対数
外郭区のパターン:
- Green Taxis:規制によりブルックリンとクイーンズに集中
- FHVサービス:伝統的なタクシーがあまりサービスしていない地域への重要な接続性を提供
サービス特性
乗車時間のパターン:
- 最短:外郭区のローカル乗車に最適化されたGreen Taxis
- 最長:空港や長距離乗車を含むFHVサービス
- 中間:Yellow TaxisとHigh Volume FHV(乗車タイプのバランスの取れた混合)
ピーク利用時間:
- 朝ラッシュ:すべてのサービスで8-9時
- 夕方ラッシュ:6-7時でサービスタイプによって異なる
- 深夜:High Volume FHVは伝統的なタクシーよりも強い存在感を維持
地理的な洞察
需要の高いゾーン:
- 空港アクセス:JFKとラガーディアがFHVの主要な乗車地点
- 交通ハブ:Penn Station、Grand Centralはすべてのサービスで目立つ
- ビジネス地区:Yellow Taxisにとってミッドタウン・マンハッタンは依然として重要
結論
この比較分析は、ニューヨークの交通エコシステムにおける異なる利用パターンと市場ポジショニングを明らかにしています。高頻度FHVサービスはその数で圧倒的ですが、イエロータクシーは伝統的なマンハッタンの地位を維持しています。グリーントラックは外郭地域の市場を成功裏にサービス提供しており、FHVサービスは長距離移動や空港アクセスに不可欠な役割を果たしています。
この分析は、異なる交通手段が相互に補完し合い、異なる地理的エリア、移動目的、時間パターンに対応していることを示しています。この洞察は以下の点で価値があります。
- 都市計画家: 交通需要パターンの理解
- サービス運営者: フリート配置と価格戦略の最適化
- 政策立案者: 交通規制の効果評価
- 研究者: 都市モビリティの進化分析
PySparkベースのアプローチは、大規模な交通データを効率的に処理・分析し、都市交通計画におけるデータ駆動型意思決定のための有意義な洞察を抽出する方法を示しています。
次のステップ
この分析をさらに拡張するために、以下を検討してください。
- 時間的分析: 異なる月や季節を比較
- 需要予測: ゾーンと時間ごとの乗車数の予測モデル構築
- ネットワーク分析: 出発地と目的地のパターンとフロー動態の検討
- 経済分析: 料金と収益データを取り入れた財務的洞察
- 天候の影響: 異なる交通手段に与える天候条件の影響分析
さらに学ぶ
当社のソリューションの実装に関するトレーニングや技術支援が必要な場合は、営業担当者にお問い合わせください、またはプロフェッショナルサービスページをご覧ください。見積もりをリクエストし、専門家チームによるプロジェクト分析を受けることができます。
質問をする、フィードバックを送信する、Data Platformの開発チームと直接交流するには、専用のDiscordチャネルにアクセスしてください。
OVHcloudサービスに関するサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。

