

カスタム PySpark アクション
当社のソフトウェア開発キット(SDK)を使用して、プラットフォームのさまざまなコンポーネントと簡単に相互作用する方法
目的
カスタム PySpark アクション は、Apache Spark™を使用して、スケーラブルなクラウドクラスタ環境でカスタム PySpark スクリプトを実行することを可能にします。
当社のソフトウェア開発キット(SDK)を使用して、プラットフォームのさまざまなコンポーネントと簡単に相互作用することができます。カスタム PySpark アクション は、以下のようなさまざまなユースケースを実装するために使用できます。
- データウェアハウスに対して操作アルゴリズムまたはETLジョブを実行する
- 簡単なデータ分析または機械学習アルゴリズムを実行する
- Data Platform マーケットプレイスで利用できないデータソースからデータを抽出する(そのためにコネクタを作成する必要はありません)
- リアルタイムデータ(MQTT、Kafka など)を抽出する
カスタム PySpark アクションは、ワークフロー内でオーケストレーションでき、即時またはスケジュールされた基準でトリガーできます。現在、単一のワークフローには、PySpark アクションと通常のアクションの両方を含めることはできません。
カスタム PySpark アクションの設定
プロジェクトの Data Processing Engine で、Actions タブに移動し、New Action ボタンをクリックします。アクションタイプとして Custom PySpark を選択します。
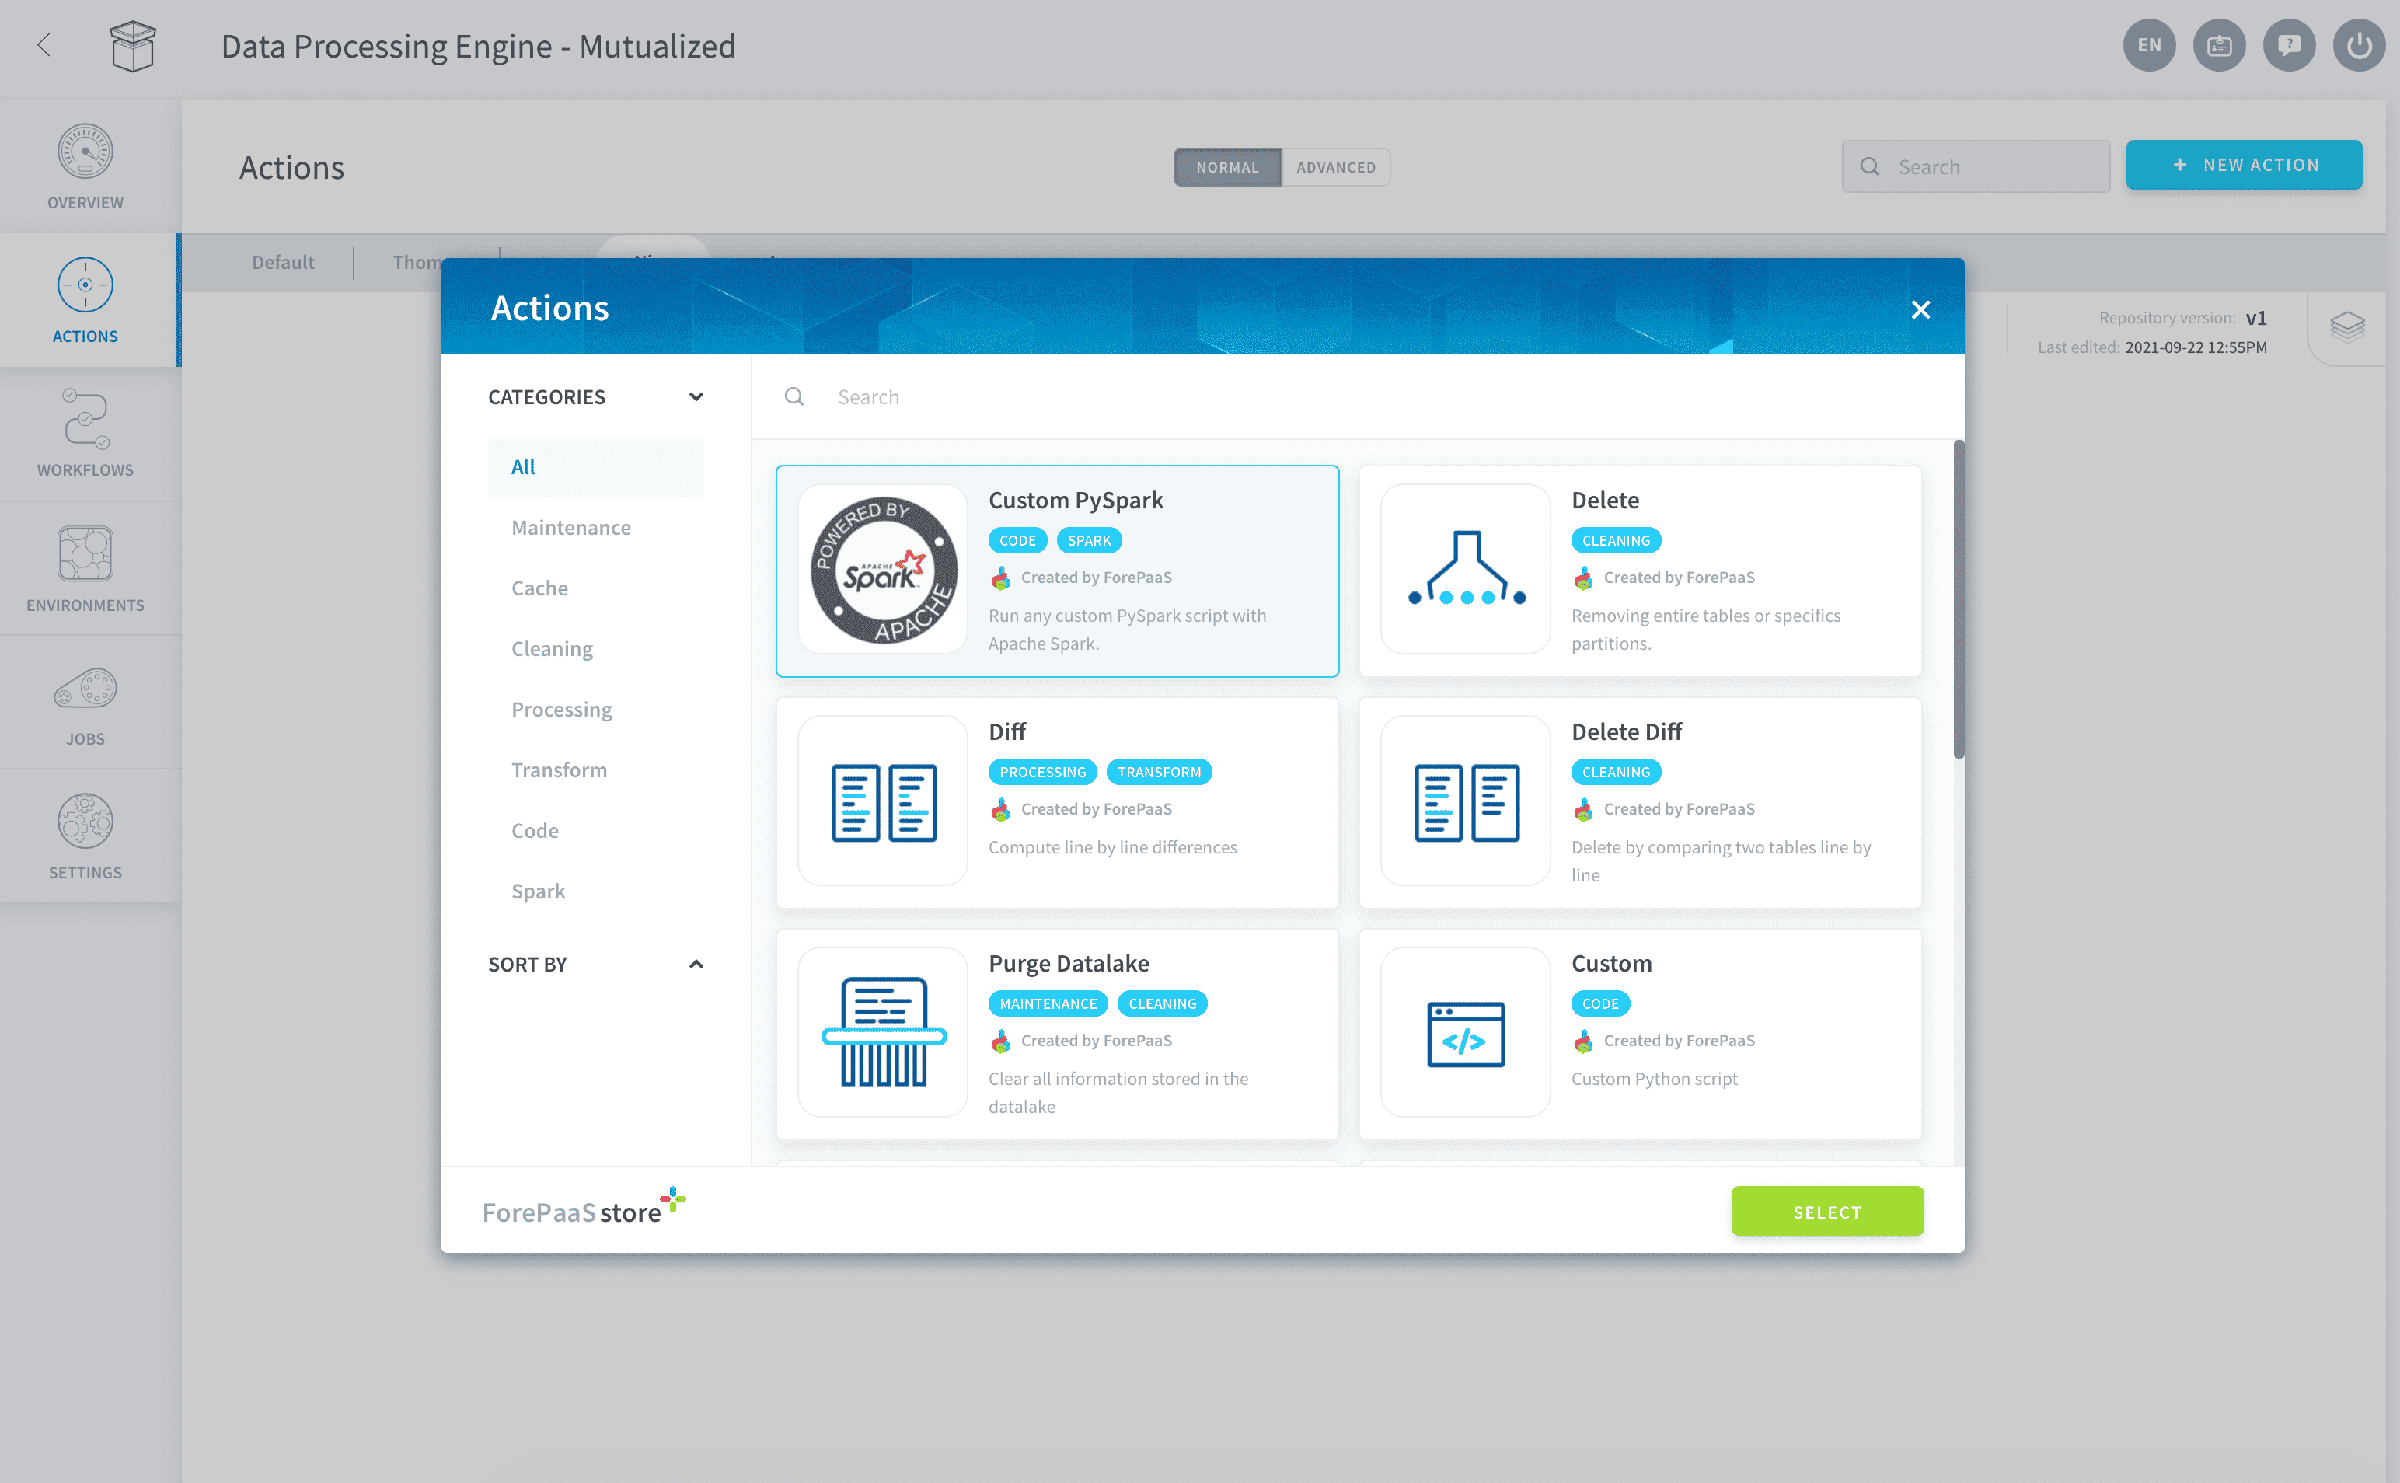
.py PySpark スクリプトを「Drag and drop」セクションにドラッグ&ドロップします。 または、Start with a boilerplate オプションを選択して、プラットフォームの Python インターフェースで例のコードスニペットから直接開始します。
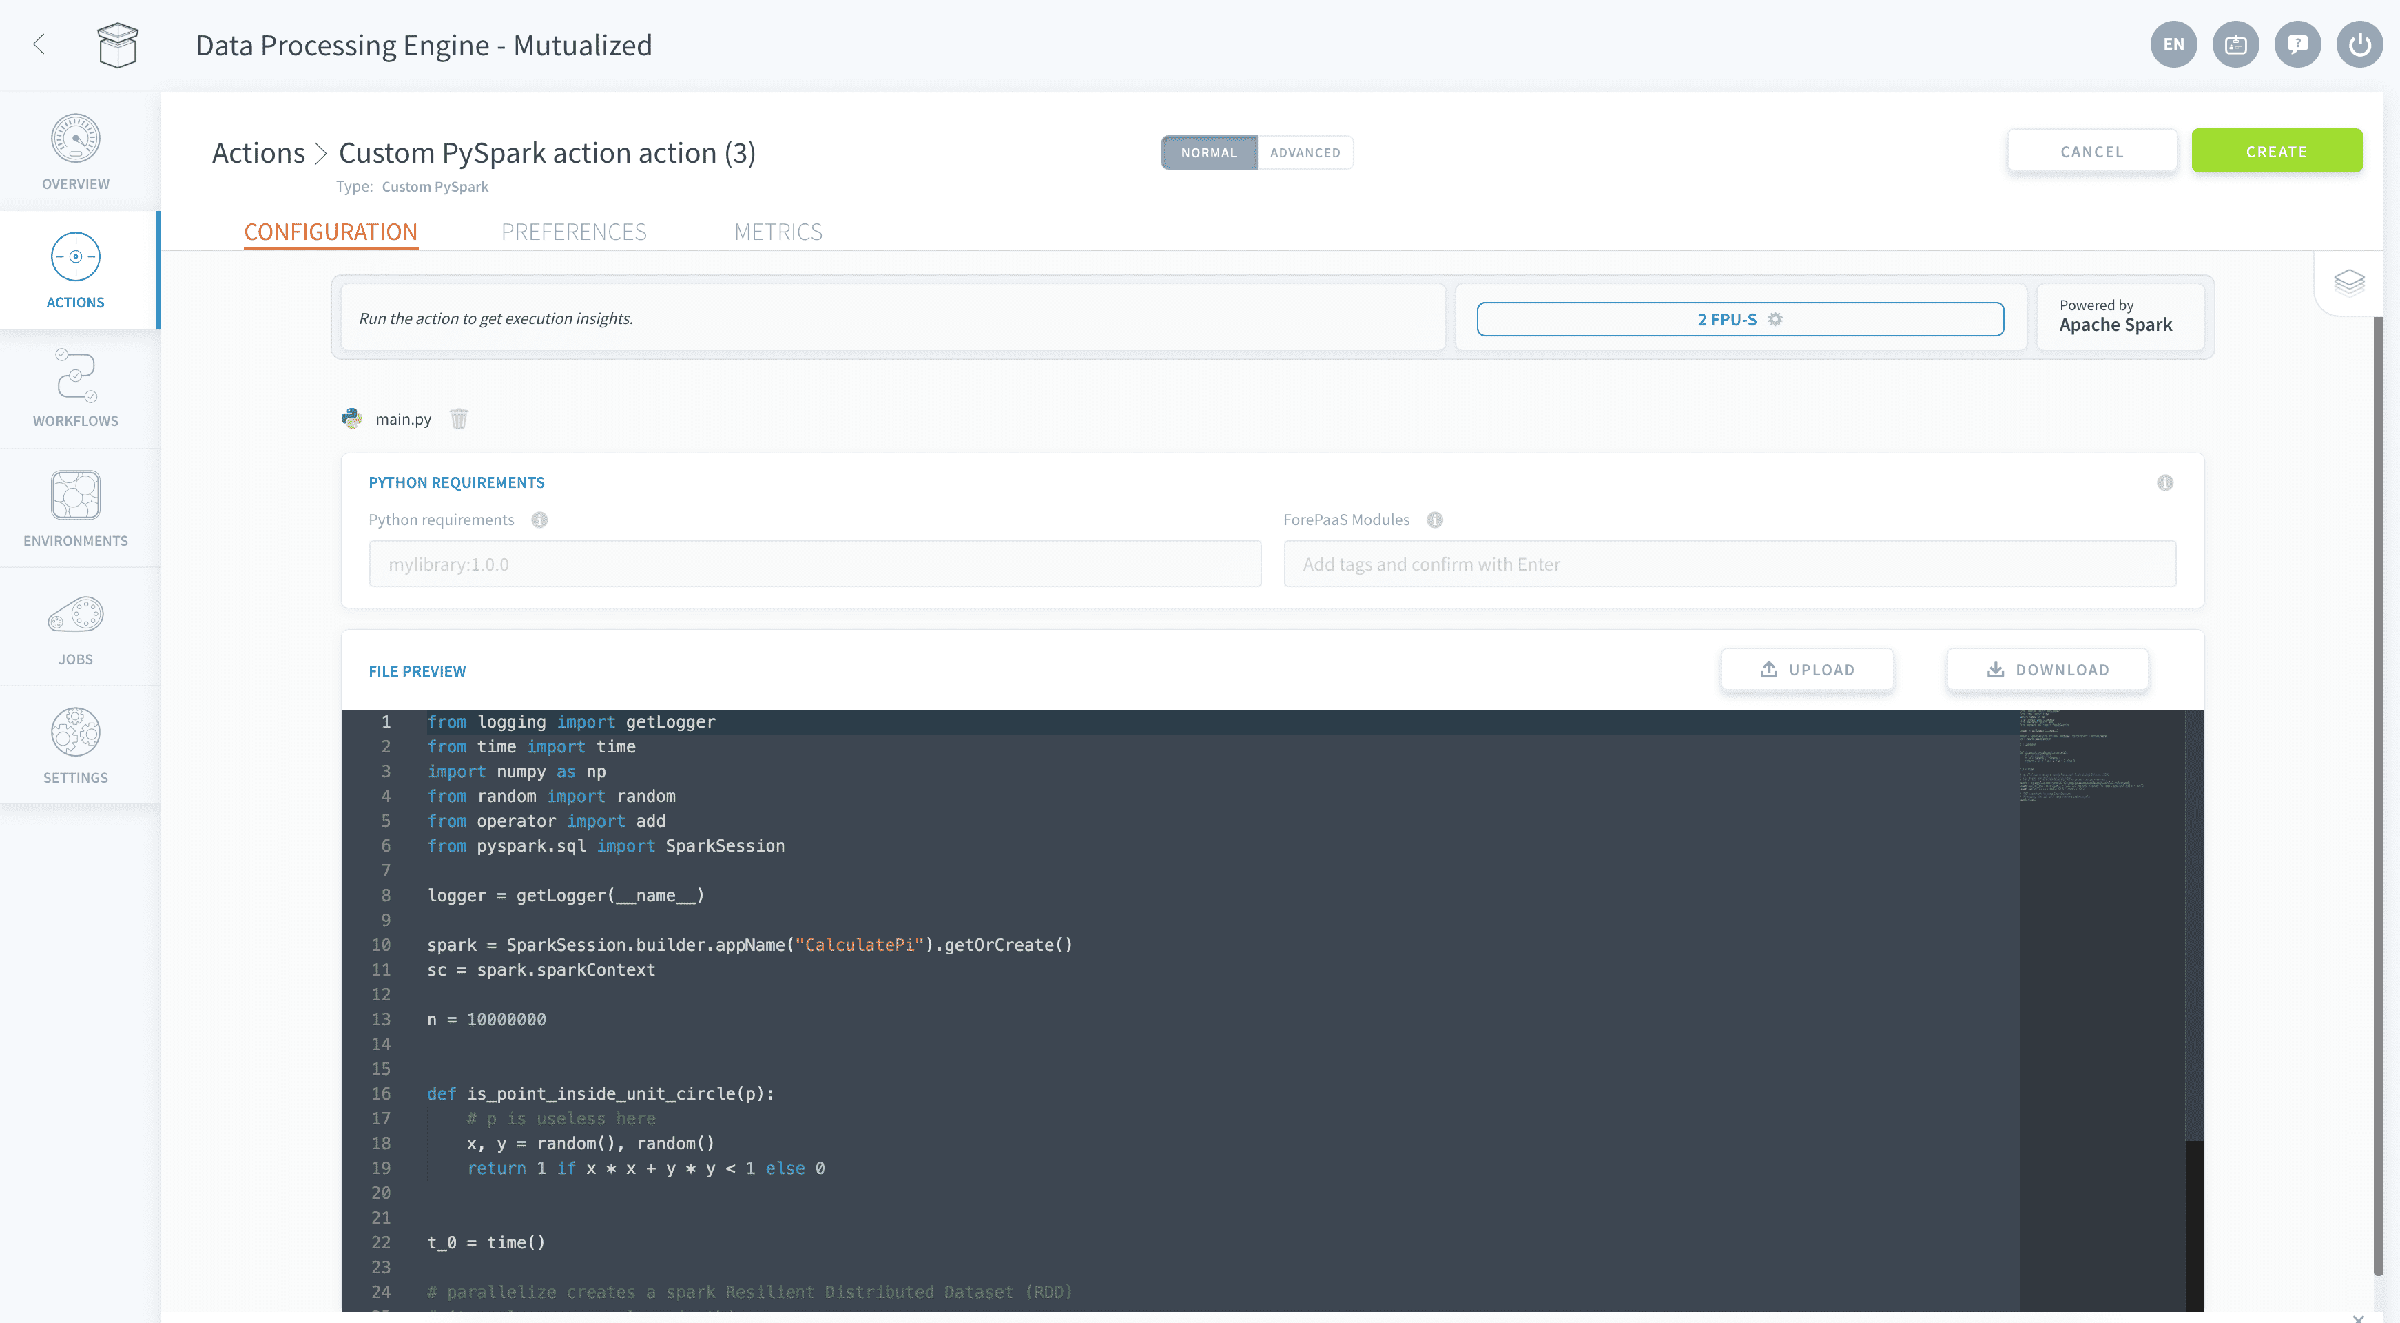
編集インターフェースでソースファイルを直接編集できます(必要に応じて新しいファイルをドロップできます)。以下の PySpark ドキュメントを参照してください。
ソフトウェア開発キット(SDK)で提供される任意の関数を使用して、プラットフォームの他のコンポーネントと簡単に相互作用できます。すべての利用可能な SDK 関数についてさらに詳しく知りたい場合は、以下の記事を参照してください。
ヘルパーパネルの使用
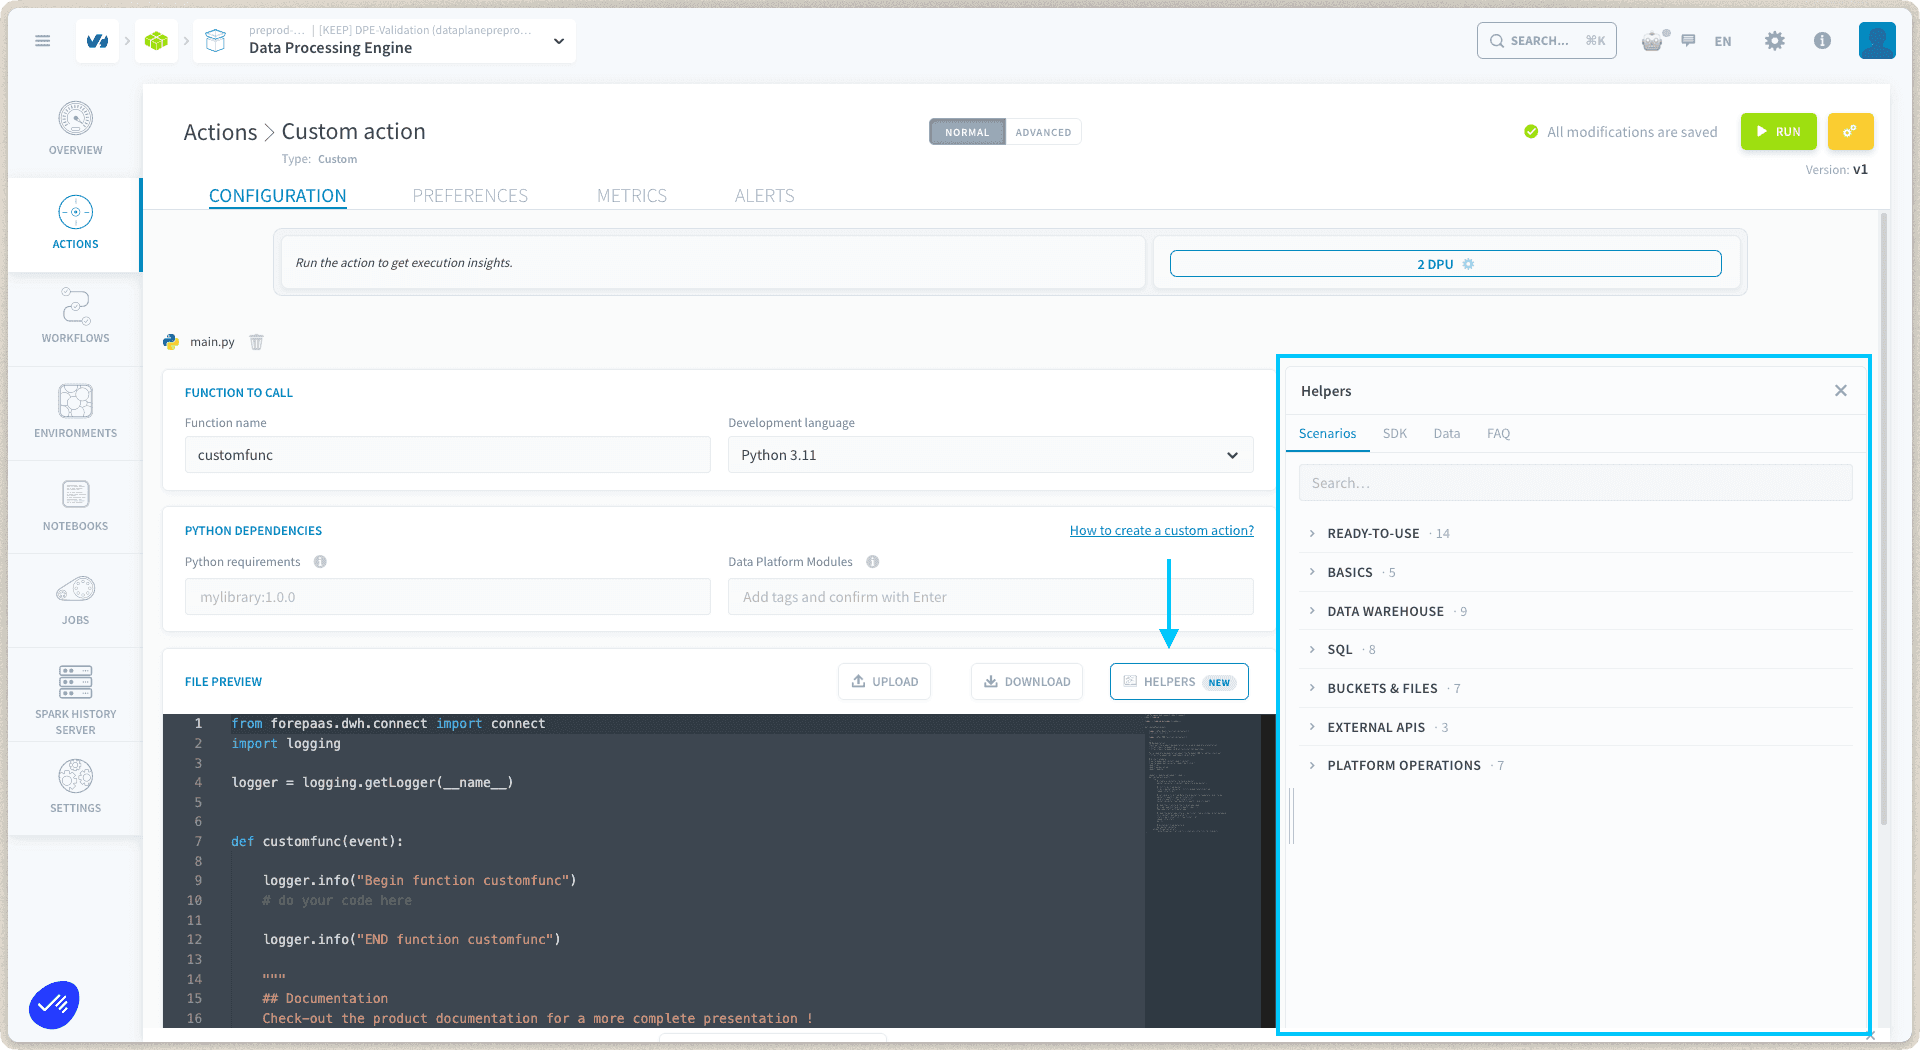
カスタム PySpark アクション エディタにはヘルパーパネルが含まれており、スクリプトを離れずにガイダンスを受けられます。
- シナリオ: カテゴリ別に整理された、コピーしてユースケースに合わせて調整できる、使用可能なアクションスクリプト。
- SDK ガイド: スクリプトから呼び出せる SDKメソッドのドキュメント。
- データ: エディタから直接プロジェクトのデータをブラウズし、コードを書く間に名前と構造を確認できます。
- FAQ: アクションに関する一般的な質問への回答。
ヘルパーコンテンツは、ノートブックの Data Platform Extensionで動作するライブカタログと同じものです。常に最新の状態です。
並列処理の管理
アクションの設定で、より多くの並列ワーカーインスタンスを追加してジョブをスケールアップできます。
インスタンス の希望する数を入力します。これは Spark エグゼキュータの数です。各インスタンスの CPU と RAM サイズは、各インスタンスに割り当てられる DPUの数を変更することで管理できます。
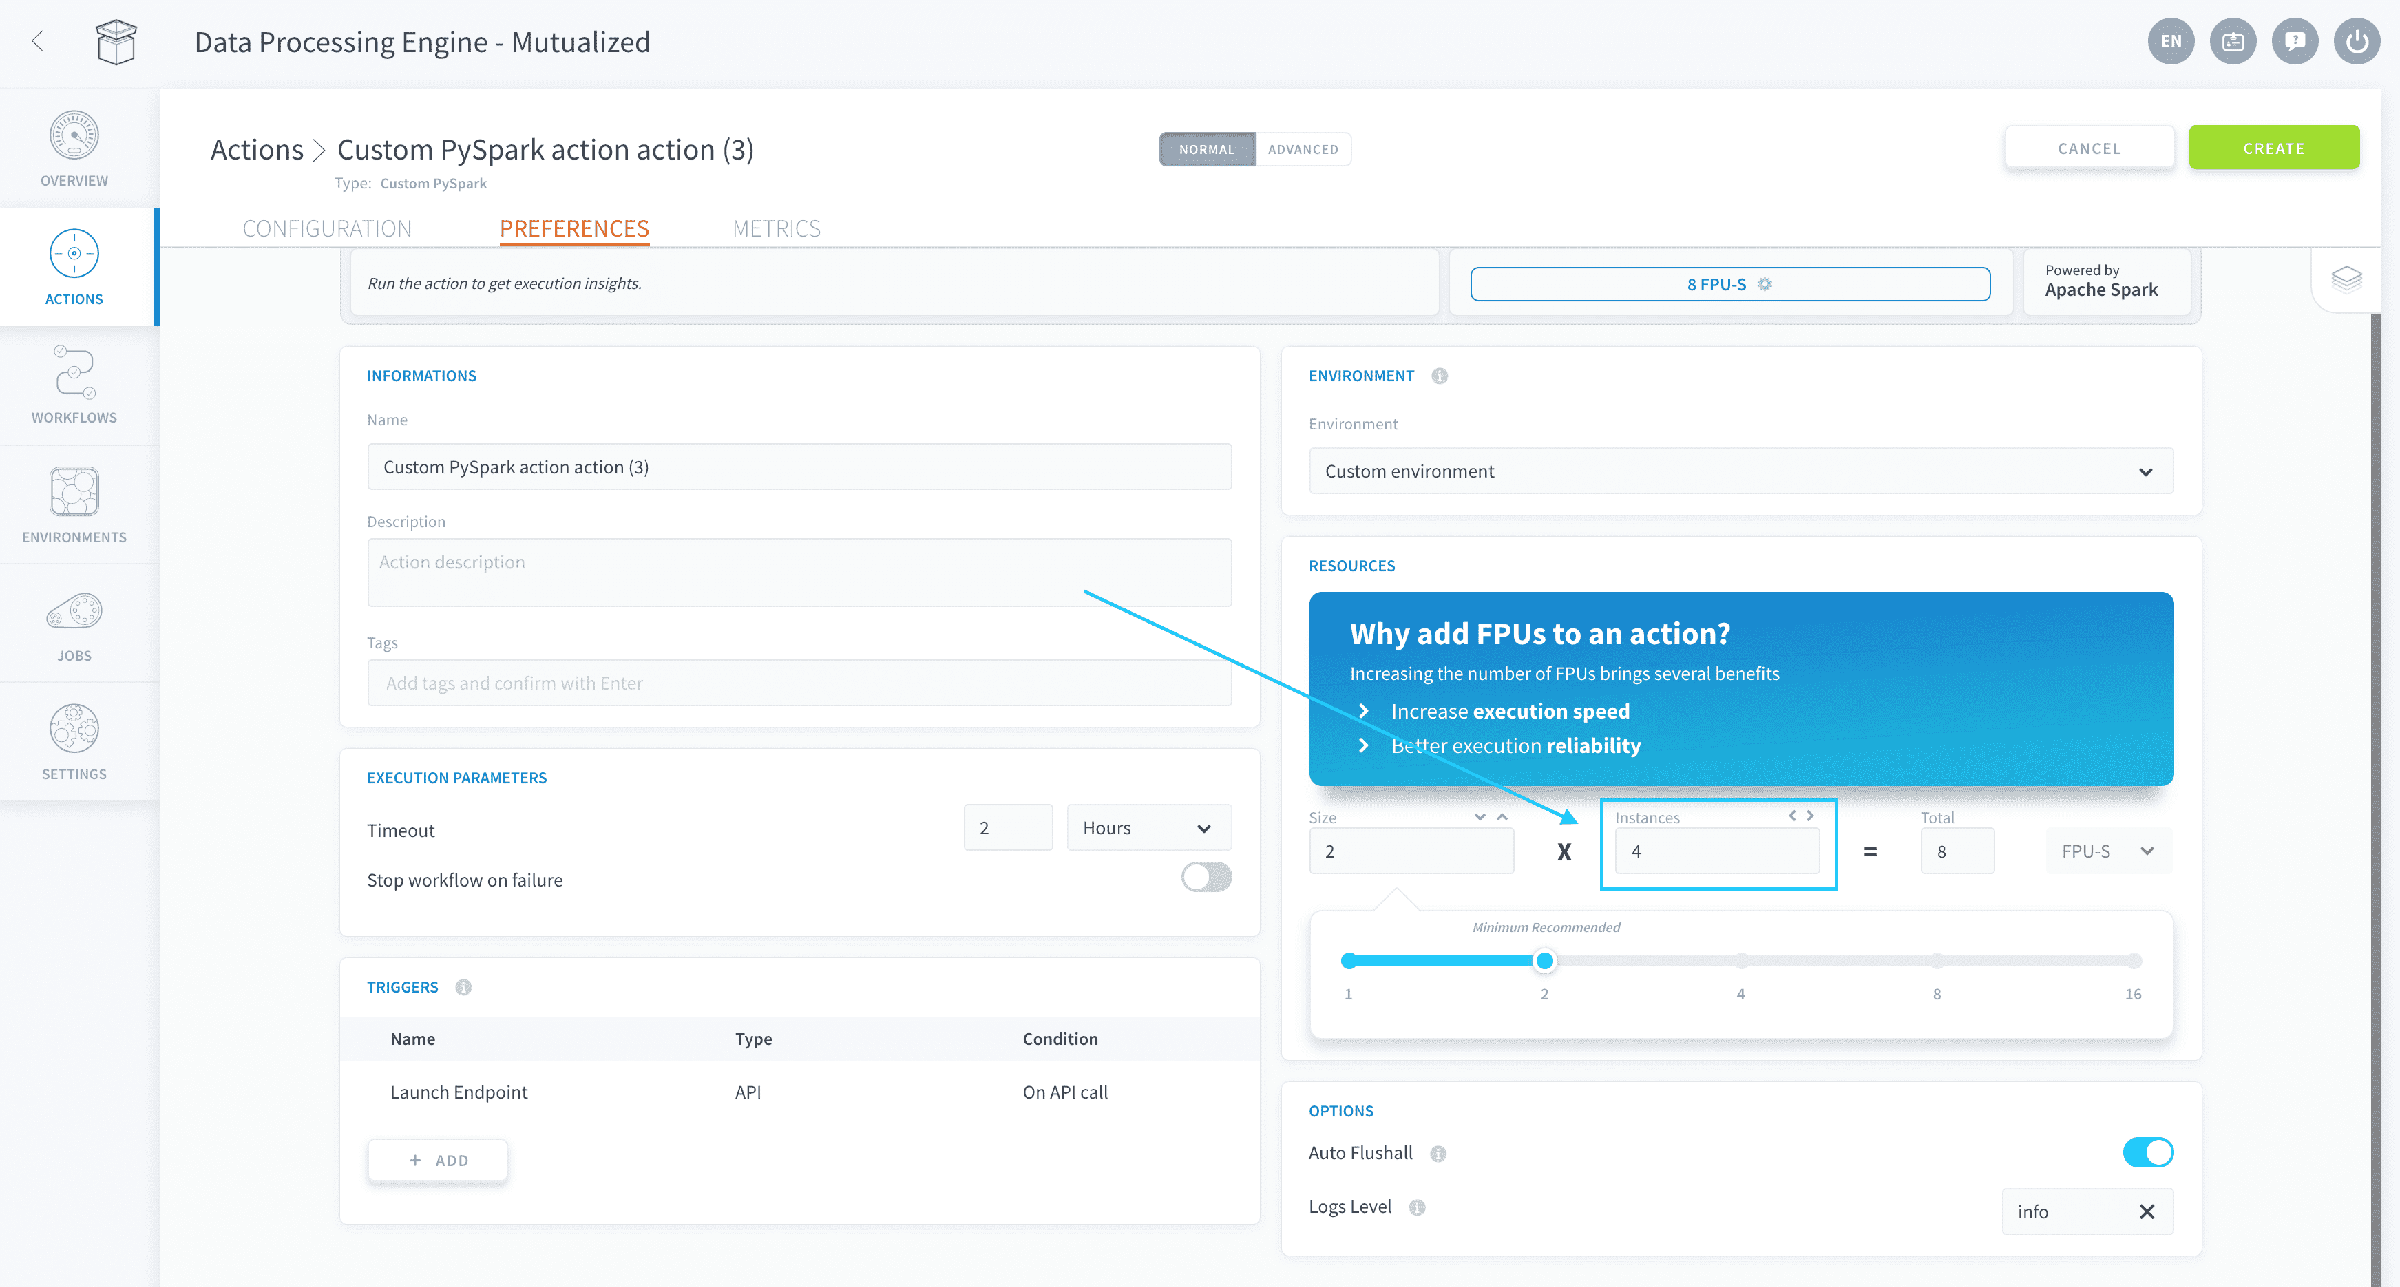
PySpark スクリプト内で、これらの異なるワーカーにジョブのワークロードをどのように分割するかを指定します。
依存関係の管理
Python パッケージのインストール
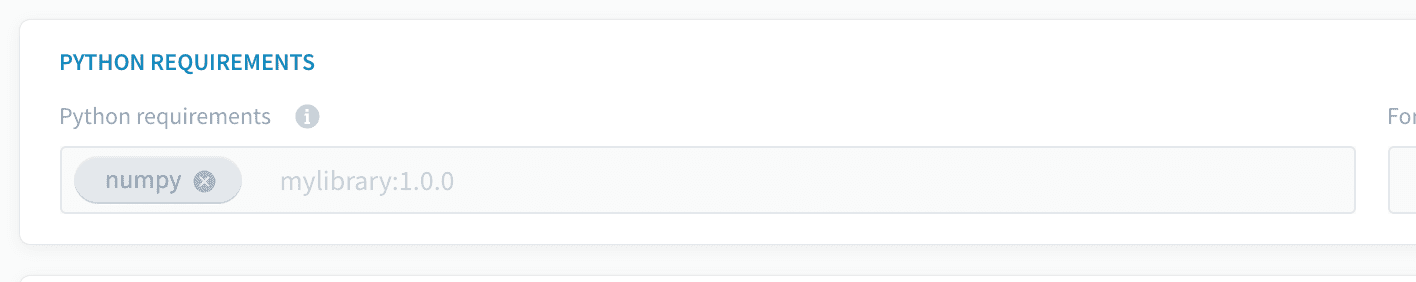
デフォルトで含まれていない特定のパッケージをインストールする必要がある場合があります。「Python Requirements」フィールドに、基本的な「pip」(Python パッケージマネージャー)の要件ファイルで使用される形式に従って追加し、キーボードで「ENTER」を押します。
「ENTER」を押した後、以下のように表示されます。
Git リポジトリからのパッケージのインストール
git+ プレフィックスを要件に使用して、GitHub または GitLab リポジトリから直接 Python パッケージをインストールできます。
特定のバージョンを固定するには、タグまたはコミットハッシュを追加します。
最新リリースの自動インストール
バージョンタグを手動で追跡することなく、常に最新の公開リリースをインストールするには、@latest を使用します。
プラットフォームは git+ プレフィックスと @latest サフィックスを検出し、最新のリリースタグを解決してインストールする前に自動的に置き換えます。
Git 依存関係を追加または変更した後、Force Build をクリックして再インストールします。モジュールの新しいバージョンが公開されるたびにタグまたはコミットハッシュを手動で更新する必要はありませんが、最新のリリースは実行時に自動的に取得されません。Force Build を手動で実行する必要があります。
デフォルトの依存関係のリスト
Data Platform は、バグ修正をインストールできるように、バージョンのマイナーをブロックします。ライブラリのより新しいバージョンが必要な場合は、「Requirements」フィールドに同じパッケージを新しいバージョンで追加して手動で上書きできます。
Data Processing Engine ワーカーに同梱されているすべてのパッケージとそのバージョン(pip の要件ファイルで見つけることができるように)のリストは以下の通りです。
さらに詳しく
トレーニングや技術的なサポートを受けて当社のソリューションを実装するには、営業担当者にお問い合わせください、またはプロフェッショナルサービスページを訪れて見積もりを依頼し、専門家チームによるプロジェクト分析を受けてください。
質問をする、フィードバックを提供し、Data Platform を構築するチームと直接交流するには、専用の Discord チャネルを利用してください。
OVHcloud サービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。