

Aggregate PySpark アクション
各目的地属性はソース属性にマッピングする必要があります。複数のソーステーブルが選択された場合
目的
Aggregate PySpark アクションを使用すると、Apache Spark™を使用して、既存のテーブルから任意のテーブル(同じテーブルを含む)にデータを転送できます。
Aggregate PySpark アクションの範囲は広く、SQL の処理や複数テーブルの結合、結果のグループ化などが可能なため、データ処理ワークフローで最もよく使用されるアクションの一つです。
Aggregate PySpark アクションを設定する
Aggregate PySpark アクションは、1つ以上のソーステーブルのリストで構成され、その値が単一の目的地テーブルに抽出されます。各目的地属性はソース属性にマッピングする必要があります。
複数のソーステーブルが選択された場合、SQL と同様に結合条件を指定する必要があります。
Aggregate PySpark アクションの設定で目的地属性をマッピングしないと、アクションを実行するとエラーが発生します。目的地フィールドを空のままにしたい場合は、マッピングされた属性のリストから単に削除してください。
目的地属性がマッピングされた属性のリストから削除された場合、次の動作が期待されます。
- Aggregate PySpark アクションが新しい行を挿入する場合、単に目的地属性列に NULL 値を入力します。
- Aggregate PySpark アクションが既存の行を更新する場合(つまり、既存のデータに挿入する場合)、その値が NULL であっても、以前の値をそのままにします。
単一および複数のソーステーブルの両方のユースケース例は、以下に記載されています。
生データを主テーブルに転送する
新しい Aggregate PySpark アクションを作成します。
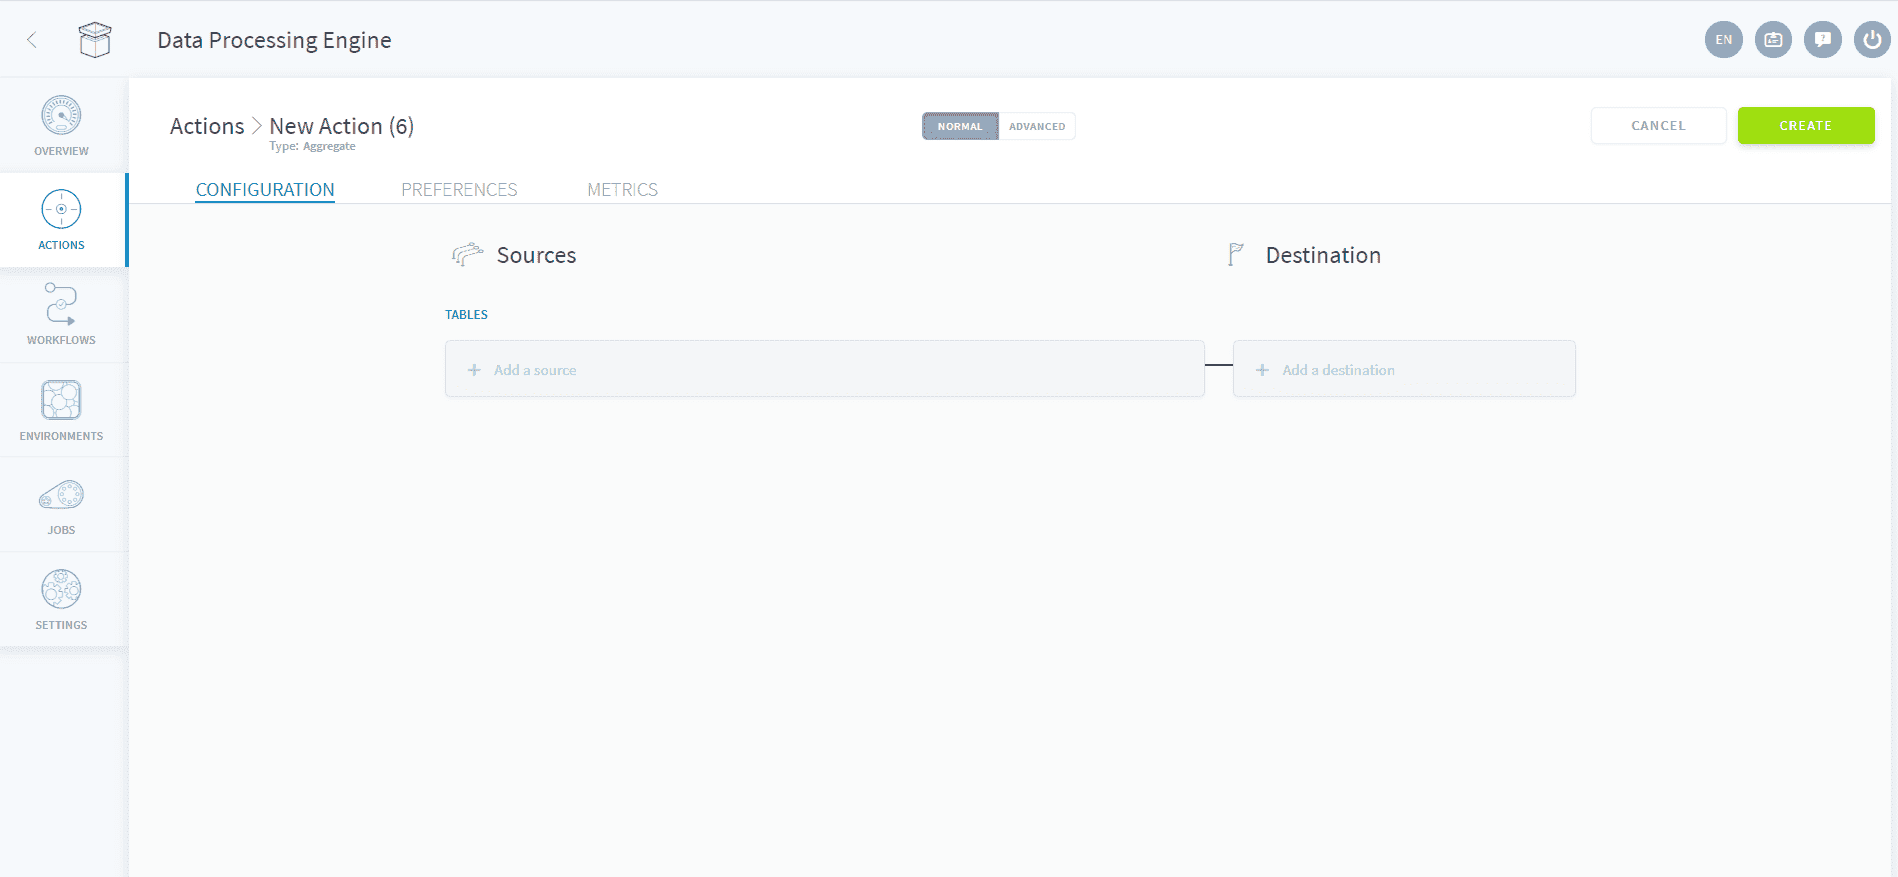
ソース(左)と目的地テーブルを選択します。可能な場合、属性は自動的に割り当てられます。ソースと目的地の間でどの属性がマッピングされるかを手動で選択できます。
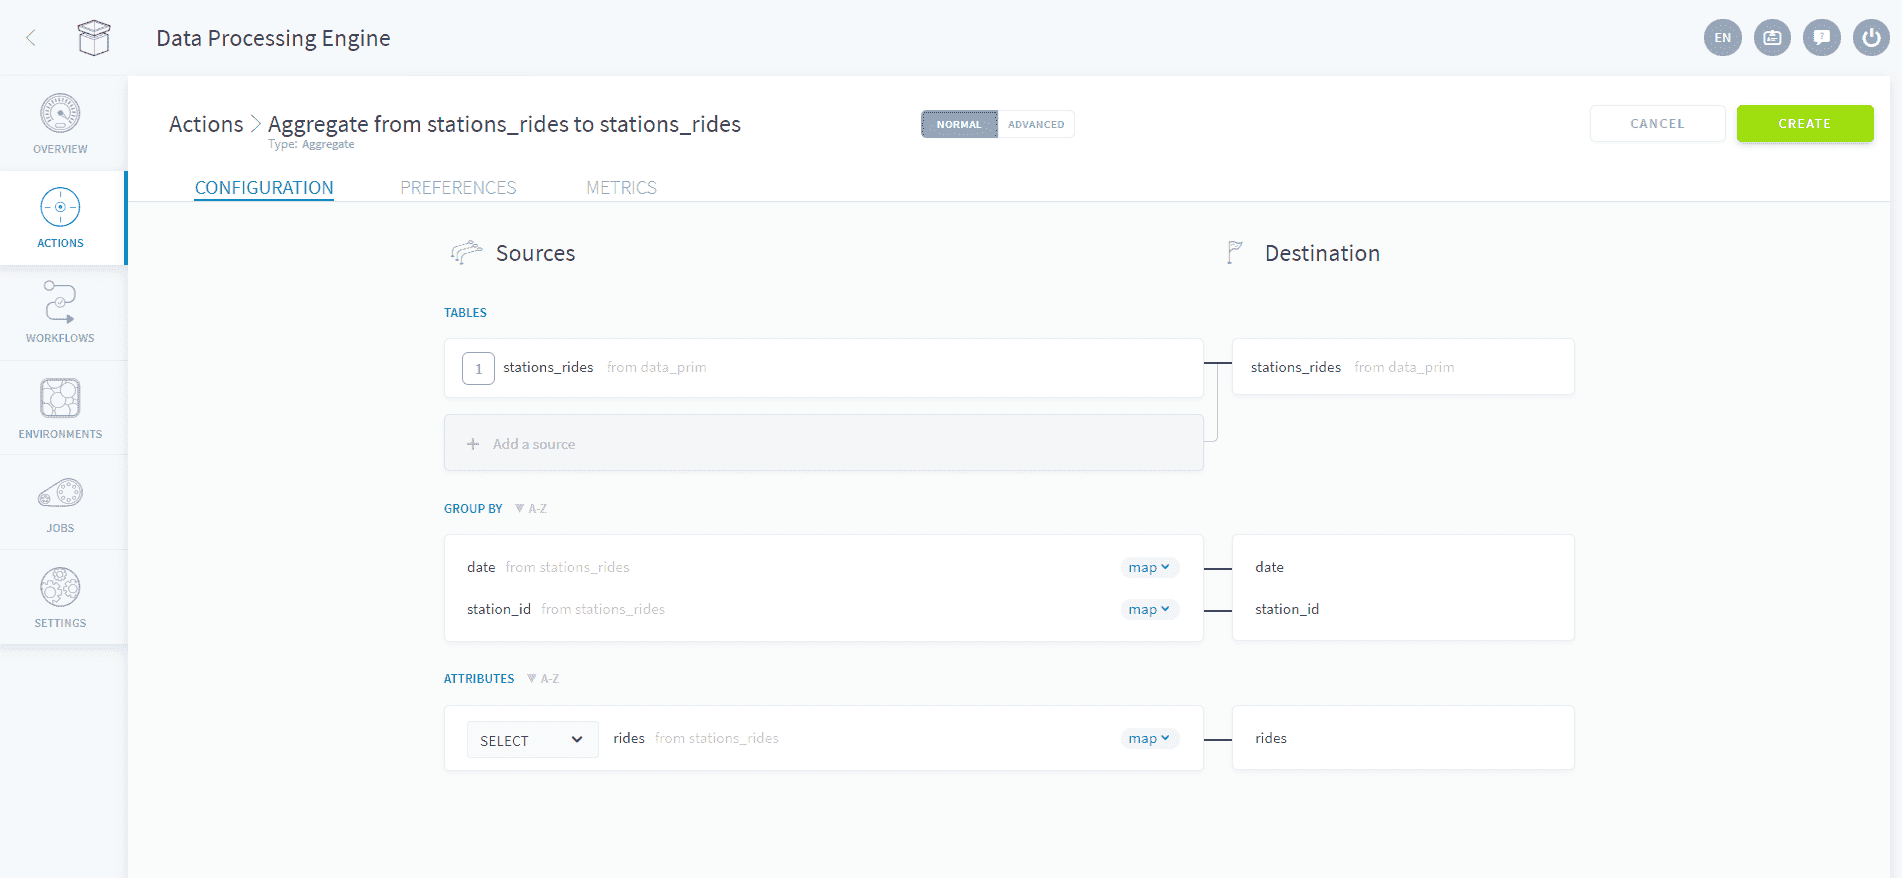
必要に応じて、MAP ボタンをクリックし、SQL または txt を選択して、マッピングを SQL またはプレーンテキストに変更できます。
属性セクションでは、各属性の計算モードも変更できます。上記の例では、SELECT が選択されていますが、他のオプションも利用可能です。
右上のCreate をクリックしてアクションを作成します。
参照テーブルを主テーブルに結合する
結合を指定するには、Add a source をクリックし、結合するテーブルを選択するように求められます。ドロップダウンメニューから結合の種類を選択し、UI に結合条件を入力します。複数のソーステーブルを結合できます。
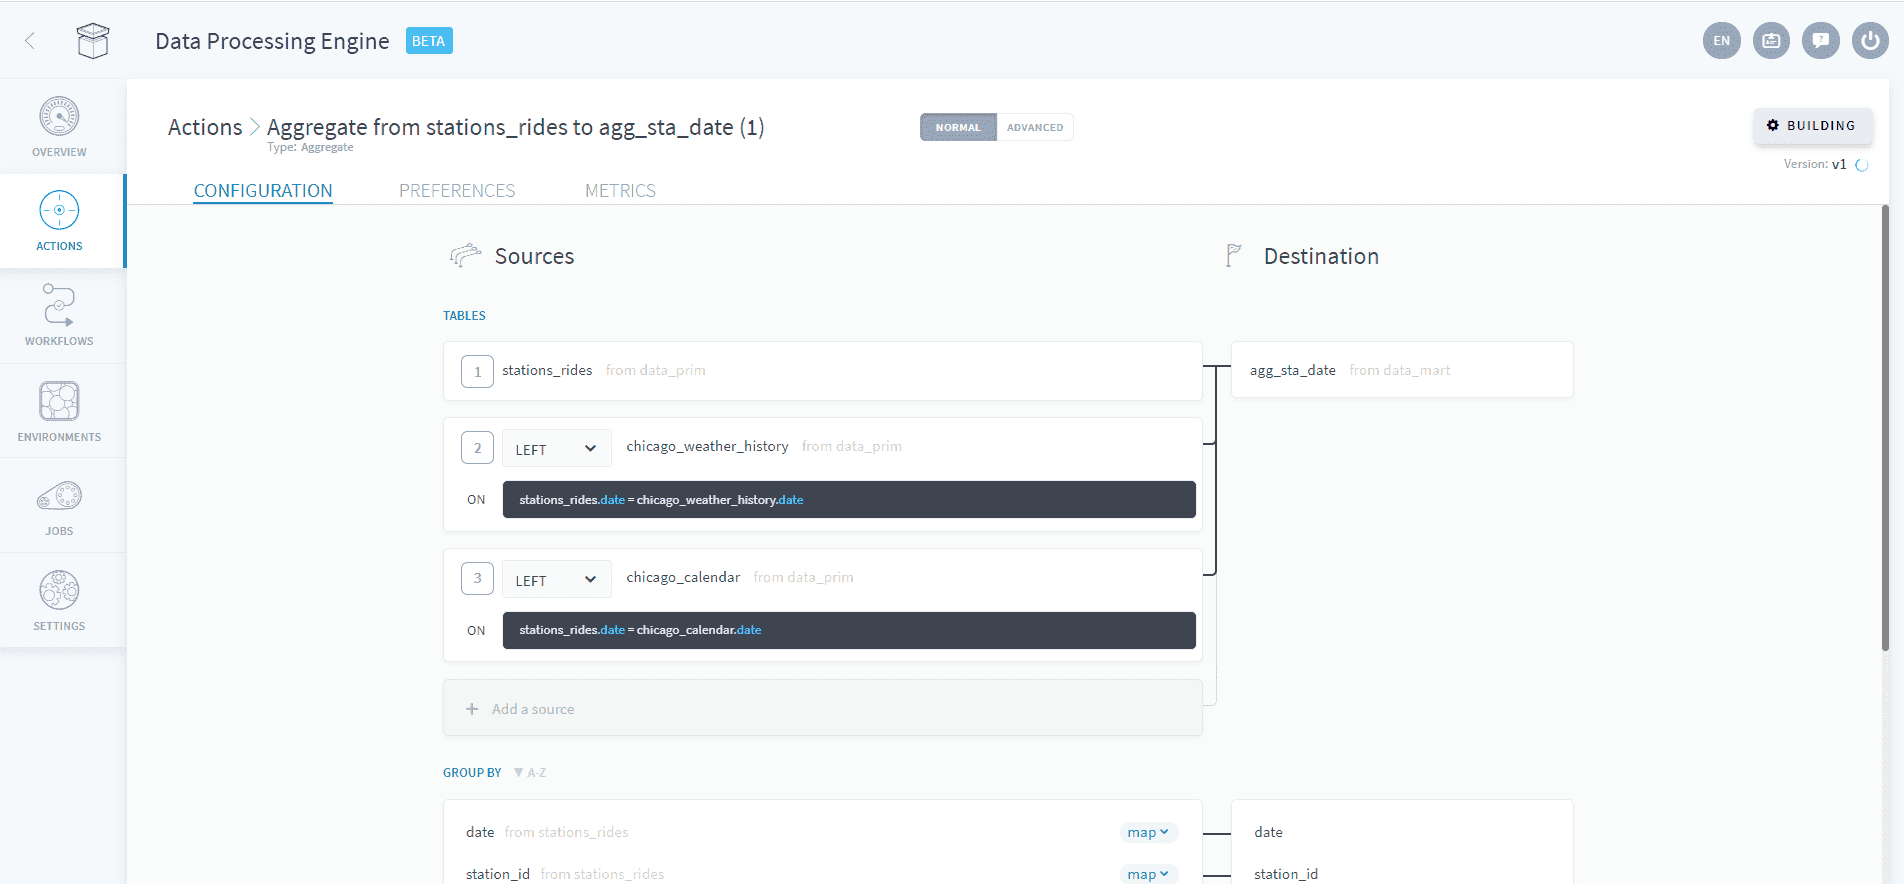
結合されたすべてのテーブルの属性は、下部の属性セクションでドロップダウンメニューまたは SQL を使用して選択できます。
アクションの設定を構成する
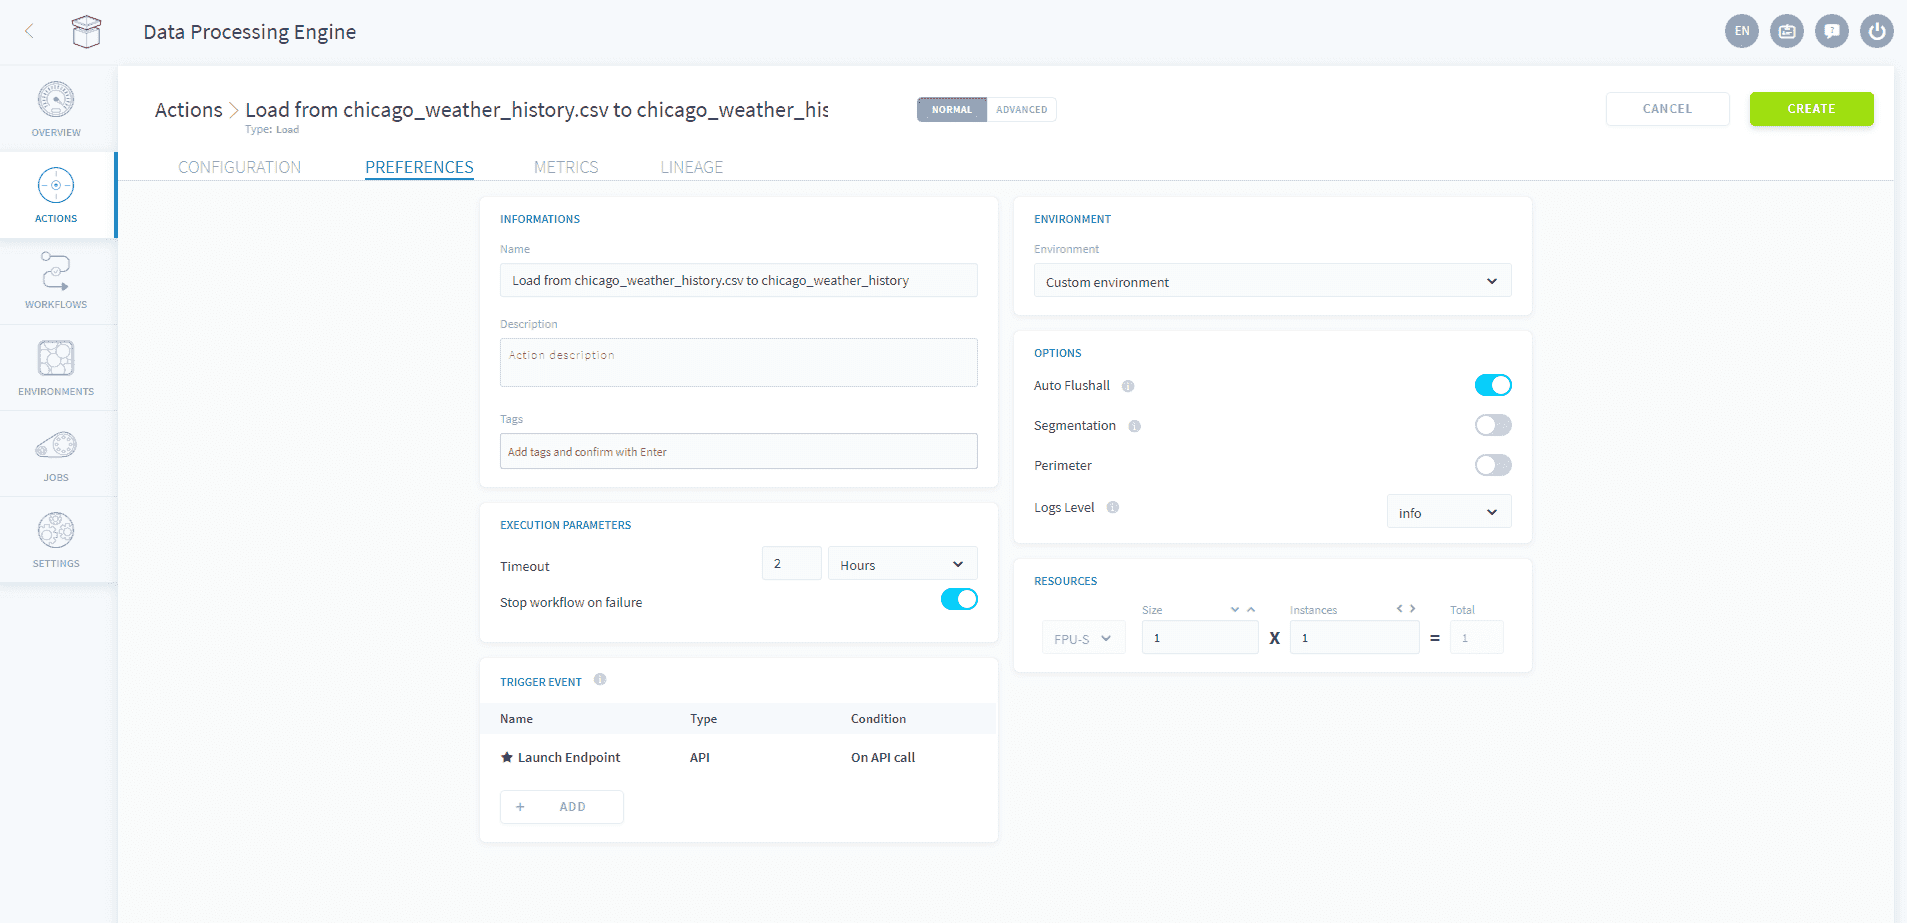
属性のマッピングに満足したら、設定タブを使用してアクション設定を構成します。
Advanced モードを使用する
アクションの JSON 構成ファイルにアクセスする必要がある場合は、Advanced をページの上部にクリックして Advanced モードを有効にできます。
Aggregate アクションの Advanced モードを使用する
さらに詳しく
トレーニングや技術的なサポートを受けて、当社のソリューションを実装するには、営業担当者にお問い合わせください、またはプロフェッショナルサービスページにアクセスして、見積もりをリクエストし、専門家チームにプロジェクトを分析してもらってください。
質問をする、フィードバックを送信する、Data Platform を構築するチームと直接交流するには、専用のDiscord チャンネルをご利用ください。
OVHcloud サービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。