

特徴量エンジニアリング
このページでは、OVHcloud Data Platformで利用できないForePaaS Legacy PlatformのサービスであるMachine Learning Managerについて説明しています。最新のドキュメントを参照してください。
ForePaaSでは、モデルに使用する変数を完全に指定できます。
予測値を追加する
予測したい値(すなわちラベル)はYデータセットに保存されます。予測値を追加するには、Add a sourceをYの横にクリックします。
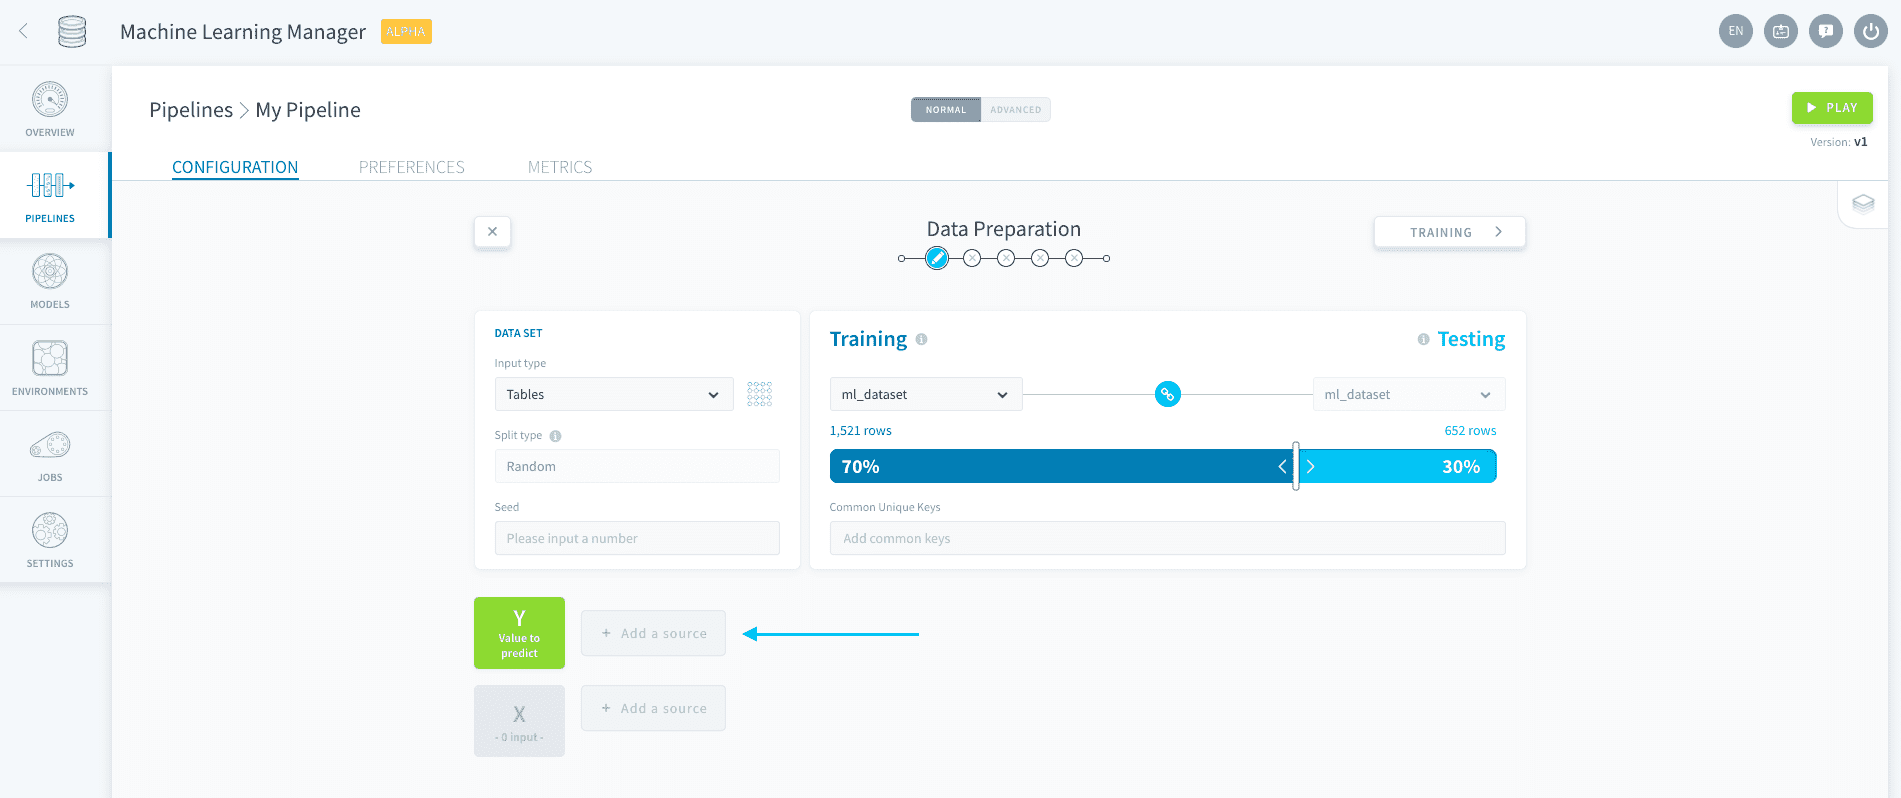
データセットを生成する時に指定した入力タイプに基づいてソースを選択し、保存します。
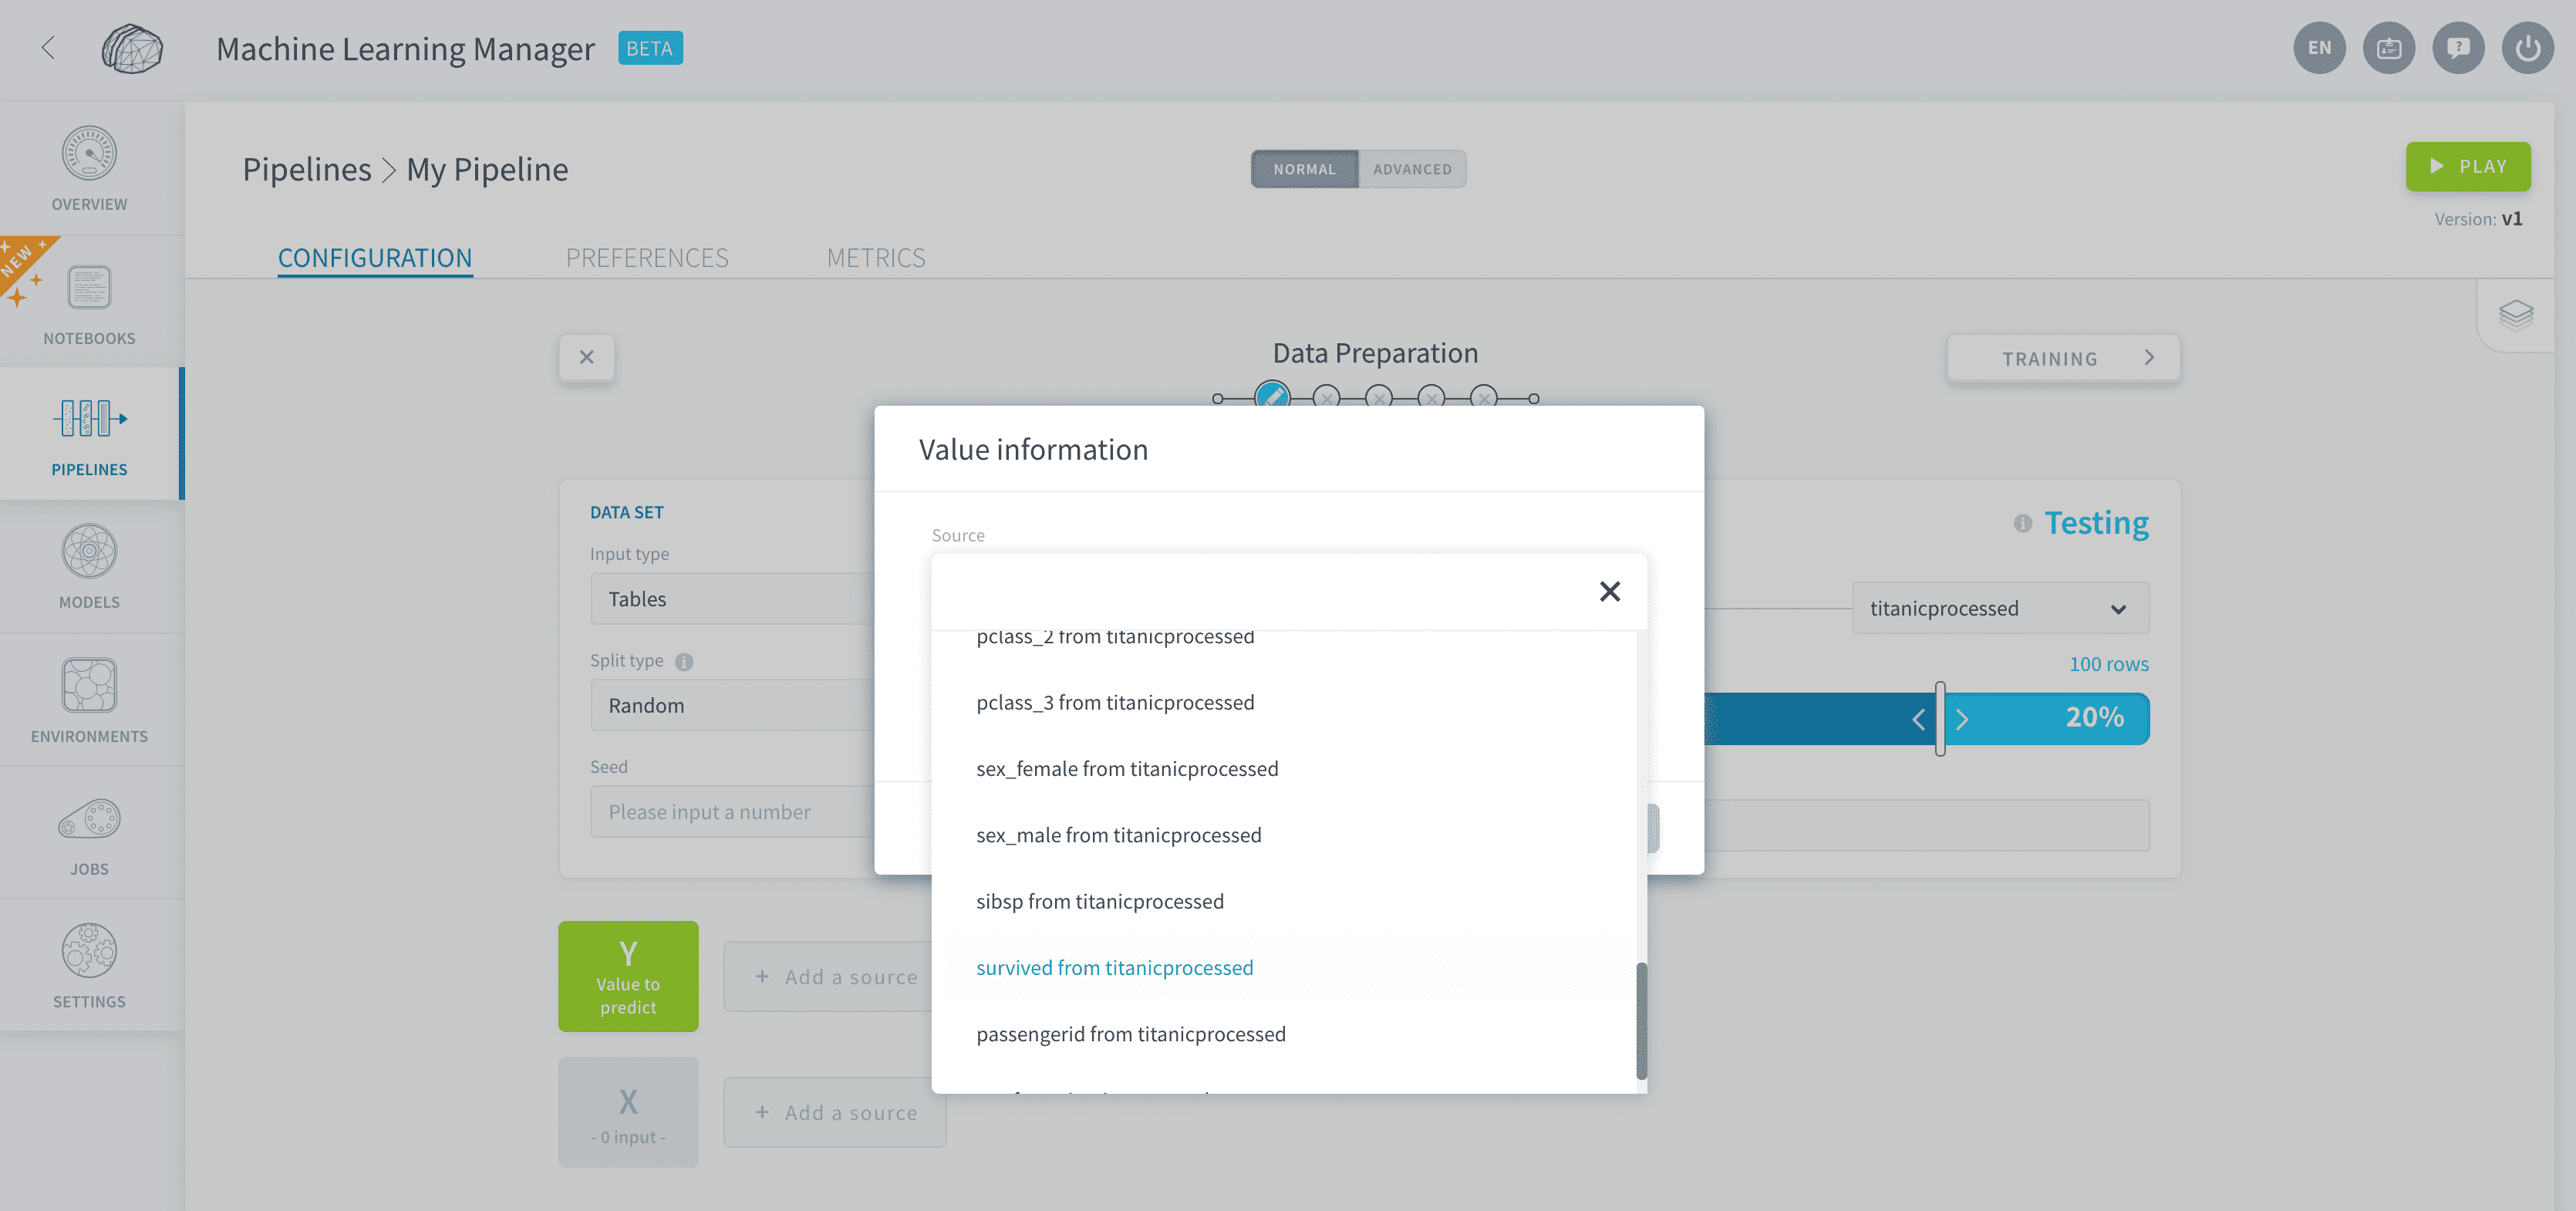
入力タイプがTablesの場合
トレーニングテーブルから1つの属性を選択できます。
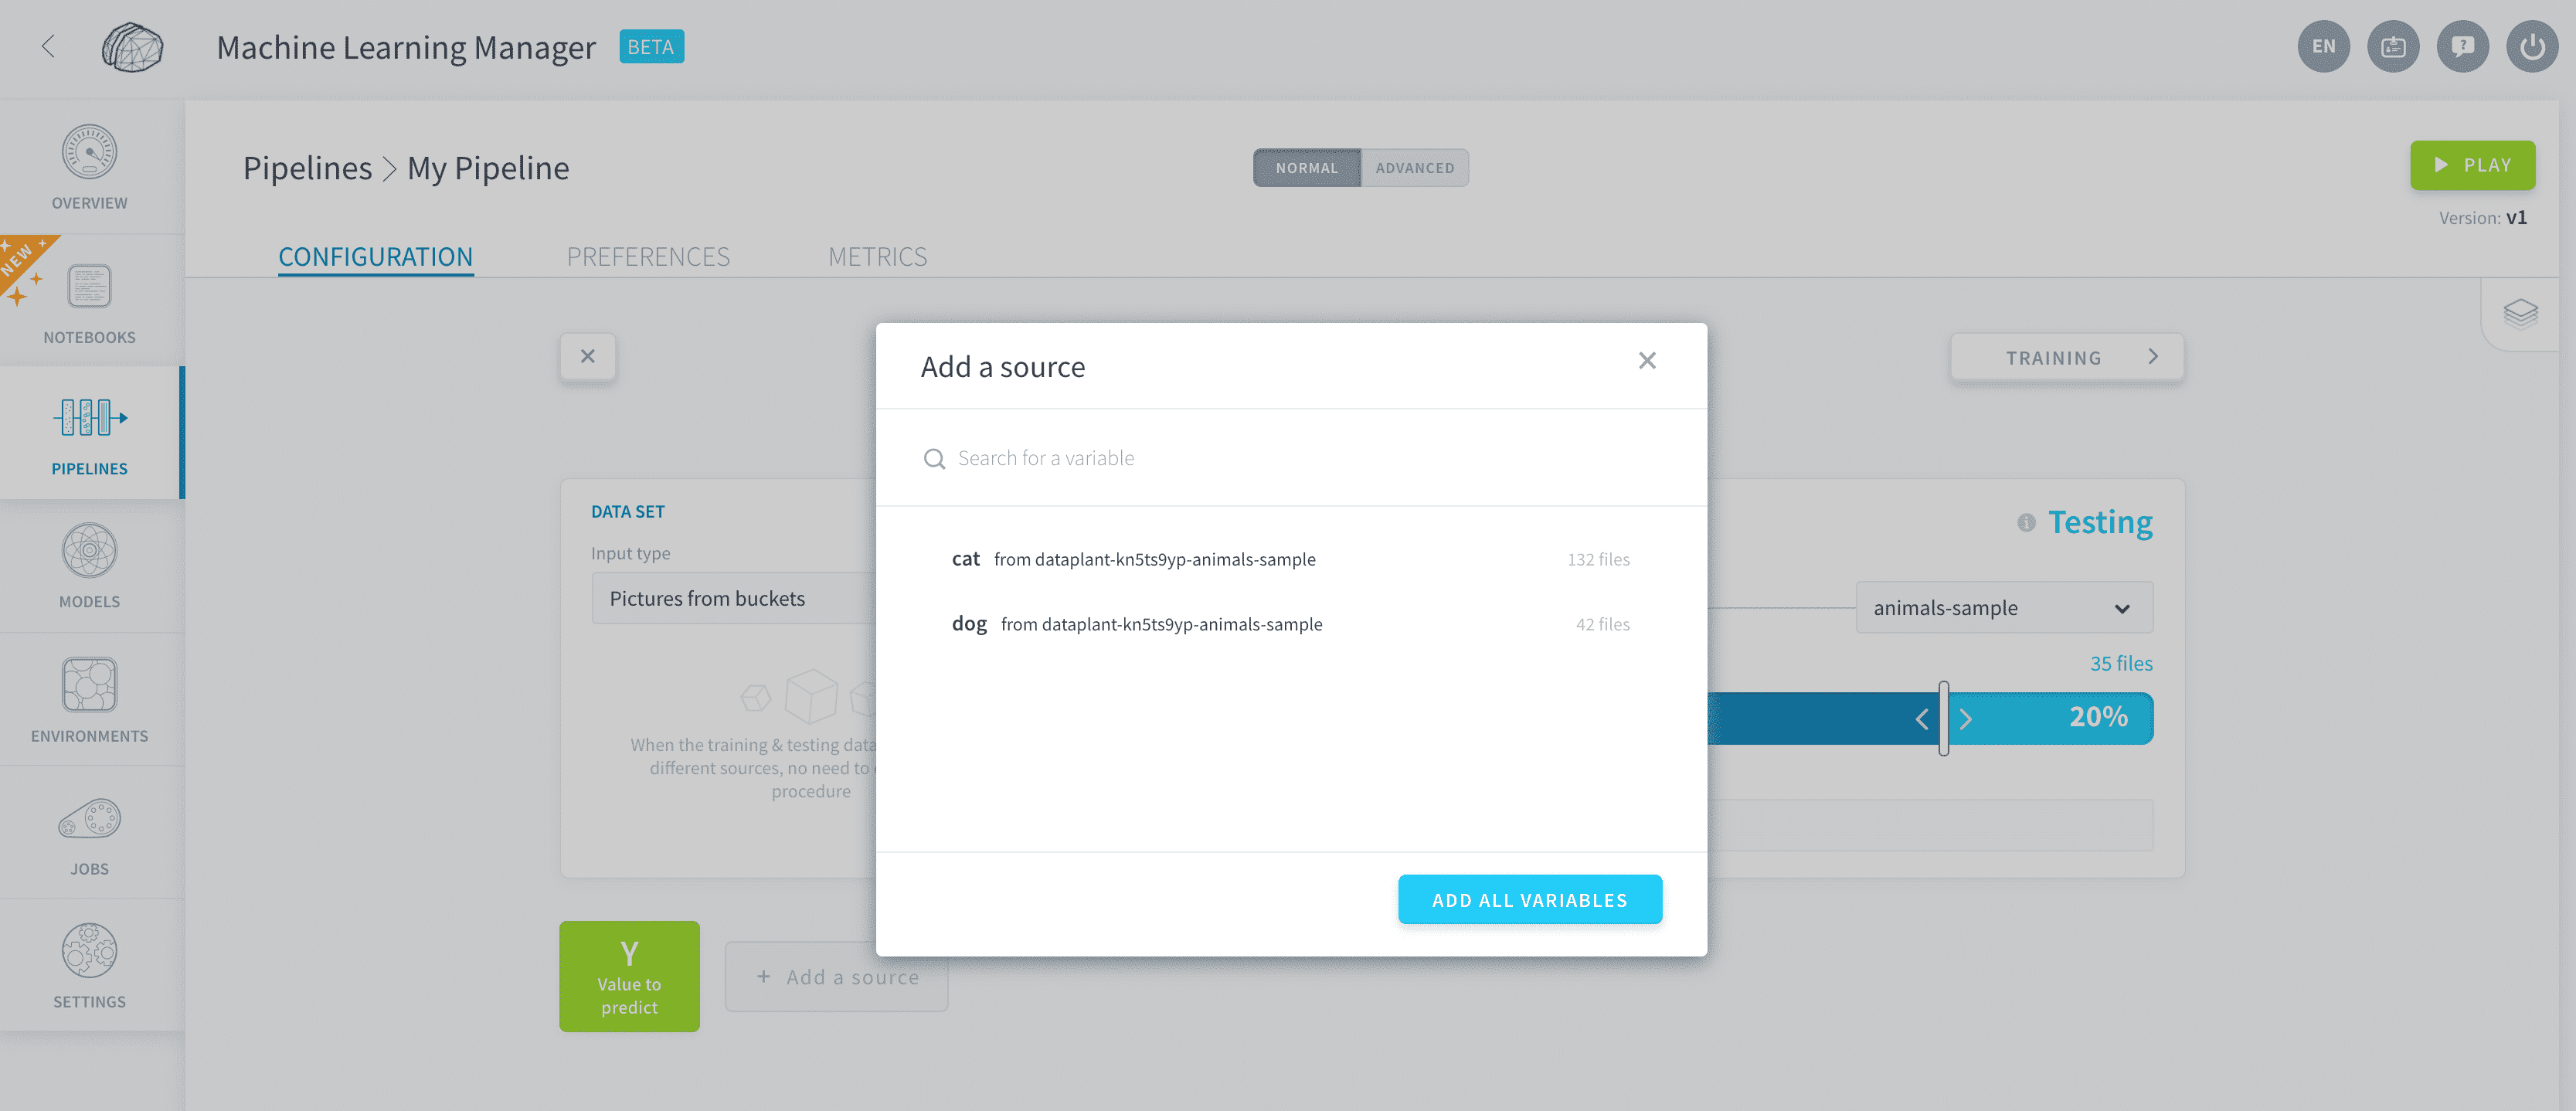
入力タイプがPictures from bucketsの場合
トレーニングバケットから1つまたは複数のフォルダを選択できます。
特徴量を追加する
予測に使用される特徴量、または変数はXデータセットに保存されます。構造化データモデルに特徴量を追加するには、Add a sourceをXの横にクリックします。
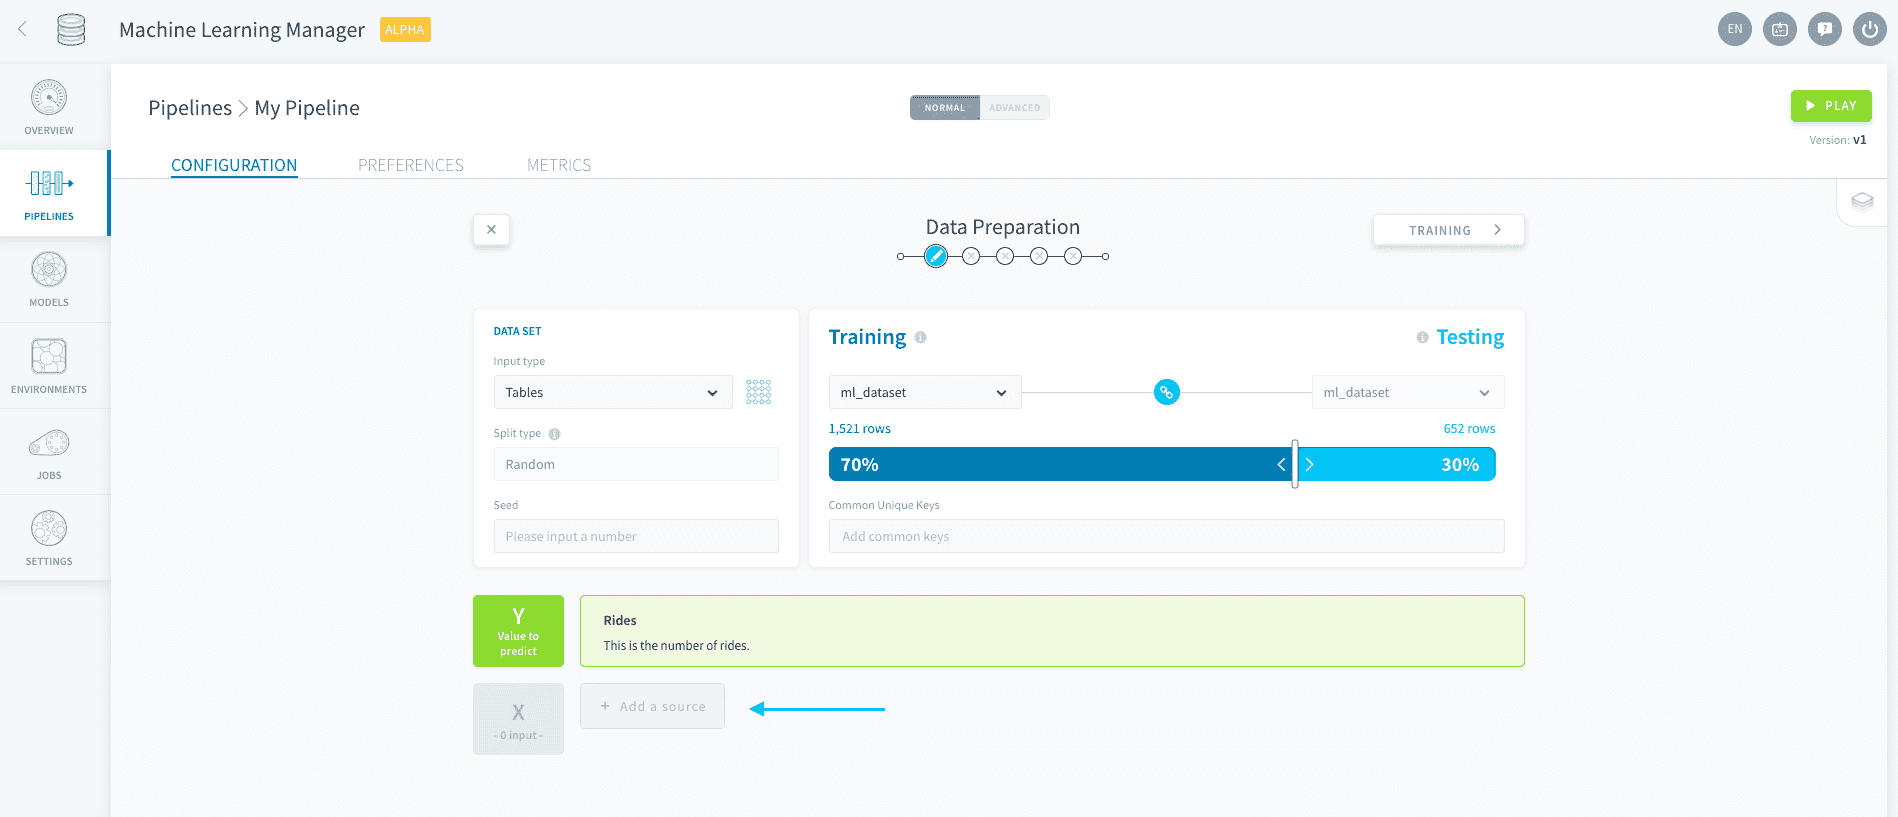
データセットを生成する時に指定した入力タイプに基づいて、ソースから必要なだけ変数を選択し、保存します。
ショートカットのヒント:一度にすべての変数を追加するオプションがあります。これにより、ソースからのすべての変数が追加されますが、予測値として選択したものを除きます。
前処理
高度な特徴量エンジニアリングは、ソース自体でData Processing Engine (DPE)上で実行する必要があります。
さらに詳しく
当社のソリューションを実装するためのトレーニングや技術サポートが必要な場合は、営業担当者にお問い合わせください、またはこのリンクをクリックして、当社のプロフェッショナルサービスの専門家にプロジェクトのカスタム分析を依頼するための見積もりを取得してください。
Data Platformを構築するチームと直接質問し、フィードバックを共有し、交流するには、専用のDiscordチャネルにアクセスしてください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。