

モデルのハイパーパラメータを微調整する
このチュートリアルでは、Machine Learning Managerを使用します。これは、ForePaaS Legacy Platformのサービスであり、OVHcloud Data Platformでは利用できません。現在のチュートリアルを参照してください。
このチュートリアルでは、Random Forestアルゴリズムのハイパーパラメータを設定し、最初のトレーニングとスコアリングジョブを実行します。
ハイパーパラメータは、データサイエンティストが学習プロセスの前に設定する機械学習アルゴリズムの核心的な変数です。これは、オーブンの温度と調理時間を設定するようなものです。同様に、ハイパーパラメータの設定とは、トレーニングに使用される基礎となる数学モデルの特定の構成を指します。 Wikipediaでハイパーパラメータについてさらに学ぶ。
以下の手順を実行します:
パラメータの最初の検索
ハイパーパラメータチューニングスタジオに到着しました。現在のところ空っぽです🙇♂️が、すぐに貴重な洞察で埋めることができます!
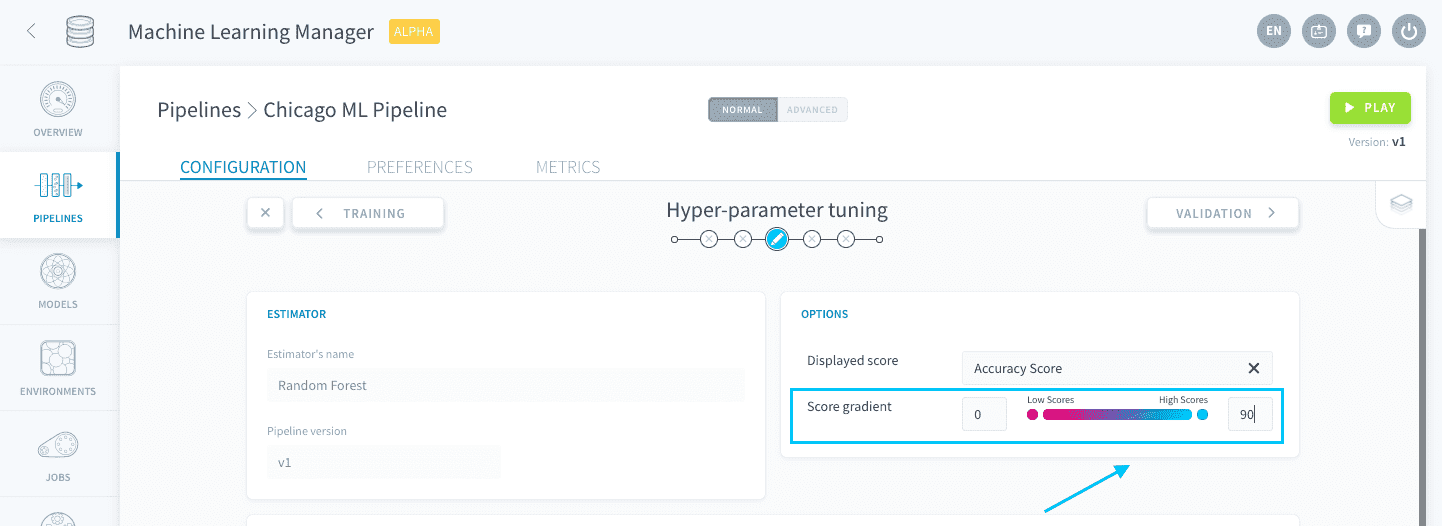
上部の2つのパネル、EstimatorとOptionsは、前のステップで選択したトレーニングアルゴリズムとスコアリング関数の概要を提供します。パイプライン内のスコアの色コードを変更することで、スコアグラデーションを構成できます。
ハイパーパラメータのリストに焦点を当てましょう。これは、ランダムフォレストアルゴリズムを構成するすべてのパラメータで埋められています。
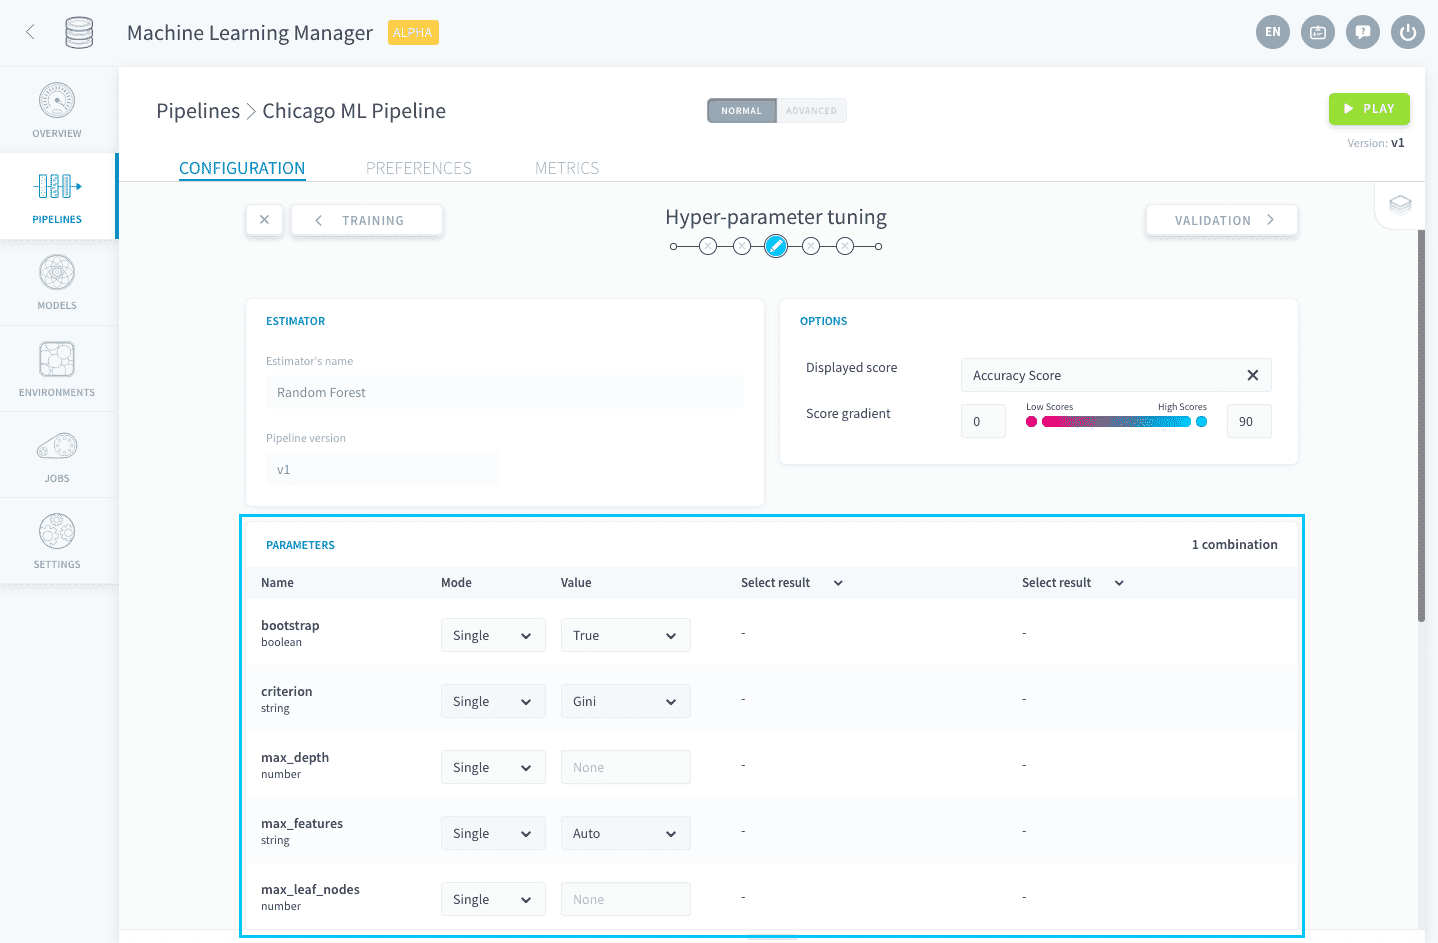
ハイパーパラメータチューニングスタジオでは、複数の構成を生成し、トレーニングとスコアリングを行うことができます。これにより、最適なハイパーパラメータの組み合わせについての洞察を得ることができ、その組み合わせのいずれかを使用するか、検索の2回目の反復でより正確になることができます。デフォルトでは、各反復はスコアに基づいて最良のモデルのみを保存し、次のステップで使用するためのものです。
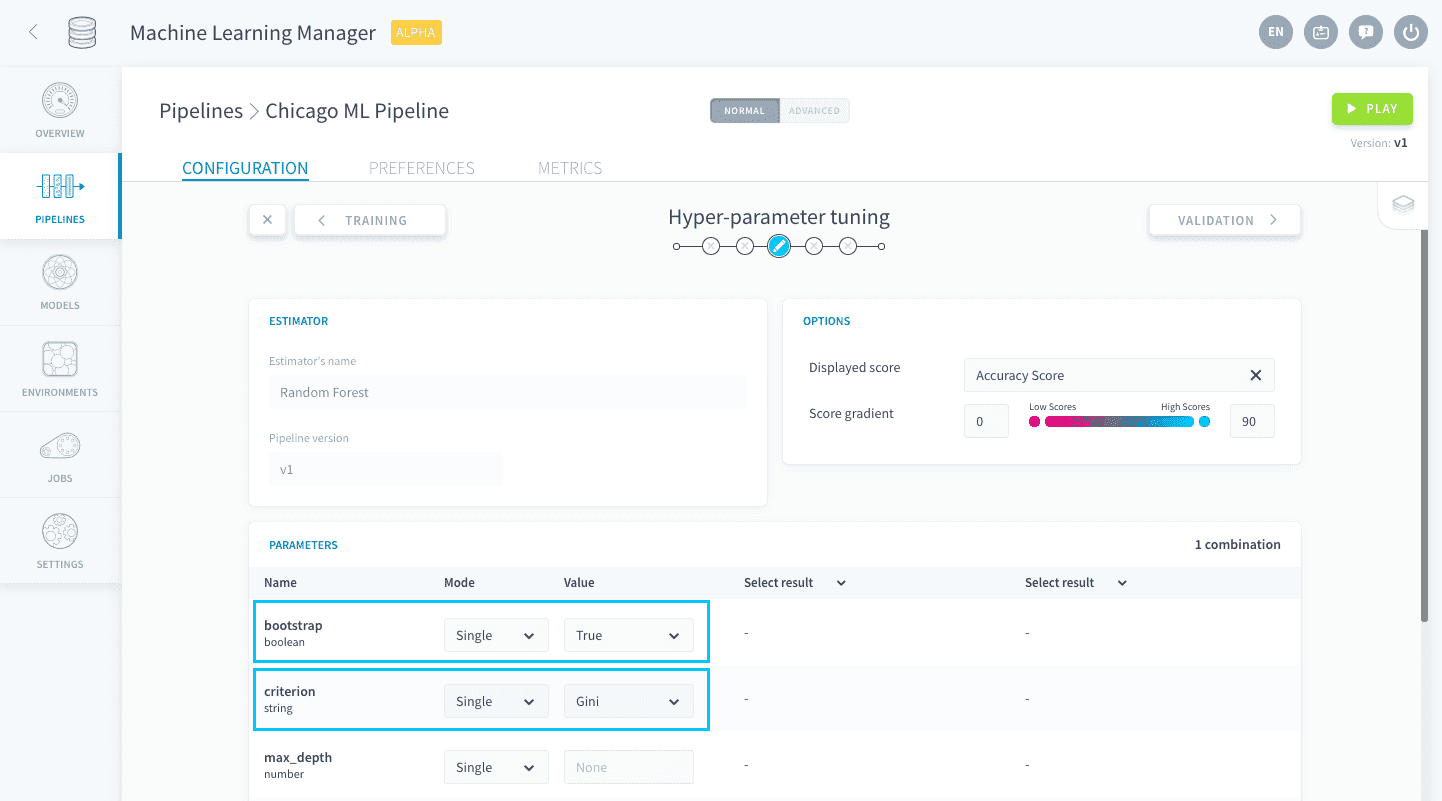
リストの最初の2つのパラメータはbootstrapとcriterionです。これらはSingleモードで、デフォルト値TrueとGiniのままにしてください。
💡 すべてのパラメータには、アルゴリズムによって定義されたデフォルト値があります。
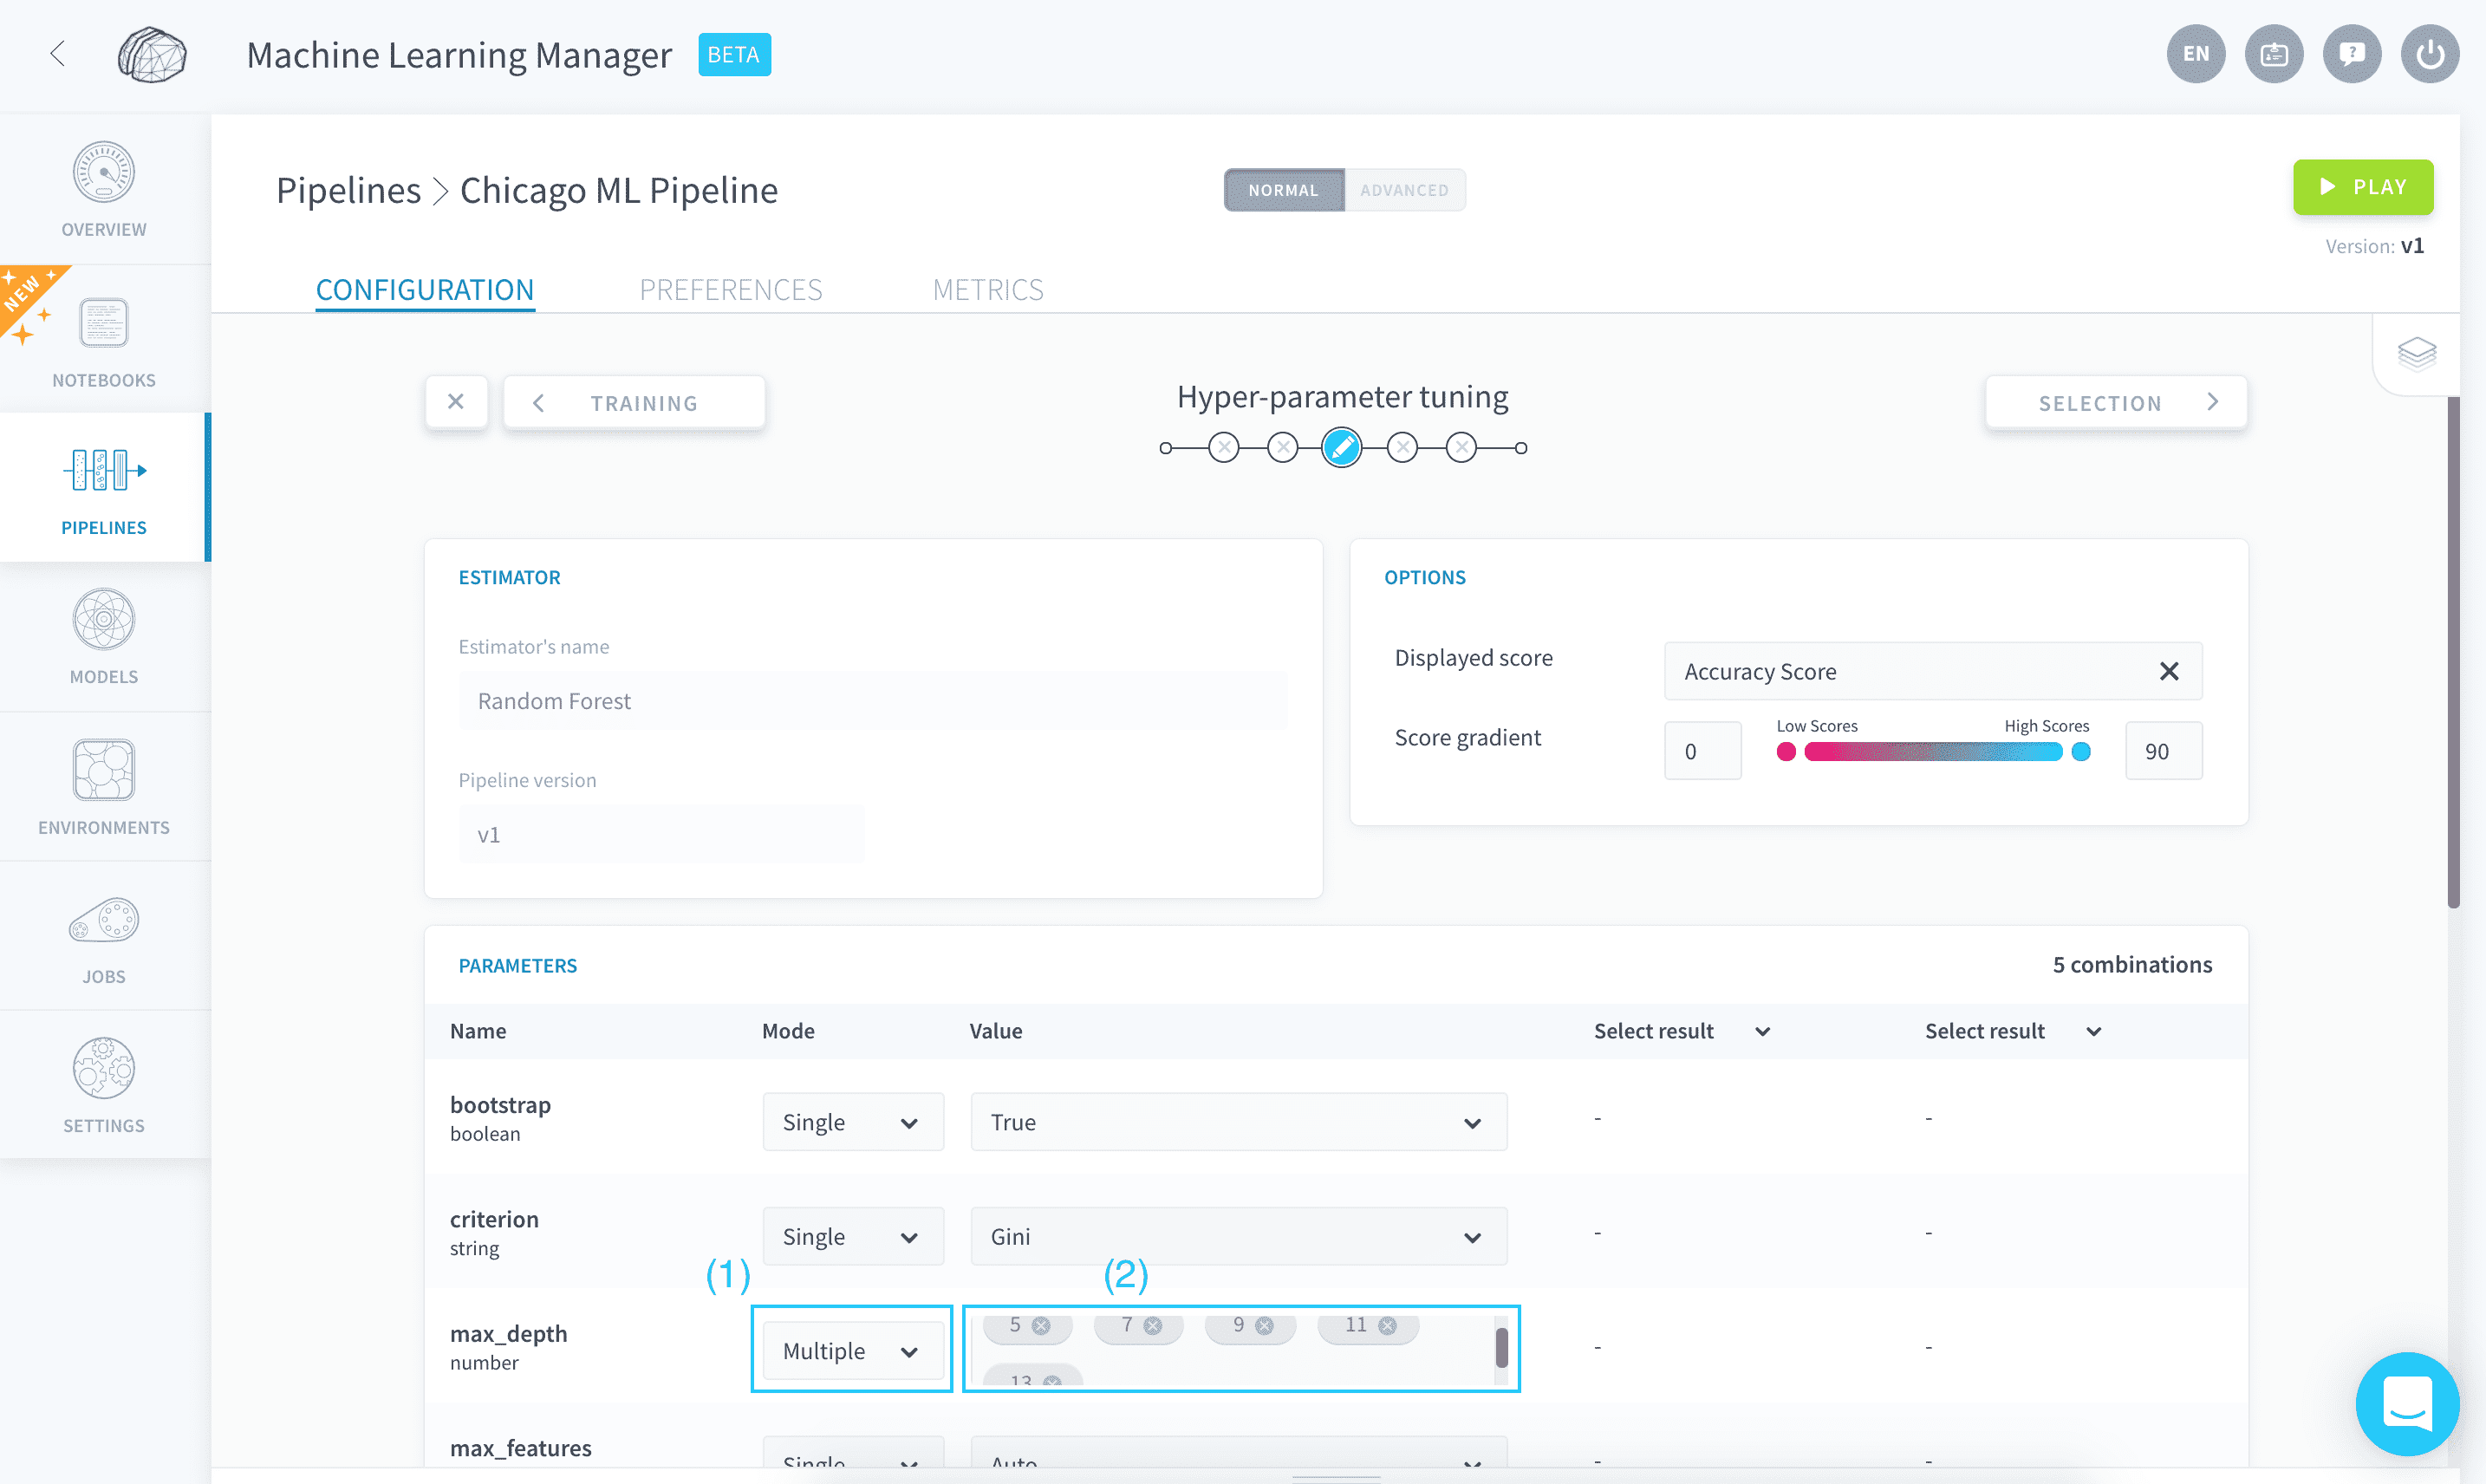
リストの3番目のパラメータはmax_depthです。これは、フォレスト内の各決定木の最大可能な深さを表します。
💡 各ハイパーパラメータの説明を取得するには、名前の上にマウスを置きます。
このパラメータのいくつかの値を探索してみましょう。ModeをMultipleに設定し、ValueフィールドでNone値タグを削除し、5、7、9、11、および13を入力します。
次に、リスト内のパラメータn_estimatorsを見つけます。これは、使用する決定木の数を定義します。 スコアは通常、木の数に応じて増加しますが、トレーニング時間と過剰適合のリスクも増加します。ModeをMultipleに設定し、Valueフィールドで100値タグを削除し、50、200、および400を入力します。
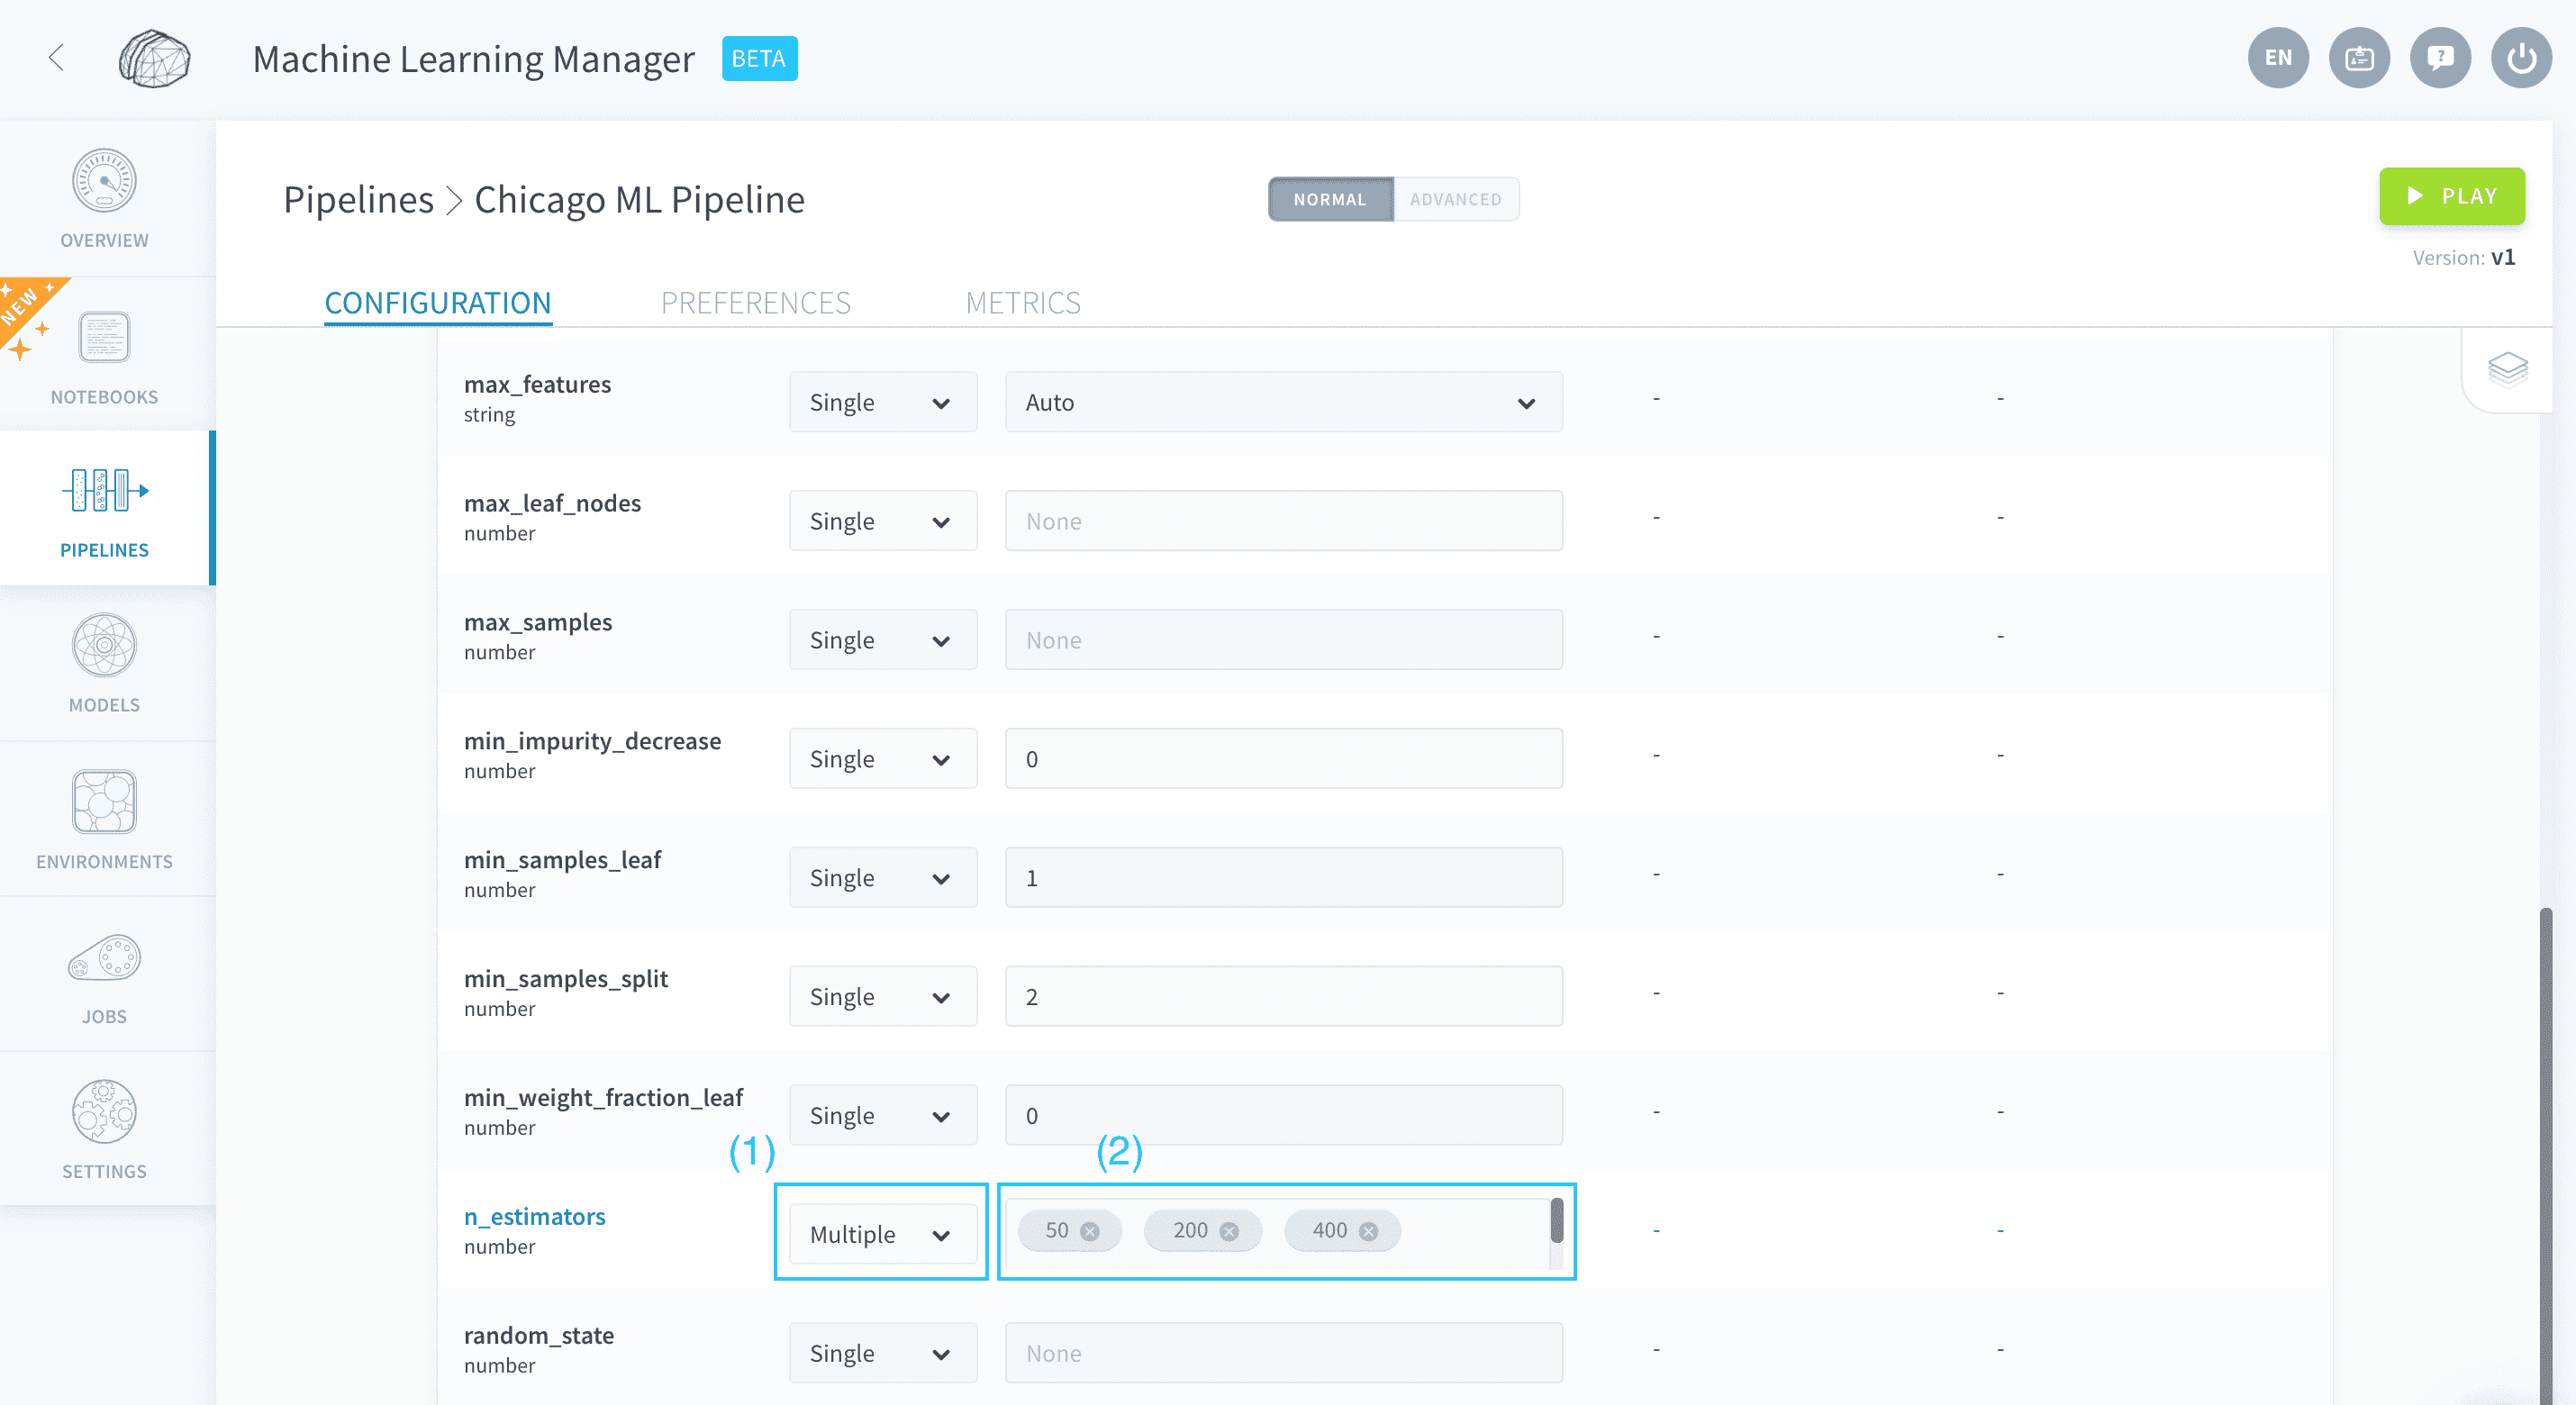
最後に、すべての他のパラメータの構成が以下のようになっていることを確認します:
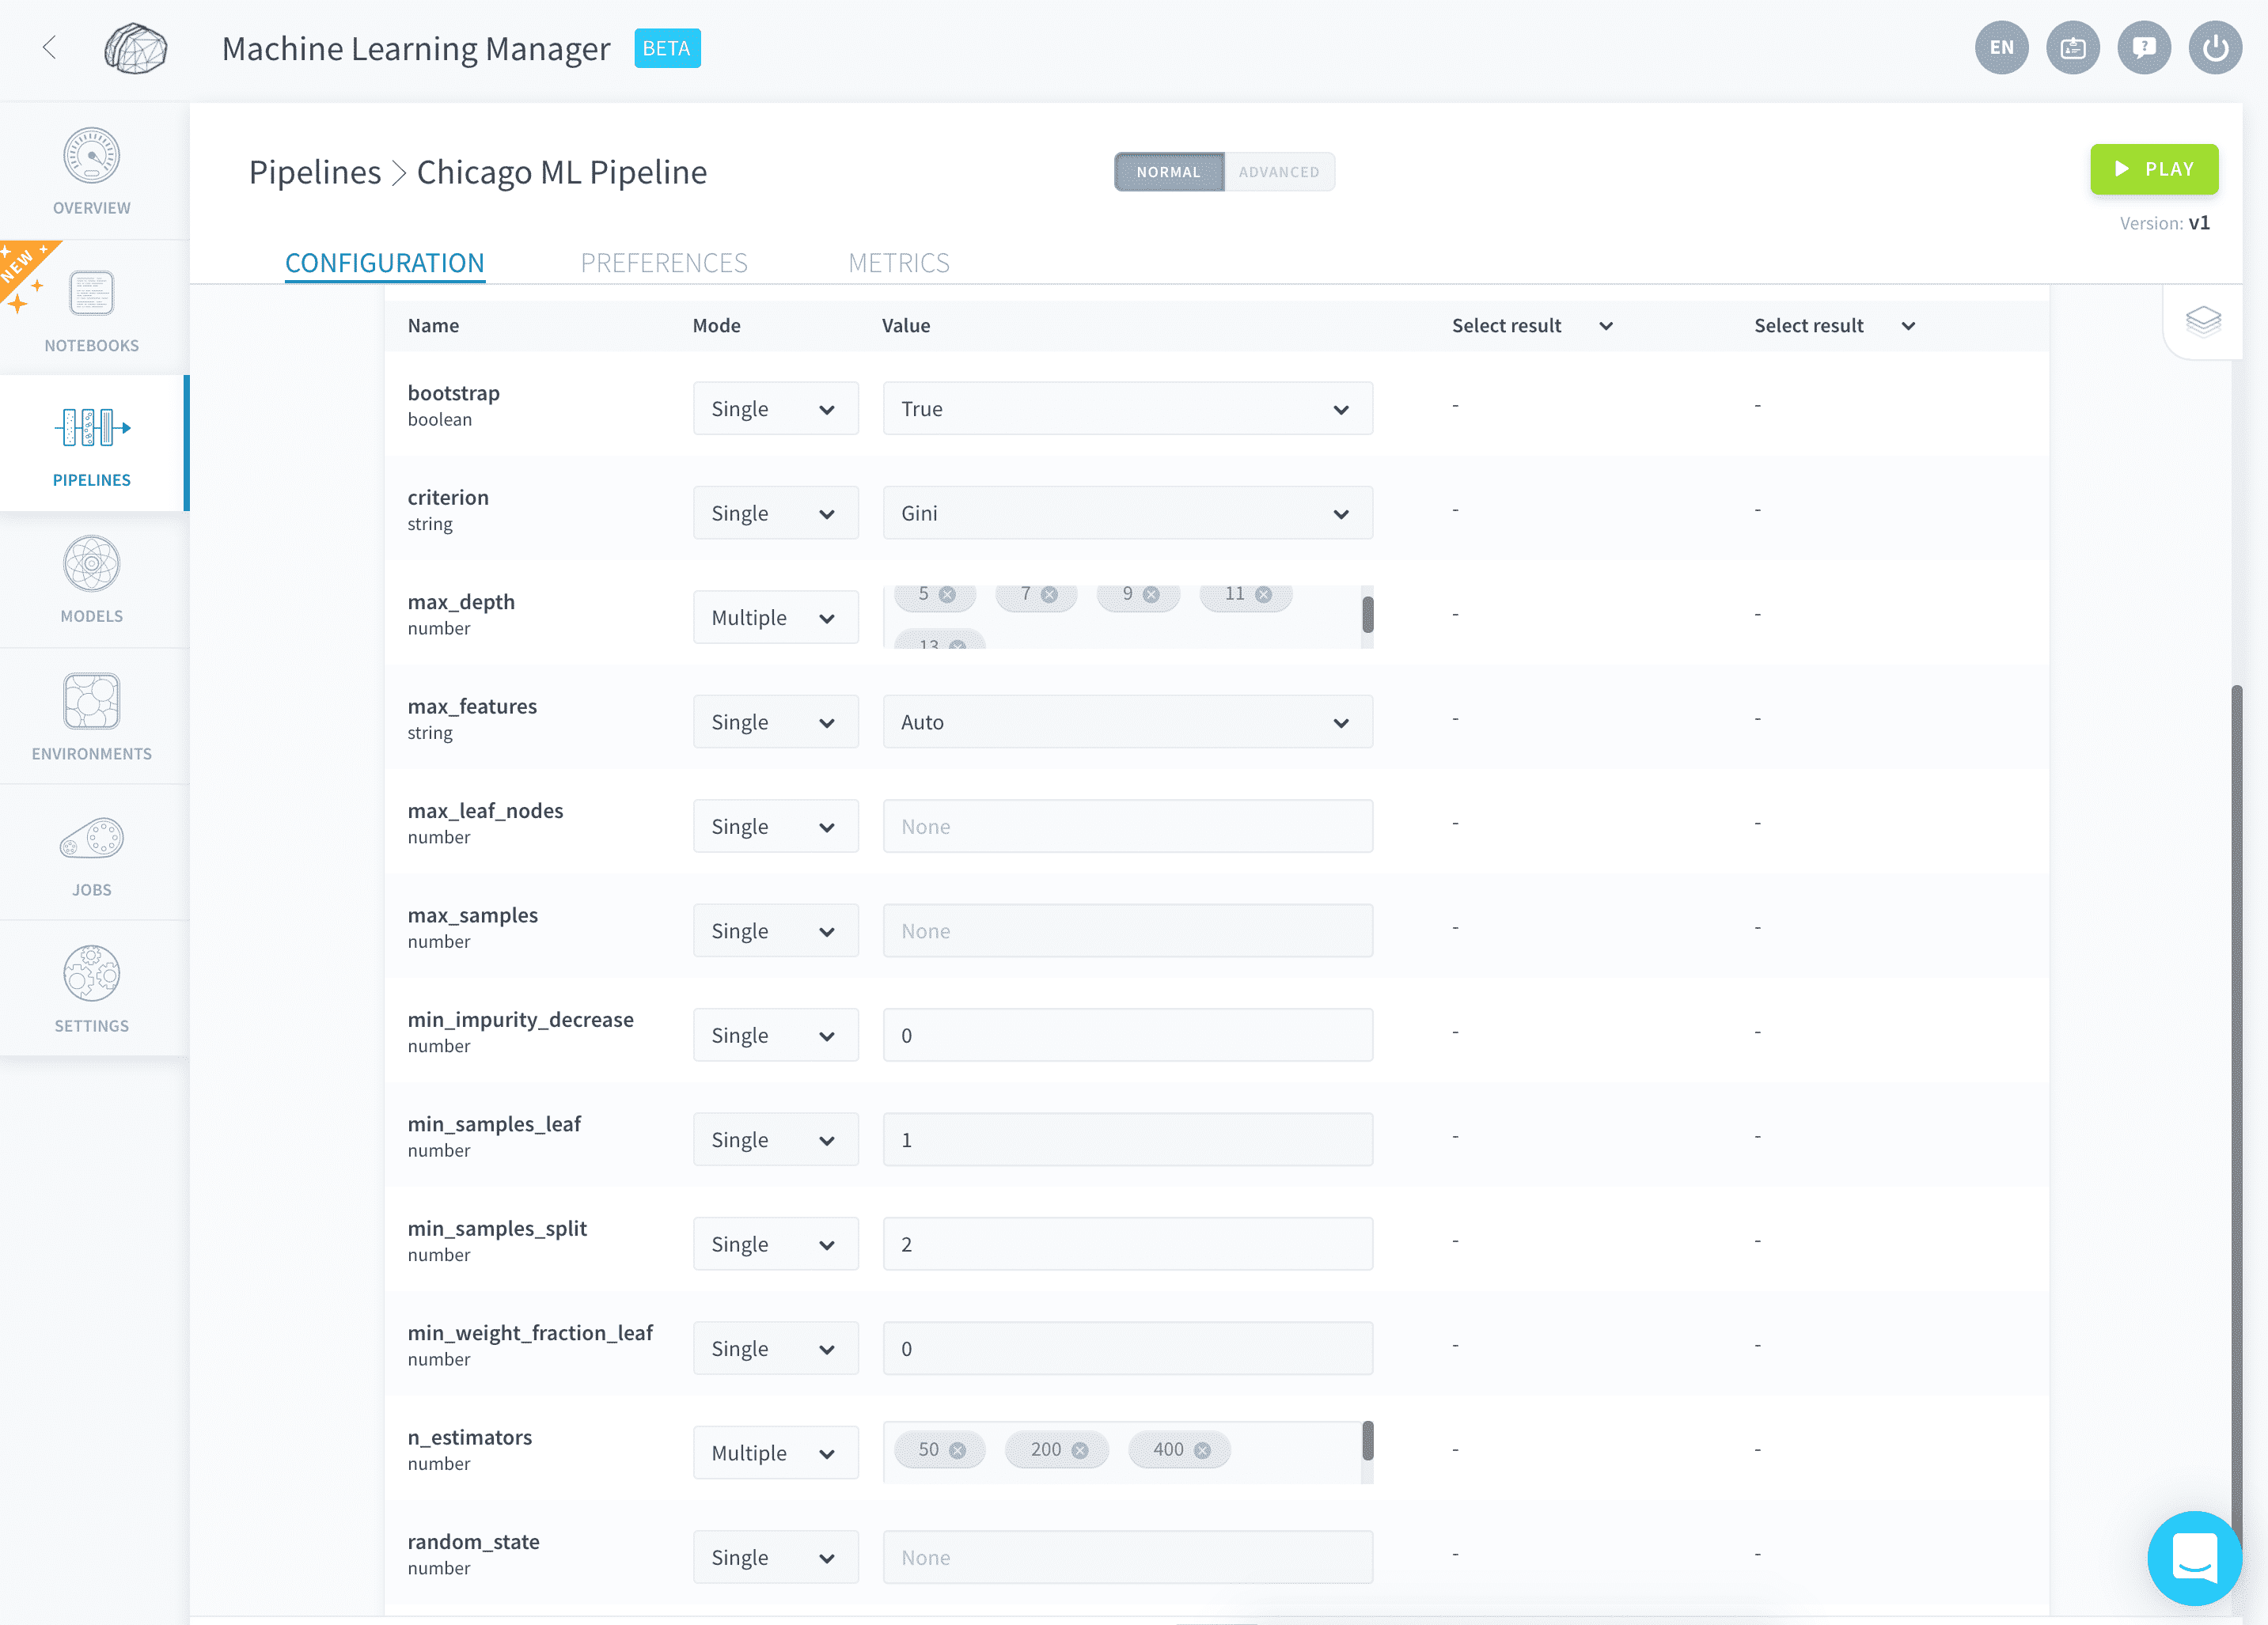
パラメータリストの右上部にあるように、15の組み合わせを生成します。
これで、パイプラインを初めて実行する準備が整いました。Playを押します。Dataset GenerationとTrainingのみを有効にし、実行します。
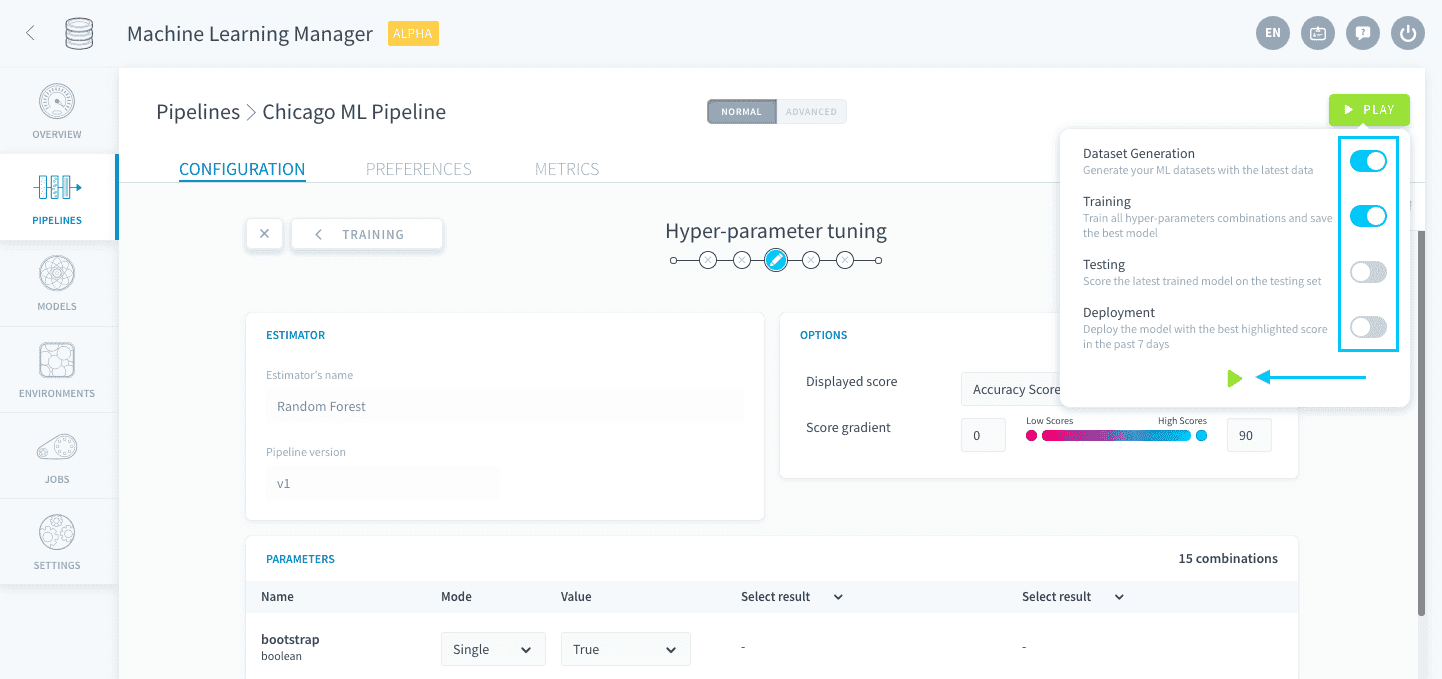
ホットドリンクが必要です。☕️ その間に、ForePaaS Platformはデータセットを生成し、モデルをトレーニングし、検証セットで組み合わせをスコアリングするためのクラウドインスタンスを展開しています。
5分後、すべてのジョブが完了し、次のステップに進むことができます:勝者モデルのデプロイ。