

データセットにテーブルを整理する
データセットは、標準または外部形式のテーブルを論理的にグループ化し、デフォルトのパラメータを共有するものです
目的
データセットは、テーブルの論理的なグループ化であり、テーブルがいくつかのデフォルトのパラメータを共有できるようにします。プラットフォームは、標準および外部のデータセットの両方をサポートして、テーブルを管理できます。
デフォルトでは、default_datasetという標準データセットが提供されます。この標準データセットは、Apache Icebergに基づくLakehouse Manager Engineを使用します。
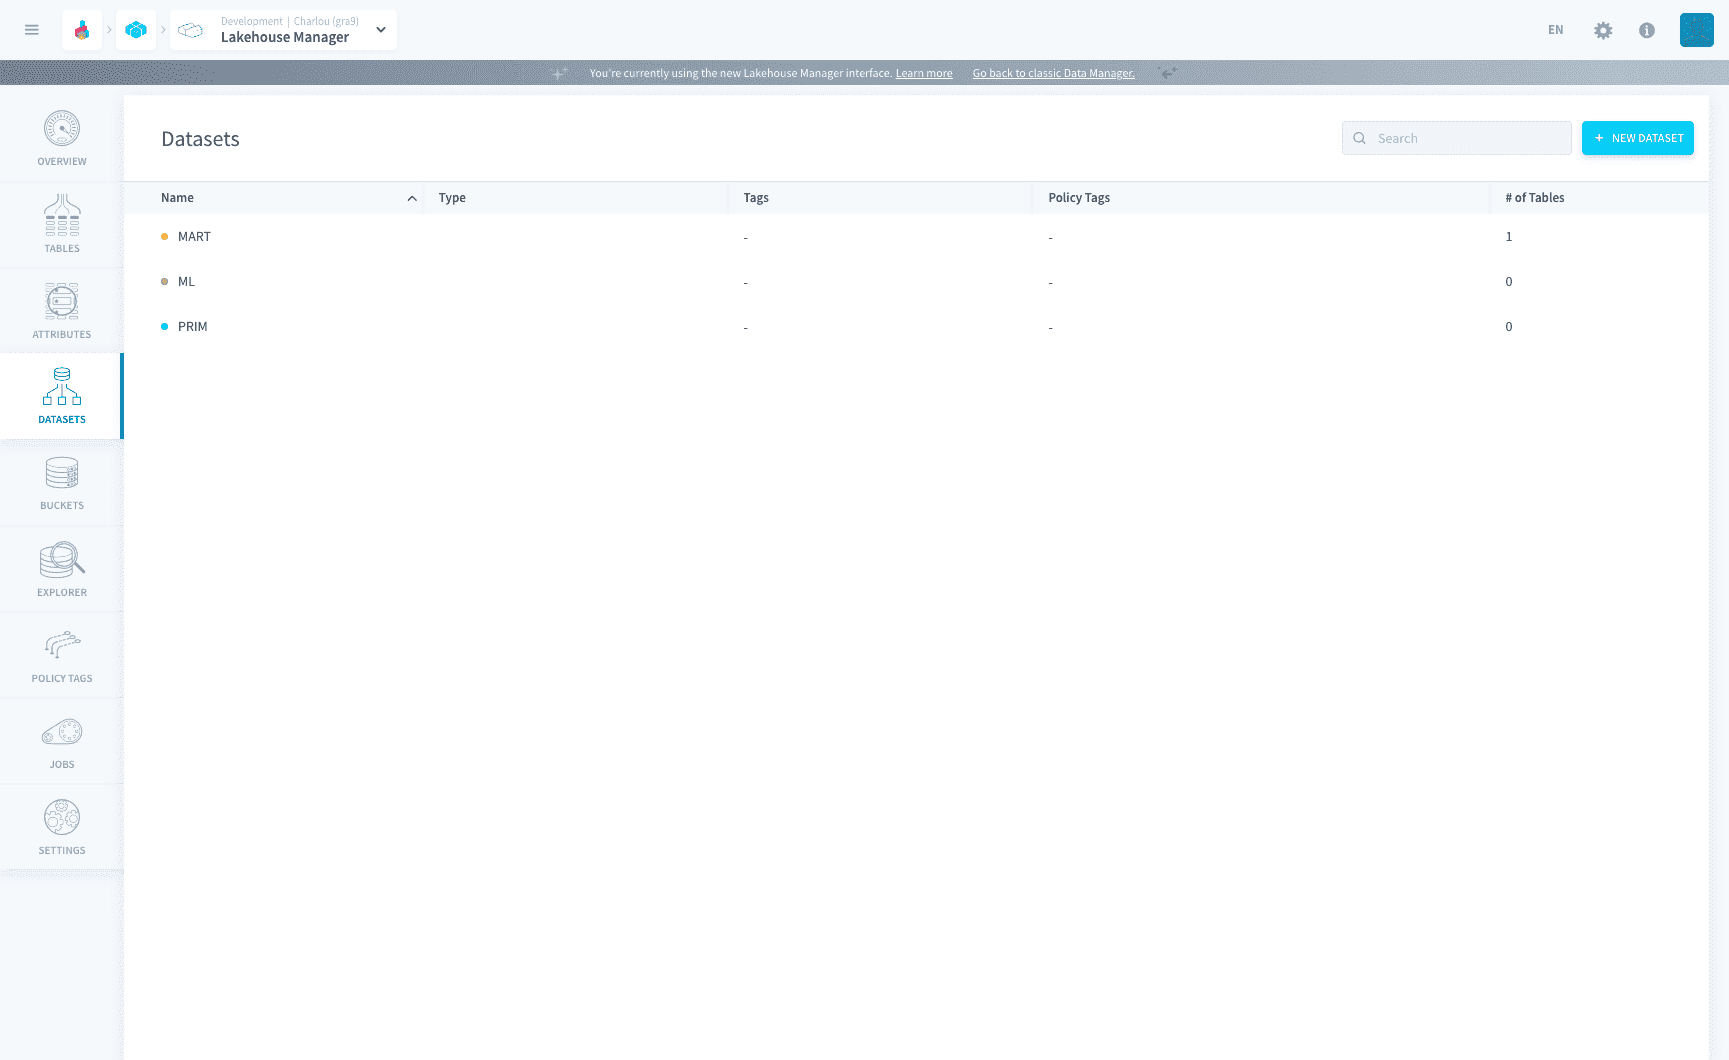
データセットを作成すると、クエリに使用できるようになるまで60秒の待機期間があります。
データセット
データセットは、ユーザーがテーブルのパラメータをグループ/データセットレベルで管理することを促進するために設計されています。リストビューからデータセットを編集、複製、削除できます。
標準データセット
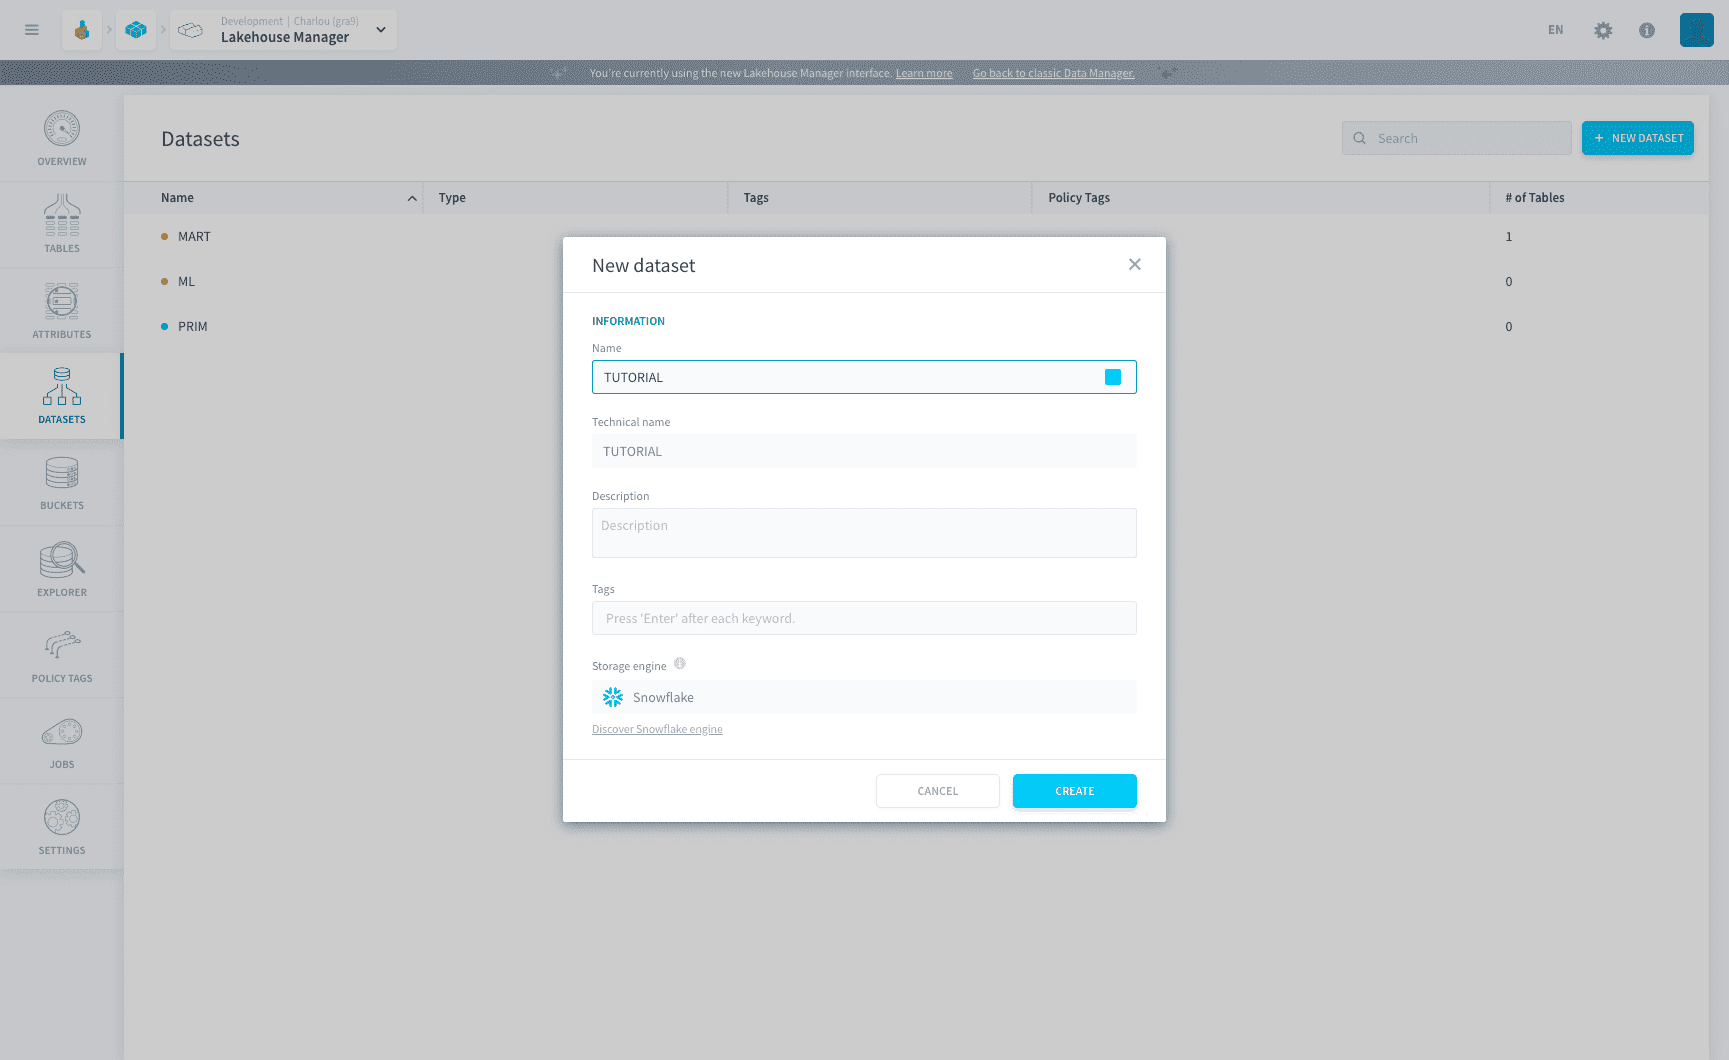
Lakehouse Managerは、標準データセットのデータ管理サービスであると同時に、ストレージエンジンの役割を果たします。データセットの作成中にdiscoverリンクをクリックすることで、このエンジンについてさらに詳しく学ぶことができます。
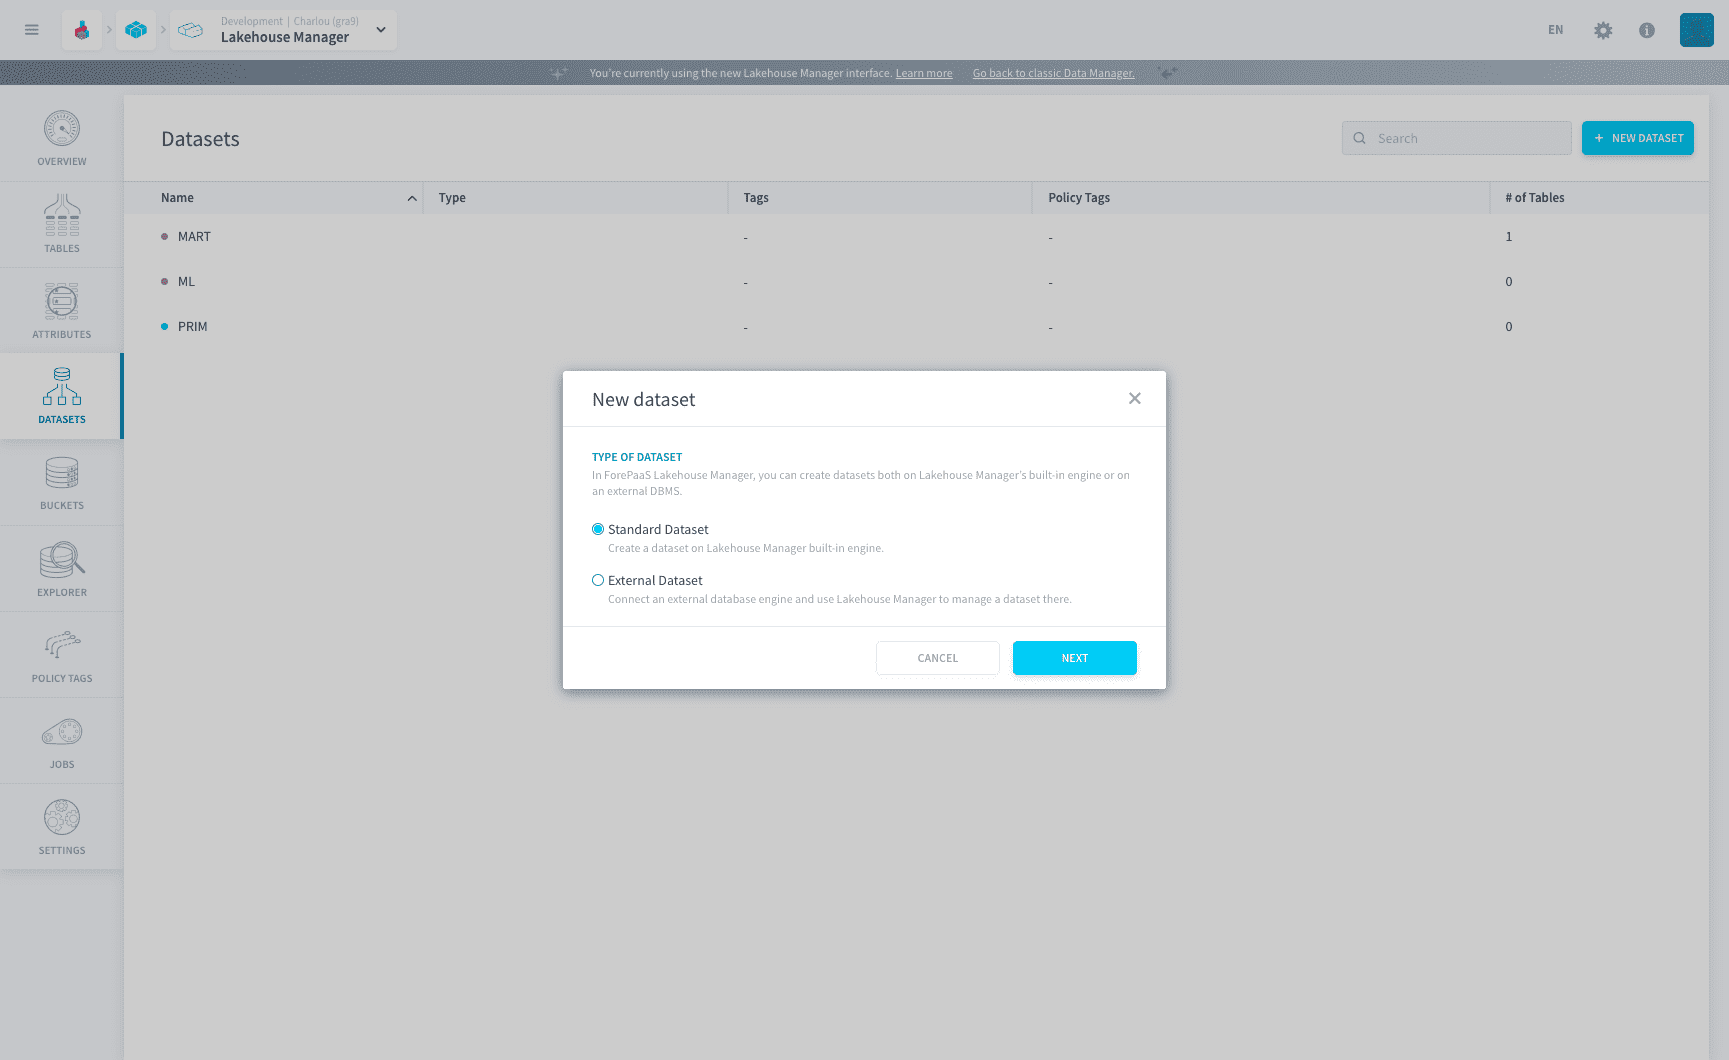
新しいデータセットを作成するには、新しいデータセットボタンをクリックし、次に標準データセットを選択します。必要なデータセットフィールドをすべて入力し、作成をクリックします。
データの保存方法
Lakehouse Managerは、データの論理的な組織化と、実際のバイトが存在する場所を分離します。混同しやすい3つの概念があるため、それらを分けておくことが役立ちます。
- データセット: テーブルをグループ化する論理的なエンベロープ。データセット自体はデータを保存しません。
- テーブル: Apache Icebergに保存され、Lakehouse Managerによって管理される物理的なオブジェクト。
- バケット: Lakehouseとは独立した非構造化ファイル用のS31互換オブジェクトストレージ。バケットを参照してください。
したがって、データセットはバケットではありません: テーブルの論理的なグループ化です。
データセットはメタデータのみを保持するため、データセットを共有または移動してもデータはコピーされません: Lakehouseが指す対象が変更されます。クロスプロジェクト共有を参照してください。
データセットの管理
設定ページには、データセットについて知っておく必要があるすべての情報が表示されます。データセットの説明とタグを編集できます。また、ストレージエンジンの使用とデータ居住地の場所などのデータ居住ポリシーを表示できます。
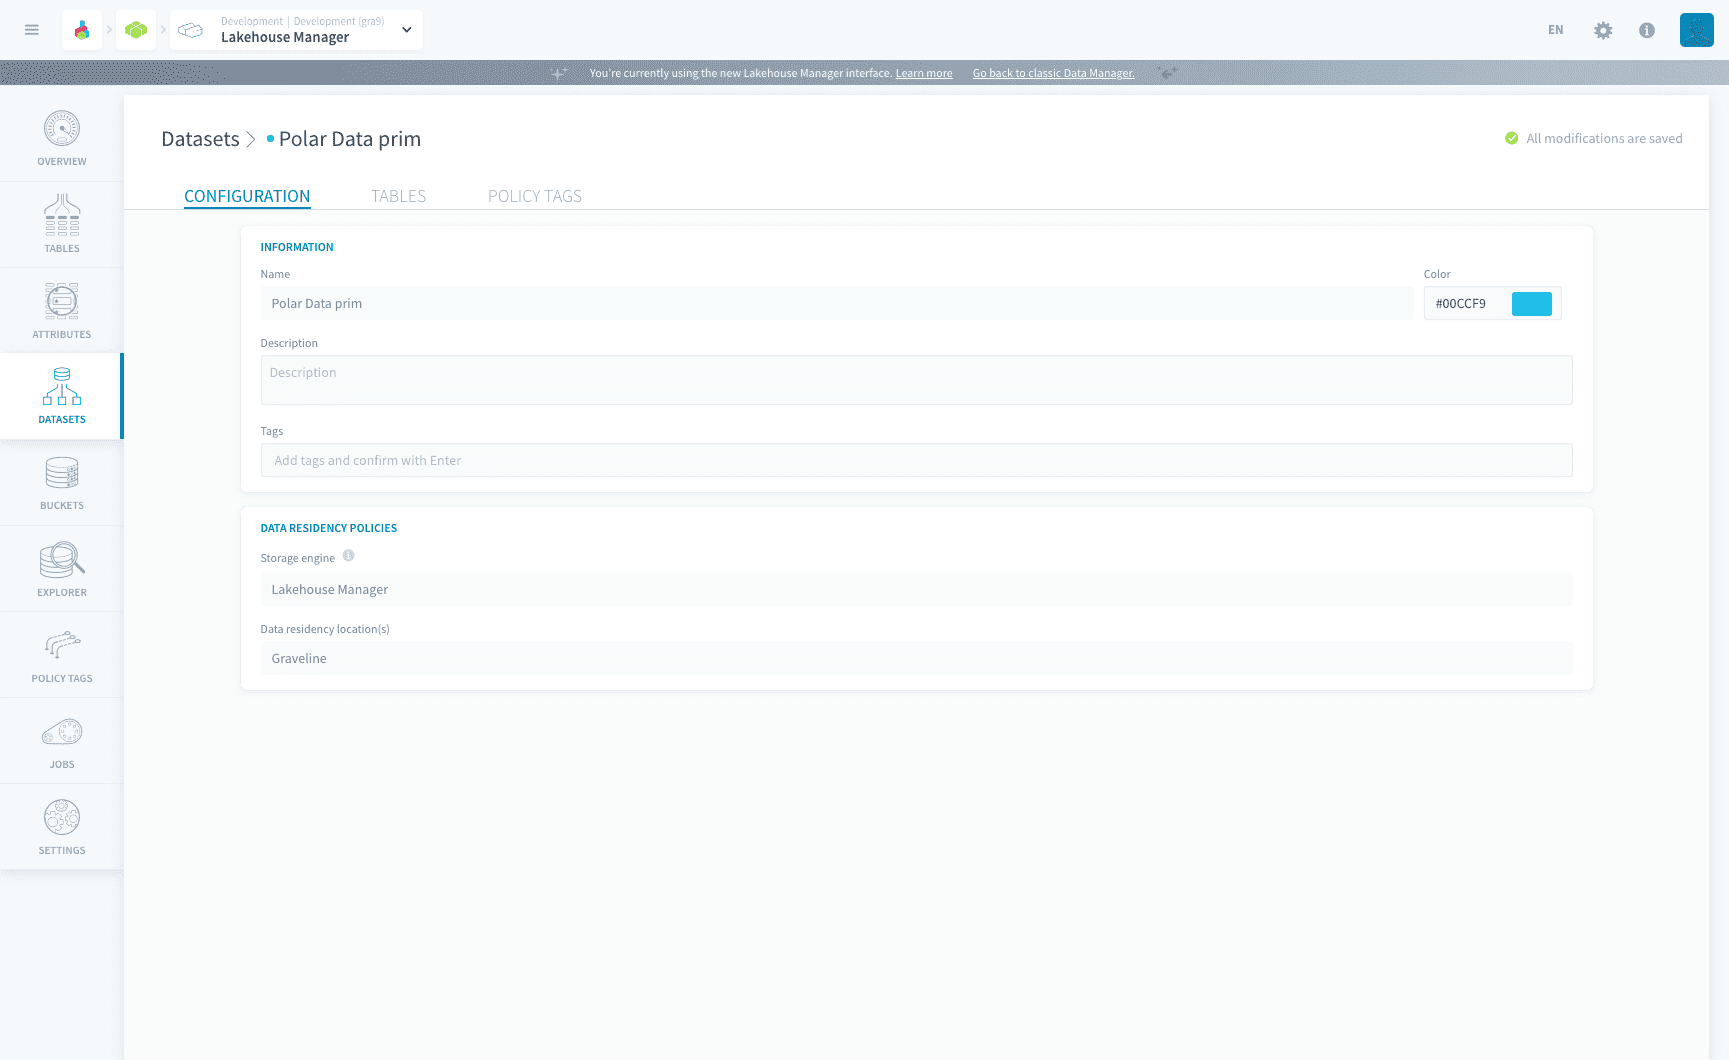
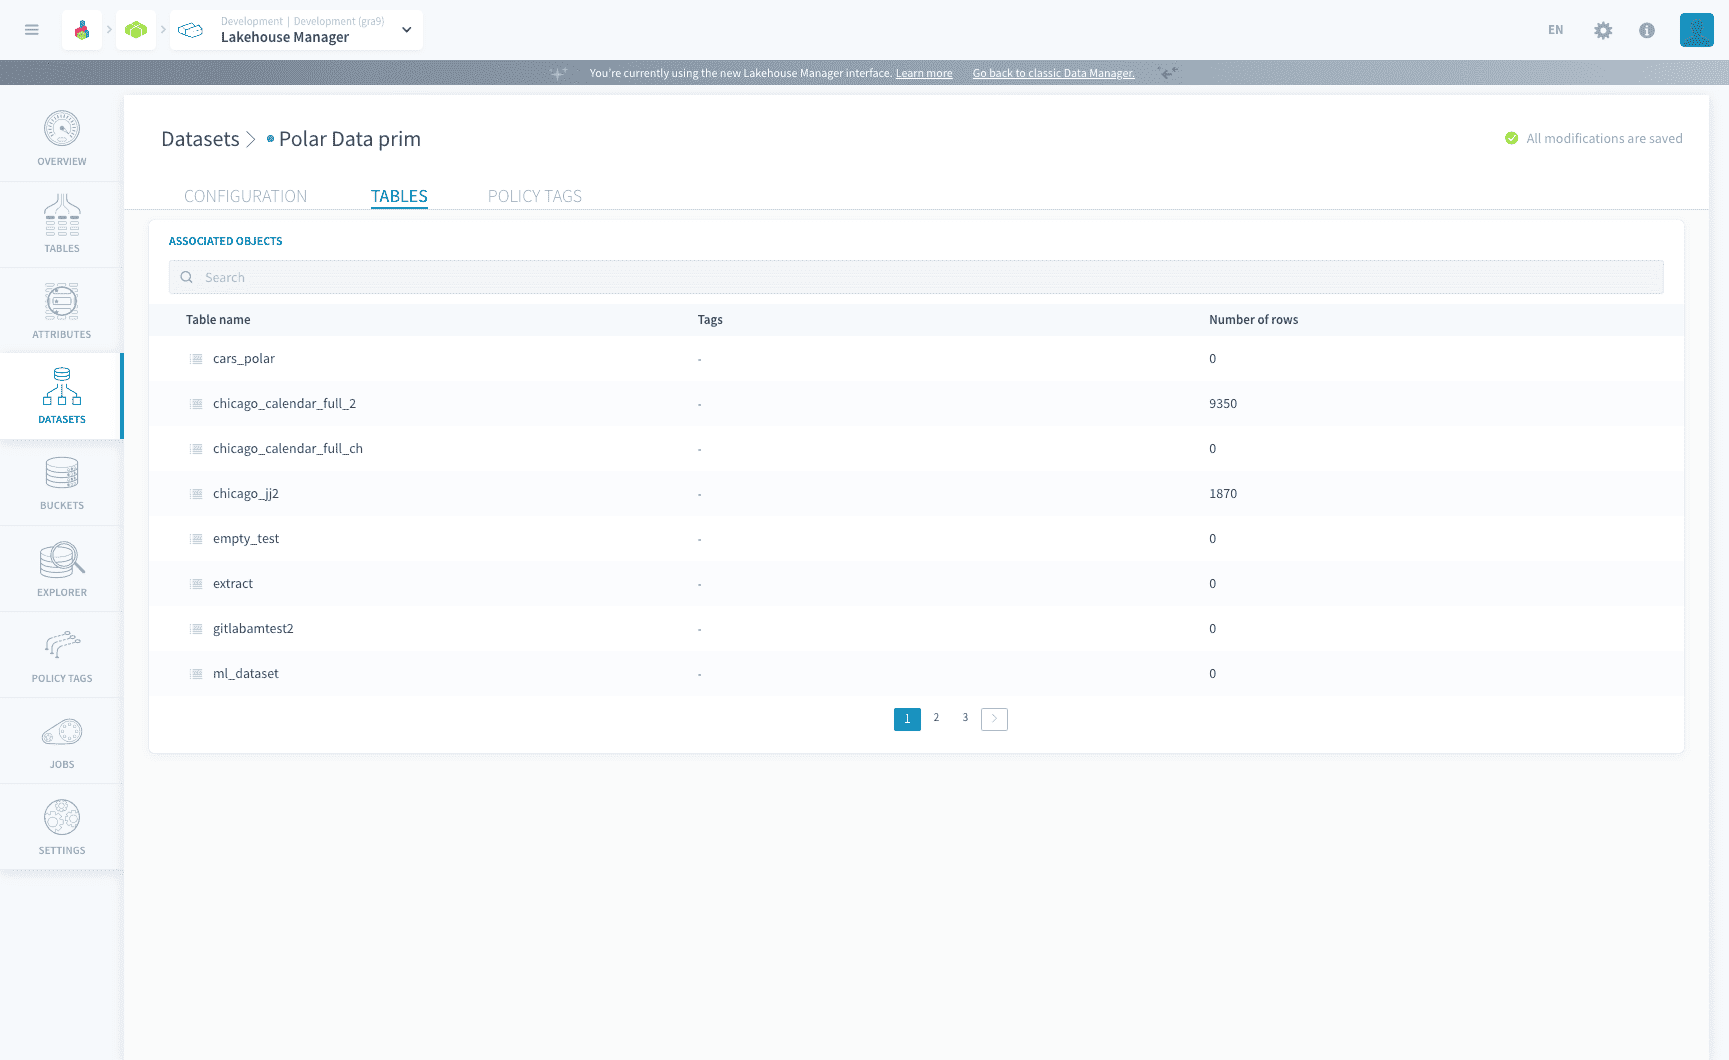
テーブルタブでは、データセットの一部である関連テーブルをすべて表示できます。このメニューからテーブルを編集できないことを覚えておくことが重要です。
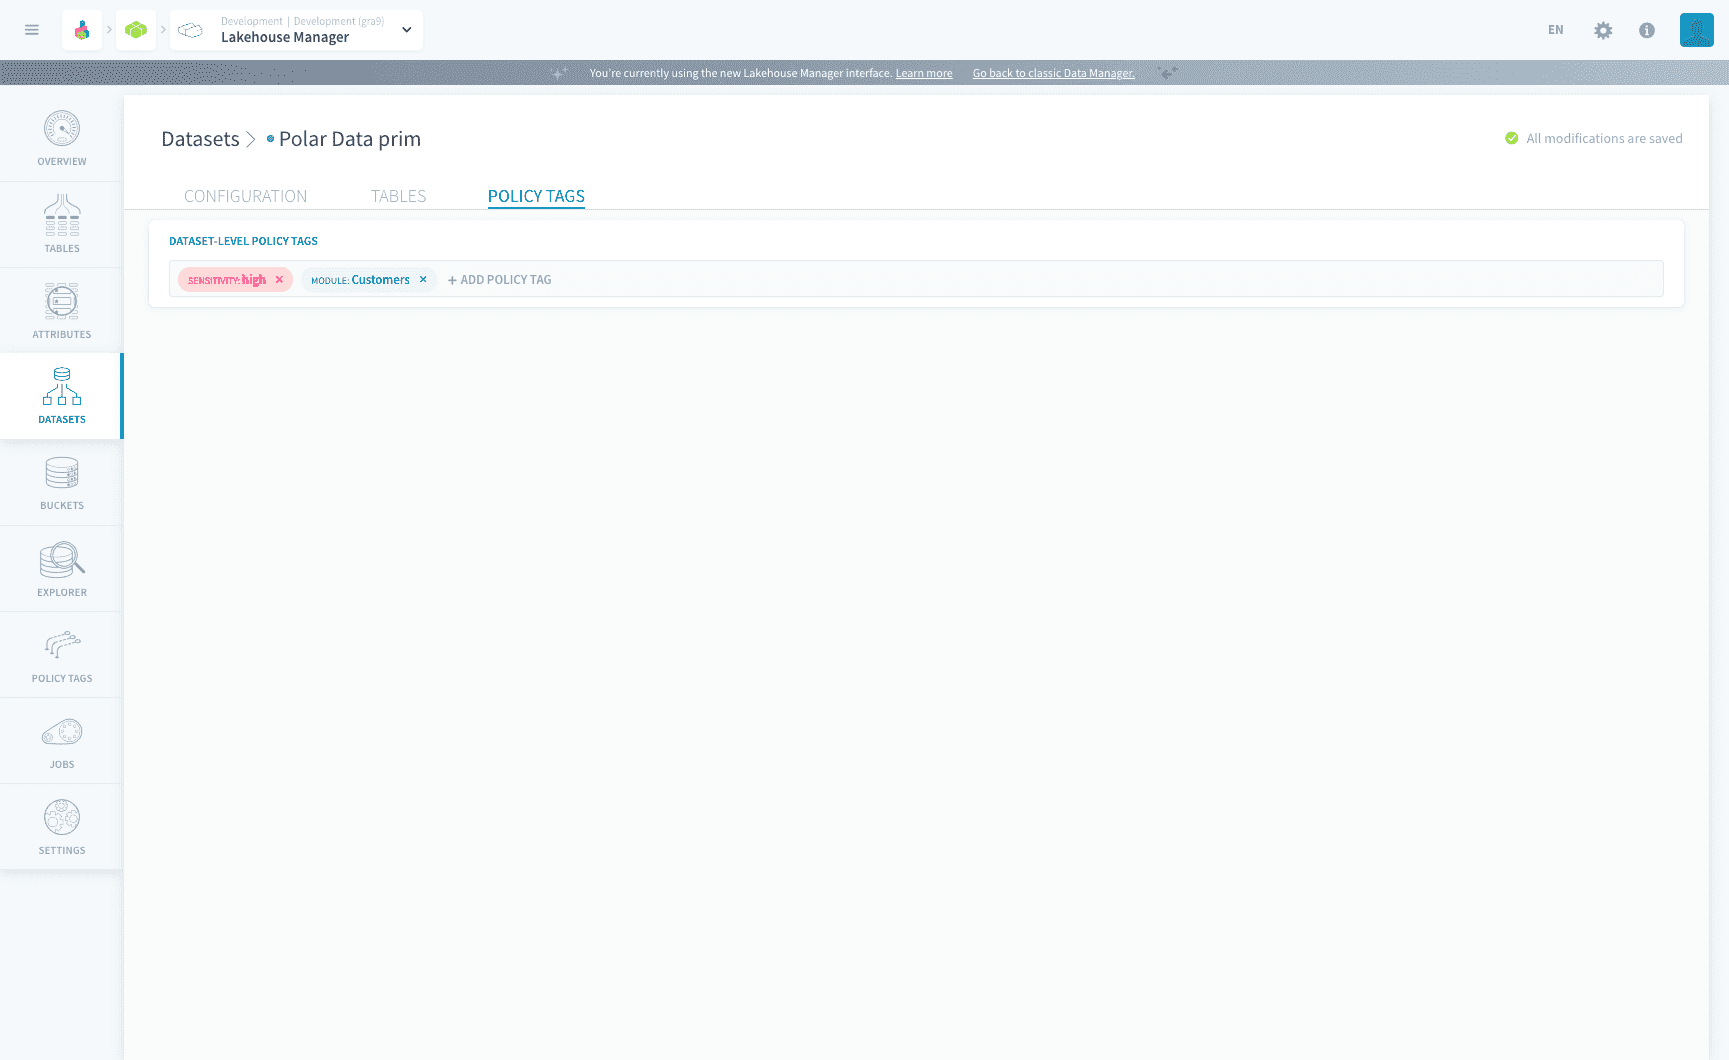
ポリシータグメニューを使用すると、データセット全体のポリシータグを割り当てることができ、そのポリシータグはデータセットの一部であるすべてのテーブルにさらに適用されます。 利用可能なポリシータグから選択するか、ポリシータグをその場で作成することもできます。ポリシータグをバインドする手順はこちらです。
データの整理: メダリオンアプローチ
Data Platformは、Bronze / Silver / Gold(「メダリオン」)アーキテクチャを指定しません: 構成に合わせてLakehouseをモデリングする自由があります。デフォルトでは、データセットが提供されます(default_dataset)。
ただし、データセットでメダリオンレイヤーを管理することは、有効なパターンであり、プラットフォームの残りの部分と自然に連携します。典型的なパイプラインは次のようになります。
- Bronze: Connectorsを通じて取り込まれた生データ。
- Silver: Data Processing Engineアクションによってクリーンアップ、検証、重複排除されます。
- Gold: Data Processing Engineアクションによってエンリッチ、結合、集計され、Analytics ManagerまたはBIツールで消費する準備ができています。
各レイヤーはデータセットです。レイヤー間の変換は、ワークフローでオーケストレーションされたアクションです。
クロスプロジェクト共有(ベータ)
この機能は現在ベータ版です。問題が発生した場合は報告してください。
デフォルトでは、Data Platform上の各プロジェクトは完全に分離されています:他のプロジェクトからデータセットにアクセスする暗黙の方法はありません。クロスプロジェクト共有により、データセットの所有者は、ソースプロジェクトから、1つまたは複数の受信プロジェクトに対して、制御された方法でデータセットを公開できます。既存のセキュリティ境界を破ることなく、です。
共有が行うことと行わないこと
- 共有はデータセットレベルで行われ、同じ組織内のプロジェクト間で行われます。他の組織と共有することはできません。
- 共有されたデータセットは単一のもので、コピーではありません。読み取り、書き込み、ビルド、およびノートブックやカスタムアクションでの使用は、ソース側と受信側の両方で同じ基盤となるデータに適用されます。
- 現在、共有は完全なものです:受信プロジェクトに対してデータセット全体が公開されます。
- 関連のないプロジェクト間の分離は厳格に維持されます。
権限と役割
共有はソースプロジェクトから管理されます。
- 共有されたデータセットは読み取り&書き込みで公開されます。
- データセットを共有するか、既存の共有を削除するには、LM & AM エディターの役割が必要です。
共有されたデータセットへのアクセスは、常に受信プロジェクトのコンテキストで評価されます。プロジェクトAから共有されたデータセットをプロジェクトBのユーザーBが読み取る場合、プラットフォームは「ユーザーBはこのデータセットにプロジェクトBでアクセスできますか?」と問います。決して「プロジェクトAで」とは問いません。ユーザーBはプロジェクトAに存在しないため、その2番目の質問は常にfalseを返します。したがって、アクセスルールは受信プロジェクトに固定されます。
より細かい高度なデータアクセス制御モジュールが、共有オブジェクトに対するより細かい権限のために研究されています。
データセットを共有する
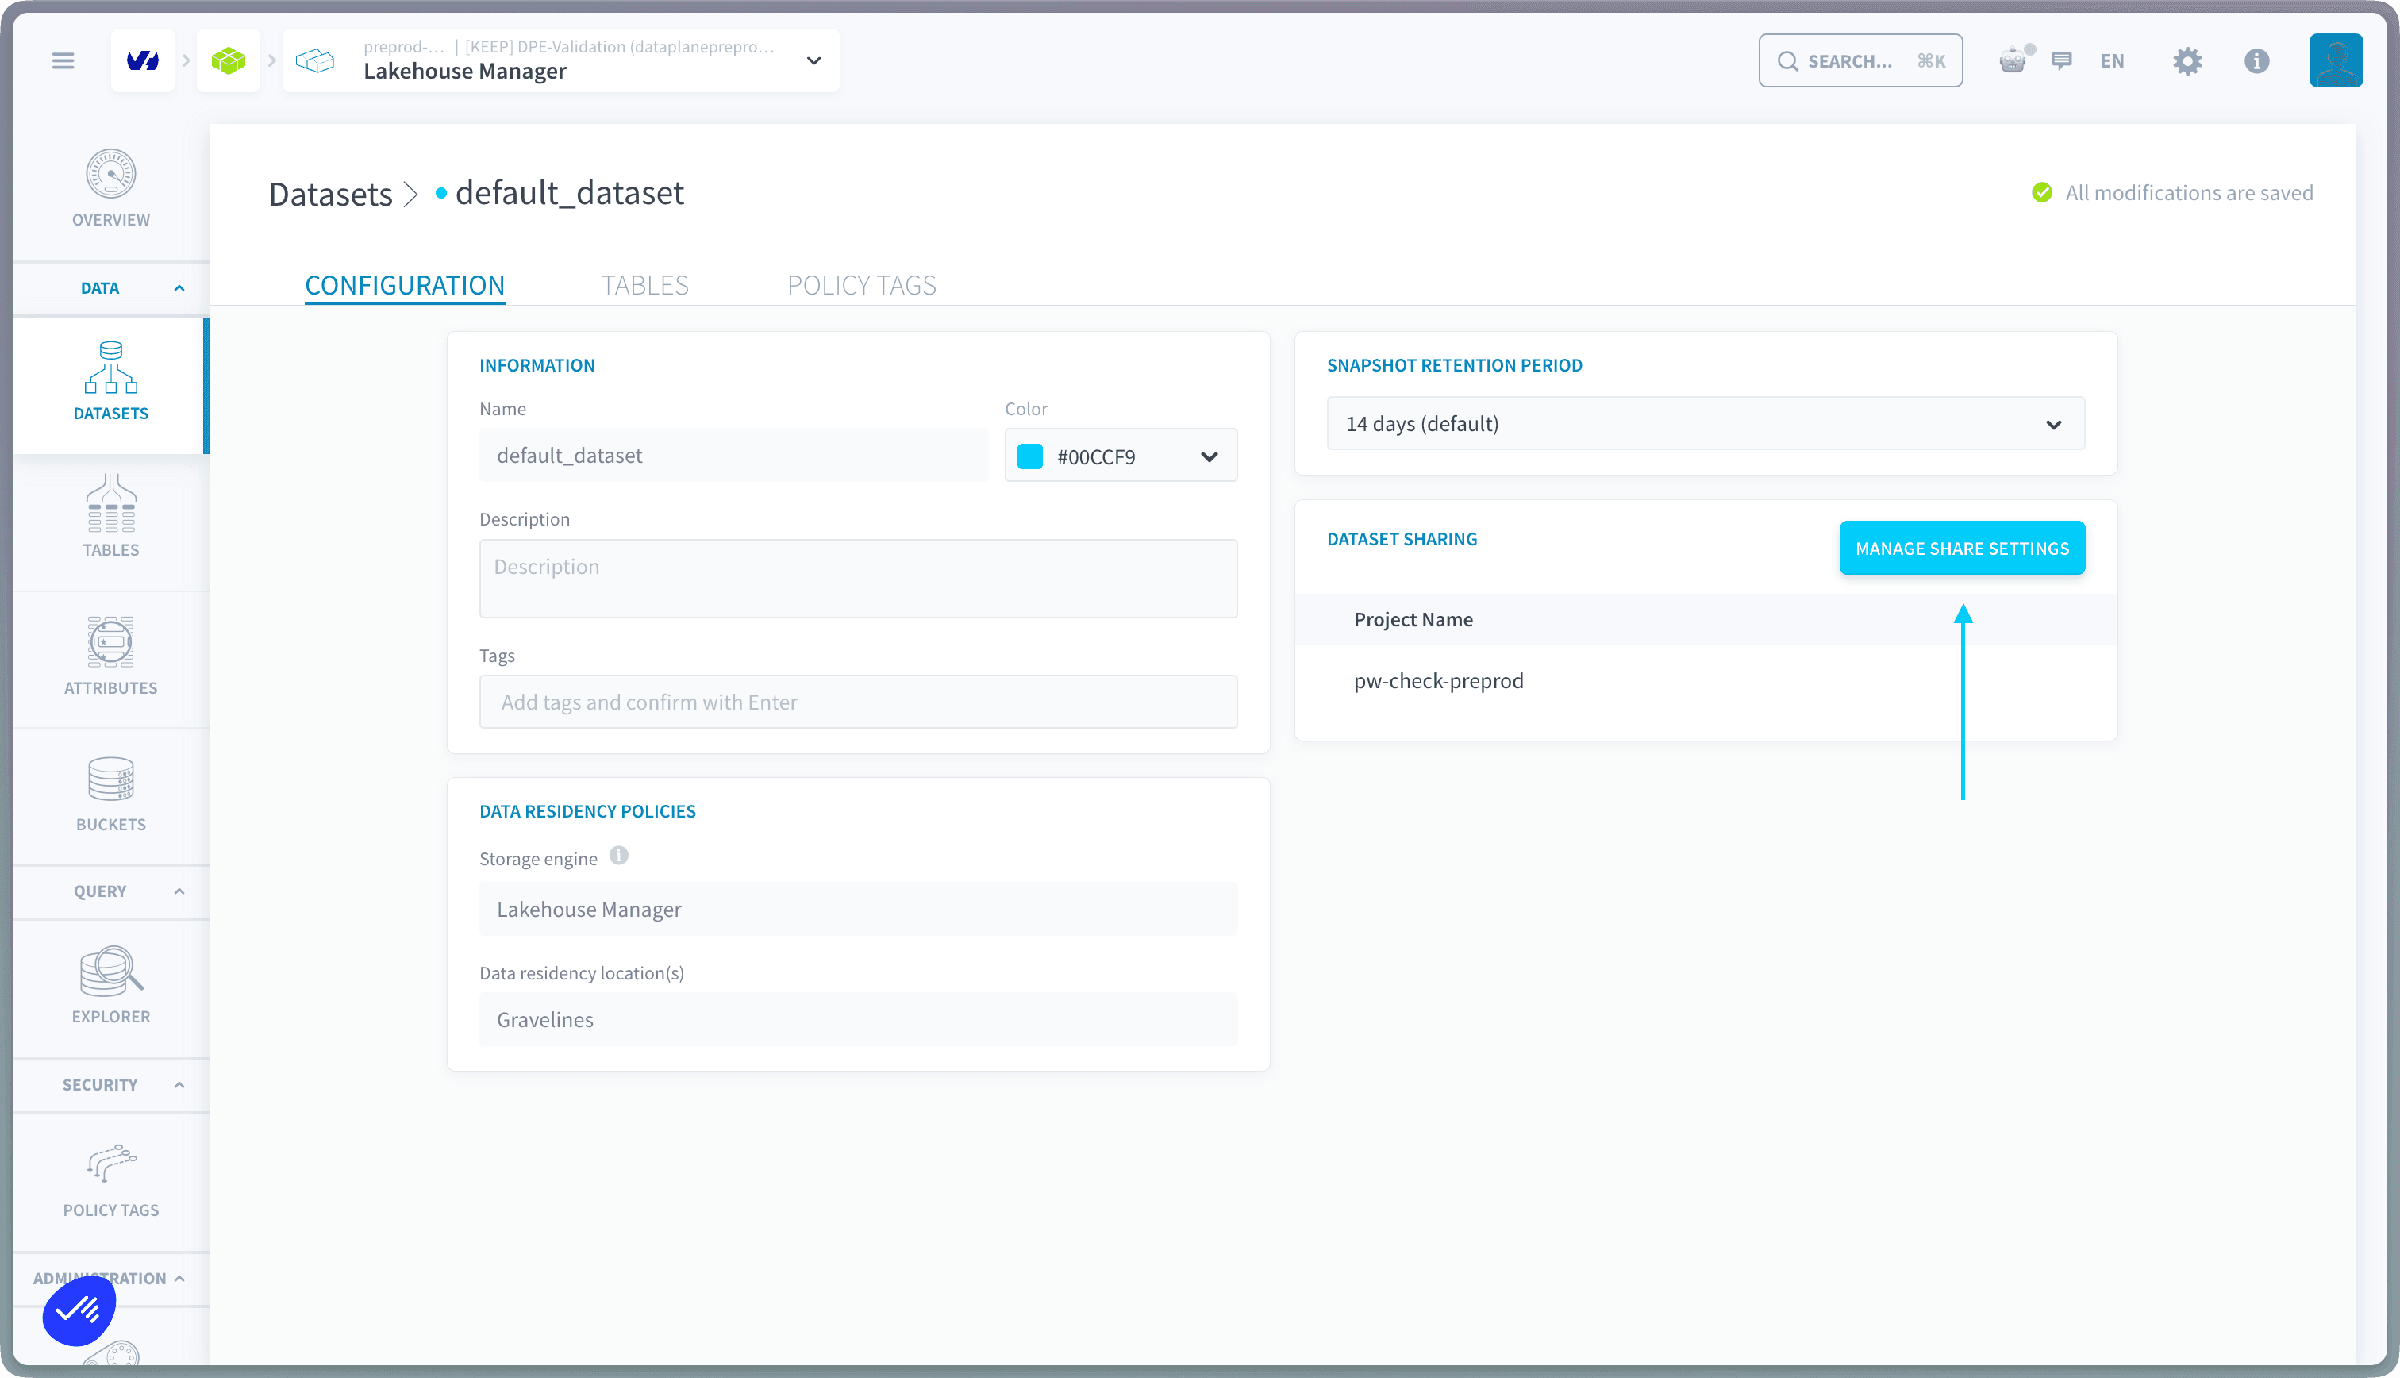
- ソースプロジェクトから、共有したいデータセットを開き、構成タブに移動します。
- 共有設定を管理をクリックします。
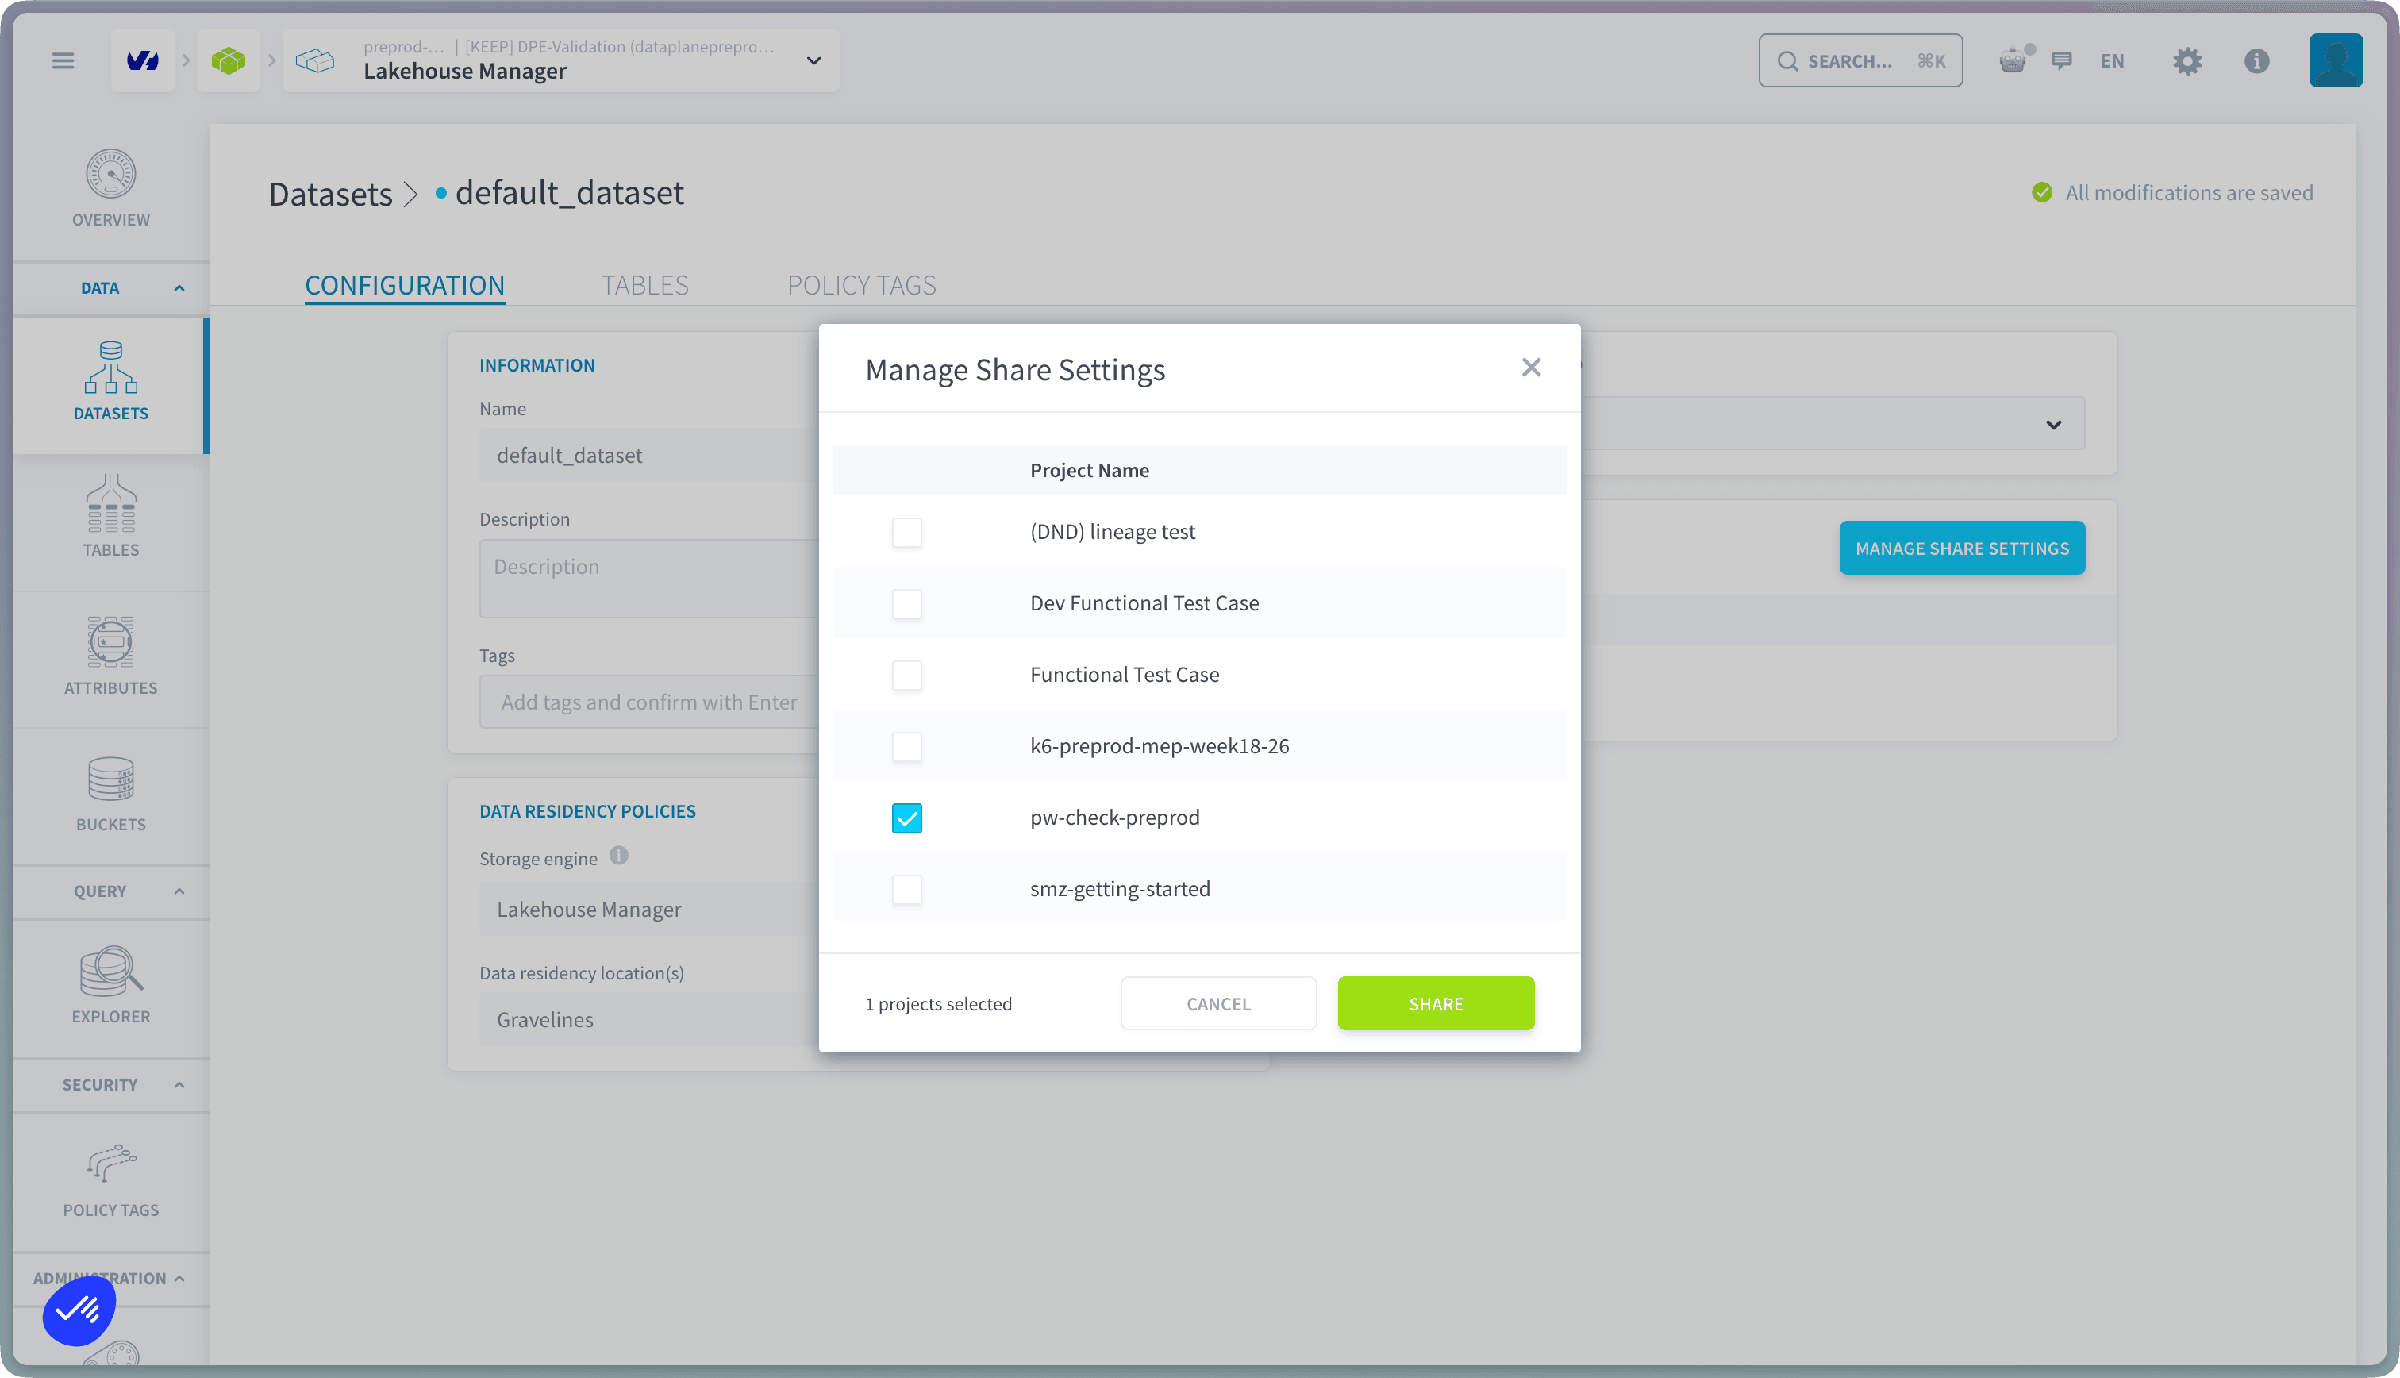
- 組織内の利用可能なプロジェクトのリストから1つまたは複数のプロジェクトを選択し、確認します。
- データセットが共有されたことを確認するメールを受け取ります。
ソースプロジェクトは、データセットが共有された各プロジェクトの使用情報を表示するため、共有データを消費しているユーザーを追跡できます。
受信プロジェクト
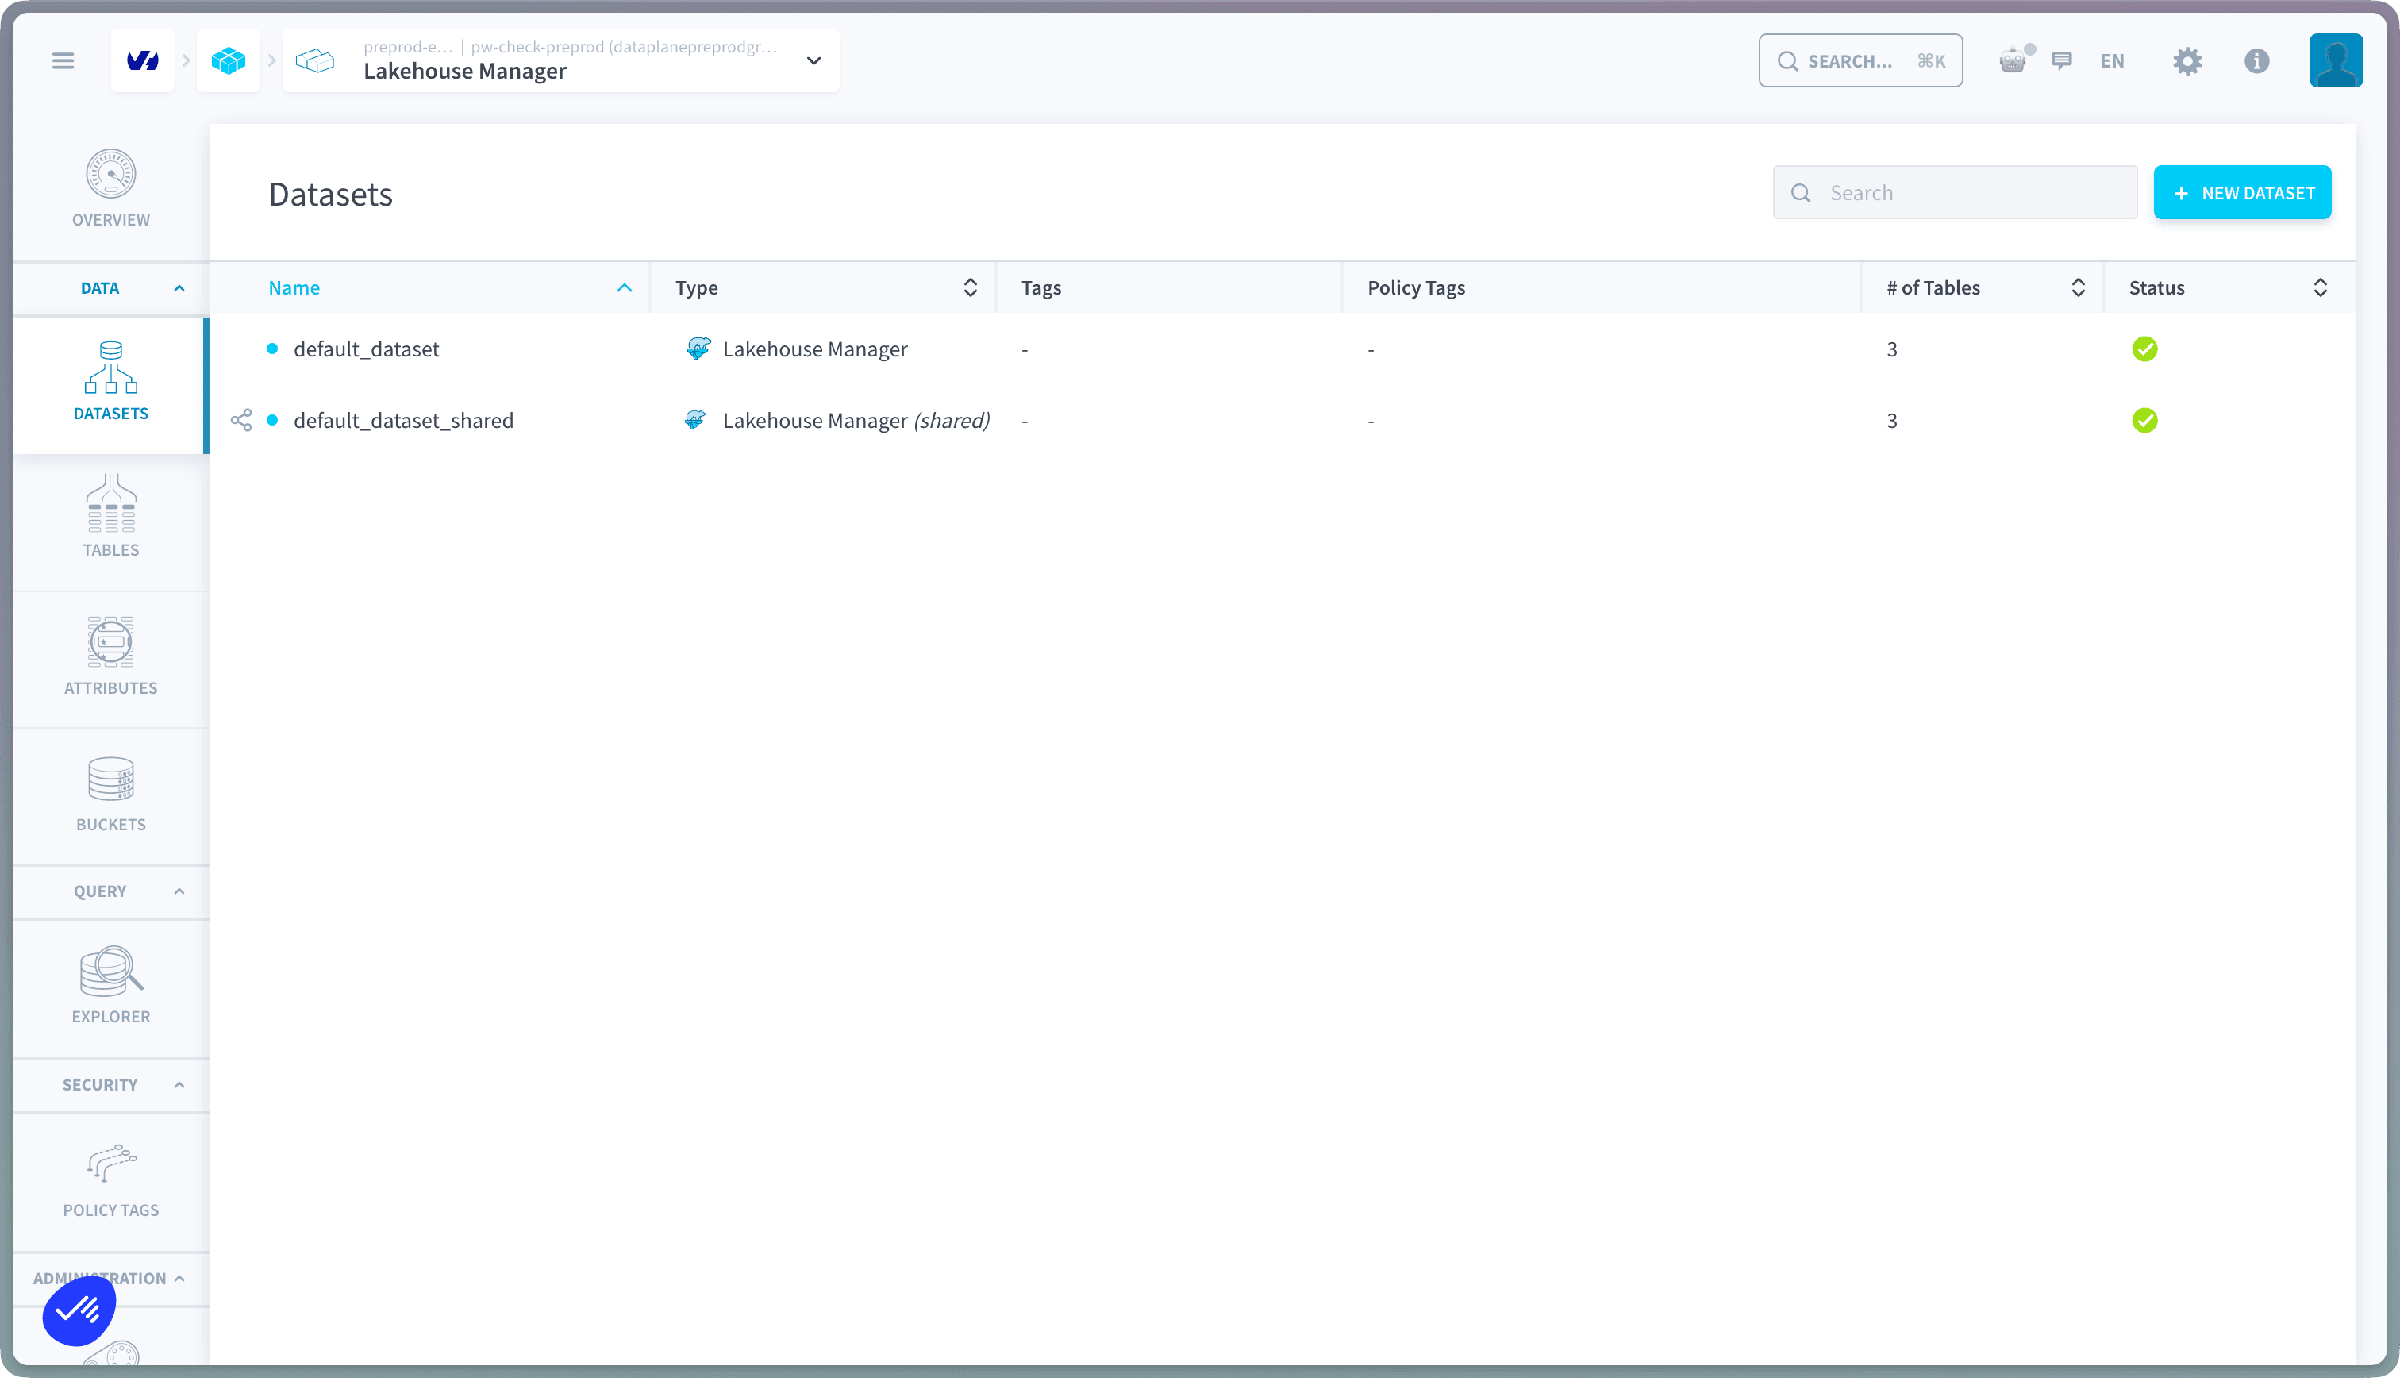
共有されたデータセットは、受信プロジェクトのLakehouse Managerのデータセットメニューに表示され、プロジェクトの独自のデータセットと並びます。共有アイコンとLakehouse Manager(共有)のタイプでマークされます。
共有されたデータセットを開くと、読み取り専用モードで詳細が表示されます:データセットの構成とテーブル構造はソースプロジェクトで管理されます。プレビューアイコンをクリックして関連テーブルをプレビューできます。
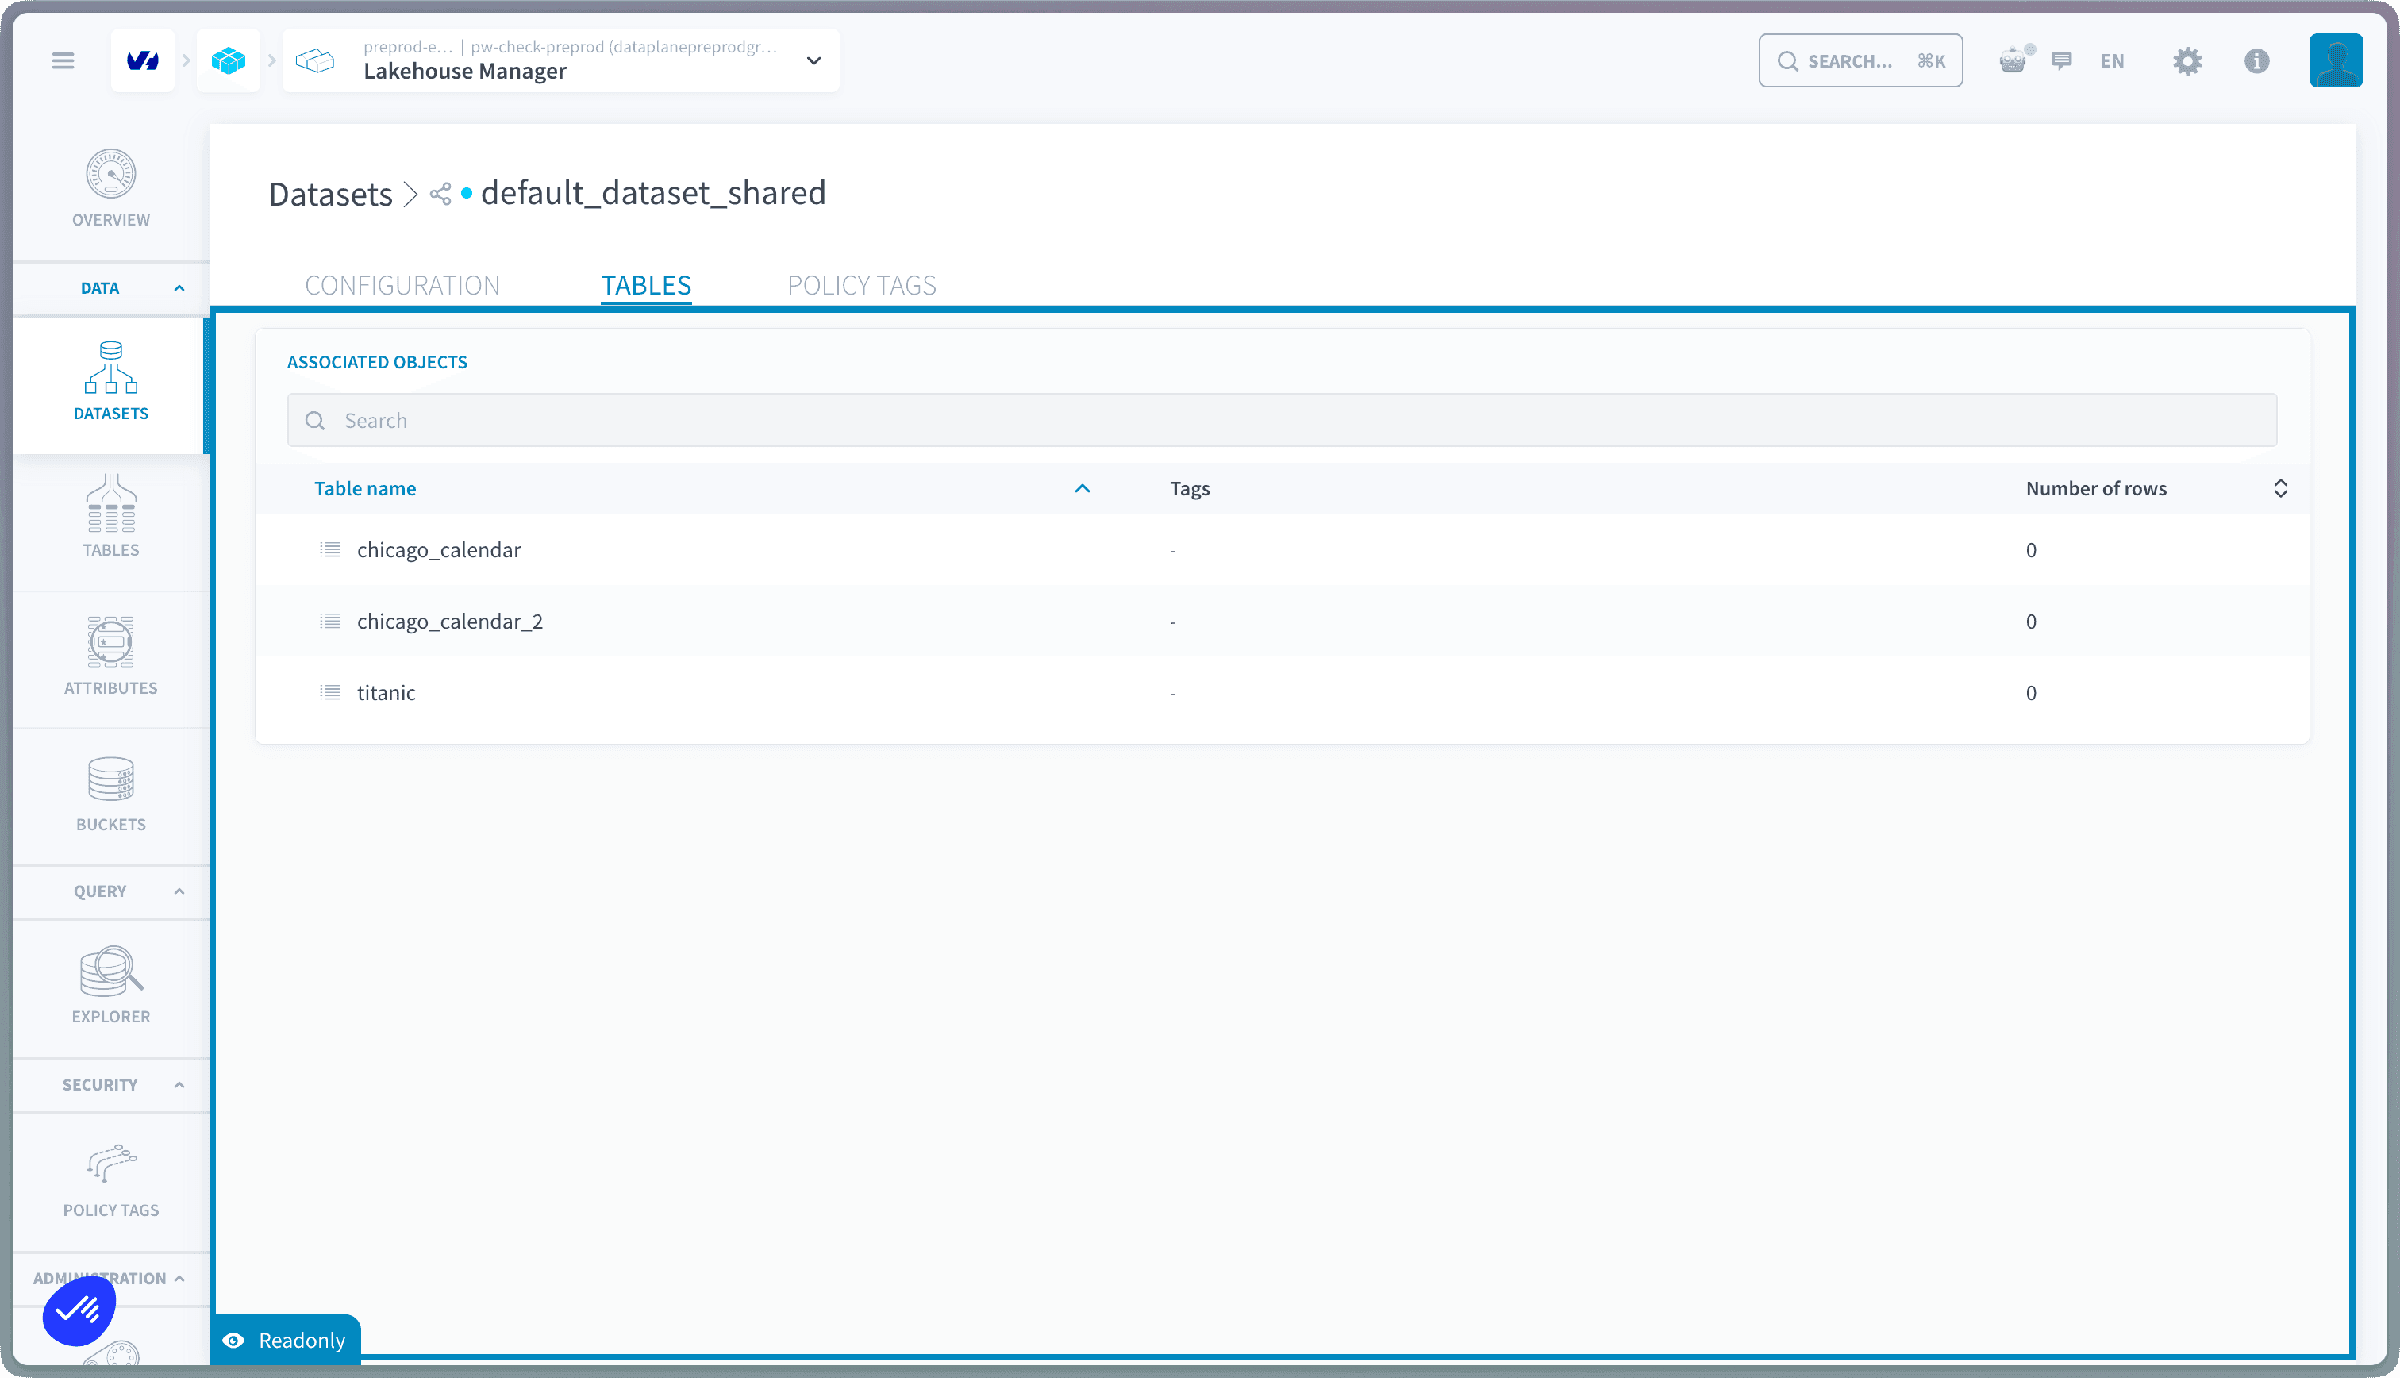
共有されたデータセットは、ConnectorおよびTrinoでソースとして使用できます。したがって、受信プロジェクトのユーザーは、専用データセットと同様にそのデータを使用できます。
Explorer内
Explorer内で、データセットごとにリスト表示オプションを使用して、新しい共有データセットカテゴリを見つけます。このプロジェクトと共有されたデータセットからのすべてのテーブルがここにリストされます。
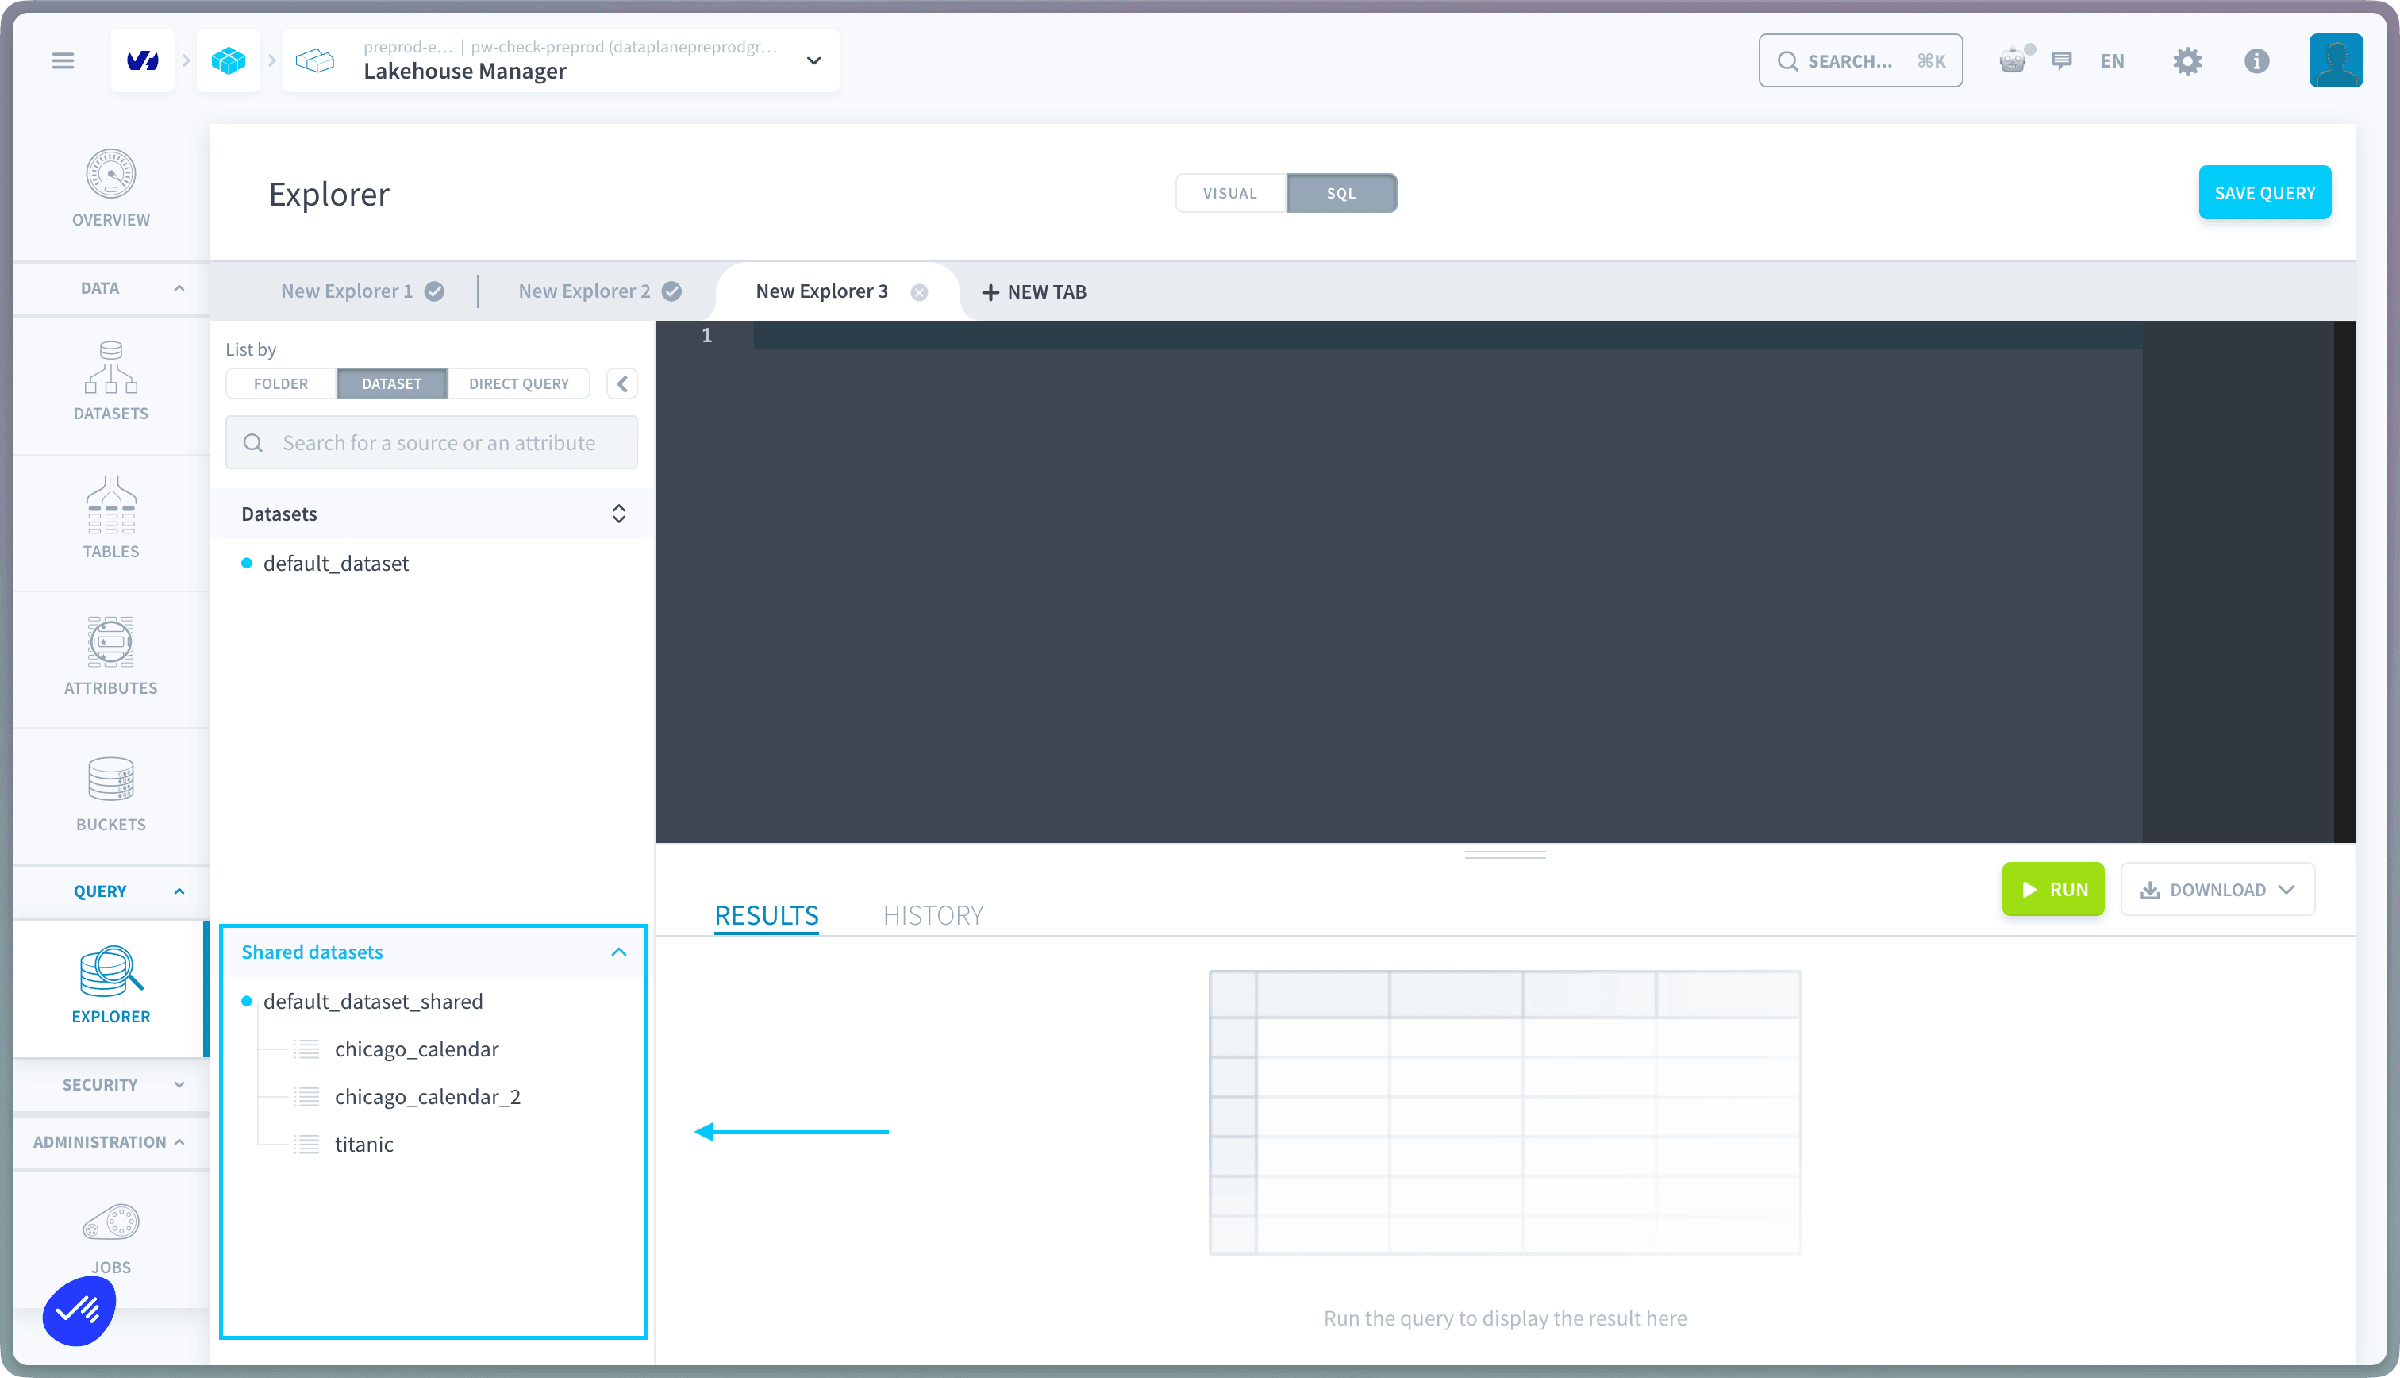
共有データセットテーブルは、SQLエディタを使用してのみクエリできます。ビジュアルビルダーのサポートはまだ利用できません。
さらに詳しく
トレーニングや技術的なサポートを受けてソリューションを実装するには、営業担当者に連絡するか、プロフェッショナルサービスページを訪れて、専門家がプロジェクトを分析するための見積もりを依頼してください。
質問をする、フィードバックを送信する、またはData Platformを構築するチームと直接交流するには、専用のDiscordチャネルを利用してください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。
1: S3はAmazon Technologies, Inc.の商標です。OVHcloudのサービスは、Amazon Technologies, Inc.によってスポンサーされ、承認され、またはその他の方法で提携されていません。