

Data Processing Engine ジョブ
各実行は検査および調整できる記録を残します。
ジョブとは?
ジョブは、アクションまたはワークフローの単一実行です。各ジョブには独自の実行環境が含まれます。割り当てられたリソース、セグメンテーションおよびペリメーター設定、環境変数です。これらは、アクションまたはワークフローの設定から、または共有環境から取得します。
Data Processing Engine はジョブベースです。実行がトリガーされると、プラットフォームは定義された環境に一致するコンテナを構築し、それを実行し、終了させます。そのため、リソースは実行期間中のみ消費されます。
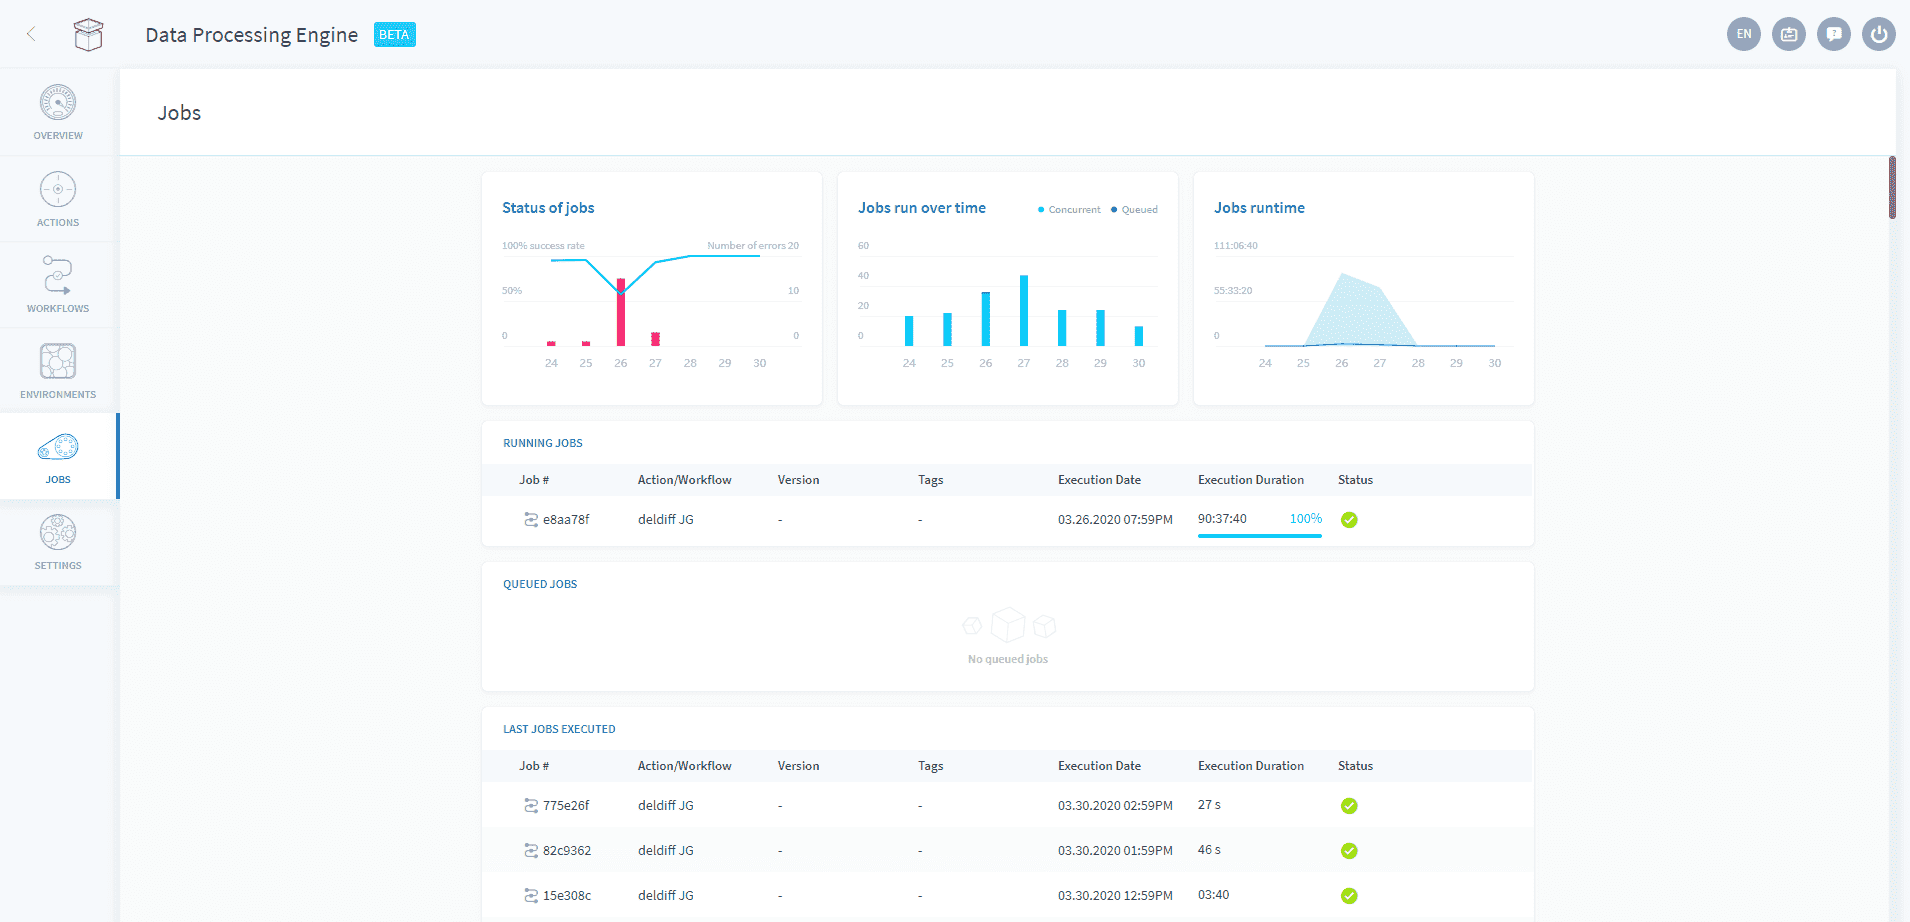
ジョブ画面には3つの状態が表示されます。
実行中のジョブはログをリアルタイムでストリーミングし、同時に実行できるジョブの数はプロジェクトのクォータによって制限されます。
キューイングされたジョブは、その制限を超えて実行を要求したものです。キューイングはデフォルトで無効になっており、サポートを通じて要求に応じて解除されます。キューイングされたジョブは、画面上に表示された順序で、上から下へ、各実行中のジョブが終了するごとに開始されます。
完了したジョブは、30日間の履歴を保持し、各実行ごとのCPUおよびRAMの統計情報と、成功、失敗、または手動で中断された結果を保持します。タイムアウトを超えたジョブは、他の失敗と区別するためにそのようにフラグが付けられます。PySparkアクションおよびそれらを含むワークフローの実行は、Spark History Serverで直接開きます。
セグメンテーションとペリメーターには独自の用語があります。以下の2つのリファレンスでは、インターフェースおよび高度なモードで表示される用語を定義します。
リソース→
ジョブを垂直にサイズ調整するか、ワーカーに分散させる。
セグメンテーション→
ジョブを日付、値、またはアカウントによって並列タスクに分割する。
パーメーター→
ジョブを実行する前に処理するデータをフィルタリングする。
実行の好み→
タイムアウト、サービスアカウント、書き込み戦略、トリガー、および実行モード。
セグメンテーションとペリメーターの用語
Segmentation and perimeter vocabulary
セグメント: データソースのサブセットです。行/列ソースのセグメントは、固定数の行、ソースの属性(日付または値)、またはユーザーアカウント(アカウントベースのソース)に基づいて定義できます。
セグメンテーション / セグメント化: DPEアクションを複数のタスクに分割し、1つ以上のセグメントを処理するアクションです。
セグメンテーション値: アクションをより小さなタスクに分割するために使用される参照値です。
セグメンテーションタイプ: 高度なモードでの技術名: segmentationValues。セグメンテーション値のリストを取得するプロセスを決定します。
ソース属性 / (セグメンテーション変数): 高度なモードでの技術名: segmentationVarName。ソース内のどの列にフィルターを適用するかを決定します。
ペリメーター: DPEアクションのソースをフィルターします。
ペリメータータイプ: 高度なモードでの技術名: perimeterValues。ペリメーター値のリストを取得する方法を決定します。
ペリメーター値: スコープを適用する値のリストです。
ソース属性 / (ペリメーター変数): 高度なモードでの技術名: perimeterVarName。ペリメーター値にフィルターを適用するソース内の列を決定します。
バケットサイズ: 高度なモードでの技術名: segmentationChunkSize。各タスクが処理するセグメンテーション値の数です。
バケットサイズの詳細
Bucket size in detail
いつでも、データソースのいくつかのセグメントをバケット(チャンク)にグループ化して管理することができます。セグメント(値、日付、またはSNSアカウント)のリストが一貫している場合、多くのタスクを生成するのを防ぎます。
バケットサイズは、各タスクが処理するセグメントの数を設定します。
- バケットサイズを2に設定すると、各タスクは2つのセグメントを処理します。
- バケットサイズを10に設定すると、各タスクは10つのセグメントを処理します。
- など。
以下は、バケットサイズを30に設定した場合とバケットサイズを1に設定した場合の影響のイラストです。ワークフローの日付に基づいてセグメンテーションを実行していると仮定します。ワークフローは2018年1月1日から2019年12月31日まで実行されます。
| セグメンテーションチャンクサイズなし | セグメンテーションチャンクサイズあり |
|---|---|
| ChunkSize = 1 | ChunkSize = 30 |
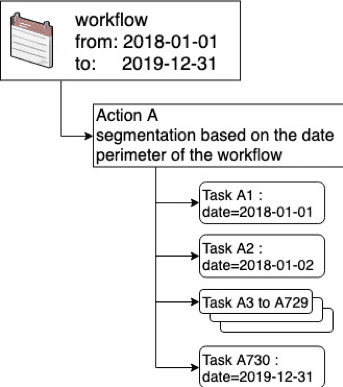 | 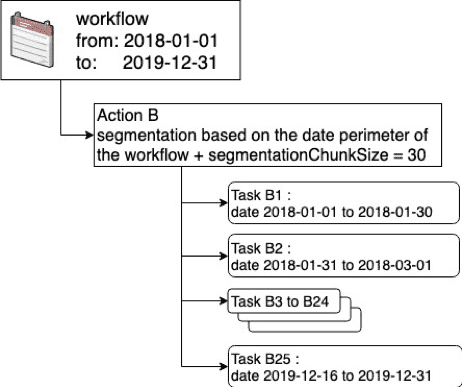 |
最初の場合、DPEアクションは730のタスク(365 x 2)に分割され、2年間の各日に1つのタスクが割り当てられます。2番目の場合、バケットサイズは30に設定され、各タスクが30日間を処理するため、DPEアクションは25のタスク(365 x 2 / 30)にのみ分割されます。
さらに詳しく
ソリューションのトレーニングまたは技術的な実装についてのアシスタンスが必要な場合は、営業担当者にお問い合わせください、またはプロフェッショナルサービスページを訪れて、見積もりを依頼し、専門家チームによるプロジェクト分析を受けてください。
質問をする、フィードバックを送信し、Data Platformを構築するチームと直接交流するには、専用のDiscordチャネルをご利用ください。
OVHcloudサービスについてサポートが必要な場合は、ヘルプセンターでリクエストを作成してください。
ユーザーコミュニティに参加してください。